왜 사람들이 DeepSeek-R1과 디스틸을 혼동하는가
ollama run deepseek-r1:14b을 입력할 때, 여러분은 DeepSeek-R1의 더 작은 버전을 실행하는 것이 아니라 R1의 추론을 모방하도록 학습된 Qwen2.5 14B를 실행하는 것입니다. "DeepSeek-R1-Distill-Qwen-14B"라는 이름은 정확하지만 오해하기 쉽습니다. "DeepSeek-R1" 부분은 추론이 어디에서 왔는지를 설명하고, "Qwen-14B" 부분이 실제로 여러분의 GPU에서 실행되는 모델입니다.
이것이 중요한 이유는 기대가 이름을 따라가기 때문입니다. 사람들은 디스틸을 "R1인데 더 작고 조금 못한 것"이라고 가정합니다. 실제로는 "R1처럼 사고하는 법을 배운 유능한 오픈 모델"에 가깝습니다. 이 관점은 여러분이 실제로 보게 될 행동을 예측합니다. 뛰어난 추론 구조와, 원시 지식이나 가장 어려운 경우의 안정성에서의 간헐적 공백입니다.
완전한 모델이 집에서 사용할 수 없는 이유의 하드웨어 현실에 대해서는 DeepSeek-V3 로컬 하드웨어 요구 사항을 참고하십시오. V3는 동일한 671B급 용량을 가진 챗 모델 형제입니다.
업데이트 — DeepSeek의 현재 세대는 R1이 아니라 DeepSeek-V4입니다. V4(Flash 및 Pro)는 오픈 웨이트로 공개되었지만(V4-Flash: 총 약 284B, 활성 13B 파라미터, MIT 라이선스) 서버급 모델이며 단일 GPU용이 아닙니다. DeepSeek 변경 로그는 기존 API 이름인 deepseek-chat과 deepseek-reasoner(V3·R1 세대)를 2026-07-24에 종료하기로 예고했으며, 현재 API는 V4 계열을 제공합니다. 따라서 이 글에서 “호스팅된 R1”은 외부 호스팅 업체 또는 자체 클러스터에서 구동하는 R1 전체 가중치를 뜻합니다. 여기서 다루는 R1 증류 모델은 이 공지로 폐기되지 않은 별도의 오픈 웨이트 공개물이며 계속 로컬에서 실행할 수 있습니다. 다만 이전 세대 모델이며 DeepSeek의 최신 라인은 아닙니다.
📍 한 문장으로
DeepSeek-R1 디스틸은 R1 자체를 축소한 사본이 아니라, 완전한 R1의 추론을 모방하도록 파인튜닝된 기존 소형 모델(Qwen2.5 또는 Llama 3.1/3.3)입니다.
💬 쉽게 말하면
완전한 R1을 능숙한 수학자로, 디스틸을 그 스승의 풀이 해법을 공부한 뛰어난 학생으로 생각하십시오. 학생은 같은 방식으로 추론하지만 스승이 아는 모든 것을 알지는 못합니다.
완전한 671B DeepSeek-R1이란?
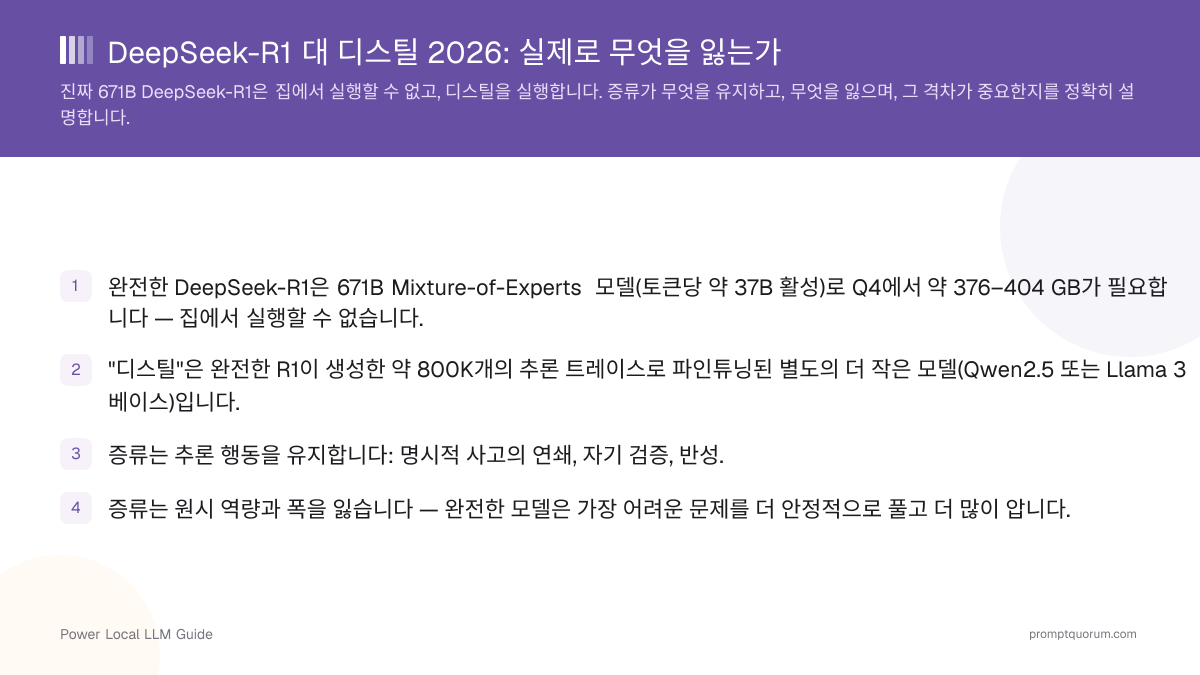
완전한 DeepSeek-R1은 6710억 개의 파라미터를 가진 Mixture-of-Experts(MoE) 모델로, 토큰당 약 37B 파라미터를 활성화하며 Q4에서 약 376–404 GB의 VRAM이 필요합니다 — 데이터센터 하드웨어 전용입니다. 이것이 바로 디스틸이 모방하도록 학습하는 고품질 추론을 생성하는 모델입니다.
MoE는 모델이 각 토큰을 소수의 "전문가" 하위 네트워크로 라우팅하여 671B 파라미터 중 토큰당 약 37B만 발화함을 의미합니다. 이는 추론을 밀집된 671B 모델보다 저렴하게 만들지만, 671B 파라미터 각각은 여전히 메모리에 상주해야 하므로 소비자용 하드웨어에는 들어가지 않습니다.
Unsloth가 제공하는 완전한 R1의 1.58비트 동적 빌드(약 131 GB)가 존재하며 VRAM과 RAM을 합쳐 80 GB 이상인 머신에서는 기술적으로 실행할 수 있지만, Unsloth의 자체 설명은 메모리가 적은 환경을 "매우 느리다"고 하고 2x H100 80 GB에서 단일 사용자 추론 기준 초당 약 14토큰이라고 밝힙니다. 실용적인 가정용 구성이 아니라 흥밋거리입니다. 실용적으로 완전한 R1은 클라우드에, 디스틸은 여러분의 머신에 있습니다.
DeepSeek-R1 증류는 어떻게 작동하는가?
DeepSeek는 완전한 R1으로 약 800,000개의 추론 샘플을 생성한 다음, 기존의 오픈 베이스 모델 — Qwen2.5(Math-1.5B, Math-7B, 14B, 32B)와 Llama 3.x(3.1-8B, 3.3-70B-Instruct) — 을 그 샘플로 파인튜닝했습니다. 베이스 모델은 R1의 파라미터를 전혀 포함하지 않으면서 R1의 단계별 추론 패턴을 재현하는 법을 배웁니다.
이것은 소형 모델에 대한 강화 학습이 아니라 고품질 추론 트레이스에 대한 지도 파인튜닝입니다. 디스틸은 R1 사고의 *형태*를 물려받습니다. 언제 사고의 연쇄를 확장하고, 언제 되돌아가고, 언제 검증할지가 베이스 모델이 이미 알던 것 위에 얹힙니다.
그래서 베이스 선택이 그토록 중요합니다. 디스틸은 그 베이스의 지식에 R1에서 복사한 추론 규율을 더한 만큼만 박식합니다. 훌륭한 추론 트레이스를 주어도 약한 베이스는 원시 역량에서 천장에 부딪힙니다.
📍 한 문장으로
DeepSeek는 완전한 R1이 생성한 약 800,000개의 추론 샘플로 Qwen2.5와 Llama 3.1/3.3 베이스 모델을 파인튜닝하여 그 추론 스타일을 소형 모델로 이전했습니다.

공식 R1 디스틸 여섯 개와 그 베이스 모델
DeepSeek는 Qwen2.5-Math, Qwen2.5, Llama 3.1, Llama 3.3의 네 가지 베이스 모델 계열 위에 R1 디스틸 여섯 개를 공개했고, 이후 Qwen3 베이스의 DeepSeek-R1-0528-Qwen3-8B를 추가했습니다. 이름의 "R1"이 아니라 베이스와 크기로 고르십시오.
디스틸 | 베이스 모델 | AIME 2024 | Ollama 태그 |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 28.9% | deepseek-r1:1.5b (1.1 GB) |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 55.5% | deepseek-r1:7b (4.7 GB) |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | 50.4% | 전용 태그 없음(참고 참조) |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | 69.7% | deepseek-r1:14b (9.0 GB) |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 72.6% | deepseek-r1:32b (20 GB) |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 70.0% | deepseek-r1:70b (43 GB) |
| DeepSeek-R1-0528-Qwen3-8B | Qwen3-8B Base | 86.0% | deepseek-r1:8b (5.2 GB) |
AIME 2024 pass@1은 DeepSeek의 Hugging Face 모델 카드에 보고된 값입니다. 0528 수치는 별도 평가에서 나온 것이므로 행 간 차이는 참고용으로만 보십시오. AIME 2024에서는 32B가 70B보다 높습니다(72.6% 대 70.0%). 여섯 디스틸은 모두 MIT 라이선스이지만 각 베이스 모델은 자체 라이선스를 유지합니다(Qwen2.5는 Apache 2.0, Llama 기반은 Llama 커뮤니티 라이선스). Ollama의 deepseek-r1:8b 태그와 태그 없는 ollama run deepseek-r1은 원래의 Llama-8B 디스틸이 아니라 R1-0528-Qwen3-8B를 받습니다.
증류는 무엇을 유지하는가?
증류는 R1을 강력한 추론기로 만드는 세 가지 행동을 안정적으로 이전합니다: 사고의 연쇄, 자기 검증, 반성. 이들은 토큰 생성의 패턴이며, 패턴이야말로 지도 파인튜닝이 잘 복사하는 것이기에 살아남습니다.
- 사고의 연쇄: 디스틸은 최종 답 이전에 중간 단계를 적어 내며, 이것이 수학·논리 강점의 핵심입니다.
- 자기 검증: 자신의 중간 결과를 점검하여 끝이 아니라 추론 중간에 오류를 잡아냅니다.
- 반성: 경로가 잘못되어 보일 때 첫 시도에 매달리지 않고 되돌아가 재고합니다.
- 결과: DeepSeek 모델 카드에 따르면 7B 디스틸은 AIME 2024에서 55.5%를 기록합니다.
증류는 무엇을 잃는가?
증류는 완전한 671B 모델의 원시 역량, 지식의 폭, 가장 어려운 문제에서의 안정성을 이전할 수 없습니다 — 작은 베이스는 정보를 저장하고 결합할 공간이 단순히 더 적기 때문입니다. 디스틸이 작을수록 이 격차는 커집니다.
역량 | 완전 671B R1 | 32B 디스틸 | 7B 디스틸 |
|---|---|---|---|
| 추론 구조(CoT, 반성) | 기준 | 매우 근접 | 근접 |
| 가장 어려운 문제에서의 안정성 | 최고 | 강함 | 보통 |
| 세계 지식의 폭 | 최고 | 양호 | 제한적 |
| 길고 제약이 많은 문제 | 최선 | 양호 | 저하됨 |
| 소비자용 하드웨어에서 실행 | 불가 | 가능 (24 GB) | 가능 (8 GB) |
순위는 방향성을 나타내며 벤치마크 정확치는 아닙니다: 격차는 일반적인 추론 작업에서 작고, 프런티어 난이도나 폭넓은 지식 작업에서 커집니다. 이 평가는 PromptQuorum의 편집상 판단이며 측정값이 아닙니다.

격차가 여러분의 사용 사례에서 중요한가?
대부분의 로컬 추론에서는 격차가 무시할 만큼 작고, 프런티어 난이도 문제나 폭넓은 세계 지식이 필요한 작업에서만 결정적이 됩니다. 가장 큰 모델을 좇기보다 사용 사례로 결정하십시오.
디스틸로 충분한가?
다음의 경우 로컬 LLM을 사용하십시오:
- •학교·경시 수학, 논리 퍼즐, 단계별 계획 → 디스틸로 충분합니다(여유를 위해 32B, 대부분은 14B)
- •데이터가 머신을 떠날 수 없는 비공개/오프라인 추론 → 로컬 디스틸은 데이터를 머신 안에 두며 적합한 선택입니다
- •호스팅 API 대비 비용 통제 → 로컬 디스틸은 토큰당 비용을 완전히 없앱니다
다음의 경우 클라우드 모델을 사용하십시오:
- •분야 최전선의 연구 수학이나 증명 → 완전한 호스팅 R1이 더 안정적입니다
- •폭넓고 최신의 세계 지식이 필요한 작업 → 더 큰 모델이나 검색 보강 설정이 이깁니다
- •비용에 관계없이 가장 안정적인 단일 답이 필요 → PromptQuorum으로 프런티어 모델과 비교하십시오
빠른 결정:
- →확신이 없으면 32B 디스틸을 실행하고, 눈에 띄게 어려워할 때만 호스팅 R1으로 올리십시오.
- →소형 영역에서는 더 큰 크기보다 더 큰 베이스가 이깁니다 — 아래의 R1-0528-Qwen3-8B를 보십시오.
R1-0528-Qwen3-8B: 더 나은 베이스가 격차를 좁힌다
DeepSeek-R1-0528-Qwen3-8B는 더 강한 베이스가 증류 격차를 줄임을 보여줍니다. 업데이트된 R1-0528의 추론을 갖춘 Qwen3 8B 위에 만들어져 AIME 2024에서 오픈 8B 모델을 선도하며, 베이스 Qwen3 8B보다 약 10점 높은 점수를 기록합니다. 원래 8B 디스틸과 같은 크기 등급이면서도 추론이 확연히 더 낫습니다 — 베이스가 더 좋고 추론 소스가 더 새롭기 때문입니다.
디스틸 선택의 교훈: 소형 영역에서는 같은 파라미터 수의 오래된 디스틸보다 더 강하고 새로운 베이스의 모델을 택하십시오. 기가바이트당 역량은 원시 크기보다 더 나은 베이스로 더 빠르게 상승하고 있습니다.
설정 팁: 온도 0.6, 시스템 프롬프트 없음
모든 DeepSeek-R1 디스틸을 온도 0.6(0.5–0.7이 안전)으로, 시스템 프롬프트 없이 실행하고 모든 지시는 사용자 프롬프트에 넣으십시오. 이는 시스템 프롬프트를 주거나 온도를 0 근처 또는 약 0.8 이상으로 줄 때 R1 계열이 빠지기 쉬운 반복·비일관성 실패 모드를 피합니다.
디스틸을 완전한 호스팅 R1과 비교하는데 디스틸이 반복되거나 벗어난다면, 디스틸이 약하다고 결론짓기 전에 설정을 고치십시오 — 잘못된 샘플링 설정은 그 진짜 품질을 가립니다.
예외: DeepSeek-R1-0528-Qwen3-8B는 시스템 프롬프트를 받습니다. 모델 카드에 따르면 강제 <think> 접두어는 더 이상 필요하지 않으며, 온도 0.6(DeepSeek 평가에서는 top-p 0.95)은 그대로 적용됩니다. "시스템 프롬프트 없음" 규칙은 원래의 R1과 원래의 여섯 디스틸에 해당합니다.
자주 묻는 질문
DeepSeek-R1 디스틸은 DeepSeek-R1과 같은 모델인데 더 작기만 한 것입니까?
아닙니다. 디스틸은 R1의 추론을 약 800K개의 샘플로 모방하도록 파인튜닝된 다른 베이스 모델(Qwen2.5 또는 Llama 3.1/3.3)입니다. R1의 추론 스타일은 유지하지만 R1의 파라미터는 전혀 포함하지 않습니다.
증류는 완전한 R1에서 정확히 무엇을 유지합니까?
추론 행동입니다: 사고의 연쇄, 자기 검증, 반성. 이들은 지도 파인튜닝이 안정적으로 이전하는 토큰 생성 패턴이며, 그래서 7B 디스틸이 AIME 2024에서 55.5%에 도달합니다.
디스틸은 완전한 671B R1 대비 무엇을 잃습니까?
원시 역량, 세계 지식의 폭, 가장 어려운 문제에서의 안정성입니다. 디스틸이 작을수록 격차가 커지지만, 일반적인 추론 작업에서는 작게 유지됩니다.
완전한 671B DeepSeek-R1을 집에서 실행할 수 없는 이유는?
토큰당 약 37B만 활성화되더라도 671B 파라미터 전부가 상주해야 하므로 Q4에서 약 376–404 GB의 VRAM이 필요합니다. 이는 데이터센터 하드웨어입니다. Unsloth에 따르면 1.58비트 동적 빌드가 존재하지만 소비자용 하드웨어에서는 매우 느려 흥밋거리일 뿐 실용적이지 않습니다.
격차가 일상적인 사용에 중요합니까?
대개 그렇지 않습니다. 학교·경시 수학, 논리, 다단계 계획에는 14B나 32B 디스틸로 충분합니다. 격차가 중요한 것은 프런티어 난이도 문제나 폭넓고 최신의 지식이 필요한 작업입니다.
어떤 디스틸이 완전한 R1에 가장 가깝습니까?
70B 디스틸은 여섯 중 가장 크고 원시 역량에서 가장 가깝지만 듀얼 GPU가 필요하며 AIME 2024에서는 32B보다 낮습니다(70.0% 대 72.6%). 32B는 여섯 개 중 AIME 2024에서 가장 강한 단일 GPU 선택지이며, DeepSeek 모델 카드에 따르면 다양한 벤치마크에서 OpenAI o1-mini를 능가합니다.
R1-0528-Qwen3-8B가 원래 8B 디스틸보다 나은 이유는?
더 강한 Qwen3 8B 베이스와 업데이트된 R1-0528의 추론을 사용하여 AIME 2024에서 오픈 8B 모델을 선도합니다 — 같은 크기에서 베이스 Qwen3 8B보다 약 10점 높습니다.
DeepSeek-V3는 R1의 디스틸입니까?
아닙니다. DeepSeek-V3는 별도의 671B MoE 챗 모델이며, 추론 모델도 디스틸도 아닙니다. R1이 추론 모델이고, 디스틸은 V3가 아니라 R1을 모방합니다.
DeepSeek-R1과 DeepSeek-R1-Distill은 무엇이 다릅니까?
DeepSeek-R1은 671B Mixture-of-Experts 추론 모델이고, DeepSeek-R1-Distill 모델은 R1이 생성한 추론 샘플로 파인튜닝한 더 작은 Qwen 또는 Llama 모델입니다. 이름은 출처(R1)와 베이스(Qwen 또는 Llama)를 알려 주며, 지식의 상한은 베이스가 정합니다.
Ollama의 어떤 태그가 어떤 DeepSeek-R1 디스틸입니까?
1.5b, 7b, 14b, 32b, 70b 태그는 같은 크기의 Qwen 또는 Llama 기반 디스틸에 해당하고, 671b는 완전한 R1입니다. 8b 태그(태그 없는 ollama run deepseek-r1이 받는 것도 이것)는 원래의 Llama-8B 디스틸이 아니라 DeepSeek-R1-0528-Qwen3-8B입니다.
DeepSeek-R1은 여전히 DeepSeek의 최신 모델입니까?
아닙니다. DeepSeek의 현재 세대는 오픈 웨이트로 공개된 DeepSeek-V4(Flash 및 Pro)입니다. R1과 V3는 이전 세대 모델이며, DeepSeek 변경 로그는 API 이름 deepseek-chat과 deepseek-reasoner를 2026-07-24에 종료하기로 예고했습니다. R1 증류 모델은 이 공지로 폐기되지 않은 별도의 오픈 웨이트 공개물이므로 계속 로컬에서 실행할 수 있으나, 더 이상 DeepSeek의 최신 라인은 아닙니다.
업데이트 로그
- 2026-06-19 게시. 다음 검토 예정일 2027-06-19(연간 신선도 등급 — 연도에 고정된 모델 사실을 담은 지속형 설명).
- 완전한 671B R1을 여섯 공식 디스틸 및 DeepSeek-R1-0528-Qwen3-8B와 비교합니다. 추론 내부 비교만 다루며, 모델 간 코딩 비교는 코딩 가이드에 있습니다.
- 2026-10-19 업데이트: 여섯 디스틸 참조 표(베이스 모델, AIME 2024, Ollama 태그)를 추가하고 베이스 모델 목록을 바로잡았으며, deepseek-r1:8b 태그가 R1-0528-Qwen3-8B임과 그 시스템 프롬프트 예외를 명시했습니다.
- 2026-10-19 업데이트(세대 점검): DeepSeek-V4가 현재 세대이고 R1/V3가 이전 세대임을, R1 증류 모델이 계속 로컬에서 쓸 수 있는 별도의 오픈 웨이트 공개물임을 명시했으며, 기반 모델의 Llama 3 표기를 Llama 3.1/3.3으로 구체화했습니다.