DeepSeek V3를 로컬에서 실행하려면 어떤 하드웨어가 필요합니까?
빠른 답변
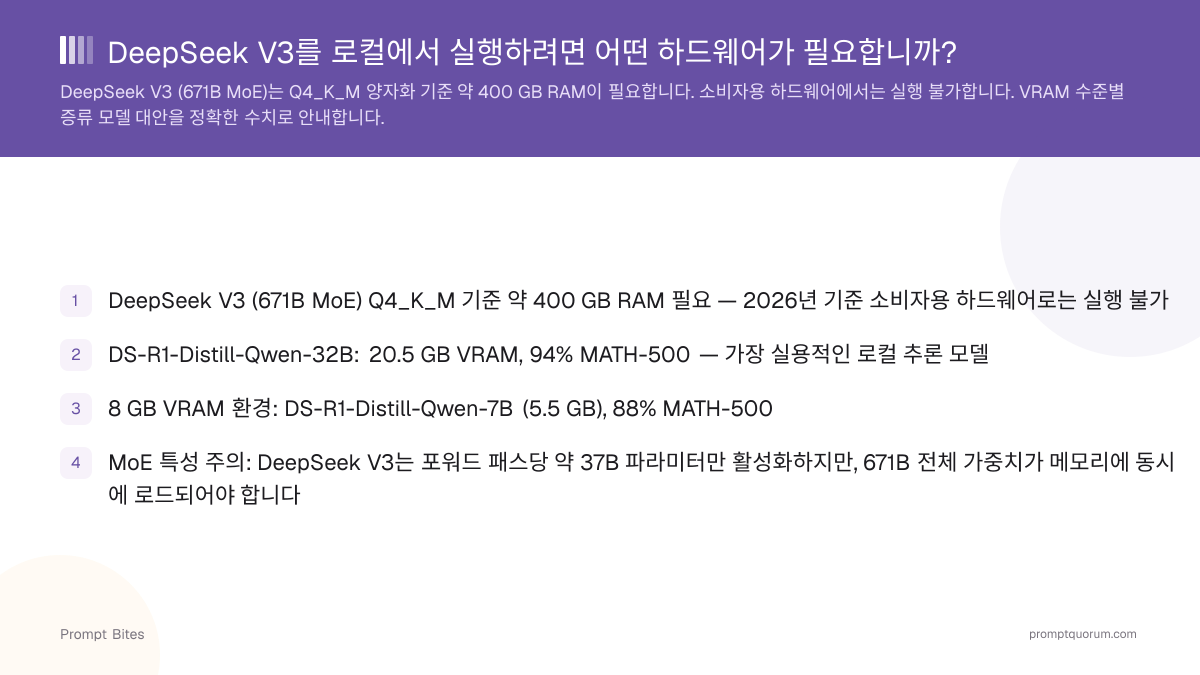
매우 큰 머신에서만 가능합니다. DeepSeek V3는 671B MoE 모델로, Q4_K_M에는 약 405 GB RAM, 네이티브 FP8 가중치에는 약 685 GB(H200 GPU 8장)가 필요합니다. 512 GB Mac Studio가 한 대로 실행할 수 있는 유일한 소비자용 방법이며, 그 외에는 DeepSeek-V4-Flash(3비트 약 103 GB)나 DS-R1-Distill-Qwen-32B(VRAM 20.5 GB)를 쓰세요.
- ▸RAM: Q4_K_M 약 405 GB, Q2_K 약 246 GB, 동적 1비트 170–207 GB
- ▸GPU: 네이티브 FP8 가중치(약 685 GB)에는 H200 8장이 필요하며 소비자용 GPU로는 턱없이 부족
- ▸Mac: 512 GB M3 Ultra는 MLX로 4비트 V3를 약 18–21 tok/s로 실행(커뮤니티 측정)
- ▸더 새롭고 작은 모델: DeepSeek-V4-Flash(284B MoE)는 3비트로 128 GB 머신에 들어감
- ▸VRAM 8–24 GB: DS-R1-Distill-Qwen-7B/14B/32B는 MATH-500에서 92.8–94.3%
핵심 요점
- ✓DeepSeek V3(671B MoE, 활성 37B)는 Q4_K_M에서 약 405 GB RAM이 필요합니다. 일반 PC나 GPU로는 불가능하며 512 GB Mac Studio나 서버에서만 가능합니다
- ✓GPU 요구사항: 네이티브 FP8 가중치가 약 685 GB이므로 H200(각 141 GB) 8장이 필요하고, H100 8장(합계 640 GB)으로는 부족합니다
- ✓실용 가능한 최소 빌드: 약 246 GB(Q2_K)와 170–207 GB(동적 1비트) — 그래도 워크스테이션급 RAM입니다
- ✓실용적 대안: 약 103 GB의 DeepSeek-V4-Flash(128 GB 머신) 또는 VRAM 20.5 GB의 DS-R1-Distill-Qwen-32B(MATH-500 94.3%)
- ✓MoE 참고: 토큰당 활성 파라미터는 약 37B뿐이지만 671B 전체를 메모리에 올려야 합니다
DeepSeek V3 사양 한눈에 보기
양자화별 DeepSeek V3 RAM 요구량
**전체 모델(671B) 크기:** BF16 약 1.34 TB, 원본 FP8 약 685 GB, Q4_K_M 약 405 GB, Q2_K 약 246 GB, 동적 1비트 170–207 GB. 수치는 동일한 671B 아키텍처인 DeepSeek-V3.1의 GGUF 파일 기준이며, V3 파일과는 차이가 아주 작습니다.
**여유를 두세요:** 파일 크기에는 KV 캐시와 컨텍스트가 포함되지 않습니다. 파일보다 10–20% 더 많은 메모리를 잡고, 긴 프롬프트에는 더 필요합니다.
**MoE가 여기서 도움이 되지 않는 이유:** DeepSeek V3는 토큰당 약 37B 파라미터만 활성화해 빠르게 동작하지만, 671B 전체 가중치 텐서가 동시에 메모리에 있어야 합니다.
DeepSeek V3 GPU 요구사항
**데이터센터 GPU:** 원본 FP8 가중치(약 685 GB)는 80 GB H100 8장(합계 640 GB)을 넘습니다. 표준 멀티 GPU 구성은 H200 8장(합계 1,128 GB) 또는 H100 2노드입니다.
**소비자용 GPU:** Q4_K_M(약 405 GB)을 VRAM에만 올리려면 KV 캐시 제외하고도 RTX 5090(32 GB) 13장 또는 RTX 4090(24 GB) 17장이 필요해 현실적이지 않습니다.
**대신 하이브리드 오프로드:** llama.cpp는 MoE 전문가 텐서를 시스템 RAM에 두고 어텐션과 공유 레이어를 GPU 한 장에서 실행할 수 있습니다. RAM+VRAM 합계가 여전히 파일을 담아야 하며, 속도는 메모리 대역폭에 제한됩니다.
Mac Studio가 한 대로 가능한 유일한 소비자용 방법
M3 Ultra와 512 GB 통합 메모리를 갖춘 Mac Studio는 MLX로 4비트 DeepSeek V3를 실행합니다. DeepSeek-V3-0324 4비트에 대한 커뮤니티 측정에서는 짧은 프롬프트에서 약 21 tok/s, 1K 컨텍스트에서 약 17.8 tok/s, 16K에서 약 5.8 tok/s, 최대 메모리 380–465 GB였습니다.
이 수치는 Apple이나 DeepSeek의 공식 벤치마크가 아니라 커뮤니티 데이터입니다. macOS의 GPU 와이어드 메모리 한도를 수동으로 올려야 할 수 있고, 긴 컨텍스트에서는 생성 속도가 크게 떨어집니다.
새로운 DeepSeek 릴리스가 로컬 환경을 바꿨습니다
**V3.1, V3.2-Exp, V3.2:** 동일한 671B급 아키텍처(Hugging Face에서는 685B)이므로 위의 RAM·GPU 수치가 그대로 적용됩니다.
**DeepSeek-V4-Flash:** 총 284B, 활성 13B, MIT 라이선스, 100만 토큰 컨텍스트. Unsloth GGUF는 약 103 GB(UD-IQ3_XXS)에서 약 162 GB(UD-Q8_K_XL)까지이며, 필요 메모리는 약 92 GB(1비트)에서 약 169 GB(8비트)입니다. 128 GB 머신에서 3비트 빌드를 실행할 수 있습니다.
**DeepSeek-V4-Pro:** 총 1.6T, 활성 49B — 서버 하드웨어 전용입니다.
집에서 강력한 DeepSeek 모델을 쓰려고 DeepSeek V3를 검색했다면, V4-Flash가 가장 현실적인 목표입니다.
하드웨어 구간별 실용적 대안
**128 GB 통합 메모리 또는 RAM:** DeepSeek-V4-Flash UD-IQ3_XXS(약 103 GB) — 고급 Mac이나 PC에 들어가는 가장 큰 DeepSeek 모델입니다.
**VRAM 24 GB(RTX 4090/M3 Max):** DS-R1-Distill-Qwen-32B Q4_K_M — MATH-500 94.3%로 전체 V3(90.2%)를 앞섭니다. 일반 대화에는 Qwen3-32B를 쓰세요.
**VRAM 12–16 GB(RTX 3080/M2 Pro):** DS-R1-Distill-Qwen-14B Q4_K_M — MATH-500 93.9%.
**VRAM 8 GB(RTX 3060/M2 16 GB):** DS-R1-Distill-Qwen-7B Q4_K_M — MATH-500 92.8%.
R1 추론 패밀리 완전 가이드 — 하드웨어 선택, 벤치마크 및 Ollama 명령어: [2026년 최고의 로컬 추론 모델](/ko/local-llms/best-local-reasoning-model-deepseek-r1-2026) · [VRAM 치트시트](/ko/prompt-bites/deepseek-r1-distill-vram-cheatsheet)
자주 묻는 질문
출처
[DeepSeek-V3 model card (Hugging Face)](https://huggingface.co/deepseek-ai/DeepSeek-V3)
[Unsloth DeepSeek-V3.1 GGUF sizes (Hugging Face)](https://huggingface.co/unsloth/DeepSeek-V3.1-GGUF)
[Unsloth: DeepSeek-V4 local guide](https://unsloth.ai/docs/models/deepseek-v4)
[DeepSeek-V4-Flash model card (Hugging Face)](https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash)
[DeepSeek-R1-Distill benchmarks (Hugging Face)](https://huggingface.co/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B)
[r/LocalLLaMA: M3 Ultra MLX DeepSeek-V3-0324 4-bit tests](https://www.reddit.com/r/LocalLLaMA/comments/1jj6i4m/deepseek_v3/)
관련 자료
전체 설명이 필요하십니까?
전체 가이드 읽기 →