Pourquoi DeepSeek-R1 et ses distills sont confondus
Quand vous tapez ollama run deepseek-r1:14b, vous n'exécutez pas une version plus petite de DeepSeek-R1 — vous exécutez Qwen2.5 14B entraîné à imiter le raisonnement de R1. Le nom « DeepSeek-R1-Distill-Qwen-14B » est précis mais facile à mal lire : la partie « DeepSeek-R1 » décrit d'où vient le raisonnement, et la partie « Qwen-14B » est le modèle réel qui tourne sur votre GPU.
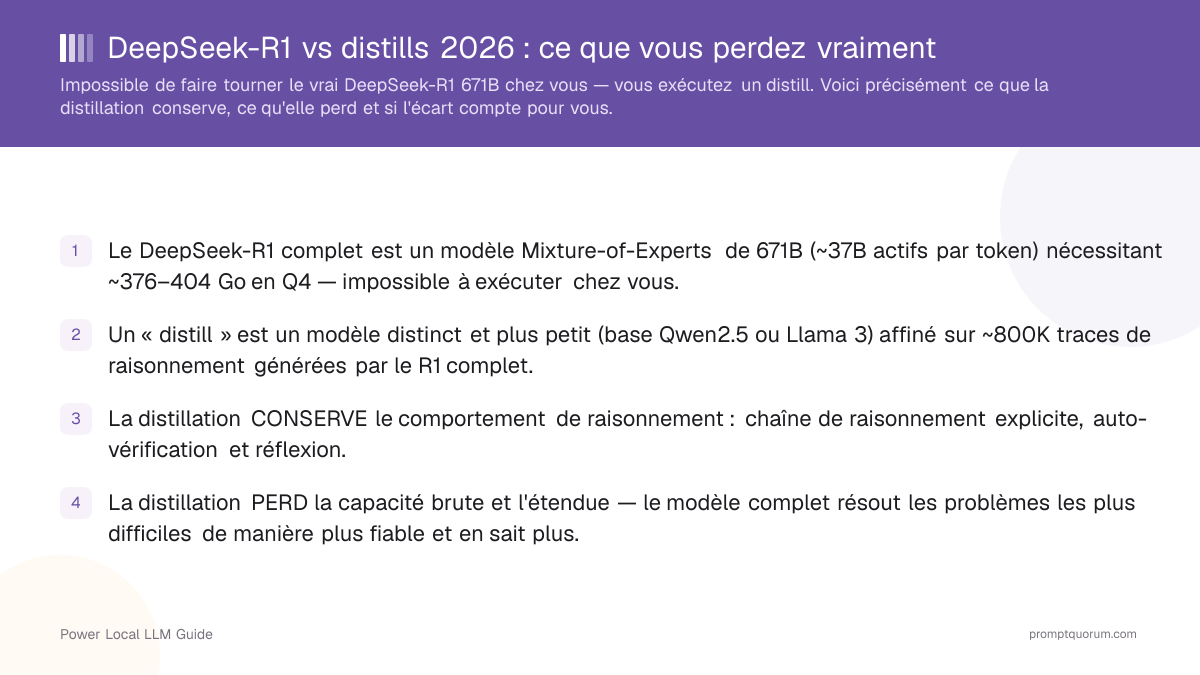
Cela compte, car les attentes suivent le nom. On suppose qu'un distill est « R1, mais plus petit et un peu moins bon ». Il est plus proche d'« un modèle ouvert compétent qui a appris à penser comme R1 ». Ce cadrage prédit le comportement que vous observerez réellement : une excellente structure de raisonnement, des lacunes ponctuelles en savoir brut ou en fiabilité dans les cas les plus difficiles.
Pour la réalité matérielle expliquant pourquoi le modèle complet est inaccessible chez soi, voir Configuration matérielle locale de DeepSeek-V3 — V3 est le frère modèle de chat avec la même empreinte de classe 671B.
Mise à jour — la génération actuelle de DeepSeek est DeepSeek-V4, et non R1. V4 (Flash et Pro) est publié en poids ouverts (V4-Flash : environ 284B de paramètres au total, 13B actifs, licence MIT), mais relève de la classe serveur et non d'un modèle pour un seul GPU. Le journal des modifications de DeepSeek prévoyait l'arrêt, le 2026-07-24, des anciens noms d'API deepseek-chat et deepseek-reasoner (générations V3 et R1) ; l'API sert désormais la famille V4. Un « R1 hébergé » désigne donc ici les poids complets de R1 chez un hébergeur tiers ou sur votre propre cluster. Les distillations R1 traitées ici sont des publications distinctes en poids ouverts, non retirées par cet avis et toujours exécutables en local — ce sont des modèles de la génération précédente, pas la gamme la plus récente de DeepSeek.
📍 En une phrase
Un distill DeepSeek-R1 est un petit modèle existant (Qwen2.5 ou Llama 3.1/3.3) affiné pour imiter le raisonnement du R1 complet, et non une copie réduite de R1 lui-même.
💬 En termes simples
Imaginez le R1 complet comme un mathématicien chevronné et un distill comme un étudiant brillant qui a étudié ses solutions détaillées. L'étudiant raisonne de la même façon mais ne connaît pas tout ce que sait le maître.
Qu'est-ce que le DeepSeek-R1 671B complet ?
Le DeepSeek-R1 complet est un modèle Mixture-of-Experts (MoE) de 671 milliards de paramètres qui active environ 37B paramètres par token et nécessite environ 376–404 Go de VRAM en Q4 — matériel de datacenter uniquement. C'est le modèle qui génère le raisonnement de haute qualité que les distills apprennent à imiter.
MoE signifie que le modèle achemine chaque token via un petit sous-ensemble de sous-réseaux « experts », de sorte que seuls ~37B des 671B paramètres s'activent par token. Cela rend l'inférence moins coûteuse qu'un modèle 671B dense — mais chacun des 671B paramètres doit tout de même résider en mémoire, raison pour laquelle il ne tient pas sur du matériel grand public.
Unsloth propose un build dynamique en 1.58 bit du R1 complet (environ 131 Go), qui peut techniquement tourner sur une machine disposant d'au moins 80 Go de VRAM et de RAM cumulées ; mais Unsloth lui-même qualifie de « très lents » les montages à faible mémoire et cite environ 14 jetons par seconde pour un utilisateur unique sur 2x H100 80 Go. C'est une curiosité, pas une configuration domestique réaliste. En pratique, le R1 complet vit dans le cloud et les distills vivent sur votre machine.
Comment fonctionne la distillation de DeepSeek-R1 ?
DeepSeek a généré environ 800 000 échantillons de raisonnement avec le R1 complet, puis a affiné des modèles de base ouverts existants — Qwen2.5 (Math-1.5B, Math-7B, 14B, 32B) et Llama 3.x (3.1-8B, 3.3-70B-Instruct) — sur ces échantillons. Les modèles de base apprennent à reproduire le schéma de raisonnement pas à pas de R1 sans jamais contenir les paramètres de R1.
Il s'agit d'un affinage supervisé sur des traces de raisonnement de haute qualité, et non d'apprentissage par renforcement sur les petits modèles. Les distills héritent de la *forme* de la pensée de R1 — quand développer une chaîne de raisonnement, quand revenir en arrière, quand vérifier — superposée à ce que le modèle de base savait déjà.
C'est pourquoi le choix de la base compte tant. Un distill n'est aussi savant que sa base, plus la discipline de raisonnement copiée de R1. Une base faible avec d'excellentes traces de raisonnement plafonne tout de même en capacité brute.
📍 En une phrase
DeepSeek a affiné des modèles de base Qwen2.5 et Llama 3.1/3.3 sur ~800 000 échantillons de raisonnement générés par le R1 complet, transférant son style de raisonnement à de petits modèles.

Les six distills R1 officiels et leurs modèles de base
DeepSeek a publié six distills R1 sur quatre familles de modèles de base — Qwen2.5-Math, Qwen2.5, Llama 3.1 et Llama 3.3 — puis ajouté DeepSeek-R1-0528-Qwen3-8B sur une base Qwen3. Choisissez selon la base et la taille, pas selon le « R1 » du nom.
Distill | Modèle de base | AIME 2024 | Tag Ollama |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 28.9% | deepseek-r1:1.5b (1.1 GB) |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 55.5% | deepseek-r1:7b (4.7 GB) |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | 50.4% | Pas de tag dédié (voir note) |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | 69.7% | deepseek-r1:14b (9.0 GB) |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 72.6% | deepseek-r1:32b (20 GB) |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 70.0% | deepseek-r1:70b (43 GB) |
| DeepSeek-R1-0528-Qwen3-8B | Qwen3-8B Base | 86.0% | deepseek-r1:8b (5.2 GB) |
pass@1 AIME 2024 tel que publié sur les fiches de modèle Hugging Face de DeepSeek ; le chiffre 0528 provient d'une évaluation distincte, lisez donc les écarts entre lignes comme indicatifs. Le 32B obtient un score plus élevé que le 70B sur AIME 2024 (72.6 % contre 70.0 %). Les six distills sont sous licence MIT, mais chaque modèle de base garde sa propre licence (Apache 2.0 pour Qwen2.5, licences communautaires Llama pour les distills basés sur Llama). Le tag Ollama deepseek-r1:8b, et un simple ollama run deepseek-r1, téléchargent R1-0528-Qwen3-8B — pas le distill Llama-8B d'origine.
Que conserve la distillation ?
La distillation transfère de manière fiable les trois comportements qui font de R1 un solide raisonneur : chaîne de raisonnement, auto-vérification et réflexion. Ils survivent car ce sont des schémas de génération de tokens, et les schémas sont précisément ce que l'affinage supervisé copie bien.
- Chaîne de raisonnement : le distill écrit les étapes intermédiaires avant la réponse finale, le cœur de sa force en maths et en logique.
- Auto-vérification : il contrôle ses propres résultats intermédiaires et détecte les erreurs en cours de raisonnement, pas seulement à la fin.
- Réflexion : il revient en arrière et reconsidère lorsqu'une piste semble fausse, au lieu de s'engager sur la première tentative.
- Résultat : selon la fiche de modèle de DeepSeek, un distill 7B atteint 55.5 % sur AIME 2024.
Que perd la distillation ?
La distillation ne peut pas transférer la capacité brute, l'étendue des connaissances ou la fiabilité du modèle 671B complet sur les problèmes les plus difficiles — une petite base a simplement moins d'espace pour stocker et combiner l'information. Plus le distill est petit, plus cet écart est grand.
Capacité | R1 671B complet | Distill 32B | Distill 7B |
|---|---|---|---|
| Structure de raisonnement (CoT, réflexion) | Référence | Très proche | Proche |
| Fiabilité sur les problèmes les plus difficiles | La plus élevée | Forte | Modérée |
| Étendue du savoir général | La plus élevée | Bonne | Limitée |
| Problèmes longs à contraintes multiples | La meilleure | Bonne | Se dégrade |
| Tourne sur matériel grand public | Non | Oui (24 Go) | Oui (8 Go) |
Les classements sont indicatifs, pas exacts au benchmark : l'écart est faible sur les tâches de raisonnement courantes et grandit sur le travail à la limite du domaine ou exigeant un large savoir. Ces classements sont des appréciations éditoriales de PromptQuorum, pas des mesures.

L'écart compte-t-il pour votre cas d'usage ?
Pour la plupart du raisonnement local, l'écart est assez faible pour être ignoré ; il ne devient décisif que sur les problèmes à la limite du domaine ou les tâches exigeant un large savoir général. Décidez selon le cas d'usage, pas en courant après le plus gros modèle.
Un distill suffit-il ?
Utilisez un LLM local si :
- •Maths scolaires et de compétition, énigmes de logique, planification pas à pas → un distill suffit largement (32B pour la marge, 14B pour la plupart)
- •Raisonnement privé/hors ligne où les données ne peuvent pas quitter votre machine → un distill local garde les données sur votre machine et convient bien
- •Maîtrise des coûts face à une API hébergée → un distill local supprime entièrement le coût par token
Utilisez un modèle cloud si :
- •Maths de recherche ou preuves à la pointe du domaine → le R1 complet hébergé est plus fiable
- •Tâches exigeant un savoir général large et à jour → un modèle plus grand ou une configuration augmentée par la recherche l'emporte
- •Vous avez besoin de la réponse unique la plus fiable, quel que soit le coût → comparez aux modèles de pointe via PromptQuorum
Décision rapide :
- →En cas de doute, exécutez le distill 32B et n'escaladez vers le R1 hébergé que lorsqu'il peine visiblement.
- →Une meilleure base bat une plus grande taille du côté des petits modèles — voir R1-0528-Qwen3-8B ci-dessous.
R1-0528-Qwen3-8B : une meilleure base réduit l'écart
DeepSeek-R1-0528-Qwen3-8B montre qu'une base plus forte réduit l'écart de distillation : bâti sur Qwen3 8B avec le raisonnement du R1-0528 mis à jour, il domine les modèles 8B ouverts sur AIME 2024 et marque environ 10 points de plus que la base Qwen3 8B. Même classe de taille que le distill 8B d'origine, un raisonnement nettement meilleur — parce que la base est meilleure et la source de raisonnement plus récente.
La leçon pour choisir un distill : du côté des petits modèles, préférez le modèle à la base plus forte et plus récente plutôt qu'un distill plus ancien au même nombre de paramètres. La capacité par gigaoctet progresse plus vite grâce à de meilleures bases qu'à la taille brute.
Astuce config : température 0.6 et pas de prompt système
Exécutez chaque distill DeepSeek-R1 à une température de 0.6 (0.5–0.7 est sûr) sans prompt système — placez toutes les instructions dans le prompt utilisateur. Cela évite le mode d'échec de répétition et d'incohérence auquel la famille R1 est sujette quand on lui donne un prompt système ou une température proche de 0 ou supérieure à ~0.8.
Si vous comparez un distill au R1 complet hébergé et que le distill boucle ou dérive, corrigez la configuration avant de conclure que le distill est faible — de mauvais réglages d'échantillonnage masquent sa vraie qualité.
Exception : DeepSeek-R1-0528-Qwen3-8B accepte un prompt système. Sa fiche de modèle indique que le préfixe <think> forcé n'est plus nécessaire, et la température 0.6 (top-p 0.95 dans les évaluations de DeepSeek) reste valable. La règle « pas de prompt système » vaut pour le R1 d'origine et les six distills d'origine.
Questions fréquentes
Un distill DeepSeek-R1 est-il le même modèle que DeepSeek-R1, juste plus petit ?
Non. Un distill est un modèle de base différent (Qwen2.5 ou Llama 3.1/3.3) affiné pour imiter le raisonnement de R1 sur ~800K échantillons. Il conserve le style de raisonnement de R1 mais ne contient aucun de ses paramètres.
Que conserve exactement la distillation du R1 complet ?
Le comportement de raisonnement : chaîne de raisonnement, auto-vérification et réflexion. Ce sont des schémas de génération de tokens que l'affinage supervisé transfère de manière fiable, raison pour laquelle un distill 7B atteint 55.5 % sur AIME 2024.
Que perd un distill face au R1 671B complet ?
La capacité brute, l'étendue du savoir général et la fiabilité sur les problèmes les plus difficiles. Plus le distill est petit, plus l'écart est grand — même s'il reste faible sur les tâches de raisonnement courantes.
Pourquoi ne puis-je pas exécuter le DeepSeek-R1 671B complet chez moi ?
Il nécessite ~376–404 Go de VRAM en Q4 car les 671B paramètres doivent tous résider en mémoire même si seuls ~37B s'activent par token. C'est du matériel de datacenter. Selon Unsloth, un build dynamique en 1.58 bit existe, mais il est très lent sur du matériel grand public — une curiosité, pas une configuration pratique.
L'écart compte-t-il pour un usage quotidien ?
Généralement non. Pour les maths scolaires et de compétition, la logique et la planification multi-étapes, un distill 14B ou 32B suffit largement. L'écart compte pour les problèmes à la limite du domaine ou les tâches exigeant un savoir large et à jour.
Quel distill est le plus proche du R1 complet ?
Le distill 70B est le plus grand des six et le plus proche en capacité brute, mais il exige une configuration bi-GPU et obtient un score inférieur à celui du 32B sur AIME 2024 (70.0 % contre 72.6 %). Le 32B est l'option mono-GPU la plus forte des six sur AIME 2024, et la fiche de modèle de DeepSeek indique qu'il surpasse OpenAI o1-mini sur divers benchmarks.
Pourquoi R1-0528-Qwen3-8B est-il meilleur que le distill 8B d'origine ?
Il utilise une base Qwen3 8B plus forte et le raisonnement du R1-0528 mis à jour, ce qui lui permet de dominer les modèles 8B ouverts sur AIME 2024 — environ 10 points au-dessus de la base Qwen3 8B à taille égale.
DeepSeek-V3 est-il un distill de R1 ?
Non. DeepSeek-V3 est un modèle de chat MoE 671B distinct, pas un modèle de raisonnement ni un distill. R1 est le modèle de raisonnement ; les distills imitent R1, pas V3.
Quelle est la différence entre DeepSeek-R1 et DeepSeek-R1-Distill ?
DeepSeek-R1 est le modèle de raisonnement Mixture-of-Experts de 671B ; un modèle DeepSeek-R1-Distill est un modèle Qwen ou Llama plus petit, affiné sur des échantillons de raisonnement générés par R1. Le nom indique la source (R1) et la base (Qwen ou Llama), et c'est la base qui fixe le plafond de connaissances.
Quel tag Ollama correspond à quel distill DeepSeek-R1 ?
Les tags 1.5b, 7b, 14b, 32b et 70b correspondent aux distills Qwen ou Llama du même nom, et 671b est le R1 complet. Le tag 8b — que télécharge aussi un simple ollama run deepseek-r1 — est DeepSeek-R1-0528-Qwen3-8B, pas le distill Llama-8B d'origine.
DeepSeek-R1 est-il encore le modèle le plus récent de DeepSeek ?
Non. La génération actuelle de DeepSeek est DeepSeek-V4 (Flash et Pro), publiée en poids ouverts. R1 et V3 sont des modèles de la génération précédente, et le journal des modifications de DeepSeek prévoyait l'arrêt des noms d'API deepseek-chat et deepseek-reasoner le 2026-07-24. Les distillations R1 sont des publications distinctes en poids ouverts que cet avis n'a pas retirées : elles s'exécutent donc toujours en local, mais ne constituent plus la gamme la plus récente de DeepSeek.
Journal des mises à jour
- Publié le 19/06/2026. Prochaine révision prévue le 19/06/2027 (palier de fraîcheur annuel — explication intemporelle avec des faits modèles ancrés sur l'année).
- Couvre le R1 671B complet face aux six distills officiels et à DeepSeek-R1-0528-Qwen3-8B. Comparaison interne au raisonnement uniquement ; les comparaisons de code entre modèles figurent dans le guide de code.
- Mis à jour le 19/10/2026 : ajout du tableau de référence des six distills (modèles de base, AIME 2024, tags Ollama), correction de la liste des modèles de base, précision que le tag deepseek-r1:8b correspond à R1-0528-Qwen3-8B et mention de son exception pour le prompt système.
- Mis à jour le 2026-10-19 (contrôle de génération) : DeepSeek-V4 indiqué comme génération actuelle et R1/V3 comme génération précédente, distillations R1 présentées comme publications distinctes en poids ouverts toujours utilisables en local, et références aux modèles de base Llama 3 précisées en Llama 3.1/3.3.