النقاط الرئيسية
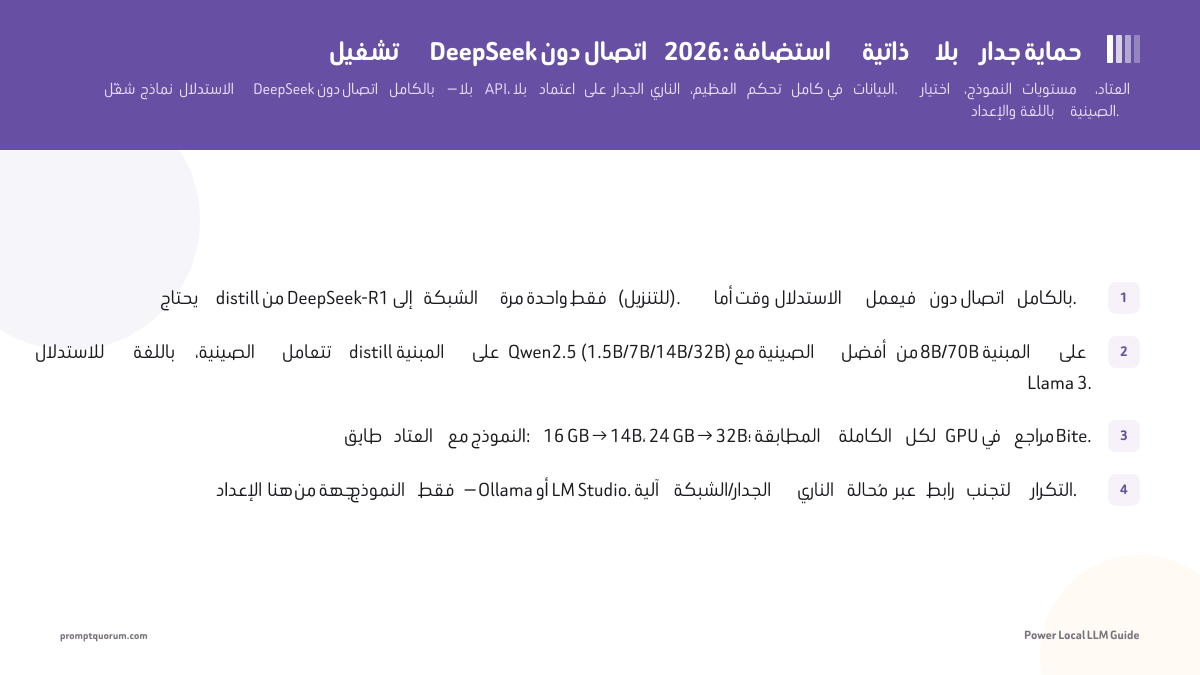
- يحتاج distill من DeepSeek-R1 إلى الشبكة مرة واحدة فقط (للتنزيل). أما وقت الاستدلال فيعمل دون اتصال بالكامل.
- للاستدلال باللغة الصينية، تتعامل distill المبنية على Qwen2.5 (1.5B/7B/14B/32B) مع الصينية أفضل من 8B/70B المبنية على Llama 3.
- طابِق العتاد مع النموذج: 16 GB → 14B، 24 GB → 32B؛ المطابقة الكاملة لكل GPU في مراجع Bite.
- الإعداد هنا من جهة النموذج فقط — Ollama أو LM Studio. آلية الشبكة/الجدار الناري مُحالة عبر رابط لتجنب التكرار.
- تحقق من «دون اتصال» تجريبيًا: احجب الشبكة أو راقب حركة المرور الصادرة أثناء جلسة وأكّد انعدام الصادر تمامًا.
- الاستضافة الذاتية دون اتصال تعني انعدام الاعتماد على الجدار الناري العظيم وانعدام تدفق البيانات عبر الحدود.
- شغّل كل distill بدرجة حرارة 0.6 وبلا موجِّه نظام.
لماذا تشغّل DeepSeek دون اتصال؟
تشغيل DeepSeek دون اتصال يمنحك تحكمًا كاملًا في البيانات ويزيل أي اعتماد على API مستضاف أو على ظروف الشبكة — يجيب النموذج من عتاد محلي دون أن يغادر الجهاز شيء. بالنسبة للعمل الحساس للسيادة، هذا هو الفرق بين أداة تتحكم فيها وخدمة تعتمد عليها.
تسود أربعة دوافع: سيادة البيانات (المُوجِّهات والمخرجات لا تغادر بيئتك أبدًا)، وانعدام فاتورة API لكل رمز بعد شراء العتاد، والاستقلال عن قيود الشبكة (ملموس للمستخدمين خلف الجدار الناري العظيم — لا يملك النموذج دون اتصال أي نقطة نهاية أجنبية للوصول إليها)، والموثوقية (لا انقطاع ولا حد للمعدل على نقطة نهاية مستضافة). لا شيء من هذه الدوافع هو «إنه أرخص تلقائيًا» — راجع مقارنة التكلفة أدناه.
هذا هو النظير العملي لتحليل الخصوصية في هل يحل DeepSeek المحلي مشكلة بيانات الصين؟ — تشرح تلك الصفحة لماذا تزيل الاستضافة الذاتية المحلية القلق بشأن تدفق البيانات؛ وهذه توضّح كيفية بنائها وأي عتاد تشتريه.
📍 في جملة واحدة
تشغيل DeepSeek دون اتصال يبقي كل مُوجِّه ومخرج على عتاد محلي، ويزيل الاعتماد على API مستضاف وأي قيد شبكي.
💬 بعبارات بسيطة
النموذج دون اتصال أشبه بكتاب تملكه مقابل موقع تزوره. بمجرد وجوده على رفّك، لا تحتاج إلى الإنترنت — ولا إلى إذن أحد — لقراءته.

DeepSeek محلي مقابل API الخاص بـ DeepSeek
لا تفترض أن التشغيل المحلي أرخص — تسعير API المستضاف من DeepSeek منخفض جدًا، لذا فالسبب الصادق للاستضافة الذاتية هو الخصوصية والتحكم والعمل دون اتصال، وليس توفيرًا مضمونًا. حتى 25 أغسطس 2026 (تم التحقق منه مقابل صفحة تسعير API الرسمية لـ DeepSeek)، تبلغ تكلفة DeepSeek-V4 Flash 0.007 $/0.22 $ لكل مليون رمز إدخال (إصابة/عدم إصابة ذاكرة التخزين المؤقت، خارج ساعات الذروة) و0.66 $ لكل مليون رمز إخراج خارج ساعات الذروة؛ وتبلغ تكلفة DeepSeek-V4 Pro 0.022 $/0.66 $ للإدخال و1.98 $ للإخراج خارج ساعات الذروة، وتتضاعف هذه الأسعار تقريبًا خلال ساعات الذروة في أيام الأسبوع (01:00–04:00 و06:00–10:00 بتوقيت UTC). بهذا التسعير، يمكن للمستخدم الخفيف أو العرضي أن ينفق مبلغًا ضئيلًا جدًا على API لفترة طويلة قبل أن يُسترد ثمن العتاد.
يعتمد حساب نقطة التعادل كليًا على حجم استخدامك: الاستخدام اليومي المكثف (ملايين الرموز شهريًا) يميل الكفة نحو العتاد خلال أشهر؛ أما الاستخدام العرضي أو المتقطع فقد لا يصل إلى التعادل أبدًا. استخدم حاسبة تكلفة الذكاء الاصطناعي المحلي من PromptQuorum بإنفاقك الشهري المتوقع للحصول على رقم حقيقي بدلًا من التخمين.
العامل | API الخاص بـ DeepSeek | DeepSeek محلي |
|---|---|---|
| العتاد | لا شيء | 400–2,800 $+ حسب المستوى (راجع قسم الميزانية) |
| الإنترنت | مطلوب | غير مطلوب بعد تنزيل النموذج |
| التكلفة لكل رمز | نعم (راجع التسعير أعلاه) | بلا تكلفة API متكررة |
| الخصوصية | تُرسَل المُوجِّهات إلى نقطة نهاية مستضافة | لا شيء يغادر الجهاز |
| الصيانة | لا شيء | تدير العتاد وحزمة البرمجيات بنفسك |
| التحكم بالنموذج | مستضاف، يتحكم فيه المزوّد | تحكم ذاتي، أي distill تختاره |
| قابل للعمل دون اتصال | لا | نعم، بعد التنزيل لمرة واحدة |
| الأنسب لـ | الاستخدام العرضي، الراحة | الاستخدام اليومي/المكثف، الخصوصية، السيادة |
السبب الحقيقي للاستضافة الذاتية هو الخصوصية + الاستقلالية + التحكم — وليس توفيرًا تلقائيًا في التكلفة. إذا كنت تستخدم DeepSeek بشكل عرضي، فمن المرجح جدًا أن يكون API أرخص وأبسط.
أي distill من DeepSeek هو الأفضل للاستدلال باللغة الصينية؟
للاستدلال باللغة الصينية، اختر distill من DeepSeek-R1 مبنية على Qwen2.5 (7B أو 14B أو 32B) — دُرِّب Qwen2.5 بتغطية قوية للصينية، فتتعامل هذه الـ distill مع المُوجِّهات والمخرجات الصينية أفضل بوضوح من 8B و70B المبنية على Llama 3. سلوك الاستدلال متطابق عبر الـ distill؛ والنموذج الأساس هو ما يحدد جودة اللغة.
خيارات عملية لأعباء العمل الصينية: 14B على بطاقة 16 GB هو الخيار المتوازن الافتراضي، و32B على بطاقة 24 GB هو أقوى خيار بوحدة GPU واحدة. كلاهما يستدل بالصينية بطلاقة بفضل أساس Qwen2.5. احتفظ بـ distill المبنية على Llama للعمل المهيمن عليه الإنجليزية أو لمتطلبات ترخيص Llama.
استعلامات رئيسية يخدمها هذا: 本地部署 deepseek (نشر DeepSeek محليًا)، deepseek 离线 (DeepSeek دون اتصال)، وdeepseek 私有化部署 (النشر الخاص لـ DeepSeek). الإجابة للثلاثة واحدة — distill مبنية على Qwen2.5 تعمل محليًا عبر Ollama أو LM Studio.
📍 في جملة واحدة
للاستدلال باللغة الصينية، اختر distill من DeepSeek-R1 مبنية على Qwen2.5 (7B/14B/32B)؛ يتعامل أساس Qwen مع الصينية أفضل بكثير من distill المبنية على Llama.
أي نموذج تشغّل، وكم VRAM تحتاج؟
طابِق الـ distill مع VRAM لديك وحالة استخدامك — المستويات نفسها لأي نشر من DeepSeek-R1، إضافة إلى ما يناسبه كل مستوى واقعيًا. هذه النسخة الموجزة؛ ومرجعا Bite يحتويان الجدول الكامل لكل GPU وVRAM لكل تكميم.
- رأي PromptQuorum: بالنسبة لمعظم الأشخاص، يمثل 14B أو 32B نقطة التوازن المثلى. القفز إلى 70B فئة عتاد مختلفة فعليًا (GPU مزدوجة، محطة عمل بذاكرة كبيرة، تبريد وطاقة جادّان) — تعامل معه كقرار شراء مستقل، لا كخطوة طبيعية تالية لـ 32B.
- النموذج الكامل بحجم 671B ليس هدفًا لجهاز مستهلك عادي. إذا احتاج عبء عملك إلى هذا الحجم، فقارن بناء محطة عمل ذكاء اصطناعي مخصصة بتكاليف السحابة/API بدلًا من تجميعها قطعة بقطعة — راجع دليل بناء محطة عمل الذكاء الاصطناعي المحلي.
VRAM | أفضل distill (دون اتصال) | الحكم | الأنسب لـ |
|---|---|---|---|
| 8 GB | 7B أو R1-0528-Qwen3-8B | نقطة دخول جيدة | أجهزة محمولة، بطاقات GPU اقتصادية، خوادم صغيرة، تجريب |
| 16 GB | 14B (Qwen2.5) | أفضل قيمة | معظم المستخدمين الجادين؛ خيار متوازن افتراضي، صينية قوية |
| 24 GB | 32B (Qwen2.5) | أفضل GPU واحدة | الهواة الراغبون في ترقية حقيقية دون تعدد وحدات GPU |
| 48 GB+ / GPU مزدوجة | 70B (Llama 3) | نطاق محطة عمل جادة | للمحترفين؛ مخرجات صينية أضعف من distill المبنية على Qwen |
| ~400 GB+ | DeepSeek-R1 الكامل (671B) | ليس عبء عمل استهلاكي عادي | عناقيد GPU متعددة بمستوى المؤسسات فقط — لا تشترِ mini PC متوقعًا هذا |
لنقطة نهاية دون اتصال تعمل دائمًا وبطاقة منخفضة، يشغّل mini PC القادر الـ distill 7B و14B بهدوء — راجع أفضل أجهزة mini PC لـ LLM المحلية. للمطابقة الدقيقة لوحدة GPU راجع مراجع Bite في الأدلة ذات الصلة.
أفضل فئات العتاد لـ DeepSeek محلي
بدلًا من الاكتفاء بذكر منتج واحد، إليك المسارات الأربعة الواقعية للعتاد — اختر ما يناسب أولوياتك، ثم استخدم الدليل المخصص للاختيارات والأسعار الحالية.
- GPU من NVIDIA — الأفضل لأقصى أداء وتوافق. الخيار الافتراضي: أوسع دعم برمجي (تعمل Ollama وvLLM وllama.cpp جميعها جيدًا على CUDA)، أكبر عدد من خيارات VRAM مقابل السعر في مستويي 16 GB/24 GB، وأسهل استكشاف للأعطال لأن معظم أدوات LLM المحلية تُطوَّر أولًا على NVIDIA. راجع أفضل دليل شراء GPU لـ LLM المحلية للاختيارات الحالية.
- GPU من AMD — الأفضل للمشترين المستعدين للتعامل مع منظومة ROCm. قد تقدّم قيمة قوية مقابل السعر لكل VRAM، لكن تحقق من توافق ROCm/البرمجيات مع بيئة التشغيل الدقيقة لديك (Ollama، llama.cpp) قبل الشراء — الدعم أضيق من دعم NVIDIA ويختلف حسب جيل البطاقة.
- Apple Silicon — الأفضل لجهاز هادئ ومنخفض الاستهلاك بذاكرة موحدة كبيرة. الميزة ليست VRAM تقليدية لوحدة GPU، بل سعة الذاكرة المشتركة — يمكن لجهاز Mac بذاكرة موحدة كافية تحميل distill أكبر مما يستطيعه GPU منفصل بسعر مماثل، وباستهلاك طاقة أقل بكثير. راجع أفضل Mac للذكاء الاصطناعي المحلي.
- mini PC — الأفضل لخادم ذكاء اصطناعي محلي يعمل دائمًا. الخيار الصحيح إذا كان عبء العمل هو 7B، أو بعض 14B، أو تكامل Home Assistant، أو RAG، أو مساعد محلي يعمل في الخلفية بدلًا من أقصى سرعة استدلال. راجع أفضل أجهزة mini PC لـ LLM المحلية.
- استئجار GPU سحابي — الأفضل إذا أردت تجربة مستوى قبل الشراء، أو تحتاج قدرة إضافية عرضية. ليس «دون اتصال»، لكنه طريقة مشروعة لتجربة أداء بمستوى 32B/70B قبل الالتزام بالعتاد. راجع دليل استئجار GPU السحابي.
إعداد DeepSeek المحلي الذي نوصي به
لمعظم قرّاء PromptQuorum الراغبين في ترقية حقيقية للاستدلال المحلي دون الدخول في نطاق تعدد وحدات GPU: GPU بسعة 24 GB، وذاكرة نظام 64 GB، وتخزين NVMe بسعة 2 TB، مع تشغيل DeepSeek-R1 32B عبر Ollama. هذه مواصفة مستهدفة، لا منتج محدد — استخدم دليل شراء GPU المرتبط أدناه للاختيارات والأسعار الحالية.
- استخدامات واقعية عند هذا المستوى: الاستدلال باللغة الصينية، المساعدة في البرمجة، تحليل المستندات، مساعد خاص، RAG على مستندات محلية، وتجريب الوكلاء المحليين.
- ميزانية محدودة؟ انزل إلى مستوى 16 GB / 14B — راجع أي نموذج وكم VRAM؟ أعلاه، وتوزيع الميزانية أدناه.
المكوّن | المواصفة المستهدفة |
|---|---|
| GPU | 24 GB VRAM |
| ذاكرة النظام (RAM) | 64 GB |
| التخزين | 2 TB NVMe |
| البرمجيات | Ollama |
| النموذج | DeepSeek-R1-Distill-Qwen-32B |
كيف تُعدّ DeepSeek دون اتصال؟
الإعداد دون اتصال من جهة النموذج فقط: نزّل مرة واحدة، ثم شغّل بلا شبكة. هذه هي الخطوات مع Ollama (LM Studio هو المكافئ الرسومي — نزّل النموذج ثم انتقل إلى وضع عدم الاتصال).
- 1ثبّت Ollama أو LM Studio
Why it matters: يشغّلان النموذج محليًا بلا اعتماد خارجي وقت الاستدلال؛ ثبّت مرة واحدة وأنت متصل. - 2نزّل الـ distill مرة واحدة
Why it matters: شغّل `ollama run deepseek-r1:14b` (أو مستواك) وأنت متصل — هذه هي الخطوة الوحيدة التي تحتاج إلى الشبكة. - 3افصل الشبكة أو احجبها
Why it matters: بعد تخزين النموذج مؤقتًا، اقطع الوصول إلى الشبكة؛ يقدّم النموذج الإجابات بالكامل من الأوزان المحلية. - 4اضبط درجة الحرارة على 0.6، وأفرغ موجِّه النظام
Why it matters: يمنع وضع فشل التكرار في R1؛ ضع كل التعليمات في موجِّه المستخدم. - 5شغّل الاستدلال دون اتصال
Why it matters: يبقى كل مُوجِّه ومخرج الآن على الجهاز بلا بيانات صادرة — أكّد ذلك بخطوة التحقق أدناه.
ollama pull deepseek-r1:14b    # مرة واحدة، متصل
# ثم افصل / احجب الشبكة
ollama run deepseek-r1:14b     # استدلال دون اتصال بالكامل
ماذا عن آلية الشبكة والجدار الناري؟
النموذج دون اتصال نفسه لا يحتاج إلى أي تهيئة لجدار ناري أو VPN أو نفق شبكي — فليس لديه نقطة نهاية أجنبية للوصول إليها — لذا فإن العمل الشبكي الوحيد هو ضمان ألا يتصل شيء آخر على الجهاز بالخارج. هذا الموضوع العام (قواعد الجدار الناري، العزل الشبكي، حجب الاتصالات الصادرة) مغطّى بتعمق في مكان آخر ولا يُكرَّر هنا.
للإعداد الكامل للجدار الناري والشبكة دون اتصال — بما في ذلك عزل محطة عمل وإحكام حركة المرور الصادرة — راجع الذكاء الاصطناعي المحلي خلف جدار ناري: دون اتصال 2026. يغطي هذا المقال اختيار نموذج DeepSeek وإعداد النموذج دون اتصال؛ وذاك يغطي آلية الشبكة.
كيف تتحقق من أنك دون اتصال فعلاً؟
أثبت حالة عدم الاتصال تجريبيًا: شغّل جلسة استدلال كاملة مع مراقبة حركة المرور الصادرة أو تعطيل الشبكة، وأكّد انعدام الاتصالات الصادرة من عملية النموذج. لا تفترض — برهِن، فهذا ما يجعل ادعاء السيادة قابلًا للتدقيق.
طريقتان سريعتان: عطّل محوّل الشبكة (أو افصل الكابل) وأكّد أن الاستدلال ما زال يعمل — برهان على أن النموذج لا يحتاج اتصالًا؛ أو أبقِ الشبكة قائمة لكن راقب الاتصالات الصادرة بالتقاط الحزم أو جدار ناري لكل عملية وأكّد أن عملية Ollama/LM Studio لا تفتح أيًّا منها أثناء الجلسة.
نصيحة احترافية للإعداد: درجة حرارة 0.6 وبلا موجِّه نظام
اضبط درجة الحرارة على 0.6 (0.5–0.7 آمن) ولا تستخدم موجِّه نظام — ضع كل التعليمات في موجِّه المستخدم. يتجنب هذا وضع فشل التكرار وعدم الترابط الذي تميل إليه distill من DeepSeek-R1، وهو مهم دون اتصال بقدر أهميته عبر الاتصال.
شراء العتاد أم استخدام API؟
هذا هو القرار الحقيقي، ويعتمد على مدى استخدامك الفعلي لـ DeepSeek — لا على أي خيار «أفضل» في المطلق.
- اشترِ عتادًا إذا: كنت تستخدم DeepSeek يوميًا، أو الخصوصية مهمة لعملك، أو تحتاج إلى تشغيل دون اتصال، أو تخطط لتشغيل عدة خدمات محلية على الجهاز نفسه، أو تملك بالفعل عتادًا مناسبًا، أو تريد وصولًا طويل الأمد يمكن التنبؤ به دون الاعتماد على تغييرات تسعير المزوّد.
- استخدم API إذا: كنت تستخدم DeepSeek بشكل عرضي، أو لا تريد صيانة عتاد أو حزمة برمجيات، أو تحتاج إلى أقصى سرعة استدلال دون شراء وحدات GPU بمستوى المؤسسات، أو كان التشغيل دون اتصال لا يهم فعليًا لحالة استخدامك.
- تسعير API الحالي لـ DeepSeek (الموثّق أعلاه) منخفض بما يكفي لجعل المستخدمين العرضيين على الأرجح في وضع أفضل بدفع تكلفة استخدام API فقط بدلًا من شراء عتاد لتوفير المال — حجة العتاد تتعلق بالخصوصية والتحكم، لا بتوفير مضمون.
- أجرِ حساباتك الخاصة باستخدام حاسبة تكلفة الذكاء الاصطناعي المحلي قبل اتخاذ القرار — أدخل إنفاقك الشهري المتوقع على API وسعر العتاد للحصول على تقدير فعلي لنقطة التعادل بدلًا من قاعدة تقريبية.
ميزانية العتاد حسب المستوى
سياق مهم لعام 2026: ارتفعت أسعار GPU وVRAM ارتفاعًا كبيرًا خلال العام الماضي بسبب ضغوط سوق الذاكرة — بطاقة مستعملة بسعة 24 GB كانت تُباع بنحو 1,000–1,300 $ في 2025 وأصبحت تُباع بنحو 2,200–2,800 $ حتى أغسطس 2026. ضع ميزانيتك وفقًا لذلك بدلًا من افتراض بقاء أسعار العام الماضي؛ أما مستوى الدخول 16 GB فقد ظل مستقرًا نسبيًا.
الميزانية | الهدف | ملاحظات |
|---|---|---|
| أقل من 500 $ | DeepSeek 7B، أعباء 14B صغيرة | أنظمة GPU مستعملة أو للمبتدئين |
| 500–900 $ | DeepSeek محلي 14B | GPU بسعة 16 GB — نقطة مثالية للمبتدئين، ظلت الأسعار هنا مستقرة نسبيًا |
| 1,500–3,000 $ | DeepSeek 32B | GPU بسعة 24 GB — أغلى بوضوح في 2026؛ تحقق من الأسعار الحالية |
| 3,000 $+ | ذكاء اصطناعي محلي جاد، مجال للنمو | GPU بسعة 24 GB+، ذاكرة 64–128 GB، عدة أقراص NVMe |
| 5,000 $+ | نماذج 70B وأكبر | قارن بناء محطة عمل ذكاء اصطناعي مخصصة بتكاليف السحابة/API عند هذه الميزانية — راجع دليل بناء محطة العمل |
ما لا يجب شراؤه
بضعة أخطاء شائعة تستحق أن تُذكر بوضوح، لأن الصفحة التي لا تقول إلا «اشترِ هذا» تبدو كصفحة بيع.
- لا تشترِ نظام GPU بأكثر من 2,000 $ فقط لتشغيل نموذج 7B — هذا هدر للمال فيما يكفيه مستوى الدخول أصلًا.
- لا تشترِ 128 GB من ذاكرة النظام دون عبء عمل يحتاجها فعليًا؛ VRAM، لا ذاكرة النظام، هي عادة عنق الزجاجة الحقيقي في استدلال GPU.
- لا تشترِ GPU من AMD لمجرد أن المواصفات على الورق تبدو مبهرة — تحقق أولًا من توافق ROCm/البرمجيات مع بيئة التشغيل الدقيقة لديك.
- لا تشترِ mini PC متوقعًا استدلالًا سريعًا لـ 70B أو 671B الكامل — متطلبات الذاكرة والحوسبة عند هذا الحجم فئة عتاد مختلفة تمامًا.
- لا تفترض أن التشغيل المحلي أرخص قبل إجراء الحسابات — من المرجح جدًا أن يكون API أنسب للمستخدم العرضي (راجع مقارنة التكلفة أعلاه).
الأسئلة الشائعة
هل يمكن لـ DeepSeek أن يعمل دون اتصال بالكامل؟
نعم. بمجرد تنزيل distill، يمكن أن يستمر الاستدلال مع تعطيل الشبكة — يمكنك فصل الشبكة أو حجبها بالكامل وسيظل يعمل من الأوزان المحلية.
هل يحتاج DeepSeek-R1 إلى VPN في الصين؟
ليس عند تشغيل النموذج محليًا. لا يملك النموذج دون اتصال أي نقطة نهاية أجنبية للوصول إليها، فشبكات VPN والالتفاف على الجدار الناري لا صلة لها بالاستدلال. المهمة الشبكية الوحيدة هي ضمان ألا يرسل شيء آخر على الجهاز بيانات للخارج.
أي distill من DeepSeek هو الأفضل للصينية؟
distill مبنية على Qwen2.5 (7B أو 14B أو 32B). يملك Qwen2.5 تغطية قوية للصينية، فتتعامل هذه الـ distill مع المُوجِّهات والمخرجات الصينية أفضل من distill 8B و70B المبنية على Llama 3.
كم VRAM يحتاجه DeepSeek 32B؟
GPU بسعة 24 GB هدف عملي لنشر 32B مُكمَّم، حسب التكميم وبيئة التشغيل — راجع جدول أي نموذج وكم VRAM أعلاه للتفصيل الكامل حسب المستوى.
هل يمكن لجهاز mini PC تشغيل DeepSeek؟
نعم، خصوصًا distill 7B وبعض إعدادات 14B. أجهزة mini PC خيار جيد لنقطة نهاية تعمل دائمًا وبطاقة منخفضة، لكنها عمومًا ليست الخيار الصحيح لأقصى أداء لـ DeepSeek أو لنماذج 70B فأكبر.
هل يمكنني تشغيل DeepSeek على Apple Silicon؟
نعم. يمكن أن تكون أنظمة Apple Silicon ذات الذاكرة الموحدة الكبيرة مثيرة للاهتمام بشكل خاص لتجريب LLM المحلية، لأن الميزة هي سعة الذاكرة المشتركة لا VRAM التقليدية لوحدة GPU — راجع قسم أفضل فئات العتاد أعلاه.
هل DeepSeek محلي أرخص من API؟
ليس بالضرورة. للعتاد تكلفة مقدَّمة كبيرة، وتسعير API الحالي لـ DeepSeek منخفض. أكبر مزايا النشر المحلي هي الخصوصية والتحكم والتشغيل دون اتصال، لا توفير مضمون في التكلفة — أجرِ حساباتك الخاصة باستخدام حاسبة التكلفة المرتبطة.
كيف أعرف أن النموذج دون اتصال لا يرسل بيانات إلى أي مكان؟
راقب حركة المرور الصادرة أثناء الجلسة أو عطّل الشبكة بالكامل وأكّد أن الاستدلال ما زال يعمل. لا يستلزم النموذج المُحمَّل محليًا بطبيعته اتصالًا بـ API الخاص بـ DeepSeek للاستدلال، لكن ينبغي التحقق من ذلك تجريبيًا لنشرك الخاص بدلًا من افتراضه.
ما العتاد الذي يشغّل DeepSeek دون اتصال جيدًا؟
يشغّل GPU بسعة 16 GB الـ distill 14B، ويشغّل GPU بسعة 24 GB الـ 32B. لنقطة نهاية هادئة تعمل دائمًا، يتعامل mini PC القادر مع 7B و14B. راجع ملاحظات GPU وVRAM للمطابقة الدقيقة، وقسم أفضل فئات العتاد لمقارنة NVIDIA/AMD/Apple Silicon/mini PC.
هل يمكنني تشغيل DeepSeek-R1 الكامل دون اتصال؟
ليس على عتاد المستهلك. يحتاج R1 الكامل بحجم 671B إلى نحو 400 GB+ من VRAM عند تكميم بمستوى Q4. تستخدم الاستضافة الذاتية دون اتصال عمليًا الـ distill (1.5B–70B) التي تعمل على وحدات GPU محلية.
أين تذهب خطوات الجدار الناري والشبكة؟
لا يعيد هذا الدليل عمدًا شرح آلية الجدار الناري والعزل الشبكي. راجع «الذكاء الاصطناعي المحلي خلف جدار ناري: دون اتصال 2026» للإحكام الشبكي الكامل؛ وهنا نغطي اختيار نموذج DeepSeek والعتاد وإعداد النموذج دون اتصال.
ما الإعدادات التي يجب أن أستخدمها لـ DeepSeek دون اتصال؟
درجة حرارة 0.6 بلا موجِّه نظام، والتعليمات في رسالة المستخدم. هذه هي التهيئة القياسية لـ DeepSeek-R1 وتمنع وضع فشل التكرار.
سجل التحديثات
- تحديث شامل للصفحة كصفحة تابعة بتاريخ 2026-08-25: إضافة تفصيل فئات العتاد (NVIDIA/AMD/Apple Silicon/mini PC/سحابة)، وإعداد مستهدف موصى به، ومقارنة تسعير موثّقة لـ API الخاص بـ DeepSeek، وقسم قرار الشراء مقابل API، وجدول ميزانية عتاد 2026 مُصحَّح (ارتفعت أسعار GPU/VRAM بوضوح على أساس سنوي)، وقسم «ما لا يجب شراؤه». تصحيح ادعاء مبالغ فيه («أوزان DeepSeek المفتوحة لا تحتوي على قياس عن بُعد» ← تحقق تجريبيًا حسب كل نشر بدلًا من التأكيد القاطع).
- نُشِر في 2026-06-19. المراجعة التالية مستحقة في 2026-09-25 (مستوى تحديث شهري، يعكس التغير السريع في أسعار GPU/API).
- يغطي اختيار نموذج DeepSeek دون اتصال، واختيار النموذج باللغة الصينية، واختيار فئة العتاد، وإعداد النموذج دون اتصال. آلية الشبكة/الجدار الناري مُحالة عبر رابط عمدًا. يُموّل هذا الدليل من البنية التحتية للعتاد المحيطة بـ DeepSeek (أدلة GPU/Mac/mini PC/محطة العمل)، لا من API الخاص بـ DeepSeek نفسه.