¿Por qué ejecutar DeepSeek sin conexión?
Ejecutar DeepSeek sin conexión te da control directo sobre tus datos y elimina la dependencia de la inferencia de una API alojada o de las condiciones de red — el modelo responde desde hardware local, así que la inferencia no depende de ningún endpoint externo. Para el trabajo sensible a la soberanía, esta es la diferencia entre una herramienta que controlas y un servicio del que dependes.
Predominan cuatro motivaciones: soberanía de datos (los prompts y las salidas permanecen en tu entorno mientras nada más en el equipo los envíe al exterior), sin factura de API por token una vez comprado el hardware, independencia de las restricciones de red (algo concreto para usuarios tras el Gran Cortafuegos — un modelo sin conexión no tiene ningún endpoint extranjero que alcanzar) y fiabilidad (sin caídas ni límites de tasa en un endpoint alojado). Ninguna de estas razones es "es automáticamente más barato" — consulta la comparación de costes más abajo.
Esta es la contraparte práctica del análisis de privacidad en ¿Resuelve DeepSeek local el problema de datos de China? — esa página explica por qué el autoalojamiento local elimina la preocupación por el flujo de datos; esta muestra cómo construirlo y qué hardware comprar.
📍 En una frase
Ejecutar DeepSeek sin conexión mantiene cada prompt y salida en hardware local, eliminando la dependencia de una API alojada y cualquier restricción de red.
💬 En términos simples
Un modelo sin conexión es como un libro que posees frente a un sitio web que visitas. Una vez en tu estante, no necesitas internet — ni el permiso de nadie — para leerlo.

DeepSeek local frente a la API de DeepSeek
No des por hecho que lo local es más barato — el precio de la API alojada de DeepSeek es muy bajo, así que la razón honesta para autoalojar es la privacidad, el control y el funcionamiento sin conexión, no un ahorro garantizado. A fecha del 2026-10-19 (verificado en la página oficial de precios de la API de DeepSeek), DeepSeek-V4.1 Flash cuesta $0.003/$0.15 por millón de tokens de entrada (acierto de caché/fallo de caché, fuera de hora punta) y $0.60 por millón de tokens de salida fuera de hora punta; DeepSeek-V4 Pro cuesta $0.022/$0.66 de entrada y $1.98 de salida fuera de hora punta, prácticamente el doble en horas punta entre semana (01:00–04:00 y 06:00–10:00 UTC). Con esos precios, un usuario ligero u ocasional puede gastar muy poco en la API durante mucho tiempo antes de que el hardware se amortice.
El punto de equilibrio depende por completo de tu volumen de uso: un uso intensivo diario (muchos millones de tokens al mes) inclina la balanza hacia el hardware en cuestión de meses; un uso ocasional o irregular puede no llegar nunca a amortizarse. Usa la calculadora de coste de IA local de PromptQuorum con tu propio gasto mensual esperado para obtener una cifra real en lugar de suponer.
Factor | API de DeepSeek | DeepSeek local |
|---|---|---|
| Hardware | Ninguno | $400–2.800+ según el nivel (ver sección de presupuesto) |
| Internet | Necesario | No hace falta tras descargar el modelo |
| Coste por token | Sí (ver precios arriba) | Sin coste de API continuo |
| Privacidad | Los prompts se envían a un endpoint alojado | La inferencia se queda en la máquina |
| Mantenimiento | Ninguno | Gestionas tú el hardware y el software |
| Control del modelo | Alojado, controlado por el proveedor | Bajo tu control, cualquier distill que elijas |
| Funciona sin conexión | No | Sí, tras la descarga única |
| Ideal para | Uso ocasional, comodidad | Uso diario/intensivo, privacidad, soberanía |
La razón real para autoalojar es la privacidad + independencia + control — no un ahorro de costes automático. Si usas DeepSeek de forma ocasional, es muy probable que la API sea más barata y sencilla.
¿Qué distill de DeepSeek es mejor para el razonamiento en chino?
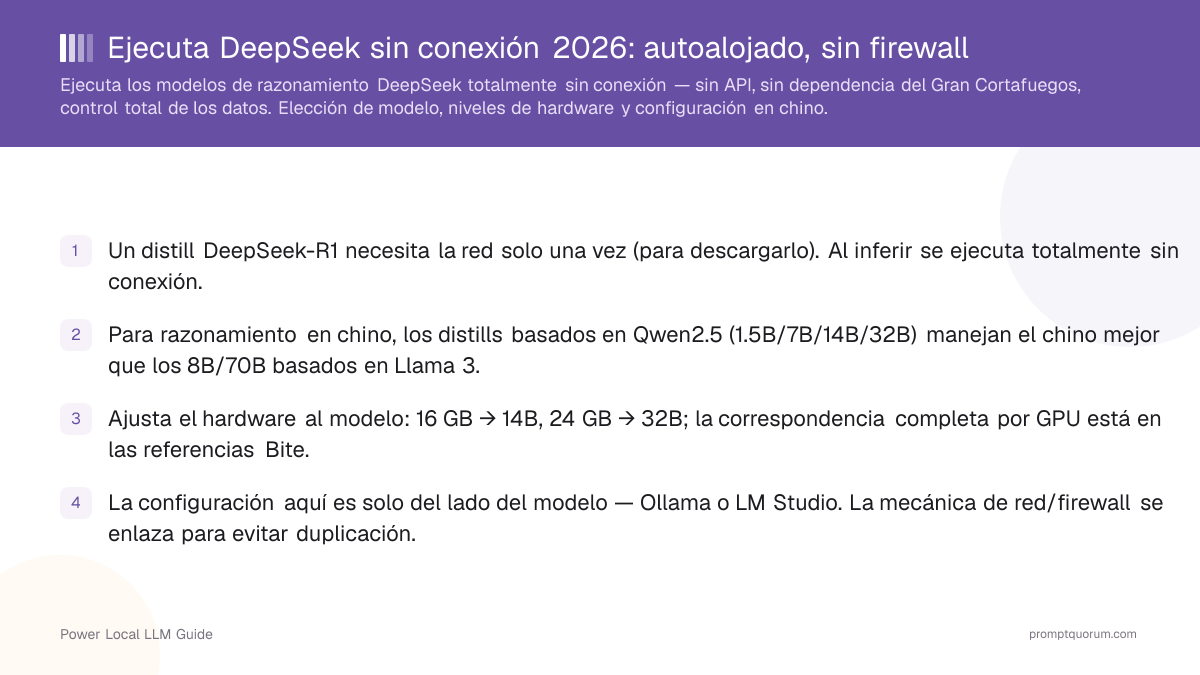
Para razonamiento en chino, elige un distill DeepSeek-R1 basado en Qwen2.5 (7B, 14B o 32B) — Qwen2.5 incluye el chino entre sus idiomas compatibles, mientras que Llama 3.1/3.3 no lo incluye entre sus idiomas oficialmente compatibles; por eso los distills basados en Qwen2.5 son la opción por defecto más segura para prompts y salidas en chino frente a los 8B y 70B basados en Llama (criterio editorial, no evaluado aquí con benchmarks). El comportamiento de razonamiento es el mismo en todos los distills; el modelo base es lo que determina la calidad del idioma.
Elecciones prácticas para cargas de trabajo en chino: el 14B en una tarjeta de 16 GB es la opción equilibrada por defecto, y el 32B en una tarjeta de 24 GB es la mejor opción de una sola GPU. Ambos razonan en chino con fluidez gracias a la base Qwen2.5. Reserva los distills basados en Llama para trabajo predominantemente en inglés o cuando la licencia de Llama sea un requisito.
Consultas principales a las que responde esta sección: 本地部署 deepseek (desplegar DeepSeek en local), deepseek 离线 (DeepSeek sin conexión) y deepseek 私有化部署 (despliegue privado de DeepSeek). La respuesta a las tres es la misma: un distill basado en Qwen2.5 ejecutado en local con Ollama o LM Studio.
📍 En una frase
Para razonamiento en chino, elige un distill DeepSeek-R1 basado en Qwen2.5 (7B/14B/32B); la base Qwen es la opción por defecto más segura para el chino frente a los distills basados en Llama.
¿Qué modelo deberías ejecutar y cuánta VRAM necesitas?
Ajusta el distill a tu VRAM y caso de uso — los mismos niveles que cualquier despliegue de DeepSeek-R1, además de para qué sirve realmente cada nivel. Esta es la versión breve; las dos referencias Bite tienen la tabla completa por GPU y la VRAM por cuantización.
- La opinión de PromptQuorum: para la mayoría de las personas, 14B o 32B es el punto óptimo. El salto a 70B es una categoría de hardware genuinamente distinta (GPUs dobles, estación de trabajo con mucha memoria, refrigeración y alimentación serias) — trátalo como una decisión de compra propia, no como el siguiente paso natural desde 32B.
- El modelo completo de 671B no es un objetivo normal para un PC de consumo. Si tu carga de trabajo necesita esa escala, compara una estación de trabajo de IA dedicada frente a los costes de la nube/API en lugar de montarla pieza por pieza — consulta la guía de construcción de estación de trabajo de IA local.
VRAM | Mejor distill (sin conexión) | Veredicto | Ideal para |
|---|---|---|---|
| 8 GB | 7B o R1-0528-Qwen3-8B | Buen punto de entrada | Portátiles, GPUs económicas, servidores pequeños, experimentación |
| 16 GB | 14B (Qwen2.5) | Mejor relación calidad-precio | La mayoría de usuarios serios; opción equilibrada, chino sólido |
| 24 GB | 32B (Qwen2.5) | Mejor de una sola GPU | Entusiastas que quieren un salto real sin multi-GPU |
| 48 GB+ / GPU dual | 70B (Llama 3.1/3.3) | Terreno de estación de trabajo seria | Profesionales; salida en chino más débil que los distills Qwen |
| ~400 GB+ | DeepSeek-R1 completo (671B) | No es una carga de consumo normal | Solo clústeres multi-GPU de nivel empresarial — no compres un mini PC esperando esto |
Para un endpoint sin conexión siempre activo y de bajo consumo, un mini PC capaz ejecuta los distills 7B y 14B de forma silenciosa — consulta los mejores mini PCs para LLM local. Para la correspondencia exacta de GPU, consulta las referencias Bite en Guías relacionadas.
Las mejores clases de hardware para DeepSeek local
En lugar de mencionar un solo producto, aquí tienes las cuatro rutas de hardware realistas — elige la que se ajuste a tus prioridades y luego usa la guía dedicada para ver las opciones y precios actuales.
- GPU NVIDIA — la mejor opción para máximo rendimiento y compatibilidad. La opción por defecto habitual: un amplio soporte de software (Ollama, vLLM y llama.cpp admiten CUDA) y, como gran parte de las herramientas de LLM local se desarrollan primero para NVIDIA, normalmente la resolución de problemas más sencilla. Consulta la mejor guía de compra de GPU para LLM local para ver las opciones actuales.
- GPU AMD — la mejor opción para quienes están dispuestos a trabajar con el ecosistema ROCm. Puede ofrecer una VRAM por dólar potencialmente mejor, pero verifica la compatibilidad de ROCm/software con tu runtime exacto (Ollama, llama.cpp) antes de comprar — el soporte es más limitado que el de NVIDIA y varía según la generación de la tarjeta.
- Apple Silicon — la mejor opción para una máquina silenciosa y de bajo consumo con memoria unificada amplia. La ventaja no es la VRAM tradicional de GPU, sino la capacidad de memoria compartida — un Mac con suficiente RAM unificada puede cargar distills más grandes que una GPU discreta con menos VRAM y suele consumir menos energía — compara los precios y benchmarks actuales para tu modelo. Consulta el mejor Mac para IA local.
- Mini PC — la mejor opción para un servidor de IA local siempre activo. La decisión correcta si la carga de trabajo es 7B, algo de 14B, integración con Home Assistant, RAG o un asistente local en segundo plano, en lugar de la máxima velocidad de inferencia. Consulta los mejores mini PCs para LLM local.
- Alquiler de GPU en la nube — la mejor opción si quieres probar un nivel antes de comprar, o necesitas capacidad puntual ocasional. No es "sin conexión", pero es una forma legítima de probar un rendimiento de clase 32B/70B antes de comprometerte con el hardware. Consulta la guía de alquiler de GPU en la nube.
Nuestra configuración local de DeepSeek recomendada
Para la mayoría de los lectores de PromptQuorum que quieren un salto real en razonamiento local sin entrar en terreno multi-GPU: una GPU de 24 GB, 64 GB de RAM del sistema y 2 TB de almacenamiento NVMe, ejecutando DeepSeek-R1 32B a través de Ollama. Esto es un objetivo de configuración, no un producto específico — usa la guía de compra de GPU enlazada abajo para ver las opciones y precios actuales.
- Usos realistas en este nivel: razonamiento en chino, asistencia con código, análisis de documentos, un asistente privado, RAG sobre documentos locales y experimentación con agentes locales.
- ¿Presupuesto limitado? Baja al nivel de 16 GB / 14B — consulta ¿Qué modelo deberías ejecutar y cuánta VRAM necesitas? arriba y el desglose de presupuesto más abajo.
Componente | Especificación objetivo |
|---|---|
| GPU | 24 GB de VRAM |
| RAM del sistema | 64 GB |
| Almacenamiento | 2 TB NVMe |
| Software | Ollama |
| Modelo | DeepSeek-R1-Distill-Qwen-32B |
¿Cómo configuras DeepSeek sin conexión?
La configuración sin conexión es solo del lado del modelo: descarga una vez y luego ejecuta sin red. Estos son los pasos con Ollama (LM Studio es el equivalente con interfaz gráfica — descarga el modelo y luego desconéctate).
- 1Instala Ollama o LM Studio
Why it matters: Ejecutan el modelo en local sin ninguna dependencia externa al inferir; instálalo una vez estando conectado. - 2Descarga el distill una vez
Why it matters: Ejecuta `ollama run deepseek-r1:14b` (o tu nivel) mientras estás conectado — este es el único paso que necesita red. - 3Desconecta o bloquea la red
Why it matters: Una vez el modelo está en caché, corta el acceso a la red; el modelo entrega respuestas desde los pesos locales. - 4Pon la temperatura en 0.6 y vacía el prompt de sistema
Why it matters: Evita el modo de fallo por repetición de R1; pon todas las instrucciones en el prompt del usuario. - 5Ejecuta la inferencia sin conexión
Why it matters: Los prompts y las salidas se procesan ahora en local — confirma con el paso de verificación de abajo que nada sale de la máquina.
ollama pull deepseek-r1:14b    # una vez, en línea
# luego desconecta / bloquea la red
ollama run deepseek-r1:14b     # inferencia sin conexión
¿Qué pasa con la mecánica de red y firewall?
El modelo sin conexión en sí no necesita configuración de firewall, VPN ni túneles de red — no tiene ningún endpoint extranjero que alcanzar — así que el único trabajo de red es asegurarte de que nada más en la máquina se conecte al exterior. Ese tema general (reglas de firewall, aislamiento de red, bloqueo de conexiones salientes) se trata en profundidad en otro lugar y no se duplica aquí.
Para la configuración completa de firewall y red sin conexión — incluido aislar una estación de trabajo y bloquear el tráfico saliente — consulta IA local detrás de un firewall: sin conexión 2026. Este artículo cubre la elección del modelo DeepSeek y la configuración del modelo sin conexión; aquel cubre la mecánica de red.
¿Cómo verificas que estás realmente sin conexión?
Demuestra el estado sin conexión de forma empírica: ejecuta una sesión de inferencia completa con el tráfico saliente monitorizado o la red deshabilitada, y confirma que hay cero conexiones salientes desde el proceso del modelo. No lo des por hecho — demuéstralo, porque eso es lo que hace auditable la afirmación de soberanía.
Dos métodos rápidos: deshabilita el adaptador de red (o desconecta el cable) y confirma que la inferencia sigue funcionando — prueba de que el modelo no necesita conectividad; o mantén la red activa pero observa las conexiones salientes con una captura de paquetes o un firewall por proceso, y confirma que el proceso de Ollama/LM Studio no abre ninguna durante una sesión.
Consejo pro de configuración: temperatura 0.6 y sin prompt de sistema
Pon la temperatura en 0.6 (0.5–0.7 es seguro) y no uses prompt de sistema — coloca todas las instrucciones en el prompt del usuario. Esto evita el modo de fallo por repetición e incoherencia al que son propensos los distills DeepSeek-R1, y importa igual sin conexión que con conexión.
¿Comprar hardware o usar la API?
Esta es la decisión real, y depende de con qué frecuencia vayas a usar DeepSeek realmente — no de qué opción es "mejor" en abstracto.
- Compra hardware si: usas DeepSeek a diario, la privacidad es importante para tu trabajo, necesitas funcionamiento sin conexión, planeas ejecutar varios servicios locales en la misma máquina, ya tienes hardware adecuado, o quieres un acceso predecible a largo plazo sin depender de los cambios de precios de un proveedor.
- Usa la API si: usas DeepSeek de forma ocasional, no quieres mantener hardware ni una pila de software, necesitas la máxima velocidad de inferencia sin comprar GPUs de nivel empresarial, o el funcionamiento sin conexión realmente no importa para tu caso de uso.
- Los precios actuales de la API de DeepSeek (verificados arriba) son lo bastante bajos como para que a los usuarios ocasionales casi siempre les convenga más pagar por el uso de la API que comprar hardware para ahorrar — el argumento del hardware es la privacidad y el control, no un ahorro garantizado.
- Calcula tus propios números con la calculadora de coste de IA local antes de decidir — introduce tu gasto mensual esperado en la API y el precio del hardware para ver una estimación real del punto de equilibrio en lugar de una regla general.
Presupuesto de hardware por nivel
Contexto importante de 2026: los precios de GPU y VRAM pueden cambiar rápido y varían mucho según la región y el estado; trata las cifras de presupuesto de abajo como rangos orientativos, no como presupuestos cerrados — comprueba los anuncios actuales antes de comprar. Presupuesta en consecuencia en lugar de asumir que los precios del año pasado siguen vigentes. Los precios en tu país pueden variar según impuestos locales.
Presupuesto | Objetivo | Notas |
|---|---|---|
| Menos de $500 | DeepSeek 7B, cargas pequeñas de 14B | Sistemas GPU usados o de nivel de entrada |
| $500–900 | DeepSeek 14B local | GPU de 16 GB — nivel de entrada razonable para el 14B |
| $1.500–3.000 | DeepSeek 32B | GPU de 24 GB — los precios varían mucho; verifica los anuncios actuales antes de presupuestar |
| $3.000+ | IA local seria, margen para crecer | GPU de 24 GB+, 64–128 GB de RAM, varias unidades NVMe |
| $5.000+ | Modelos de 70B y mayores | Compara una estación de trabajo de IA dedicada frente a los costes de nube/API en este presupuesto — consulta la guía de estación de trabajo |
Qué no comprar
Vale la pena nombrar claramente algunos errores comunes, ya que una página que solo dice "compra esto" se lee como una página de ventas.
- No compres un sistema con GPU de más de $2.000 solo para ejecutar un modelo 7B — es un desperdicio de dinero que el nivel de entrada ya cubre.
- No compres 128 GB de RAM del sistema sin una carga de trabajo que realmente lo necesite; la VRAM, no la RAM del sistema, suele ser el verdadero cuello de botella para la inferencia en GPU.
- No compres una GPU AMD solo porque las especificaciones sobre el papel parezcan impresionantes — verifica primero la compatibilidad de ROCm/software con tu runtime exacto.
- No compres un mini PC esperando inferencia rápida de 70B o del 671B completo — los requisitos de memoria y cómputo a esa escala son una clase de hardware completamente distinta.
- No asumas que lo local es más barato antes de hacer los números — es muy probable que a un usuario ocasional le convenga más la API (consulta la comparación de costes de arriba).
Preguntas frecuentes
¿Puede DeepSeek ejecutarse sin conexión?
Sí. Una vez descargado un distill, la inferencia puede continuar con la red deshabilitada — puedes desconectar o bloquear la red por completo y sigue funcionando a partir de los pesos locales.
¿DeepSeek-R1 necesita una VPN en China?
No para la inferencia si ejecutas el modelo en local: un modelo sin conexión no tiene ningún endpoint extranjero al que llegar. Descargar los pesos es un paso aparte que requiere acceso a la red, y esta guía no ofrece asesoramiento legal sobre lo que permiten las normas locales. La única tarea de red durante la inferencia es asegurarte de que nada más en el equipo envíe datos al exterior.
¿Qué distill de DeepSeek es mejor para el chino?
Un distill basado en Qwen2.5 (7B, 14B o 32B). Qwen2.5 incluye el chino entre sus idiomas compatibles, así que estos son la opción por defecto más segura para prompts y salidas en chino frente a los distills 8B y 70B basados en Llama 3.1/3.3 (criterio editorial, no evaluado aquí con benchmarks).
¿Cuánta VRAM necesita DeepSeek 32B?
Una GPU de 24 GB es un objetivo práctico para un despliegue cuantizado de 32B, según la cuantización y el runtime — consulta la tabla de arriba sobre qué modelo ejecutar y cuánta VRAM necesitas para el desglose completo por nivel.
¿Puede un mini PC ejecutar DeepSeek?
Sí, en particular el distill 7B y algunas configuraciones de 14B. Los mini PCs son una buena opción para un endpoint siempre activo y de bajo consumo, pero por lo general no son la mejor opción para el máximo rendimiento de DeepSeek ni para modelos de 70B o más.
¿Puedo ejecutar DeepSeek en Apple Silicon?
Sí. Los sistemas Apple Silicon con mucha memoria unificada pueden resultar especialmente interesantes para experimentar con LLM local, ya que la ventaja es la capacidad de memoria compartida en lugar de la VRAM tradicional de GPU — consulta la sección de mejores clases de hardware arriba.
¿Es DeepSeek local más barato que la API?
No necesariamente. El hardware tiene un coste inicial considerable, y los precios actuales de la API de DeepSeek son bajos. Las mayores ventajas del despliegue local son la privacidad, el control y el funcionamiento sin conexión, no un ahorro de costes garantizado — calcula tus propios números con la calculadora de costes enlazada.
¿Cómo sé que el modelo sin conexión no está enviando datos a ningún sitio?
Monitoriza el tráfico saliente durante una sesión o deshabilita la red por completo y confirma que la inferencia sigue funcionando. Un modelo cargado en local no necesita inherentemente una conexión a la API de DeepSeek para inferir, pero deberías verificarlo empíricamente en tu propio despliegue en lugar de darlo por hecho.
¿Qué hardware ejecuta bien DeepSeek sin conexión?
Una GPU de 16 GB ejecuta el distill 14B y una GPU de 24 GB ejecuta el 32B. Para un endpoint silencioso y siempre activo, un mini PC capaz maneja el 7B y el 14B. Consulta los bites de GPU y VRAM para la correspondencia exacta, y la sección de mejores clases de hardware para las ventajas y desventajas de NVIDIA/AMD/Apple Silicon/mini PC.
¿Puedo ejecutar el DeepSeek-R1 completo sin conexión?
No en hardware de consumo. El R1 671B completo necesita aproximadamente 400 GB+ de VRAM con cuantización de nivel Q4. El autoalojamiento sin conexión usa de forma realista los distills (1.5B–70B), que se ejecutan en GPUs locales.
¿Dónde están los pasos de firewall y red?
Esta guía deliberadamente no vuelve a explicar la mecánica de firewall y aislamiento de red. Consulta IA local detrás de un firewall: sin conexión 2026 para el bloqueo de red completo; aquí cubrimos la elección del modelo DeepSeek, el hardware y la configuración del modelo sin conexión.
¿Qué ajustes debo usar para DeepSeek sin conexión?
Temperatura 0.6 sin prompt de sistema, con las instrucciones en el mensaje del usuario. Es la configuración estándar de DeepSeek-R1 y evita el modo de fallo por repetición.
¿Puedo ejecutar DeepSeek-V4 sin conexión?
Los pesos son públicos: DeepSeek publica V4-Flash (unos 284B de parámetros en total y 13B activos, licencia MIT) y el V4-Pro, mucho más grande, en Hugging Face, y la ficha del modelo menciona vLLM y SGLang como opciones de servicio. DeepSeek no indica requisitos para GPU de consumo y los modelos de este tamaño son de clase servidor, así que para una sola GPU doméstica las destilaciones de R1 de esta guía siguen siendo la opción práctica sin conexión.
Registro de cambios
- Actualización completa como página de afiliados el 25-08-2026: se añadió el desglose por clases de hardware (NVIDIA/AMD/Apple Silicon/mini PC/nube), un objetivo de configuración recomendada, una comparación verificada de precios de la API de DeepSeek, una sección de decisión comprar-vs-API, una tabla de presupuesto de hardware 2026 (rangos orientativos) y una sección de "qué no comprar". Se corrigió una afirmación excesiva ("los pesos abiertos de DeepSeek no tienen telemetría" → verificarlo empíricamente por despliegue en lugar de afirmarlo categóricamente).
- Publicado el 19-06-2026. Próxima revisión prevista el 25-09-2026 (nivel de frescura mensual, que refleja los precios de GPU/API en rápida evolución).
- Cubre la elección del modelo DeepSeek sin conexión, la elección del modelo en chino, la selección de clase de hardware y la configuración del modelo sin conexión. La mecánica de red/firewall se enlaza a propósito. Monetiza la infraestructura de hardware alrededor de DeepSeek (guías de GPU/Mac/mini PC/estación de trabajo), no la propia API de DeepSeek.
- Actualizado el 2026-10-19: se indica que DeepSeek-V4 es la generación actual (pesos abiertos, clase servidor) y que las destilaciones de R1 son de la generación anterior; se corrigió la introducción, que presentaba por error V4 como solo API y R1/V3 como los modelos de pesos abiertos para autoalojar; se actualizaron los precios de la API de DeepSeek según la página de precios (DeepSeek-V4.1 Flash y V4 Pro); «basado en Llama 3» se precisó como Llama 3.1/3.3. Revisión de riesgos: se eliminaron el historial de precios de GPU usadas sin fuente y la mención «verificado» con mes, se sustituyeron los absolutos («totalmente sin conexión», «nada sale de la máquina») por formulaciones verificables, el consejo sobre modelos para chino se basó en los idiomas que cada familia lista oficialmente y se amplió la nota de «no es asesoramiento legal».