为什么离线运行 DeepSeek?
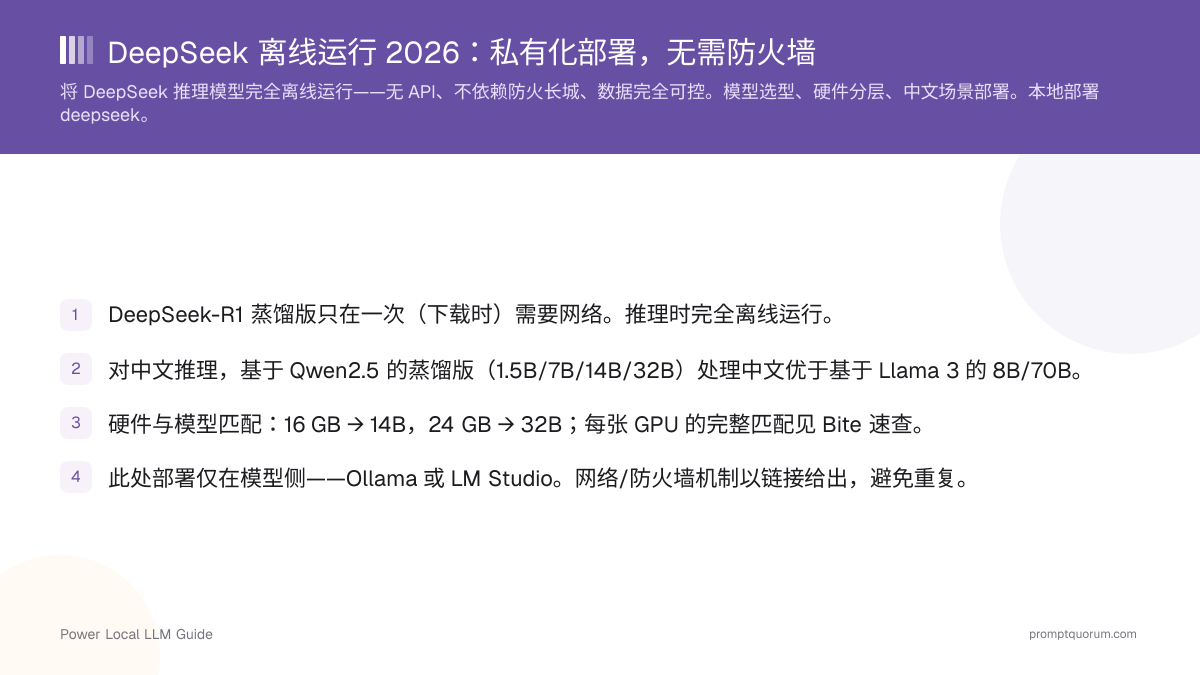
离线运行 DeepSeek 能让你直接掌控数据,并让推理摆脱对托管 API 或网络状况的依赖——模型从本地硬件作答,推理不依赖任何外部端点。 对主权敏感的工作而言,这是「你掌控的工具」与「你依赖的服务」之间的区别。
四大动因占主导:数据主权(只要机器上没有其他程序向外发送,提示词与输出就留在你的环境内)、硬件购置后不再有按 token 计费的 API 账单、摆脱网络限制(对防火长城背后的用户而言尤为具体——离线模型没有要访问的境外端点)、以及可靠性(托管端点没有宕机或限流风险)。这些理由都不等于「自动更便宜」——见下方的成本对比。
这是本地 DeepSeek 能解决中国数据问题吗?一文中隐私分析的实践对应——那篇文章解释了本地私有化部署为何能消除数据流动顾虑;本篇展示如何搭建它,以及该买什么硬件。
📍 简单一句话
离线运行 DeepSeek 能让每个提示词和输出都留在本地硬件上,摆脱对托管 API 的依赖以及任何网络限制。
💬 简单来说
离线模型就像你拥有的一本书,而不是你访问的一个网站。一旦它摆上书架,你无需互联网——也无需任何人的许可——就能阅读它。

本地 DeepSeek 与 DeepSeek API 对比
不要假设本地方案更便宜——DeepSeek 的托管 API 定价很低,因此私有化部署的真正理由是隐私、可控性与离线运行,而不是必然的省钱。 截至 2026-10-19(已对照 DeepSeek 官方 API 定价页核实),DeepSeek-V4.1 Flash 的价格为每百万输入 token 0.003 美元/0.15 美元(缓存命中/未命中,非高峰时段),每百万输出 token(非高峰)0.60 美元;DeepSeek-V4 Pro 的价格为每百万输入 token 0.022 美元/0.66 美元,每百万输出 token(非高峰)1.98 美元,在工作日高峰时段(UTC 01:00–04:00 与 06:00–10:00)价格大致翻倍。按此定价,轻度或偶尔使用的用户可以在很长时间内只花很少的钱在 API 上,远早于硬件回本。
盈亏平衡的计算完全取决于你的使用量:高强度日常使用(每月数百万 token 以上)会在数月内让天平倒向硬件一方;偶尔或突发式使用可能永远无法回本。用 PromptQuorum 的本地 AI 成本计算器,代入你自己预期的月度支出,得到一个真实数字,而不是靠猜测。
因素 | DeepSeek API | 本地 DeepSeek |
|---|---|---|
| 硬件 | 无 | 400–2,800 美元以上,视档位而定(见预算部分) |
| 联网 | 需要 | 模型下载完成后不再需要 |
| 按 token 计费 | 是(见上方定价) | 无持续 API 费用 |
| 隐私 | 提示词发送至托管端点 | 推理留在本机 |
| 维护 | 无需维护 | 需自行管理硬件与软件栈 |
| 模型控制权 | 厂商托管、厂商掌控 | 自主掌控,任选蒸馏版 |
| 可离线 | 否 | 可以,一次性下载后即可 |
| 适合场景 | 偶尔使用,追求便捷 | 日常/高强度使用、隐私、数据主权 |
私有化部署的真正理由是隐私 + 独立性 + 可控性——而不是自动省钱。如果你只是偶尔使用 DeepSeek,API 很可能更便宜也更简单。
哪个 DeepSeek 蒸馏版最适合中文推理?
对中文推理,请选择基于 Qwen2.5 的 DeepSeek-R1 蒸馏版(7B、14B 或 32B)——Qwen2.5 将中文列为支持语言,而 Llama 3.1/3.3 并未将中文列入官方支持语言,因此基于 Qwen2.5 的蒸馏版在处理中文提示与输出时,是比基于 Llama 的 8B 和 70B 更稳妥的默认选择(编辑判断,此处未做基准测试)。 各蒸馏版的推理行为一致;决定语言质量的是底座模型。
中文工作负载的实用选择:16 GB 显卡上的 14B 是均衡默认项,24 GB 显卡上的 32B 是最强的单卡选项。两者凭借 Qwen2.5 底座都能流畅地用中文推理。基于 Llama 的蒸馏版留给英文为主的工作或 Llama 许可需求。
本节服务的核心搜索:本地部署 deepseek、deepseek 离线、deepseek 私有化部署。三者的答案相同——用 Ollama 或 LM Studio 本地运行一个基于 Qwen2.5 的蒸馏版。
📍 简单一句话
对中文推理,请选择基于 Qwen2.5 的 DeepSeek-R1 蒸馏版(7B/14B/32B);在中文场景下,Qwen 底座是比基于 Llama 的蒸馏版更稳妥的默认选择。
该运行哪个模型,需要多少 VRAM?
把蒸馏版与你的 VRAM 及使用场景匹配——分层逻辑与任何 DeepSeek-R1 部署相同,外加每一档实际适合做什么。这是精简版;两份 Bite 参考文章有完整的按 GPU 分类表格和按量化档位的 VRAM 需求。
- PromptQuorum 的看法: 对大多数人来说,14B 或 32B 是最佳平衡点。跳到 70B 是完全不同的硬件门槛(双 GPU、大内存工作站、认真的散热与供电)——把它当作独立的购买决策,而不是从 32B 自然升级的下一步。
- 完整的 671B 模型不是普通消费级 PC 的目标。如果你的负载确实需要这个规模,应把专用 AI 工作站方案与云端/API 成本对比,而不是零散拼装——见本地 AI 工作站搭建指南。
VRAM | 最佳蒸馏版(离线) | 结论 | 适合场景 |
|---|---|---|---|
| 8 GB | 7B 或 R1-0528-Qwen3-8B | 不错的入门选择 | 笔记本电脑、经济型 GPU、小型服务器、实验用途 |
| 16 GB | 14B (Qwen2.5) | 性价比最高 | 大多数认真用户;均衡默认项,中文能力强 |
| 24 GB | 32B (Qwen2.5) | 最佳单卡方案 | 想要真正升级又不进入多卡领域的发烧友 |
| 48 GB+ / 双 GPU | 70B (Llama 3.1/3.3) | 进入严肃工作站领域 | 专业用户;中文输出弱于 Qwen 系蒸馏版 |
| 约 400 GB+ | 完整版 DeepSeek-R1(671B) | 并非普通消费级负载 | 仅限企业级多卡集群——不要指望用 mini PC 跑这个 |
若需要一台常开、低功耗的离线端点,一台性能足够的 mini PC 就能安静运行 7B 和 14B 蒸馏版——见本地 LLM 最佳 mini PC。精确的 GPU 匹配见「相关指南」中的 Bite 参考。
本地 DeepSeek 的最佳硬件类别
与其只推荐单一产品,不如看这四条现实可行的硬件路径——选出与你优先级匹配的一条,再用专门指南查看当前具体选择与价格。
- NVIDIA GPU——追求最高性能与兼容性的首选。 通常的默认之选:软件支持面广(Ollama、vLLM、llama.cpp 都支持 CUDA),而且由于许多本地 LLM 工具优先针对 NVIDIA 开发,排错通常也最简单。当前选择见本地 LLM 最佳 GPU 选购指南。
- AMD GPU——适合愿意折腾 ROCm 生态的买家。 每美元 VRAM 潜力可能不错,但购买前请核实你具体运行环境(Ollama、llama.cpp)的 ROCm/软件兼容性——支持范围比 NVIDIA 窄,且因显卡代次而异。
- Apple Silicon——适合安静、低功耗且拥有大容量统一内存的机器。 它的优势不是传统意义上的 GPU 显存,而是共享内存容量——一台统一内存足够大的 Mac,能加载比显存较小的独立 GPU 更大的蒸馏版,且功耗通常更低——请针对你的模型对比当前价格与基准测试。见本地 AI 最佳 Mac。
- Mini PC——适合常开的本地 AI 服务器。 如果你的负载是 7B、部分 14B、Home Assistant 集成、RAG,或是后台本地助手,而不是追求最高推理速度,这就是正确选择。见本地 LLM 最佳 mini PC。
- 云端 GPU 租用——适合想在购买前先试用某一档位,或只需偶尔的突发算力。 这不算「离线」,但它是在你投入硬件之前,合理体验 32B/70B 级性能的方式。见云端 GPU 租用指南。
我们推荐的本地 DeepSeek 配置
对大多数希望在本地推理能力上获得真正提升、又不想进入多卡领域的 PromptQuorum 读者而言:24 GB 显存 GPU、64 GB 系统内存、2 TB NVMe 存储,通过 Ollama 运行 DeepSeek-R1 32B。 这是一个配置目标,不是某个具体产品——请用下方链接的 GPU 选购指南查看当前的具体型号与价格。
- 这一档位的现实用途:中文推理、编程辅助、文档分析、私人助手、基于本地文档的 RAG,以及本地 agent 实验。
- 预算有限?降到 16 GB / 14B 档位——见上方该运行哪个模型,需要多少 VRAM?以及下方的预算细分。
组件 | 目标规格 |
|---|---|
| GPU | 24 GB 显存 |
| 系统内存 | 64 GB |
| 存储 | 2 TB NVMe |
| 软件 | Ollama |
| 模型 | DeepSeek-R1-Distill-Qwen-32B |
如何离线部署 DeepSeek?
离线部署仅在模型侧:下载一次,随后无需网络运行。以下是用 Ollama 的步骤(LM Studio 是图形界面等价方案——拉取模型,然后离线)。
- 1安装 Ollama 或 LM Studio
Why it matters: 它们在本地运行模型,推理时无外部依赖;联网时安装一次即可。 - 2一次性拉取蒸馏版
Why it matters: 在联网状态下运行 `ollama run deepseek-r1:14b`(或你的分层)——这是唯一需要网络的步骤。 - 3断开或阻断网络
Why it matters: 模型缓存后切断网络访问;模型凭本地权重作答。 - 4设置 temperature 0.6,清空系统提示词
Why it matters: 防止 R1 的重复失败模式;把所有指令放进用户提示词。 - 5离线运行推理
Why it matters: 现在提示词与输出在本地处理——用下面的验证步骤确认没有任何数据外发。
ollama pull deepseek-r1:14b    # 一次性,联网
# 然后断开 / 阻断网络
ollama run deepseek-r1:14b     # 离线推理
网络与防火墙机制怎么处理?
离线模型本身不需要任何防火墙配置、VPN 或网络隧道——它没有要访问的境外端点——因此唯一的网络工作就是确保本机上没有别的东西回连。 这个通用主题(防火墙规则、气隙隔离、阻断外发连接)在别处有深入讲解,此处不重复。
完整的防火墙与离线网络部署——包括给工作站做气隙隔离、锁定外发流量——见防火墙后的本地 AI:离线 2026。本文负责 DeepSeek 模型选型与离线模型部署;那篇负责网络机制。
如何验证你确实处于离线?
用实证证明离线状态:在监控外发流量或禁用网络的情况下运行一次完整推理会话,确认模型进程没有任何外发连接。 不要假设——要演示出来,因为这才能让主权主张可审计。
两种快捷方法:禁用网卡(或拔掉网线)并确认推理仍可正常工作——证明模型不需要联网;或者保持网络开启,但用抓包工具或按进程防火墙监控外发连接,确认会话期间 Ollama/LM Studio 进程没有打开任何外发连接。
配置小贴士:temperature 0.6 与无系统提示词
将 temperature 设为 0.6(0.5–0.7 都安全),并且不设系统提示词——把所有指令放进用户提示词。 这能避免 DeepSeek-R1 蒸馏版容易出现的重复与不连贯失败模式,离线时和在线时一样重要。
购买硬件还是使用 API?
这是真正需要做的决定,它取决于你实际会多频繁地使用 DeepSeek——而不是抽象意义上哪个「更好」。
- 如果符合以下情况,购买硬件: 你每天都使用 DeepSeek、隐私对你的工作很重要、你需要离线运行、你计划在同一台机器上运行多个本地服务、你已经拥有合适的硬件,或者你希望获得可预期的长期使用权,而不依赖厂商未来的定价变化。
- 如果符合以下情况,使用 API: 你只是偶尔使用 DeepSeek、你不想维护硬件或软件栈、你需要最高推理速度但不想购买企业级 GPU,或者离线运行对你的场景确实无关紧要。
- DeepSeek 目前的 API 定价(见上方核实数据)已经低到,偶尔使用的用户很可能直接为 API 用量付费,比购买硬件省钱更划算——购买硬件的理由是隐私与可控性,而不是保证省钱。
- 在做决定之前,用本地 AI 成本计算器算一下你自己的数字——代入你预期的月度 API 支出与硬件价格,得到一个真实的回本估算,而不是凭经验法则猜测。
各档硬件预算
2026 年的重要背景:GPU 和显存价格可能快速变化,并因地区和成色而差异很大。请把下方预算数字视为参考区间而非报价——购买前请核实当前报价。 请据此做预算,不要假设去年的价格仍然适用。
预算 | 目标 | 备注 |
|---|---|---|
| 500 美元以下 | DeepSeek 7B,小规模 14B 负载 | 二手或入门级 GPU 系统 |
| 500–900 美元 | 本地 14B DeepSeek | 16 GB GPU——适合 14B 的合理入门档 |
| 1,500–3,000 美元 | 32B DeepSeek | 24 GB GPU——价格波动很大;做预算前请核实当前报价 |
| 3,000 美元以上 | 认真的本地 AI,留有升级空间 | 24 GB+ GPU、64–128 GB 内存、多块 NVMe 硬盘 |
| 5,000 美元以上 | 70B 及更大模型 | 在这个预算下,应将专用 AI 工作站方案与云端/API 成本对比——见工作站搭建指南 |
不该买什么
有几个常见的错误值得直说,因为一篇只会说「买这个」的文章读起来就像销售软文。
- 不要为了跑一个 7B 模型就买 2,000 美元以上的 GPU 系统——入门档位已经够用,那样只是浪费钱。
- 不要在没有真正需要的负载时就买 128 GB 系统内存;对 GPU 推理来说,真正的瓶颈通常是显存而不是系统内存。
- 不要仅仅因为纸面参数看起来亮眼就买 AMD GPU——先核实你具体运行环境的 ROCm/软件兼容性。
- 不要指望用 mini PC 快速运行 70B 或完整 671B 推理——这个规模的内存与算力需求属于完全不同的硬件级别。
- 不要在没算清楚之前就假设本地方案更便宜——偶尔使用的用户很可能用 API 更划算(见上方成本对比)。
常见问题
DeepSeek 能离线运行吗?
可以。蒸馏版下载完成后,即使禁用网络,推理仍可继续——你可以完全断开或阻断网络,它仍会凭本地权重继续工作。
在中国运行 DeepSeek-R1 需要 VPN 吗?
在本地运行模型时,推理本身不需要:离线模型没有需要连接的境外端点。下载权重是另一个需要联网的步骤,本指南不就当地规则允许什么提供法律意见。推理期间唯一的网络工作,是确保机器上的其他程序不会向外发送数据。
哪个 DeepSeek 蒸馏版最适合中文?
基于 Qwen2.5 的蒸馏版(7B、14B 或 32B)。Qwen2.5 将中文列为支持语言,因此在处理中文提示与输出时,它们是比基于 Llama 3.1/3.3 的 8B 和 70B 蒸馏版更稳妥的默认选择(编辑判断,此处未做基准测试)。
DeepSeek 32B 需要多少 VRAM?
24 GB 显存的 GPU 是 32B 量化部署的实用目标,具体取决于量化方式与运行环境——完整分层见上方「该运行哪个模型,需要多少 VRAM?」表格。
mini PC 能运行 DeepSeek 吗?
可以,尤其是 7B 蒸馏版和部分 14B 配置。mini PC 是常开、低功耗端点的不错选择,但通常不适合追求 DeepSeek 最高性能,也不适合 70B 以上的模型。
我能在 Apple Silicon 上运行 DeepSeek 吗?
可以。统一内存较大的 Apple Silicon 机型对本地 LLM 实验尤其有吸引力,因为其优势在于共享内存容量,而非传统意义上的 GPU 显存——见上方「最佳硬件类别」部分。
本地 DeepSeek 比 API 更便宜吗?
不一定。硬件有相当高的前期成本,而 DeepSeek 目前的 API 定价很低。本地部署最大的优势是隐私、可控性与离线运行,而不是保证省钱——请用链接的成本计算器算一下你自己的数字。
我怎么知道离线模型没有把数据发到任何地方?
在会话期间监控外发流量,或者完全禁用网络并确认推理仍可正常工作。本地加载的模型在推理时本身并不天然需要连接 DeepSeek API,但你应当针对自己的具体部署做实证验证,而不是想当然地假设。
哪些硬件能很好地离线运行 DeepSeek?
16 GB GPU 可运行 14B 蒸馏版,24 GB GPU 可运行 32B。若需要安静的常开端点,一台性能足够的 mini PC 可应对 7B 和 14B。精确匹配见 GPU 与 VRAM 速查,NVIDIA/AMD/Apple Silicon/mini PC 的取舍见「最佳硬件类别」部分。
我能离线运行完整版 DeepSeek-R1 吗?
消费级硬件上不行。完整的 671B R1 在 Q4 级量化下大约需要 400 GB 以上的显存。离线私有化部署实际上使用的是蒸馏版(1.5B–70B),它们可以在本地 GPU 上运行。
防火墙和网络相关步骤去哪里看?
本指南刻意不重复讲解防火墙和气隙隔离机制。完整的网络锁定方案见《防火墙后的本地 AI:离线 2026》;本文专注于 DeepSeek 模型选型、硬件与离线模型部署。
离线运行 DeepSeek 应该用什么设置?
temperature 设为 0.6,不设系统提示词,指令放在用户消息中。这是标准的 DeepSeek-R1 配置,可以防止重复失败模式。
可以离线运行 DeepSeek-V4 吗?
权重是公开的:DeepSeek 在 Hugging Face 上发布了 V4-Flash(总参数约 284B,激活 13B,MIT 许可证)以及体量大得多的 V4-Pro,模型卡列出了 vLLM 与 SGLang 作为部署方式。DeepSeek 并未给出消费级 GPU 的运行要求,这种规模的模型属于服务器级,因此对于家用单 GPU,本指南中的 R1 蒸馏模型仍是实用的离线选择。
更新日志
- 2026-08-25 全面重构为联盟营销页面:新增硬件类别拆解(NVIDIA/AMD/Apple Silicon/mini PC/云端)、推荐配置目标、已核实的 DeepSeek API 定价对比、购买硬件 vs 使用 API 的决策部分、2026 硬件预算表(参考区间),以及「不该买什么」部分。修正了一处过度断言(「DeepSeek 开放权重不含遥测」→ 改为按具体部署做实证验证,而非一概断言)。
- 发布于 2026-06-19。下次复查时间 2026-09-25(月度新鲜度分层,反映快速变化的 GPU/API 价格)。
- 负责 DeepSeek 离线模型选型、中文模型选择、硬件类别选择,以及离线模型部署。网络/防火墙机制刻意以链接给出。围绕 DeepSeek 的硬件基础设施变现(GPU/Mac/mini-PC/工作站指南),而非 DeepSeek 自身的 API。
- 2026-10-19 更新:注明 DeepSeek-V4 为当前一代(开放权重,服务器级),R1 蒸馏模型属于上一代;更正引言中把 V4 说成仅限 API、把 R1/V3 说成可自托管开放权重模型的错误表述;依据定价页更新 DeepSeek API 价格(DeepSeek-V4.1 Flash 与 V4 Pro);将“基于 Llama 3”改为基于 Llama 3.1/3.3。风险审查:删除了无来源的二手 GPU 价格走势和带月份的“已核实”表述,把“完全离线”“数据不出本机”等绝对化说法改为可验证的表述,将中文模型建议建立在各模型系列官方列出的支持语言之上,并扩充了“不构成法律意见”的说明。