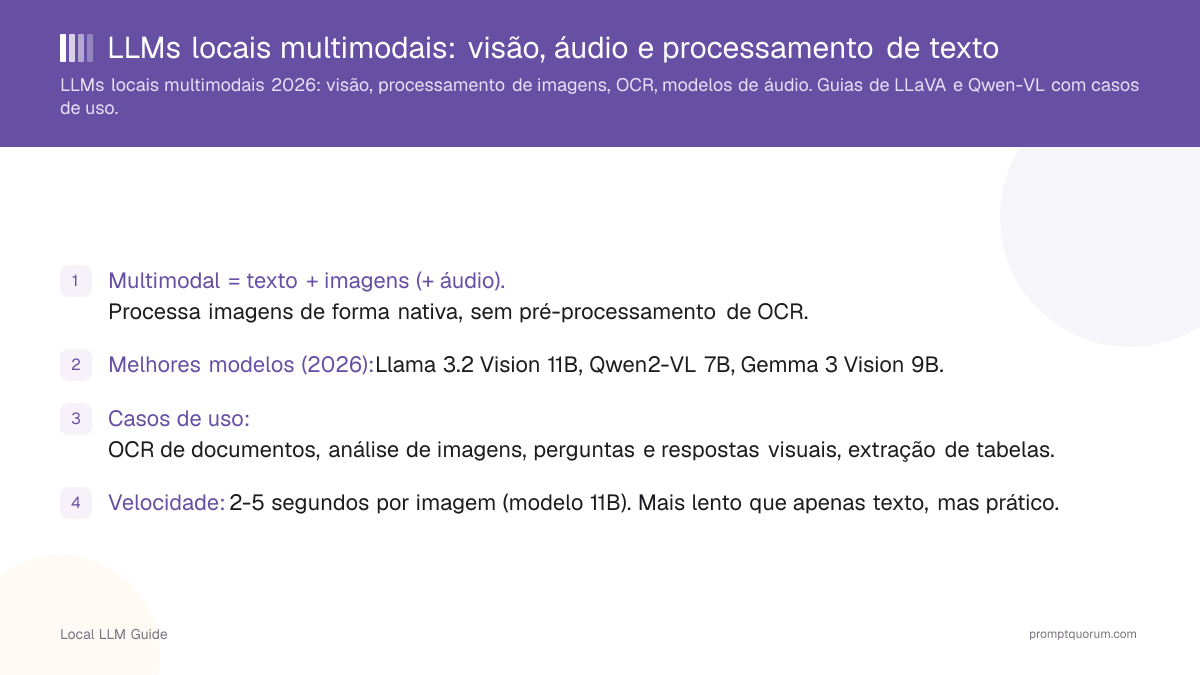
Modelos multimodais disponíveis
Modelo | Suporte a imagem | VRAM | Velocidade por imagem | Melhor para |
|---|---|---|---|---|
| Llama 3.2 Vision 11B | Sim | 8 GB | 3-5 seg/imagem | Visão geral |
| Qwen2.5-VL 7B | Sim | 6.0 GB (download do Ollama) | Depende do hardware | Documentos e OCR |
| Gemma 4 E2B | Sim | ~2 GB | 1-2 seg/imagem | Hardware mínimo / edge |
| Llama 3.2 Vision 90B | Sim | 55 GB | 10+ seg/imagem | Alta qualidade |
Capacidades de visão
Os modelos multimodais podem:
- Descrição de imagens: Explica o que há em uma imagem.
- OCR (Reconhecimento óptico de caracteres): Extrai texto de imagens (cartão de visita, digitalização de documento).
- Perguntas e respostas visuais: Responde a perguntas sobre imagens ("Qual é a marca do carro?").
- Extração de tabelas: Converte tabelas de imagens em dados estruturados.
- Análise de gráficos: Interpreta visualizações de dados.
- Detecção de objetos: Identifica e localiza objetos em imagens.
Configuração e uso
Usando o Llama 3.2 Vision com o Ollama:
python
# Pull the model
ollama pull llama3.2-vision:11b

# Use it
from ollama import Client
client = Client()

with open("image.jpg", "rb") as f:
    image_data = f.read()

response = client.generate(
  model="llama3.2-vision:11b",
  prompt="Describe this image",
  images=[image_data]  # Pass image data
)

print(response["response"])
Casos de uso reais
- Processamento de documentos: Extrai texto de PDFs digitalizados sem serviço de OCR externo.
- Moderação de conteúdo: Sinaliza imagens inadequadas sem enviá-las para a nuvem.
- Acessibilidade: Descreve imagens para usuários com deficiência visual.
- Análise de produtos: Analisa imagens de produtos em e-commerce (categoria, estado, defeitos).
- Pesquisa: Analisa gráficos e diagramas científicos.
Desempenho e limitações
Precisão: Boa para OCR de documentos e descrição, mas não perfeita para análise detalhada ou objetos pequenos.
Velocidade: 2-5 segundos por imagem. Os modelos de nuvem (GPT-4 Vision) são 10-50× mais rápidos.
Tamanho da imagem: Suporta até ~1000×1000 pixels. Imagens maiores são reduzidas por amostragem.
Limitações: Não consegue igualar a precisão do GPT-4 Vision em cenas complexas. Compromisso: privacidade vs. qualidade.
Erros comuns
- Esperar a precisão do GPT-4 Vision. Os modelos locais são 20-30% menos precisos. Use-os para domínios específicos, não para visão geral.
- Não preparar as imagens. Recorte as imagens para a área de foco. Remova o ruído. Melhor entrada = melhor saída.
- Usar modelos 7B para visão complexa. Os modelos pequenos têm dificuldade com detalhes sutis. Use 11B+ para visão confiável.
Fontes
- Llama 3.2 Vision Model Card -- huggingface.co/meta-llama/Llama-3.2-11B-Vision
- Qwen2.5-VL -- github.com/QwenLM/Qwen2.5-VL