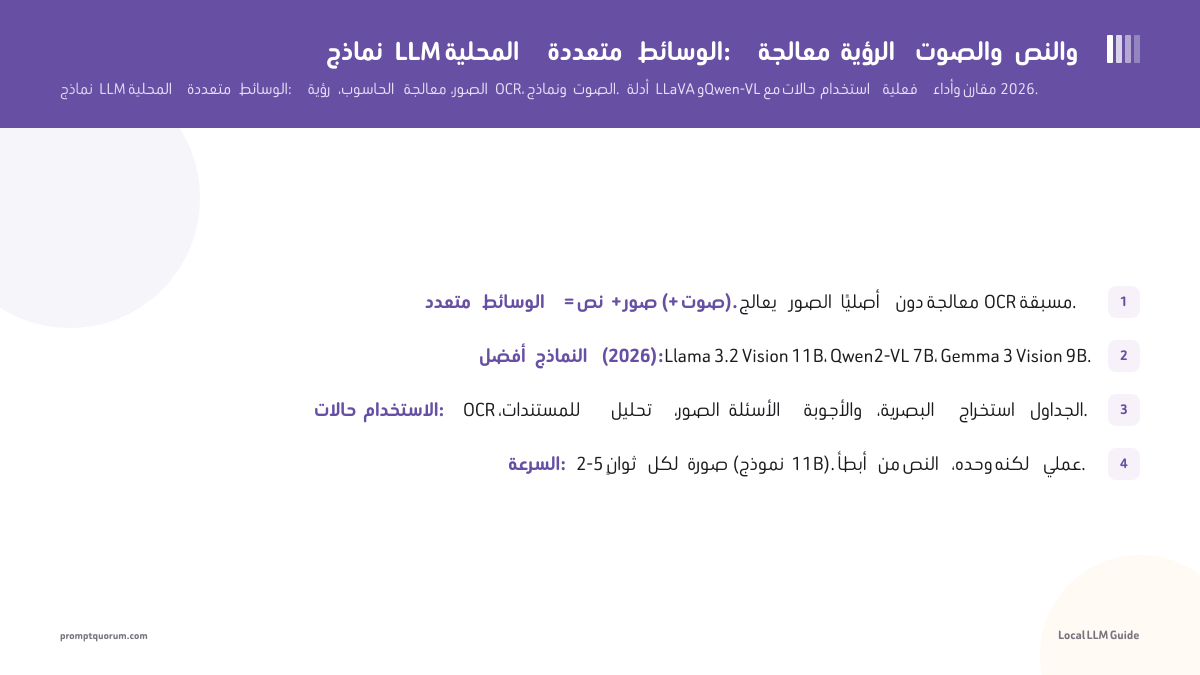
النماذج متعددة الوسائط المتاحة
Modelo | Soporte de imagen | VRAM | Velocidad por imagen | Mejor para |
|---|---|---|---|---|
| Llama 3.2 Vision 11B | نعم | 8 GB | 3-5 ث/صورة | رؤية عامة |
| Qwen2.5-VL 7B | نعم | 6.0 GB (حجم تنزيل Ollama) | يعتمد على العتاد | المستندات وOCR |
| Gemma 4 E2B | نعم | ~2 GB | 1-2 ث/صورة | أصغر عتاد / edge |
| Llama 3.2 Vision 90B | نعم | 55 GB | 10+ ث/صورة | جودة عالية |
قدرات الرؤية
يمكن للنماذج متعددة الوسائط:
- وصف الصور: يشرح ما في الصورة.
- OCR (التعرّف الضوئي على الحروف): يستخرج النص من الصور (بطاقة عمل، مسح مستند).
- أسئلة وأجوبة بصرية: يجيب عن أسئلة حول الصور ("ما ماركة السيارة؟").
- استخراج الجداول: يحلّل جداول الصور إلى بيانات منظّمة.
- تحليل الرسوم البيانية: يفسّر تصورات البيانات.
- كشف الكائنات: يحدّد ويوضّع الكائنات في الصور.
الإعداد والاستخدام
باستخدام Llama 3.2 Vision مع Ollama:
python
# Pull the model
ollama pull llama3.2-vision:11b

# Use it
from ollama import Client
client = Client()

with open("image.jpg", "rb") as f:
    image_data = f.read()

response = client.generate(
  model="llama3.2-vision:11b",
  prompt="Describe this image",
  images=[image_data]  # Pass image data
)

print(response["response"])
حالات استخدام حقيقية
- معالجة المستندات: يستخرج النص من ملفات PDF الممسوحة دون خدمة OCR خارجية.
- الإشراف على المحتوى: يضع علامة على الصور غير اللائقة دون إرسالها للسحابة.
- إمكانية الوصول: يصف الصور للمستخدمين ذوي الإعاقة البصرية.
- تحليل المنتجات: يحلّل صور المنتجات في التجارة الإلكترونية (الفئة، الحالة، العيوب).
- البحث: يحلّل الرسوم البيانية والمخططات العلمية.
الأداء والقيود
الدقة: جيدة لـ OCR المستندات والوصف، لكنها ليست مثالية للتحليل التفصيلي أو الكائنات الصغيرة.
السرعة: 2-5 ثوانٍ لكل صورة. النماذج السحابية (GPT-4 Vision) أسرع بمقدار 10-50×.
حجم الصورة: يدعم حتى ~1000×1000 بكسل. الصور الأكبر يُخفَّض معدل أخذ عيناتها.
القيود: لا يمكنه مضاهاة دقة GPT-4 Vision في المشاهد المعقدة. المقايضة: الخصوصية مقابل الجودة.
أخطاء شائعة
- توقّع دقة GPT-4 Vision. النماذج المحلية أقل دقة بنسبة 20-30%. استخدمها لمجالات محددة، لا للرؤية العامة.
- عدم تجهيز الصور. اقتصّ الصور إلى منطقة التركيز. أزل الضوضاء. إدخال أفضل = إخراج أفضل.
- استخدام نماذج 7B للرؤية المعقدة. النماذج الصغيرة تكافح مع التفاصيل الدقيقة. استخدم 11B+ للرؤية الموثوقة.
المصادر
- بطاقة نموذج Llama 3.2 Vision -- huggingface.co/meta-llama/Llama-3.2-11B-Vision
- Qwen2.5-VL -- github.com/QwenLM/Qwen2.5-VL