Key Takeaways
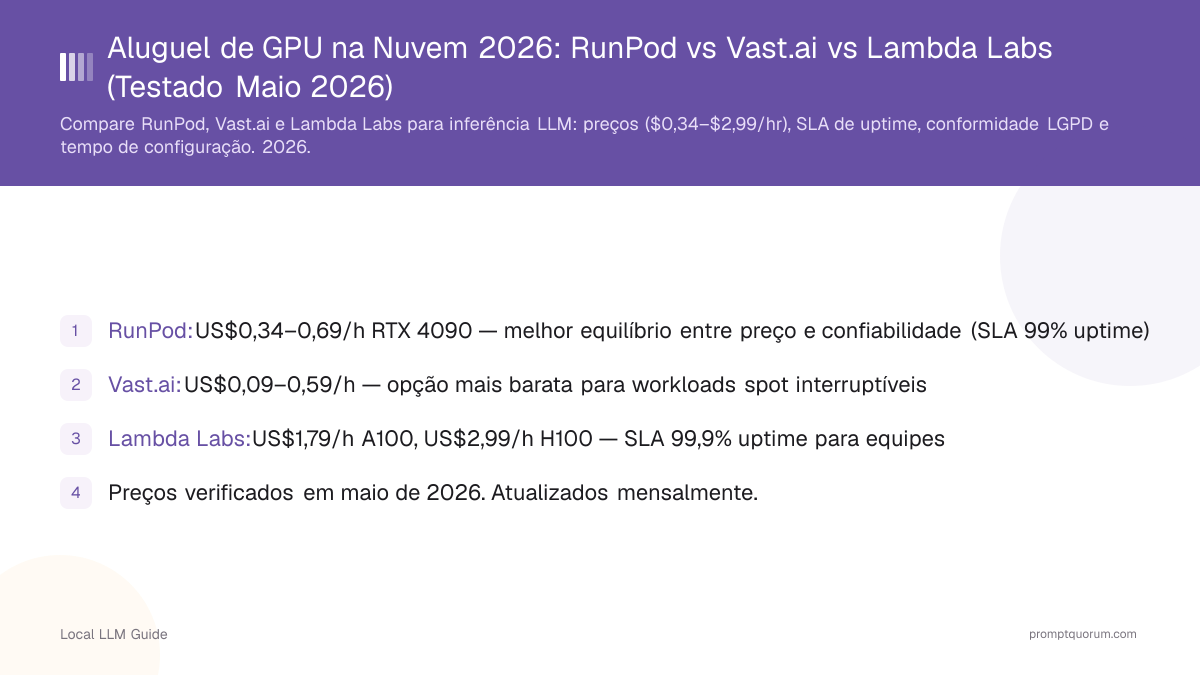
- RunPod: US$0,34–0,69/h RTX 4090 — melhor equilíbrio entre preço e confiabilidade para inferência de LLM (SLA de 99% de uptime)
- Vast.ai: US$0,08–0,59/h — opção mais barata para workloads spot interruptíveis
- Lambda Labs: US$1,99–2,79/h A100, US$3,29–3,99/h H100 — SLA de 99,9% de uptime para equipes
- Preços verificados em agosto de 2026 nos três provedores. Reverificados mensalmente.
Preços de aluguel de GPU na nuvem para inferência de LLM: RunPod (US$0,34–0,69/h RTX 4090, melhor confiabilidade), Vast.ai (US$0,08–0,59/h, mais barato com instâncias interruptíveis), Lambda Labs (US$1,99–2,79/h A100, US$3,29–3,99/h H100, 99,9% de uptime para equipes).
O aluguel de GPU na nuvem permite pagar por hora para usar uma placa de vídeo poderosa no servidor de outra pessoa — sem precisar comprar hardware. Instâncias interruptíveis são mais baratas, mas podem ser retomadas a qualquer momento; instâncias reservadas são estáveis e custam mais. RTX 4090 e RTX 5090 atendem a inferência de LLM; A100/H100 atendem a treinamento ou a cargas de throughput muito alto.
🔄 Atualização de agosto de 2026
Esta revisão reconciliou preços que estavam dessincronizados entre a tabela comparativa, as seções de cada provedor e a tabela de detalhamento de preços abaixo — as três agora mostram os mesmos valores de RunPod, Vast.ai e Lambda Labs. Foram adicionadas notas de disponibilidade da RTX 5090 e uma FAQ sobre Stable Diffusion/geração de imagens (vários leitores buscam preços de aluguel de GPU para geração de imagens, não apenas para inferência de LLM). Esta página agora segue um ciclo mensal de verificação de fatos; o título e a meta description também foram revisados para explicitar a comparação RunPod vs Vast.ai vs Lambda Labs nas buscas.
•📋 Dados Verificados: Todos os preços e afirmações de uptime neste guia são conferidos mensalmente nas páginas de preços dos provedores. Confirme as tarifas atuais exatas no painel de cada provedor antes de assinar um plano, pois os preços spot em particular mudam de hora em hora.
Verificação de Fontes
Preços conferidos: RunPod (runpod.io), Vast.ai (vast.ai), Lambda Labs (lambdalabs.com). Última verificação: 15 de julho de 2026. Reverificado mensalmente. Esta página é mantida como referência canônica.
🏆 Nossas Recomendações
Três vencedores distintos para três prioridades diferentes.
•🥇 MELHOR NO GERAL: RunPod: Por quê: melhor equilíbrio entre preço ($0,34–0,69/hr RTX 4090), confiabilidade (99% de uptime) e facilidade de uso para inferência de LLM. Nível Secure Cloud recomendado para produção. ✓ Regiões EU disponíveis
•💰 MELHOR OPÇÃO ECONÔMICA: Vast.ai: Por quê: 30–50% mais barato que a concorrência se você tolera interrupções spot. RTX 4090 a partir de $0,08/hr. Maior catálogo de GPUs. ⚠ Peer-to-peer (qualidade variável)
•🏢 MELHOR PARA EQUIPES: Lambda Labs: Por quê: SLA de uptime de 99,9%, suporte dedicado (Slack/e-mail/telefone), foco em A100/H100. Preço premium ($1,99–$3,99/hr) justificado para cargas de trabalho de IA em produção.
Tabela de Comparação Rápida
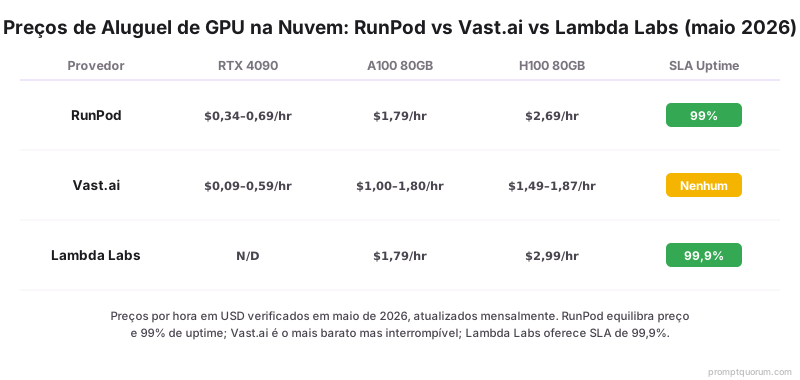
Comparativa direta de preços e características para inferência de LLM, verificada em agosto de 2026. Os preços são tarifas por hora; a maioria dos provedores cobra por segundo, então o custo real depende do tempo de execução. As listagens de RTX 5090 são mais recentes e menos consistentes que as de RTX 4090 — confira o estoque atual no painel de cada provedor.
Provedor | RTX 4090 | RTX 5090 | A100 80GB | H100 80GB | SLA Uptime | Faturamento | Créditos Grátis | Região EU |
|---|---|---|---|---|---|---|---|---|
| RunPod | $0,34–0,69/hr | $0,60–0,95/hr* | $1,19–1,79/hr | $2,49–2,69/hr | 99% | por segundo | $10 | ✓ Sim |
| Vast.ai | $0,08–0,59/hr* | $0,45–0,85/hr* | $0,71–1,80/hr* | $1,49–1,87/hr* | Nenhum | por segundo | $5 (varia) | Por host |
| Salad | a partir de $0,16/hr | a partir de $0,25/hr | N/A | N/A | Nenhum | por segundo | — | — |
| Lambda Labs | N/D | N/D | $1,99–2,79/hr | $3,29–3,99/hr | 99,9% | por minuto | $15 | ✗ Não |
Por Que Alugar GPUs na Nuvem?
O aluguel de GPU na nuvem faz sentido quando você: precisa de poder computacional ocasional (execuções semanais de fine-tuning), quer evitar custos iniciais de hardware de $2.000–$10.000, precisa de vários tipos de GPU para experimentar, ou precisa de mais de 100 GPUs para treinamento distribuído sem comprar infraestrutura. A mesma lógica de preços vale para inferência de LLM, fine-tuning ou renderização de Stable Diffusion / geração de imagens — os três rodam nas mesmas instâncias RTX 4090, RTX 5090, A100 e H100 abordadas neste guia.
- Sem manutenção de hardware nem custos de eletricidade
- Escale para cima ou para baixo instantaneamente (minutos, não semanas)
- Teste GPUs caras (H100, A100, RTX 5090) antes de comprar
- Pague apenas pelo tempo de computação usado — sem custo ocioso
- Acesse GPUs em várias regiões do mundo
Matriz de Decisão: Qual Provedor Atende à Sua Necessidade?
Associe seu caso de uso ao melhor provedor.
- 1Orçamento é a prioridade → Vast.ai (instâncias spot, $0,08/hr para RTX 4090)
- 2Iniciante, precisa de simplicidade → RunPod (painel unificado, preços claros, $10 de crédito grátis)
- 3Equipe com fluxos de trabalho gerenciados → Lambda Labs (suporte via API, suporte via Slack, SLA de 99,9%)
- 4Vários tipos de GPU, experimentação → Vast.ai (maior catálogo: mais de 500 modelos de GPU)
- 5Apenas fine-tuning (carga estável) → RunPod Secure Cloud (SLA de 99%, sem interrupções)
- 6Inferência em produção de longo prazo → Lambda Labs (instâncias reservadas, garantias de custo)
- 7Conformidade com GDPR na UE necessária → RunPod (data centers na UE + DPA)
- 8Urgência de configuração em menos de 5 minutos → Lambda Labs (onboarding mais polido)
- 9Quer comparar vários provedores → Use a tabela comparativa desta página
- 10Não tem certeza → Comece com o RunPod ($10 grátis, mais flexível, padrão mais seguro)
RunPod: A Escolha Equilibrada
O RunPod é um marketplace de computação em GPU com dois níveis de preço: Secure Cloud (reservado, estável, 99% de uptime) e On-Demand (mais barato, interrompível). Para inferência de LLM, o nível RTX 4090 atende confortavelmente a maioria dos modelos de 7B a 34B.
- RTX 4090: $0,34–0,69/hr — On-Demand começa perto de $0,34/hr, Secure Cloud (reservado, sem interrupções) custa $0,50–0,69/hr (agosto de 2026)
- RTX 5090: listada em algumas regiões a partir de ~$0,60/hr; a disponibilidade é mais recente e menos consistente que a da RTX 4090 — confira o estoque atual antes de planejar em torno dela
- A100 80GB: $1,19–1,79/hr (On-Demand a Secure Cloud)
- H100 80GB: $2,49–2,69/hr (On-Demand a Secure Cloud)
- Faturamento: por minuto, sem mínimo por hora
- Nível gratuito: $10 de crédito no cadastro
- Tempo de configuração: 5 minutos
- DPA disponível: Sim (em conformidade com o GDPR para instâncias na UE)
- Regiões EU: Sim (Países Baixos, Romênia)
- Comunidade gratuita: forte ecossistema no Discord
O RunPod Secure Cloud é confiável?
Sim. As instâncias Secure Cloud têm SLA de 99% de uptime e não são interrompidas, a menos que o provedor cancele a instância (muito raro). Instâncias On-Demand podem ser interrompidas com 5 minutos de aviso.
Posso usar imagens Docker personalizadas?
Sim. O RunPod permite imagens Docker personalizadas; envie para o Docker Hub ou para um registry e referencie pela URL. Também há implantação de templates com um clique, com frameworks de ML pré-instalados.
Como pauso uma instância?
Botão de pausa no painel. O snapshot é salvo. Enquanto pausada, você paga apenas pelo armazenamento (custo desprezível).
Posso escalar para várias GPUs?
Sim. O RunPod suporta instâncias com várias GPUs e treinamento distribuído via API.
Vast.ai: Máxima Economia
A Vast.ai é um marketplace de GPUs peer-to-peer em que pessoas e data centers alugam capacidade ociosa. Os preços são dinâmicos e costumam ser 30–50% mais baratos que RunPod ou Lambda Labs. Instâncias spot podem ser interrompidas com 15 segundos de aviso.
- RTX 4090 spot: $0,08–0,59/hr — mediana em torno de $0,21/hr; o valor mais baixo ($0,08/hr) é real, mas raro (demanda fora do pico), e o mais alto vale para listagens estáveis/sob demanda
- RTX 5090: aparecendo na Vast.ai a partir de cerca de $0,45/hr em alguns hosts; o estoque é menor e menos consistente que o da RTX 4090 — filtre por hosts "Verified" se precisar de confiabilidade
- A100 80GB: $0,71–1,80/hr (mediana $0,71/hr)
- H100 80GB: $1,49–1,87/hr (mediana $1,49/hr)
- Faturamento: por segundo (sem mínimos)
- Maior estoque de GPUs: mais de 500 modelos únicos de GPU
- Nível gratuito: $5 de crédito (varia conforme a promoção)
- Tempo de configuração: 10 minutos (mais técnico)
- DPA: caso a caso (peer-to-peer, não disponível universalmente)
- Regiões EU: mistas (dependem da localização de cada host)
E se minha instância spot for interrompida?
Instâncias spot podem ser interrompidas com 15 segundos de aviso se o provedor retomar a GPU. Use o filtro "Interruptible: Off" para instâncias estáveis (preços mais altos, mais estabilidade).
Tenho acesso root/sudo?
A maioria dos provedores oferece sudo; alguns não. Confira os detalhes da instância antes de alugar. Não é garantido pela Vast.ai.
Como envio dados?
Use rsync ou scp via SSH. Para conjuntos de dados grandes (>100GB), armazene no disco anexado em /mnt/ (pequena taxa adicional) ou use uma ponte de armazenamento em nuvem (S3, Google Drive).
Os preços são realmente tão mais baixos?
Sim, mas os preços spot flutuam. $0,08/hr é real, mas raro (fora do pico de demanda). A mediana de $0,21/hr é mais típica. Monitore antes de adotar spot em produção.
O preço da Vast.ai vale para Stable Diffusion da mesma forma que para inferência de LLM?
Sim — as mesmas instâncias spot RTX 4090 e RTX 5090 usadas para inferência de LLM também executam Stable Diffusion e outras cargas de geração de imagens. A geração de imagens costuma depender mais de VRAM e ser menos sensível à latência que a inferência de chat; por isso, instâncias spot/interruptíveis (mais baratas, podem ser retomadas) geralmente são adequadas para jobs em lote de geração de imagens. Reserve instâncias estáveis "Interruptible: Off" apenas se precisar de uma fila de renderização longa sem interrupções.
Lambda Labs: Premium Gerenciado
A Lambda Labs é um provedor de nuvem de GPU gerenciada, focado em simplicidade, uptime e suporte ao cliente. Os preços são mais altos que os da concorrência, mas incluem infraestrutura gerenciada, foco em A100/H100 e suporte ao vivo.
- A100 80GB: $1,99–2,79/hr (sob demanda a partir de $1,99/hr)
- H100 80GB: $3,29–3,99/hr (sob demanda a partir de $3,29/hr)
- RTX 4090 / RTX 5090: não oferecidas (foco em A100/H100 — GPUs de nível consumidor não fazem parte do catálogo da Lambda Labs)
- Instâncias reservadas: desconto para 12 meses disponível
- Faturamento: por hora (com cobrança final por minuto)
- SLA de uptime: 99,9%
- Nível gratuito: $15 de crédito no cadastro
- Tempo de configuração: 3 minutos (UX mais polida)
- Recursos para equipes: vários usuários por conta
- Suporte: Slack, e-mail, telefone (pessoas reais)
- DPA: Sim, mas com infraestrutura apenas nos EUA (não atende ao GDPR para dados pessoais da UE)
A Lambda Labs vale o preço premium?
Sim, se você precisa de SLA de 99,9% de uptime, aceita infraestrutura nos EUA e valoriza suporte ao vivo. Para experimentação, RunPod ou Vast.ai são mais baratos. Para produção, o SLA da Lambda Labs justifica o custo.
Posso escalar para várias GPUs?
Sim. A Lambda Labs permite instâncias com várias GPUs e treinamento distribuído. O ambiente Jupyter cuida da configuração.
Qual é a política de reembolso?
Reembolso em 30 dias se você não ficar satisfeito. A maioria dos usuários não precisa dele depois de testar o crédito gratuito de $15.
Por que não há RTX 4090 ou RTX 5090?
A Lambda Labs foca no mercado empresarial de A100/H100, não no nível de GPUs de consumo. A estratégia é deliberada.
GDPR da UE e Residência de Dados: Seu Checklist Essencial
Para clientes da UE que processam dados pessoais por meio de LLMs, a conformidade com o GDPR é inegociável. A maioria dos provedores globais de GPU na nuvem é dos EUA e NÃO atende, por padrão, aos requisitos de residência de dados da UE.
- A residência dos dados (onde eles ficam fisicamente) é um requisito do Artigo 32 do GDPR
- As Cláusulas Contratuais Padrão (SCCs) para transferências aos EUA são incertas após o caso Schrems II
- Alguns provedores oferecem data centers na UE, mas processam os dados nos EUA (não conforme)
- Um DPA (Acordo de Processamento de Dados) sozinho NÃO basta sem residência de dados na UE
Provedores de GPU na Nuvem em Conformidade com o GDPR (Nativos da UE)
Estes provedores têm data centers na UE e podem assinar DPAs para o processamento de dados pessoais da UE. Hyperstack, segundo dados do provedor: certificação SOC 2 Type 2; o DPA cobre o GDPR da UE, o UK GDPR e as SCCs; sob demanda H100 SXM $3.20/h, H100 NVLink $2.60/h, H200 $3.99/h, B200 $6.00/h, cobrança por minuto sem taxas de entrada ou saída (preços do provedor).
Provedor | Localização | DPA | Observação |
|---|---|---|---|
| Hetzner GPU | Alemanha (Falkenstein, Nuremberg) | ✓ Lei alemã | Infraestrutura de propriedade alemã, nativa da UE por padrão |
| Scaleway | França (Paris, Amsterdã) | ✓ Disponível | Especialista francês em IA, preços competitivos |
| OVHcloud | França, Alemanha, Reino Unido | ✓ Disponível | Maior provedor de nuvem da UE, foco empresarial |
| STACKIT (Schwarz Group) | Alemanha | ✓ Lei alemã | Foco empresarial, certificado Gaia-X |
| Nebius | Finlândia, Islândia | ✓ Disponível | Novo, especializado em IA, alto desempenho |
| RunPod (regiões EU) | Países Baixos, Romênia | ✓ Disponível | Empresa dos EUA, mas com data centers na UE disponíveis |
| Hyperstack (NexGen Cloud) | Suécia, Noruega | ✓ Disponível | Empresa do Reino Unido, mas com data centers na UE disponíveis; SOC 2 Type 2 (segundo o provedor) |
NÃO Adequados para Dados Pessoais da UE
Estes provedores não têm residência de dados na UE ou não conseguem garantir conformidade com o GDPR.
- Lambda Labs — infraestrutura apenas nos EUA e sem regiões na UE (mesmo com DPA, não há residência de dados na UE)
- Vast.ai — peer-to-peer; a localização do host varia (principalmente EUA), sem DPA centralizado
- CoreWeave — principalmente EUA; presença limitada na UE, infraestrutura majoritariamente nos EUA
O Que Isso Significa na Prática para Sua Carga de Trabalho
O GDPR se aplica se você processa QUALQUER dado pessoal (nomes de funcionários, e-mails de clientes, identificadores, dados biométricos, dados de localização, endereços IP, dados comportamentais). Dados não pessoais (anonimizados, agregados, sintéticos) estão isentos.
- Dados de funcionários (RH, folha de pagamento, avaliações de desempenho): o GDPR se aplica
- PII de clientes (nomes, e-mails, endereços, dados de pagamento): o GDPR se aplica
- Dados de saúde (sobreposição com HIPAA): o GDPR se aplica + regras mais rígidas
- Dados financeiros (sobreposição com SOX e GDPR): o GDPR se aplica + regras mais rígidas
- Benchmarks anonimizados (saídas de modelos agregadas): o GDPR NÃO se aplica
- Dados sintéticos (gerados por IA, sem PII real): o GDPR NÃO se aplica
- Categoria de alto risco do AI Act da UE (decisões automatizadas que afetam pessoas): o GDPR se aplica + regras adicionais
Checklist de Verificação do GDPR Antes do Cadastro
Antes de se cadastrar em qualquer provedor de GPU na nuvem, verifique estes 5 pontos.
- 1Confirme a localização do data center na UE nos termos do provedor (não "disponível" — de fato localizado)
- 2Solicite e revise o DPA por escrito; ele deve referenciar os Artigos 28 e 32 do GDPR
- 3Verifique as Cláusulas Contratuais Padrão (SCCs) se houver qualquer fluxo de dados para os EUA
- 4Verifique se a política de privacidade do provedor cobre explicitamente o Artigo 32 (segurança) e o Artigo 28 (obrigações do operador) do GDPR
- 5Pergunte ao provedor: "Você pode garantir que todos os dados permanecem em [país] e nunca fluem para os EUA?" Obtenha a resposta por escrito.
Quando o Aluguel de GPU na Nuvem NÃO É a Escolha Certa
O aluguel na nuvem nem sempre é o ideal. Comprar hardware ou continuar no local faz mais sentido econômico nestas situações:
Você Executa LLMs Mais de 4 Horas por Dia
Na tarifa intermediária da RTX 4090 no RunPod ($0,50/hr): $0,50/hr × 4 horas × 30 dias = $60/mês. Em 18 meses são $1.080 — menos da metade do custo de uma RTX 4090 real (cerca de $2.000–2.600 no varejo, preço de fim de linha). Se o seu uso é constante e previsível, comprar sai mais barato no longo prazo.
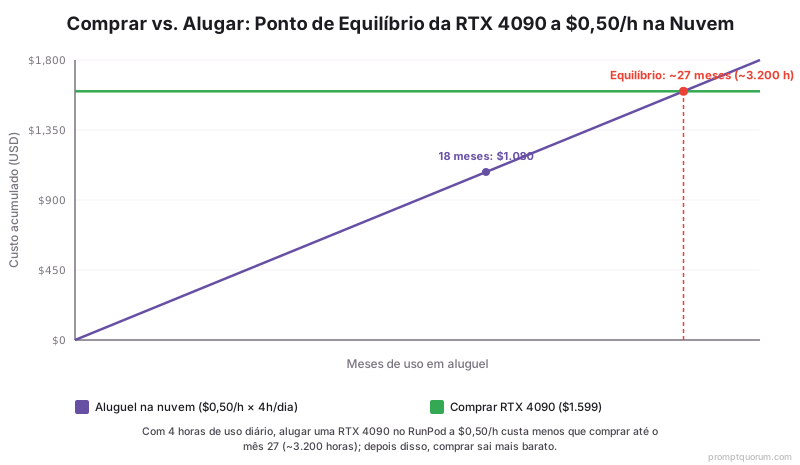
•💡 A Conta: Ponto de equilíbrio: a $0,50/hr e 4 horas/dia, são cerca de 4.600 horas de aluguel — aproximadamente 38 meses de uso diário de 4 horas. Se você já passou disso, calcule o ROI: custo da GPU ($2.000–2.600) ÷ tarifa por hora ($0,50) = horas de equilíbrio.
Você Precisa de Latência Abaixo de 100 ms
O tempo de ida e volta da rede até uma GPU na nuvem soma de 30 a 150 ms, dependendo da sua localização e da região do provedor. Em aplicações interativas (chat em tempo real, transcrição de voz, IA em jogos ao vivo), essa latência é perceptível. Uma GPU local não tem nenhuma sobrecarga de rede.
Seus Dados Estão em Setores Regulados
Saúde (HIPAA), finanças (SOX, MiFID II), jurídico (sigilo advogado-cliente) ou trabalho governamental muitas vezes não podem usar a nuvem legalmente — nem mesmo uma nuvem em conformidade com o GDPR. Hardware on-premises é o único caminho em conformidade.
Você Quer Custo Recorrente Zero
Depois de comprar uma GPU, a eletricidade é o único custo contínuo (~$0,05–$0,15/hr na maioria dos países). Sem assinatura, sem surpresas de uso, sem mudanças de tarifa. Ter o hardware tem um teto de custo claro.
Você Está Aprendendo, Não Produzindo
Se você ainda está descobrindo quais modelos funcionam para você, a fase de experimentação se beneficia da flexibilidade da nuvem. Mas, uma vez definido o fluxo de trabalho, o hardware local tende a ser mais econômico.
A Abordagem Híbrida (Recomendada)
A resposta certa para a maioria dos usuários é híbrida: hardware local para o trabalho diário e GPU na nuvem para tarefas pesadas ocasionais (execuções de fine-tuning, inferência de modelos de 70B, experimentos com várias GPUs). Não adote apenas nuvem nem apenas local — use os dois de forma estratégica.
- Local: inferência diária, fluxos de trabalho estáveis, cargas com custo previsível
- Nuvem: experimentação, modelos de 70B+, treinamento distribuído, capacidade de pico
- Essa abordagem minimiza tanto o investimento em hardware QUANTO o gasto excessivo na nuvem
Início Rápido: Alugue Sua Primeira GPU em 10 Minutos
Siga este guia passo a passo para colocar uma GPU em funcionamento em qualquer plataforma.
- 1Cadastre-se com e-mail e cartão de crédito (RunPod) ou GitHub (Vast.ai)
- 2Selecione um tipo de GPU e uma região (filtre por disponibilidade e preço)
- 3Escolha a imagem do SO (Ubuntu 22.04 + CUDA é o padrão)
- 4Defina o tamanho do disco (mínimo de 50 GB para a maioria das cargas de ML)
- 5Clique em "Start" e aguarde de 30 a 60 segundos para a instância inicializar
- 6Conecte-se por SSH ao IP fornecido (credenciais no seu painel)
- 7Instale as dependências: apt update && apt install -y python3-pip
- 8Clone seu repositório e execute sua carga de trabalho
- 9Monitore o uso no painel do provedor (fique de olho no relógio)
- 10Pare a instância quando terminar (a cobrança cessa imediatamente)
Detalhamento de Preços por GPU
Tarifas de aluguel por hora das GPUs mais comuns nas três plataformas — estes valores coincidem com os da tabela comparativa e das seções de cada provedor acima. O custo real depende do tempo de execução (RunPod por minuto, Vast.ai por segundo, Lambda Labs por hora com cobrança final por minuto).
Perguntas Frequentes
Perguntas comuns sobre provedores de aluguel de GPU na nuvem.
RunPod vs Vast.ai vs Lambda Labs: qual é o mais barato para inferência de LLM?
A Vast.ai é a mais barata no papel ($0,08–0,59/hr RTX 4090), mas interrompível. O RunPod ($0,34–0,69/hr RTX 4090) é o melhor equilíbrio entre preço e estabilidade para inferência de LLM. A Lambda Labs ($1,99–3,99/hr A100/H100) não tem nível de GPU de consumo e custa mais, mas inclui suporte gerenciado e SLA de 99,9%.
Esta comparação cobre Stable Diffusion e geração de imagens, ou apenas inferência de LLM?
Os preços, níveis de GPU e provedores deste guia valem para ambos. Stable Diffusion e outras cargas de geração de imagens rodam nas mesmas instâncias RTX 4090/RTX 5090/A100/H100 da inferência de LLM. Veja a seção da Vast.ai acima para orientações específicas de geração de imagens sobre instâncias spot vs. estáveis.
A RTX 5090 já está disponível para aluguel na nuvem?
Sim, em um número crescente, mas ainda limitado, de listagens do RunPod e da Vast.ai. Disponibilidade e preço são menos consistentes que os do nível RTX 4090, já consolidado — confira as listagens atuais no painel do provedor em vez de presumir estoque. A Lambda Labs não oferece nenhuma GPU de nível consumidor, incluindo a RTX 5090.
Posso pausar e retomar minha instância?
Sim. RunPod e Vast.ai permitem pausar instâncias (o snapshot é salvo). Lambda Labs pode pausar via API. Enquanto pausada, você paga apenas pelo armazenamento (custo desprezível, normalmente <$0,01/dia).
O que acontece se a instância ficar sem espaço em disco?
A instância vai travar. Adicione um disco extra pelo painel do provedor e monte em /mnt/ antes que ele encha. Prática padrão: monitore o uso do disco semanalmente.
Posso usar esses serviços para inferência de IA comercial?
Sim, mas revise os termos do provedor. RunPod e Lambda Labs permitem cargas de trabalho comerciais. Provedores individuais da Vast.ai podem ter restrições — leia a listagem com atenção.
Como transfiro conjuntos de dados grandes (>100 GB)?
Para <100 GB: rsync via SSH. Para >100 GB: (1) armazene na nuvem (S3, Google Drive) e baixe na instância, ou (2) solicite ao provedor um disco anexado em /mnt/ (pequena taxa adicional).
Qual provedor é melhor para treinamento distribuído com várias GPUs?
Lambda Labs (configuração mais simples, suporte incluído). RunPod (boa API para multi-nó). Vast.ai (mais barata, exige configuração manual do cluster).
Esses provedores oferecem créditos grátis?
RunPod $10, Vast.ai $5 (varia), Lambda Labs $15. Use os créditos para testar preços e a experiência de uso antes de comprometer orçamento.
Posso usar imagens Docker personalizadas?
RunPod: sim (envie para um registry). Vast.ai: sim (ferramentas pré-instaladas). Lambda Labs: limitado (imagens predefinidas por simplicidade).
Qual provedor é melhor para inferência em produção 24/7?
Lambda Labs (SLA de 99,9%, instâncias reservadas). RunPod Secure Cloud (SLA de 99%, mais barato). Evite instâncias spot da Vast.ai para uso 24/7 (interrompíveis).
Como minimizo custos com instâncias spot?
Use a Vast.ai com "Interruptible: On" (mais barato), mantenha as instâncias rodando continuamente (sem liga-desliga) e acompanhe as tendências de preço antes de se comprometer.
Qual tem a melhor API para automação?
RunPod (API Python robusta). Lambda Labs (API REST com webhooks). Vast.ai (API mais antiga, interface web como principal).
Posso obter um IP dedicado?
RunPod: sim (sob solicitação). Lambda Labs: sim (gerenciado). Vast.ai: depende do provedor.
Qual é o preço se eu alugar por exatamente 1 hora?
RunPod: mínimo de 60 minutos (arredondado para cima). Lambda Labs: hora cheia cobrada. Vast.ai: cobrança por segundo (você paga exatamente 1 hora, nada a mais).
Qual aluguel de GPU na nuvem é o mais barato?
Instâncias spot da Vast.ai custam 30–50% menos, mas são interrompíveis. O RunPod é 40% mais barato que a Lambda Labs. O preço depende do tipo de GPU e da demanda do mercado.
O aluguel de GPU na nuvem está em conformidade com a LGPD?
Para dados de cidadãos brasileiros, verifique se o provedor pode firmar um DPA e se os dados não são transferidos para fora do Brasil sem base legal adequada. RunPod com regiões EU oferece opções de conformidade. Consulte as seções de GDPR acima para alternativas com residência de dados na UE.