Quais LLMs locais realmente suportam vários idiomas?
"Suportar" um idioma significa mais do que gerar texto nesse idioma. O suporte multilíngue real requer: dados de treinamento no idioma (não apenas tradução), tokenização otimizada para o script do idioma, e ajuste fino no seguimento de instruções nesse idioma.
Modelos que afirmam suporte multilíngue mas foram treinados principalmente em inglês produzem saídas de menor qualidade em outros idiomas — erros gramaticais, inconsistências culturais e menor precisão no seguimento de instruções. Apenas o Qwen3 oferece suporte de qualidade nativa genuína para idiomas asiáticos de forma local.
Família de modelo | Idiomas nativos | Suporte asiático forte | Suporte europeu forte | Suporte árabe |
|---|---|---|---|---|
| Qwen3 | 29 | Sim | Sim | Sim |
| Llama 3.x | 8 | Limitado | Bom | Limitado |
| Mistral | 5 | Não | Bom | Limitado |
| Gemma 4 | 35+ | Moderado | Bom | Moderado |
| Phi-4 | ~10 | Limitado | Moderado | Limitado |
Quais LLMs locais funcionam melhor para idiomas europeus?
Para alemão, francês, espanhol, italiano, português, holandês e polonês — Qwen3, Mistral e Llama 3.x produzem resultados aceitáveis. O Mistral tem força particular no francês porque a Mistral AI é uma empresa francesa com ênfase em dados de treinamento em francês. Os benchmarks em alemão mostram que o Qwen3 8B supera o Mistral Small em 8–12% em tarefas de seguimento de instruções em alemão.
Para o português especificamente: Qwen3 8B lidera em seguimento de instruções formais em pt-BR e pt-PT. Mistral Small é competitivo em texto formal. Llama 3.1 8B é adequado para tarefas gerais. Para casos de uso sensíveis à LGPD no Brasil, executar um modelo local (de qualquer família) é preferível às APIs na nuvem por razões de residência de dados.
- Alemão: Qwen3 8B lidera no seguimento de instruções; Mistral Small competitivo em texto formal.
- Francês: Mistral Small é competitivo com Qwen3 8B; ambos muito acima do Llama 3.1 8B.
- Português (Brasil/Portugal): Qwen3 8B ligeiramente à frente; Llama 3.1 8B competitivo.
- Espanhol, italiano: Qwen3 8B ligeiramente à frente; Llama 3.1 8B competitivo.
- Polonês, tcheco, romeno: Qwen3 8B lidera; queda significativa de qualidade para Mistral Small.
Quais LLMs locais funcionam melhor para idiomas asiáticos?
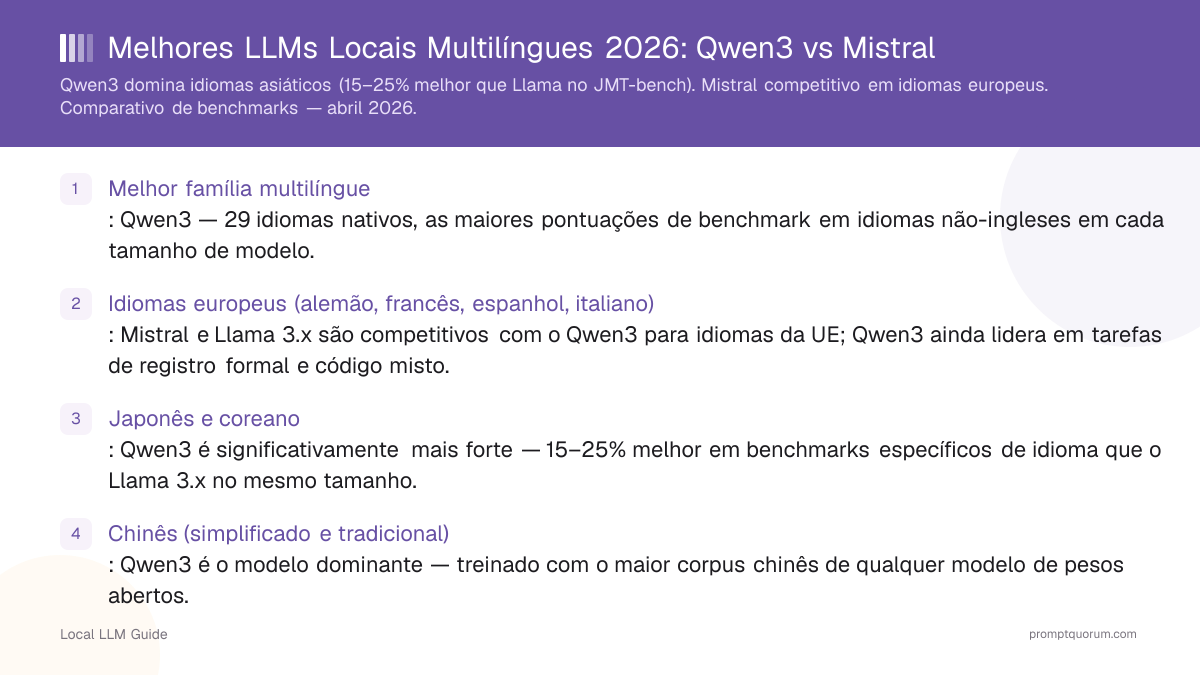
Para japonês, coreano e chinês — o Qwen3 é a escolha única em cada tamanho de modelo comparável. A diferença de qualidade vs Llama 3.x é substancial: 15–25% melhor nos benchmarks JMT-bench (japonês) e Ko-bench (coreano).
Para texto em japonês especificamente: o Qwen3 8B usa tokenização nativa do japonês que processa texto japonês 30–40% mais eficientemente que o Llama, reduzindo o tempo de inferência para documentos em japonês.
- Chinês (simplificado e tradicional): Qwen3 domina — melhor corpus de treinamento, tokenização nativa.
- Japonês: Qwen3 significativamente melhor — 15–25% melhor que Llama em JMT-bench.
- Coreano: Qwen3 lidera — tokenização nativa do hangul, melhor seguimento de instruções formais.
- Thai, vietnamita, indonésio: Qwen3 e Gemma oferecem suporte; Llama e Mistral têm qualidade limitada.
Quais LLMs locais funcionam melhor para árabe e línguas do Oriente Médio?
O árabe é o idioma mais desafiador para modelos locais por causa da escrita da direita para a esquerda (RTL), morfologia complexa e a distinção entre árabe moderno padrão (MSA) e dialetos.
Qwen3 e Gemma 4 oferecem o melhor suporte ao árabe em modelos executáveis localmente. O Llama 3.x tem suporte ao árabe limitado. Para árabe de qualidade profissional, nenhum modelo local atinge a qualidade do GPT-5.6.
Modelo | Pontuação MSA (1–5) | Pontuação dialeto | Velocidade de geração |
|---|---|---|---|
| Qwen3 8B | ★★★ | ★★ | 30–50 tok/s |
| Gemma 4 E2B | ★★★ | ★★ | 30–50 tok/s |
| Llama 3.1 8B | ★★ | ★ | 40–60 tok/s |
| Mistral Small | ★ | ★ | 35–55 tok/s |
Como avaliar a qualidade multilíngue dos LLMs?
O melhor benchmark é testar em sua própria tarefa. Benchmarks genéricos como MMLU existem principalmente em inglês. Para avaliação multilíngue, use:
- 1Execute o MGSM (Multilingual Grade School Math) -- testa o raciocínio matemático em 10 idiomas. Disponível no Hugging Face: datasets/juletxara/mgsm.
- 2Execute o m-MMLU -- a versão multilíngue do MMLU, cobrindo 57 disciplinas em vários idiomas.
- 3Para qualidade conversacional: escreva 10 prompts de teste no idioma alvo cobrindo diferentes tipos de tarefa (resumo, perguntas e respostas, tradução, escrita criativa). Avalie as respostas manualmente ou com um falante nativo.
- 4Para japonês especificamente: use o JMT-bench (github.com/Stability-AI/lm-evaluation-harness), que cobre o seguimento de instruções em japonês.
- 5Compare seu modelo local com APIs na nuvem usando o PromptQuorum -- envie o mesmo prompt multilíngue simultaneamente para seu modelo Ollama local e para o GPT-5.6 para quantificar a diferença de qualidade no seu caso de uso específico.
Tabela comparativa multilíngue
Idioma | Qwen3 8B | Llama 3.1 8B | Mistral Small | Gemma 4 E2B |
|---|---|---|---|---|
| Inglês | ★★★★★ | ★★★★★ | ★★★★★ | ★★★★★ |
| Chinês | ★★★★★ | ★★★ | ★★ | ★★★ |
| Japonês | ★★★★ | ★★ | ★ | ★★★ |
| Coreano | ★★★★ | ★★ | ★ | ★★★ |
| Alemão | ★★★★ | ★★★★ | ★★★★ | ★★★★ |
| Francês | ★★★★ | ★★★★ | ★★★★★ | ★★★★ |
| Português | ★★★★ | ★★★★ | ★★★★ | ★★★★ |
| Árabe (MSA) | ★★★ | ★★ | ★ | ★★★ |
Erros comuns com modelos multilíngues
- Assumir que qualquer LLM suporta bem todos os idiomas. O Llama 3.1 8B tem suporte limitado ao japonês, coreano e árabe — para esses idiomas, use Qwen3 ou Gemma 4.
- Usar o modelo de embedding errado. Para RAG multilíngue, o bge-m3 (suporte a 100+ idiomas) supera o nomic-embed-text em idiomas não-ingleses.
- Ignorar diferenças de tokenização. Modelos com tokenização nativa do idioma (Qwen3 para chinês/japonês/coreano) processam texto 30–40% mais eficientemente, reduzindo o custo de inferência.
- Esperar qualidade de nível GPT-5.6 em modelos locais para idiomas asiáticos. A lacuna é maior do que em inglês. Para uso profissional crítico em japonês/coreano, os modelos locais ainda ficam atrás.
Perguntas frequentes
O Qwen3 é bom para português brasileiro?
Sim. Qwen3 8B oferece bom suporte ao português, com treinamento em dados pt-BR e pt-PT. É ligeiramente melhor que o Llama 3.1 8B em seguimento de instruções formais em português. Mistral Small também é competitivo. Para uso profissional crítico, teste ambos em sua tarefa específica.
Qual LLM local é melhor para tradução inglês-português?
Qwen3 8B e Mistral Small ambos oferecem boa qualidade de tradução. Para tradução de alto volume, o custo $0/token do local supera qualquer API na nuvem. Para qualidade máxima em texto especializado (jurídico, médico), teste manualmente antes de escolher.
Posso usar LLMs locais para suporte a clientes em múltiplos idiomas?
Sim. Para inglês, espanhol, francês, alemão e português: modelos locais 13B oferecem qualidade suficiente para a maioria das interações de suporte. Para japonês, coreano e chinês: use Qwen3 14B ou maior para melhor qualidade. Configure o system prompt no idioma do cliente para melhores resultados.
O suporte ao português melhora com modelos maiores?
Sim. Qwen3 14B e Llama 3.3 70B oferecem qualidade significativamente melhor em português do que os modelos 7B/8B. Para uso profissional crítico (documentos jurídicos, relatórios financeiros), use modelos 14B+ locais ou APIs na nuvem.