Qual modelo de visão do Qwen você deve executar?
Comece com o Qwen3-VL 8B se o seu Ollama for 0.12.7 ou mais recente, e com o Qwen2.5-VL 7B se for mais antigo. A Qwen descreve o Qwen3-VL como o modelo de visão e linguagem mais poderoso da série Qwen até agora; a ficha dele no Hugging Face menciona OCR em 32 idiomas, contexto nativo de 256K e edições Instruct e Thinking.
O Qwen2.5-VL é a geração anterior. A ficha dele destaca a compreensão de documentos, gráficos e layouts, a saída estruturada para digitalizações de notas fiscais, formulários e tabelas e a localização visual com caixas delimitadoras. No Ollama, as duas gerações aceitam texto e imagens como entrada.
O Qwen2-VL, a geração que esta página descrevia originalmente, é história: foi lançado em 2024 e foi superado pelo Qwen2.5-VL e pelo Qwen3-VL. Nada neste guia depende dele.
Essas são descrições da própria Qwen, não medições do PromptQuorum. A precisão nos seus documentos — principalmente com fontes pequenas, escrita à mão ou digitalizações de baixa qualidade — varia, então teste algumas páginas representativas antes de se basear nela.
Execute os modelos de visão do Qwen localmente com `ollama pull qwen3-vl:8b` (6.2 GB) ou `ollama pull qwen2.5vl:7b` (6.0 GB); a antiga tag `qwen2-vl` não está mais na biblioteca oficial do Ollama.
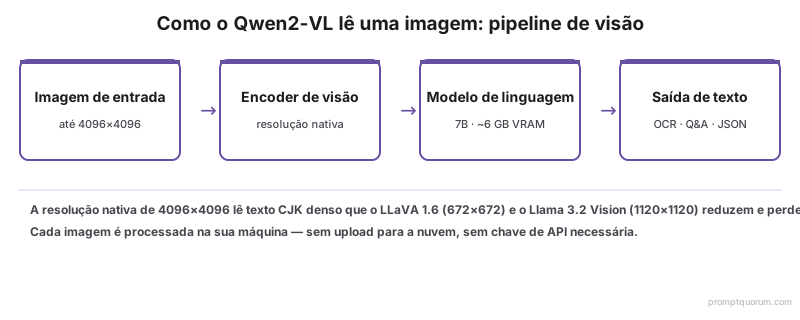
Um modelo de visão e linguagem lê imagens em vez de gerá-las. Você dá a ele uma foto ou uma página digitalizada e ele devolve texto: uma descrição, uma resposta ou o conteúdo extraído.
Tags do Ollama, tamanhos e licenças do Qwen3-VL e do Qwen2.5-VL
Os tamanhos abaixo são os de download exibidos nas páginas da biblioteca do Ollama (qwen3-vl e qwen2.5vl); as licenças vêm das fichas das versões Instruct no Hugging Face (Qwen no Hugging Face). Confira os dois de novo antes de depender deles, porque bibliotecas e licenças mudam.
Modelo | Tag do Ollama | Download | Licença (ficha HF) |
|---|---|---|---|
| Qwen3-VL 2B | qwen3-vl:2b | 1.9 GB | Apache 2.0 |
| Qwen3-VL 4B | qwen3-vl:4b | 3.3 GB | Apache 2.0 |
| Qwen3-VL 8B | qwen3-vl:8b | 6.2 GB | Apache 2.0 |
| Qwen3-VL 30B-A3B (MoE) | qwen3-vl:30b | 20 GB | Apache 2.0 |
| Qwen3-VL 32B | qwen3-vl:32b | 21 GB | Apache 2.0 |
| Qwen3-VL 235B-A22B (MoE) | qwen3-vl:235b | 143 GB | Apache 2.0 |
| Qwen2.5-VL 3B | qwen2.5vl:3b | 3.2 GB | Licença Qwen Research |
| Qwen2.5-VL 7B | qwen2.5vl:7b | 6.0 GB | Apache 2.0 |
| Qwen2.5-VL 32B | qwen2.5vl:32b | 21 GB | Apache 2.0 |
| Qwen2.5-VL 72B | qwen2.5vl:72b | 49 GB | Licença Qwen |
Escolha o tamanho que cabe na sua memória: Qwen3-VL 8B ou Qwen2.5-VL 7B para a maioria das máquinas com uma GPU, as tags de 2B–4B ou 3B para GPUs pequenas e as de 30B+ somente com uma GPU grande ou muita memória unificada. O Ollama também publica tags `-instruct` e `-thinking` do Qwen3-VL (por exemplo `qwen3-vl:8b-instruct`, 6.2 GB); use uma tag Instruct quando quiser uma saída de extração direta, sem texto de raciocínio. As tags padrão têm o mesmo tamanho que suas variantes `q4_K_M` — veja quantização de LLM explicada.
Requisitos de hardware para os modelos de visão do Qwen
- Os tamanhos de download são apenas os pesos: o Qwen3-VL 8B tem 6.2 GB e o Qwen2.5-VL 7B tem 6.0 GB. O cache de contexto e o codificador de imagens precisam de memória extra, que cresce com o tamanho do contexto e da imagem, então deixe folga acima do tamanho do download.
- Opções menores: Qwen3-VL 2B (1.9 GB) e 4B (3.3 GB) ou Qwen2.5-VL 3B (3.2 GB) servem para GPUs pequenas e notebooks; espere menos precisão do que nos modelos de 7B–8B.
- Opções maiores: Qwen3-VL 30B-A3B (20 GB), Qwen3-VL 32B e Qwen2.5-VL 32B (21 GB) e Qwen2.5-VL 72B (49 GB) exigem uma GPU grande, várias GPUs ou Apple Silicon com muita memória unificada.
- Offload parcial: quando um modelo não cabe na VRAM, o Ollama pode colocar parte dele na RAM do sistema; funciona, mas é bem mais lento.
- Software: Ollama 0.12.7+ para o Qwen3-VL e 0.7.0+ para o Qwen2.5-VL, conforme as páginas da biblioteca do Ollama.
📌Nota: O PromptQuorum não fez benchmarks desses modelos em GPUs específicas para este guia, por isso não há números de velocidade nem de VRAM exata. Execute `ollama ps` depois de carregar um modelo para ver a memória que ele realmente usa na sua máquina.
Configurando o Qwen2.5-VL e o Qwen3-VL com o Ollama
O Ollama é a forma mais rápida de executar os modelos de visão do Qwen localmente. Ele baixa o modelo, gerencia a quantização e expõe uma API em localhost:11434. Instale-o em ollama.com — ou, se for novo no assunto, comece por como instalar o Ollama.
- 1Instalar ou atualizar o Ollama
Why it matters: O Qwen2.5-VL exige Ollama 0.7.0 ou mais recente e o Qwen3-VL exige 0.12.7 ou mais recente. Verifique com `ollama --version` e atualize se necessário. O Ollama está disponível para macOS, Linux e Windows. - 2Baixar um modelo com uma tag explícita
Why it matters: Use `qwen3-vl:8b` ou `qwen2.5vl:7b`. Não use `qwen2-vl:7b` — ele não está na biblioteca oficial do Ollama, então o download falha. - 3Executar o modelo e anexar uma imagem
Why it matters: No modo interativo, digite o caminho do arquivo de imagem dentro do prompt. O Ollama detecta o caminho e carrega a imagem. - 4Enviar imagens pela API
Why it matters: O endpoint /api/generate aceita um array `images` em base64 sem o prefixo data:. É assim que aplicações — e o PromptQuorum — enviam imagens de forma programática. - 5Verificar o OCR multilíngue
Why it matters: Envie a digitalização de um documento em chinês ou japonês e compare o texto extraído com o original antes de construir em cima disso.
# Step 1 — Install or update Ollama (Qwen3-VL needs 0.12.7+, Qwen2.5-VL needs 0.7.0+)
# macOS
brew install ollama

# Linux
curl -fsSL https://ollama.com/install.sh | sh

# Windows — download from https://ollama.com/download
ollama --version

# Step 2 — Pull a Qwen vision model (explicit tag)
ollama pull qwen3-vl:8b          # 6.2 GB
# or: ollama pull qwen2.5vl:7b   # 6.0 GB

# Step 3 — Run and attach an image (interactive)
ollama run qwen3-vl:8b
>>> Extract every line of text from ./invoice-jp.png

# Step 4 — Send an image through the API
# Encode the image first:  base64 -i scan.png   (macOS)
curl http://localhost:11434/api/generate -d '{
  "model": "qwen3-vl:8b",
  "prompt": "Extract every line of text from this document. Preserve line breaks.",
  "images": ["<base64-encoded-image>"],
  "stream": false
}'

# Step 5 — Verify multilingual OCR
ollama run qwen3-vl:8b
>>> Extract all text from this image: ./contract-zh.png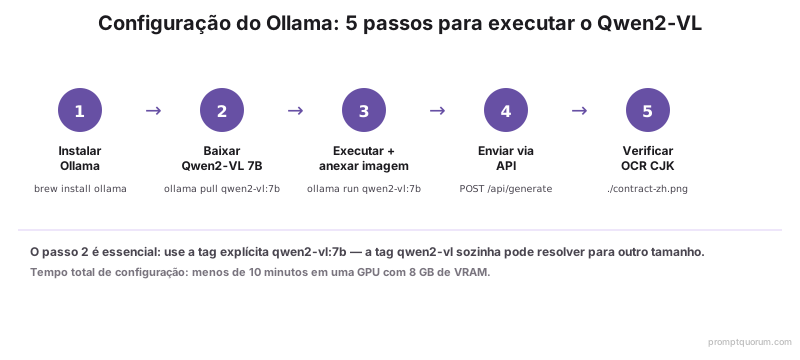
⚠️Aviso: Envie as imagens de documentos com 150 DPI ou mais. A qualidade da imagem é o fator mais importante nos resultados de OCR — uma digitalização borrada gera caracteres errados com qualquer modelo.
Configurando os modelos de visão do Qwen com o LM Studio
O LM Studio executa modelos de visão por uma interface gráfica, sem comandos de terminal. Baixe-o em lmstudio.ai ou veja como instalar o LM Studio. O catálogo de modelos muda com o tempo, então confira o que ele oferece hoje para o Qwen.
- 1Baixar e instalar o LM Studio
Why it matters: Uma interface gráfica multiplataforma para inferência local de modelos. Não precisa de terminal. - 2Procurar os modelos de visão do Qwen
Why it matters: Pesquise "Qwen3-VL" ou "Qwen2.5-VL" no navegador de modelos e escolha uma versão cuja ficha informe suporte a visão. Ajuste a quantização à sua memória. - 3Carregar o modelo e anexar uma imagem
Why it matters: Use o botão de imagem na caixa de chat para enviar uma foto ou digitalização. O LM Studio a repassa ao codificador de visão. - 4Iniciar o servidor local
Why it matters: A opção "Start Server" expõe uma API compatível com a OpenAI em localhost:1234. As requisições de visão usam o formato de conteúdo padrão image_url.
// LM Studio — OpenAI-compatible vision request (localhost:1234)
{
  "model": "<model-id-shown-in-LM-Studio>",
  "messages": [
    {
      "role": "user",
      "content": [
        { "type": "text", "text": "Extract all text from this document." },
        {
          "type": "image_url",
          "image_url": { "url": "data:image/png;base64,<base64-encoded-image>" }
        }
      ]
    }
  ]
}
OCR de documentos em chinês, japonês e idiomas mistos
Os modelos de visão do Qwen conseguem extrair texto de documentos em chinês, japonês, coreano e idiomas mistos, mas a precisão depende da qualidade da digitalização e do layout — teste nos seus próprios documentos. A ficha do Qwen3-VL menciona OCR em 32 idiomas, e a do Qwen2.5-VL descreve a saída estruturada para digitalizações de notas fiscais, formulários e tabelas.
O padrão mais confiável é um prompt de extração específico. Peça estrutura — "preserve o layout da tabela", "devolva cada campo como chave: valor" — em vez de um vago "leia isto".
Para extrair texto de um documento CJK, envie a imagem com 150+ DPI para qwen3-vl:8b ou qwen2.5vl:7b com um prompt específico que peça estrutura, como "devolva cada campo como chave: valor".
OCR significa transformar a imagem de um texto em texto editável. O modelo olha uma página digitalizada e escreve o que vê.
- Extração de texto simples: "Extraia cada linha de texto desta imagem. Preserve as quebras de linha e a ordem de leitura."
- Campos estruturados: "Esta é uma nota fiscal japonesa. Devolva fornecedor, data, subtotal, imposto e total como pares chave: valor."
- Extração de tabelas: "Extraia esta tabela como CSV. Trate a primeira linha como cabeçalho."
- Extrair e traduzir de uma vez: "Extraia o texto em chinês desta imagem e traduza para o inglês. Mostre os dois."
# Japanese invoice -> structured fields
ollama run qwen3-vl:8b
>>> This is a Japanese invoice. Extract vendor name, invoice date,
    subtotal, consumption tax, and total. Return as key: value pairs.
    ./invoice-jp.png

# Illustrative output format (not a measured result):
# vendor: <vendor name>
# date: <invoice date>
# subtotal: <amount> JPY
# tax: <amount> JPY
# total: <amount> JPY•Important: Sempre confira os números extraídos com o documento original. Modelos de visão locais podem ler um dígito errado em uma digitalização de baixa qualidade. Trate o resultado do OCR como um rascunho a confirmar, não como um valor final, principalmente em notas fiscais e documentos financeiros.
Perguntas sobre imagens, análise de capturas de tela e leitura de gráficos
Além do OCR, os modelos de visão do Qwen descrevem fotos, respondem perguntas sobre capturas de tela e leem gráficos. Os resultados são melhores com entradas nítidas e piores com cenas confusas ou ambíguas.
- Perguntas sobre imagens: faça perguntas abertas sobre uma foto — "O que há nesta imagem?" — e confira as respostas com a imagem.
- Análise de capturas de tela e de interfaces: comece lendo capturas de interface, caixas de erro e estados de aplicativos. As fichas dos dois modelos também descrevem habilidades de agente para interfaces gráficas, que este guia não cobre.
- Leitura de gráficos: descrever a estrutura e as tendências de um gráfico funciona melhor do que extrair números exatos; confirme os valores exatos nos dados de origem.
- Comparação de várias imagens: envie várias imagens em uma única requisição para comparar versões ou descrever um conjunto; quantas cabem depende da sua memória e do tamanho do contexto.
💡Dica: Para um panorama de outros modelos de visão locais, veja a comparação de modelos de visão locais.
Comparação entre Qwen2-VL, Qwen2.5-VL e Qwen3-VL
O Qwen2-VL é o mais antigo dos três e o único sem entrada oficial na biblioteca do Ollama; o Qwen2.5-VL e o Qwen3-VL são as opções atuais. A tabela resume o que dá para conferir na biblioteca do Ollama e nas fichas do Hugging Face.
Geração | Lançamento | Tag oficial do Ollama | Licença (ficha HF) | Observações |
|---|---|---|---|---|
| Qwen2-VL | 2024 | Nenhuma (a página retorna 404) | Apache 2.0 (2B/7B); licença Qwen (72B) | Apenas histórico |
| Qwen2.5-VL | 2025 | qwen2.5vl (3b, 7b, 32b, 72b) | Apache 2.0 (7B/32B); licenças Qwen (3B/72B) | Contexto de 125K no Ollama |
| Qwen3-VL | 2025 | qwen3-vl (de 2b a 235b) | Apache 2.0 (todos os tamanhos conferidos) | Contexto de 256K; Instruct e Thinking |
A linha do Qwen2-VL reflete uma verificação de ollama.com/library/qwen2-vl, que retornou HTTP 404, na data da última atualização desta página. Existem outros modelos de visão locais; esta página não os classifica — veja a comparação de modelos de visão locais.
Conectando um modelo de visão local do Qwen ao PromptQuorum
O PromptQuorum pode usar um servidor Ollama local como um de seus endpoints de modelo. O Ollama expõe uma API compatível com a OpenAI em `http://localhost:11434/v1`; aponte a configuração de modelo local para esse endereço e selecione a tag de visão que você baixou, por exemplo `qwen3-vl:8b`. Consulte as configurações do aplicativo para ver os nomes exatos dos campos.
As requisições com imagens enviadas a um endpoint local são processadas pelo seu servidor Ollama em vez de uma API de visão na nuvem, enquanto os modelos na nuvem continuam disponíveis para outras tarefas. Para quais modelos rotear é decisão sua, e qualquer modelo na nuvem que você adicionar recebe o que você enviar a ele.
Conecte o PromptQuorum a um modelo de visão local do Qwen apontando o endpoint local para http://localhost:11434/v1 e selecionando a tag baixada, como qwen3-vl:8b.
Solução de problemas dos modelos de visão do Qwen
- "pull model manifest: file does not exist" ou modelo desconhecido: a tag não está na biblioteca oficial. `qwen2-vl:7b` não está disponível — use `ollama pull qwen3-vl:8b` ou `ollama pull qwen2.5vl:7b`.
- O download termina, mas o modelo não carrega: atualize o Ollama. O Qwen2.5-VL exige 0.7.0+ e o Qwen3-VL exige 0.12.7+.
- A imagem é ignorada e o modelo responde como se nenhuma imagem tivesse sido enviada: confirme que o caminho do arquivo está correto e legível. Na API do Ollama, o array `images` deve conter base64 puro *sem* o prefixo `data:`; o prefixo `data:` é só do formato do LM Studio e da OpenAI.
- Caracteres CJK ilegíveis ou ausentes: a digitalização provavelmente tem resolução baixa demais. Digitalize de novo a 150–300 DPI e compare o resultado.
- Falta de memória: escolha uma tag menor (por exemplo `qwen3-vl:4b` ou `qwen2.5vl:3b`), reduza o tamanho do contexto ou a resolução da imagem, ou use Apple Silicon, que compartilha memória unificada entre CPU e GPU.
- Números errados extraídos de uma nota fiscal ou gráfico: modelos de visão locais podem ler dígitos errados em entradas com ruído. Melhore a qualidade da digitalização e sempre confira a saída numérica com o original.
- Um PDF não carrega: a API do Ollama aceita imagens, não arquivos PDF. Converta primeiro as páginas em PNG ou JPEG (com pdf2image ou pypdfium2) e envie cada página como uma imagem separada.
- O LM Studio mostra "failed to load model": ou a memória é insuficiente, ou você baixou uma versão sem visão. Confirme que a ficha do modelo informa suporte a visão e tente uma quantização menor.
💡Dica: Execute `ollama ps` para ver quais modelos estão carregados e quanta memória cada um usa. Use `ollama stop qwen3-vl:8b` para descarregar um modelo antes de carregar um maior.
Perguntas frequentes
Por que o ollama pull qwen2-vl:7b falha?
Porque o Qwen2-VL não tem entrada na biblioteca oficial do Ollama — a página da biblioteca retorna HTTP 404. Use `ollama pull qwen2.5vl:7b` (Ollama 0.7.0+) ou `ollama pull qwen3-vl:8b` (Ollama 0.12.7+). Consulte ollama.com/library para ver a lista atual.
Devo usar o Qwen2.5-VL ou o Qwen3-VL?
O Qwen3-VL é a geração mais nova (a Qwen o descreve como o modelo de visão e linguagem mais poderoso da série até agora), mas exige Ollama 0.12.7 ou mais recente. O Qwen2.5-VL roda no Ollama 0.7.0+ e vai de 3B a 72B. Teste os dois em alguns dos seus documentos; a precisão depende do seu material.
Qual é o hardware mínimo para executar esses modelos?
Não há um número único. Os tamanhos de download no Ollama são 1.9 GB (Qwen3-VL 2B), 3.3 GB (4B), 6.2 GB (8B) e 3.2 GB (Qwen2.5-VL 3B), 6.0 GB (7B). O cache de contexto e o codificador de imagens precisam de memória extra, então deixe folga e use `ollama ps` para ver o uso real na sua máquina.
Esses modelos leem PDFs diretamente?
Não pelo Ollama: a API dele aceita imagens. Converta primeiro cada página do PDF em PNG ou JPEG (com pdf2image ou pypdfium2), envie cada página como uma requisição de imagem separada e combine os resultados.
Como envio uma imagem pelo Ollama?
De duas formas. No modo interativo (`ollama run qwen3-vl:8b`), digite o caminho do arquivo de imagem dentro do prompt — o Ollama o detecta e carrega a imagem. Pela API, faça um POST em /api/generate com um array `images` em base64. A string base64 não deve incluir o prefixo `data:`.
Os modelos funcionam totalmente offline?
Depois do download único do modelo, a inferência roda na sua própria máquina sem conta na nuvem, então o Ollama não envia as imagens que você manda a uma API na nuvem. Outros programas da máquina ainda podem enviar dados para fora, e as obrigações de proteção de dados do seu fluxo de trabalho continuam valendo; isto não é aconselhamento jurídico. Veja o guia de configuração LGPD/GDPR do Qwen local para mais detalhes.
Posso usá-los comercialmente?
Depende do tamanho e da licença da ficha do modelo. As fichas do Hugging Face indicam Apache 2.0 para o Qwen3-VL e para o Qwen2.5-VL 7B e 32B, e licenças da Qwen para o Qwen2.5-VL 3B e 72B. Leia o texto atual da licença antes de usar comercialmente.
Por que os caracteres saem ilegíveis no resultado do OCR?
Quase sempre por causa de uma digitalização borrada ou de baixa resolução. Digitalize o documento de novo a 150–300 DPI e compare. Entrada de baixa qualidade é a maior causa de erros de OCR em qualquer modelo de visão local.