¿Qué modelo de visión de Qwen deberías ejecutar?
Empieza con Qwen3-VL 8B si tu Ollama es 0.12.7 o posterior, y con Qwen2.5-VL 7B si es anterior. Qwen describe Qwen3-VL como el modelo de visión-lenguaje más potente de la serie Qwen hasta la fecha; su ficha de Hugging Face menciona OCR en 32 idiomas, un contexto nativo de 256K y ediciones Instruct y Thinking.
Qwen2.5-VL es la generación anterior. Su ficha destaca la comprensión de documentos, gráficos y diseños, la salida estructurada para escaneos de facturas, formularios y tablas, y la localización visual con cuadros delimitadores. En Ollama ambas generaciones aceptan texto e imágenes como entrada.
Qwen2-VL, la generación que esta página describía originalmente, es historia: se lanzó en 2024 y ha sido superado por Qwen2.5-VL y Qwen3-VL. Nada de esta guía depende de él.
Son descripciones del propio equipo de Qwen, no mediciones de PromptQuorum. La precisión con tus documentos — sobre todo con fuentes pequeñas, escritura a mano o escaneos de baja calidad — varía, así que prueba unas cuantas páginas representativas antes de apoyarte en ella.
Ejecuta modelos de visión de Qwen en local con `ollama pull qwen3-vl:8b` (6.2 GB) o `ollama pull qwen2.5vl:7b` (6.0 GB); la antigua etiqueta `qwen2-vl` ya no está en la biblioteca oficial de Ollama.
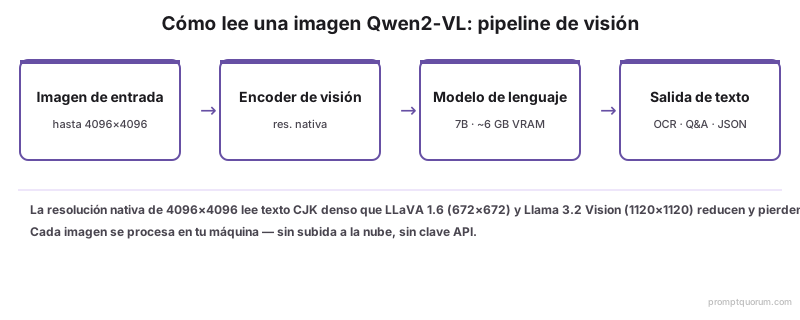
Un modelo de visión-lenguaje lee imágenes en lugar de generarlas. Le das una foto o una página escaneada y devuelve texto: una descripción, una respuesta o el contenido extraído.
Etiquetas de Ollama, tamaños y licencias de Qwen3-VL y Qwen2.5-VL
Los tamaños siguientes son los de descarga que muestran las páginas de la biblioteca de Ollama (qwen3-vl y qwen2.5vl); las licencias proceden de las fichas de Hugging Face de las versiones Instruct (Qwen en Hugging Face). Vuelve a comprobar ambos antes de basarte en ellos, porque las bibliotecas y las licencias cambian.
Modelo | Etiqueta de Ollama | Descarga | Licencia (ficha HF) |
|---|---|---|---|
| Qwen3-VL 2B | qwen3-vl:2b | 1.9 GB | Apache 2.0 |
| Qwen3-VL 4B | qwen3-vl:4b | 3.3 GB | Apache 2.0 |
| Qwen3-VL 8B | qwen3-vl:8b | 6.2 GB | Apache 2.0 |
| Qwen3-VL 30B-A3B (MoE) | qwen3-vl:30b | 20 GB | Apache 2.0 |
| Qwen3-VL 32B | qwen3-vl:32b | 21 GB | Apache 2.0 |
| Qwen3-VL 235B-A22B (MoE) | qwen3-vl:235b | 143 GB | Apache 2.0 |
| Qwen2.5-VL 3B | qwen2.5vl:3b | 3.2 GB | Licencia Qwen Research |
| Qwen2.5-VL 7B | qwen2.5vl:7b | 6.0 GB | Apache 2.0 |
| Qwen2.5-VL 32B | qwen2.5vl:32b | 21 GB | Apache 2.0 |
| Qwen2.5-VL 72B | qwen2.5vl:72b | 49 GB | Licencia Qwen |
Elige el tamaño que quepa en tu memoria: Qwen3-VL 8B o Qwen2.5-VL 7B para la mayoría de equipos con una sola GPU, las etiquetas de 2B–4B o 3B para GPUs pequeñas y las de 30B+ solo con una GPU grande o mucha memoria unificada. Ollama también publica etiquetas `-instruct` y `-thinking` de Qwen3-VL (por ejemplo `qwen3-vl:8b-instruct`, 6.2 GB); usa una etiqueta Instruct si quieres una salida de extracción directa, sin texto de razonamiento. Las etiquetas por defecto tienen el mismo tamaño que sus variantes `q4_K_M` — consulta cuantización de LLM explicada.
Requisitos de hardware para los modelos de visión de Qwen
- Los tamaños de descarga son solo los pesos: Qwen3-VL 8B ocupa 6.2 GB y Qwen2.5-VL 7B ocupa 6.0 GB. La caché de contexto y el codificador de imágenes necesitan memoria adicional que crece con la longitud del contexto y el tamaño de la imagen, así que deja margen sobre el tamaño de descarga.
- Opciones más pequeñas: Qwen3-VL 2B (1.9 GB) y 4B (3.3 GB) o Qwen2.5-VL 3B (3.2 GB) sirven para GPUs pequeñas y portátiles; espera menos precisión que con los modelos de 7B–8B.
- Opciones más grandes: Qwen3-VL 30B-A3B (20 GB), Qwen3-VL 32B y Qwen2.5-VL 32B (21 GB) y Qwen2.5-VL 72B (49 GB) requieren una GPU grande, varias GPUs o Apple Silicon con mucha memoria unificada.
- Descarga parcial: cuando un modelo no cabe en la VRAM, Ollama puede colocar parte en la RAM del sistema; funciona, pero es notablemente más lento.
- Software: Ollama 0.12.7+ para Qwen3-VL y 0.7.0+ para Qwen2.5-VL, según indican las páginas de la biblioteca de Ollama.
📌Nota: PromptQuorum no ha medido estos modelos en GPUs concretas para esta guía, por lo que no se dan cifras de velocidad ni de VRAM exacta. Ejecuta `ollama ps` tras cargar un modelo para ver la memoria que usa realmente en tu equipo.
Configuración de Qwen2.5-VL y Qwen3-VL con Ollama
Ollama es la forma más rápida de ejecutar modelos de visión de Qwen en local. Descarga el modelo, gestiona la cuantización y expone una API en localhost:11434. Instálalo desde ollama.com — o, si es la primera vez, empieza por cómo instalar Ollama.
- 1Instalar o actualizar Ollama
Why it matters: Qwen2.5-VL necesita Ollama 0.7.0 o posterior y Qwen3-VL necesita 0.12.7 o posterior. Comprueba con `ollama --version` y actualiza si hace falta. Ollama está disponible para macOS, Linux y Windows. - 2Descargar un modelo con una etiqueta explícita
Why it matters: Usa `qwen3-vl:8b` o `qwen2.5vl:7b`. No uses `qwen2-vl:7b`: no está en la biblioteca oficial de Ollama, así que la descarga falla. - 3Ejecutar el modelo y adjuntar una imagen
Why it matters: En modo interactivo, escribe la ruta del archivo de imagen dentro de tu prompt. Ollama detecta la ruta y carga la imagen. - 4Enviar imágenes por la API
Why it matters: El endpoint /api/generate acepta un array `images` en base64 sin el prefijo data:. Así envían imágenes las aplicaciones — y PromptQuorum — de forma programática. - 5Verificar el OCR multilingüe
Why it matters: Envía el escaneo de un documento en chino o japonés y compara el texto extraído con el original antes de construir sobre ello.
# Step 1 — Install or update Ollama (Qwen3-VL needs 0.12.7+, Qwen2.5-VL needs 0.7.0+)
# macOS
brew install ollama

# Linux
curl -fsSL https://ollama.com/install.sh | sh

# Windows — download from https://ollama.com/download
ollama --version

# Step 2 — Pull a Qwen vision model (explicit tag)
ollama pull qwen3-vl:8b          # 6.2 GB
# or: ollama pull qwen2.5vl:7b   # 6.0 GB

# Step 3 — Run and attach an image (interactive)
ollama run qwen3-vl:8b
>>> Extract every line of text from ./invoice-jp.png

# Step 4 — Send an image through the API
# Encode the image first:  base64 -i scan.png   (macOS)
curl http://localhost:11434/api/generate -d '{
  "model": "qwen3-vl:8b",
  "prompt": "Extract every line of text from this document. Preserve line breaks.",
  "images": ["<base64-encoded-image>"],
  "stream": false
}'

# Step 5 — Verify multilingual OCR
ollama run qwen3-vl:8b
>>> Extract all text from this image: ./contract-zh.png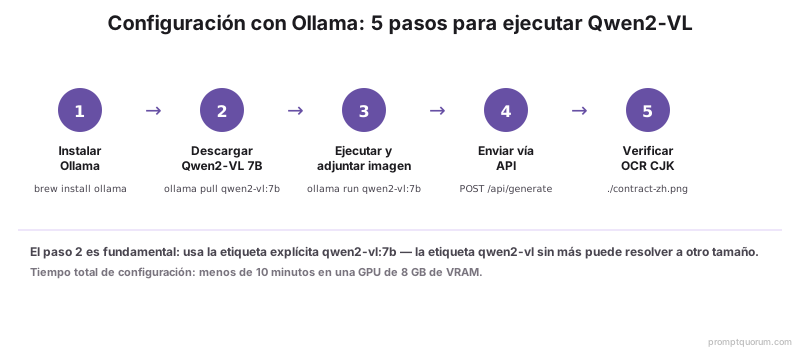
⚠️Advertencia: Envía las imágenes de documentos a 150 DPI o más. La calidad de la imagen es el factor más importante en los resultados de OCR: un escaneo borroso produce caracteres erróneos con cualquier modelo.
Configuración de los modelos de visión de Qwen con LM Studio
LM Studio ejecuta modelos de visión mediante una interfaz gráfica, sin comandos de terminal. Descárgalo desde lmstudio.ai o consulta cómo instalar LM Studio. Su catálogo de modelos cambia con el tiempo, así que comprueba qué ofrece ahora para Qwen.
- 1Descargar e instalar LM Studio
Why it matters: Una interfaz gráfica multiplataforma para la inferencia local de modelos. No hace falta terminal. - 2Buscar modelos de visión de Qwen
Why it matters: Busca "Qwen3-VL" o "Qwen2.5-VL" en el explorador de modelos y elige una variante cuya ficha indique compatibilidad con visión. Ajusta la cuantización a tu memoria. - 3Cargar el modelo y adjuntar una imagen
Why it matters: Usa el botón de imagen del cuadro de chat para subir una foto o un escaneo. LM Studio la pasa al codificador de visión. - 4Iniciar el servidor local
Why it matters: La opción "Start Server" expone una API compatible con OpenAI en localhost:1234. Las solicitudes de visión usan el formato de contenido estándar image_url.
// LM Studio — OpenAI-compatible vision request (localhost:1234)
{
  "model": "<model-id-shown-in-LM-Studio>",
  "messages": [
    {
      "role": "user",
      "content": [
        { "type": "text", "text": "Extract all text from this document." },
        {
          "type": "image_url",
          "image_url": { "url": "data:image/png;base64,<base64-encoded-image>" }
        }
      ]
    }
  ]
}
OCR de documentos en chino, japonés e idiomas mixtos
Los modelos de visión de Qwen pueden extraer texto de documentos en chino, japonés, coreano e idiomas mixtos, pero la precisión depende de la calidad del escaneo y del diseño: prueba con tus propios documentos. La ficha de Qwen3-VL menciona OCR en 32 idiomas, y la de Qwen2.5-VL describe la salida estructurada para escaneos de facturas, formularios y tablas.
El patrón más fiable es un prompt de extracción concreto. Pide estructura — "conserva el diseño de la tabla", "devuelve cada campo como clave: valor" — en lugar de un vago "lee esto".
Para extraer texto de un documento CJK, envía la imagen a 150+ DPI a qwen3-vl:8b o qwen2.5vl:7b con un prompt concreto que pida estructura, como "devuelve cada campo como clave: valor".
OCR significa convertir la imagen de un texto en texto editable. El modelo mira una página escaneada y escribe lo que ve.
- Extracción de texto simple: "Extrae cada línea de texto de esta imagen. Conserva los saltos de línea y el orden de lectura."
- Campos estructurados: "Esta es una factura japonesa. Devuelve proveedor, fecha, subtotal, impuesto y total como pares clave: valor."
- Extracción de tablas: "Extrae esta tabla como CSV. Trata la primera fila como encabezado."
- Extraer y traducir de una vez: "Extrae el texto en chino de esta imagen y tradúcelo al inglés. Muestra ambos."
# Japanese invoice -> structured fields
ollama run qwen3-vl:8b
>>> This is a Japanese invoice. Extract vendor name, invoice date,
    subtotal, consumption tax, and total. Return as key: value pairs.
    ./invoice-jp.png

# Illustrative output format (not a measured result):
# vendor: <vendor name>
# date: <invoice date>
# subtotal: <amount> JPY
# tax: <amount> JPY
# total: <amount> JPY•Important: Verifica siempre los números extraídos con el documento original. Los modelos de visión locales pueden leer mal un dígito en un escaneo de baja calidad. Trata el resultado del OCR como un borrador que hay que confirmar, no como un valor final, sobre todo en facturas y documentos financieros.
Preguntas sobre imágenes, análisis de capturas de pantalla y lectura de gráficos
Además del OCR, los modelos de visión de Qwen describen fotos, responden preguntas sobre capturas de pantalla y leen gráficos. Los resultados son mejores con entradas claras y peores con escenas confusas o ambiguas.
- Preguntas sobre imágenes: haz preguntas abiertas sobre una foto — "¿Qué hay en esta imagen?" — y comprueba las respuestas con la imagen.
- Análisis de capturas y de interfaces: empieza leyendo capturas de interfaz, cuadros de error y estados de aplicaciones. Las fichas de ambos modelos también describen capacidades de agente para interfaces gráficas, que esta guía no cubre.
- Lectura de gráficos: describir la estructura y las tendencias de un gráfico funciona mejor que extraer cifras exactas; confirma los valores exactos con los datos de origen.
- Comparación de varias imágenes: envía varias imágenes en una misma solicitud para comparar versiones o describir un conjunto; cuántas caben depende de tu memoria y del tamaño del contexto.
💡Consejo: Para un repaso de otros modelos de visión locales, consulta la comparativa de modelos de visión locales.
Comparativa Qwen2-VL, Qwen2.5-VL y Qwen3-VL
Qwen2-VL es el más antiguo de los tres y el único sin entrada oficial en la biblioteca de Ollama; Qwen2.5-VL y Qwen3-VL son las opciones actuales. La tabla resume lo que se puede comprobar en la biblioteca de Ollama y en las fichas de Hugging Face.
Generación | Lanzamiento | Etiqueta oficial Ollama | Licencia (ficha HF) | Notas |
|---|---|---|---|---|
| Qwen2-VL | 2024 | Ninguna (la página da 404) | Apache 2.0 (2B/7B); licencia Qwen (72B) | Solo histórico |
| Qwen2.5-VL | 2025 | qwen2.5vl (3b, 7b, 32b, 72b) | Apache 2.0 (7B/32B); licencias Qwen (3B/72B) | Contexto de 125K en Ollama |
| Qwen3-VL | 2025 | qwen3-vl (de 2b a 235b) | Apache 2.0 (todos los tamaños revisados) | Contexto 256K; Instruct y Thinking |
La fila de Qwen2-VL refleja una comprobación de ollama.com/library/qwen2-vl, que devolvió HTTP 404, en el momento de la última actualización de esta página. Existen otros modelos de visión locales; esta página no los clasifica — consulta la comparativa de modelos de visión locales.
Conectar un modelo de visión local de Qwen con PromptQuorum
PromptQuorum puede usar un servidor Ollama local como uno de sus endpoints de modelo. Ollama expone una API compatible con OpenAI en `http://localhost:11434/v1`; apunta el ajuste de modelo local a esa dirección y selecciona la etiqueta de visión que descargaste, por ejemplo `qwen3-vl:8b`. Consulta los ajustes de la aplicación para ver los nombres exactos de los campos.
Las solicitudes con imágenes enviadas a un endpoint local las procesa tu servidor Ollama en lugar de una API de visión en la nube, mientras que los modelos en la nube siguen disponibles para otras tareas. Tú decides a qué modelos enrutas, y cualquier modelo en la nube que añadas recibe lo que le envíes.
Conecta PromptQuorum con un modelo de visión local de Qwen apuntando su endpoint local a http://localhost:11434/v1 y seleccionando la etiqueta descargada, como qwen3-vl:8b.
Solución de problemas de los modelos de visión de Qwen
- "pull model manifest: file does not exist" o modelo desconocido: la etiqueta no está en la biblioteca oficial. `qwen2-vl:7b` no está disponible — usa `ollama pull qwen3-vl:8b` o `ollama pull qwen2.5vl:7b`.
- La descarga termina pero el modelo no carga: actualiza Ollama. Qwen2.5-VL necesita 0.7.0+ y Qwen3-VL necesita 0.12.7+.
- Se ignora la imagen y el modelo responde como si no hubieras enviado ninguna: confirma que la ruta del archivo es correcta y legible. En la API de Ollama, el array `images` debe contener base64 sin procesar *sin* el prefijo `data:`; el prefijo `data:` es solo del formato de LM Studio y OpenAI.
- Caracteres CJK ilegibles o ausentes: probablemente el escaneo tiene muy poca resolución. Vuelve a escanear a 150–300 DPI y compara el resultado.
- Sin memoria: elige una etiqueta más pequeña (por ejemplo `qwen3-vl:4b` o `qwen2.5vl:3b`), reduce el tamaño del contexto o la resolución de la imagen, o usa Apple Silicon, que comparte memoria unificada entre CPU y GPU.
- Números incorrectos extraídos de una factura o un gráfico: los modelos de visión locales pueden leer mal los dígitos con entradas ruidosas. Mejora la calidad del escaneo y verifica siempre la salida numérica con el original.
- Un PDF no se carga: la API de Ollama acepta imágenes, no archivos PDF. Convierte primero las páginas a PNG o JPEG (con pdf2image o pypdfium2) y envía cada página como una imagen independiente.
- LM Studio muestra "failed to load model": o no hay memoria suficiente, o descargaste una variante sin visión. Confirma que la ficha del modelo indica compatibilidad con visión y prueba una cuantización menor.
💡Consejo: Ejecuta `ollama ps` para ver qué modelos están cargados y cuánta memoria usa cada uno. Usa `ollama stop qwen3-vl:8b` para descargar un modelo antes de cargar uno mayor.
Preguntas frecuentes
¿Por qué falla ollama pull qwen2-vl:7b?
Porque Qwen2-VL no tiene entrada en la biblioteca oficial de Ollama: la página de la biblioteca devuelve HTTP 404. Usa en su lugar `ollama pull qwen2.5vl:7b` (Ollama 0.7.0+) o `ollama pull qwen3-vl:8b` (Ollama 0.12.7+). Consulta ollama.com/library para ver la lista actual.
¿Debería usar Qwen2.5-VL o Qwen3-VL?
Qwen3-VL es la generación más nueva (Qwen lo describe como el modelo de visión-lenguaje más potente de su serie hasta la fecha), pero requiere Ollama 0.12.7 o posterior. Qwen2.5-VL funciona con Ollama 0.7.0+ y abarca de 3B a 72B. Prueba ambos con algunos de tus documentos; la precisión depende de tu material.
¿Cuál es el hardware mínimo para ejecutar estos modelos?
No hay una cifra única. Los tamaños de descarga en Ollama son 1.9 GB (Qwen3-VL 2B), 3.3 GB (4B), 6.2 GB (8B) y 3.2 GB (Qwen2.5-VL 3B), 6.0 GB (7B). La caché de contexto y el codificador de imágenes necesitan memoria adicional, así que deja margen y usa `ollama ps` para comprobar el uso real en tu equipo.
¿Pueden estos modelos leer PDF directamente?
No a través de Ollama: su API acepta imágenes. Convierte primero cada página del PDF a PNG o JPEG (con pdf2image o pypdfium2), envía cada página como una solicitud de imagen independiente y combina los resultados.
¿Cómo envío una imagen a través de Ollama?
De dos formas. En modo interactivo (`ollama run qwen3-vl:8b`), escribe la ruta del archivo de imagen dentro de tu prompt: Ollama la detecta y carga la imagen. Por la API, haz un POST a /api/generate con un array `images` en base64. La cadena base64 no debe incluir el prefijo `data:`.
¿Los modelos funcionan totalmente sin conexión?
Tras la descarga única del modelo, la inferencia se ejecuta en tu propio equipo sin cuenta en la nube, por lo que Ollama no sube a una API en la nube las imágenes que envías. Otro software del equipo aún puede enviar datos a otro sitio, y las obligaciones de protección de datos de tu flujo de trabajo siguen aplicándose; esto no es asesoramiento legal. Consulta la guía de configuración RGPD de Qwen en local para más información.
¿Puedo usarlos con fines comerciales?
Depende del tamaño y de la licencia de la ficha del modelo. Las fichas de Hugging Face indican Apache 2.0 para Qwen3-VL y para Qwen2.5-VL 7B y 32B, y licencias de Qwen para Qwen2.5-VL 3B y 72B. Lee el texto vigente de la licencia antes de un uso comercial.
¿Por qué salen caracteres ilegibles en mi resultado de OCR?
Casi siempre por un escaneo borroso o de poca resolución. Vuelve a escanear el documento a 150–300 DPI y compara. La entrada de baja calidad es la mayor causa de errores de OCR en cualquier modelo de visión local.