Key Takeaways
- O Galaxy AI é uma plataforma híbrida: Bloqueio de Chamadas, Now Nudge, Now Brief e Detecção de Fraude rodam 100% no dispositivo via Personal Data Engine (PDE). A geração de imagens do Creative Studio e a integração com o Gemini exigem servidores em nuvem.
- O Galaxy S26 divide o hardware por região: o Exynos 2600 (Europa/Coreia/Índia) é +113% mais rápido em IA que o Exynos 2500, enquanto o Snapdragon 8 Elite Gen 5 (EUA/China/Japão) oferece +39% de NPU em relação ao S25. O Exynos 2600 é o melhor chip para inferência de LLM local.
- Toggle de privacidade: ative "Processar dados apenas no dispositivo" em Configurações > Galaxy AI para evitar o fallback para a nuvem. O Knox Vault (enclave de segurança em hardware) protege dados sensíveis; o Knox Matrix sincroniza configurações entre dispositivos.
- Geração de imagens no dispositivo: a Samsung fez parceria com a Nota AI no EdgeFusion, que gera imagens de 512×512 em menos de um segundo no NPU do Exynos 2600 usando otimização de Stable Diffusion baseada em LCM. O Creative Studio (o app voltado ao usuário) exige rede + conta Samsung.
- Executando seus próprios LLMs: a memória LPDDR5X (85,6 GB/s) limita o throughput de decodificação. Um modelo 7B quantizado em Q4 (4-bit, ~3,5 GB) atinge um máximo teórico de ~24 tokens/seg. Use o MLC Chat ou o Ollama para Android para testar.
- Memória Snapdragon: as variantes S26 e S26 Ultra nos EUA/China/Japão usam o Snapdragon 8 Elite Gen 5 (84,8 GB/s LPDDR5X), ligeiramente mais lento para inferência de LLM do que o Exynos 2600 devido ao desempenho do NPU, não da memória.
O Que É o Galaxy AI no Galaxy S26?
O Galaxy AI é a plataforma de inteligência no dispositivo da Samsung, construída sobre a própria família de LLM da Samsung, o Gauss, mais a integração com o Gemini. Lançado com o Galaxy S24, refinado no S25 e expandido no S26 (lançamento em 25 de fevereiro de 2026), ele equilibra o processamento local para privacidade com recursos em nuvem para mais poder.
O Personal Data Engine (PDE) é o núcleo: ele aprende a partir dos seus dados no dispositivo — mensagens, calendário, fotos, histórico de localização — sem enviar nada para os servidores da Samsung, a menos que você opte explicitamente por recursos em nuvem. O Knox Vault, um enclave de segurança em hardware, isola dados sensíveis (credenciais, registros de saúde, informações de pagamento) até mesmo do próprio software da Samsung.
Os recursos do Galaxy AI se dividem em três categorias: puramente no dispositivo (Bloqueio de Chamadas), híbridos com padrão local-first (Now Nudge, Now Brief, Detecção de Fraude), e dependentes de nuvem (Creative Studio, agentes Gemini, Circle to Search).
O controle do usuário é central: um único toggle nas configurações do Galaxy AI — "Processar dados apenas no dispositivo" — bloqueia todo fallback para a nuvem em recursos compatíveis. Isso não é uma ideia de privacidade tardia; é o comportamento padrão, a menos que você peça mais poder.
O Galaxy AI executa recursos no dispositivo via Personal Data Engine (PDE) e recursos em nuvem sob demanda, com um único toggle para forçar o processamento apenas no dispositivo.
Knox Vault = trava de hardware para segredos; PDE = aprende com seu telefone sem enviar dados; toggle = sua escolha se os recursos em nuvem estão ativados.
No Dispositivo vs. Nuvem: Quais Recursos Ficam Locais?
Recurso | Processamento | Envia Dados do Usuário? | Exige Rede? |
|---|---|---|---|
| Bloqueio de Chamadas | No dispositivo (NPU) | Não — áudio da chamada transcrito localmente | Não |
| Now Nudge | No dispositivo (PDE) | Não — lê tela + calendário localmente | Não |
| Now Brief | No dispositivo (PDE) | Não — resume reservas + eventos locais | Não |
| Detecção de Fraude | No dispositivo (NPU + modelo Gemini) | Não — áudio da chamada e intenção sinalizados localmente | Não |
| Creative Studio (geração de imagens) | Nuvem (servidores Samsung) | Sim — prompt de texto + imagens de referência | Sim — exige conta + internet |
| Agentes Gemini (tarefas de múltiplas etapas) | Nuvem (Google Gemini) | Sim — intenção da tarefa para servidores do Google | Sim |
| Circle to Search | Nuvem (Google) | Sim — área da captura de tela para o Google | Sim |
| Photo Assist (edições complexas) | Híbrido (segmentação local, geração em nuvem) | Parcial — imagem enviada para modelos generativos | Sim, para remoção de objetos / troca de fundo |
Geração de Imagens no Dispositivo no S26
A Samsung fez parceria com a Nota AI (Coreia do Sul) para otimizar o Stable Diffusion para inferência em NPU móvel. O resultado: geração de texto para imagem em menos de um segundo, produzindo imagens fotorrealistas de 512×512 pixels inteiramente no dispositivo, sem necessidade de rede.
A técnica é chamada de EdgeFusion (da pesquisa da Nota AI): ela usa um agendador Latent Consistency Model (LCM) com remoção de ruído em 2 etapas em vez das 50 etapas padrão, reduzindo a computação em ~96%. O tiling em nível de modelo reduz a latência de atenção cruzada em ~73%. A quantização de precisão mista (W8A16 na U-Net) mantém a qualidade intacta enquanto reduz o uso de VRAM pela metade.
Desempenho: validado no NPU do Exynos 2600, onde gera imagens de 512×512 em menos de 1 segundo. O Exynos 2600 é 2,4x mais rápido em Stable Diffusion do que o Exynos 2500, então isso é realista. As variantes com Snapdragon 8 Elite Gen 5 nos EUA/China/Japão provavelmente alcançarão tempos semelhantes ou ligeiramente maiores devido ao desempenho inferior do NPU.
Checagem de realidade: o app que a Samsung realmente distribui, o Creative Studio, exige rede + login com conta Samsung. Não está claro se o EdgeFusion foi lançado como recurso voltado ao usuário no lançamento ou se ele viabiliza uma atualização futura. A Samsung nunca mencionou "EdgeFusion" pelo nome nos materiais oficiais do Unpacked; o recurso vem da parceria de pesquisa com a Nota AI. Use essa informação para gerenciar expectativas: a geração de imagens no dispositivo está chegando, mas pode não ser lançada completa no primeiro dia.
O EdgeFusion gera imagens de 512×512 em menos de 1 segundo no dispositivo, reduzindo o Stable Diffusion de 50 etapas de remoção de ruído para apenas 2, usando pesos quantizados e tiling em nível de modelo.
Menos etapas de remoção de ruído = menos computação = inferência mais rápida. A quantização reduz o modelo. O tiling divide as camadas de atenção para caber na VRAM do celular. Juntos: imagens instantâneas offline.
- Agendador LCM: remoção de ruído em 2 etapas substitui a difusão padrão de 50 etapas, 96% menos etapas de computação
- Tiling em nível de modelo: reduz o acesso à memória de atenção cruzada, ~73% de melhora na latência
- Quantização W8A16: pesos de 8 bits, ativações de 16 bits, sem perda perceptível de qualidade
- Resolução alvo: 512×512 pixels, saída fotorrealista
- Otimizado para NPU: os núcleos tensoriais do Exynos 2600 processam a maior parte da computação; sobrecarga mínima de CPU
- Capaz de funcionar offline: dependência de rede zero se o EdgeFusion estiver ativo
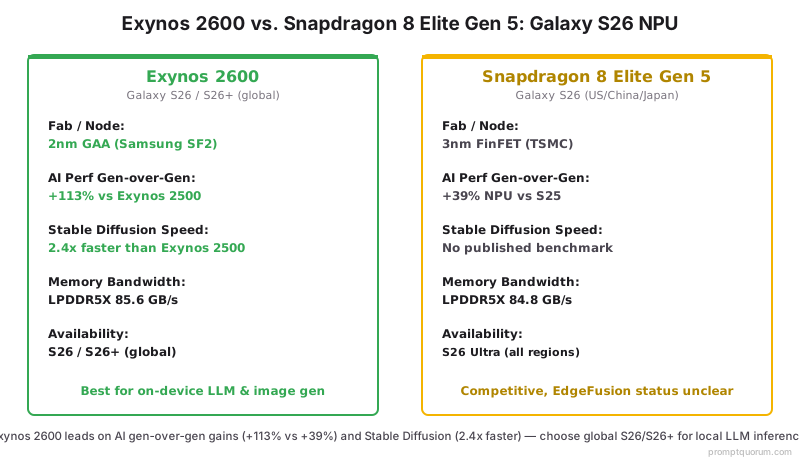
Exynos 2600 vs. Snapdragon 8 Elite Gen 5 NPU
Métrica | Exynos 2600 | Snapdragon 8 Elite Gen 5 | Vencedor para IA Local? |
|---|---|---|---|
| Node / Fábrica | 2nm GAA (Samsung SF2) | 3nm FinFET (TSMC) | Exynos (menor, mais eficiente) |
| Desempenho de IA geração a geração | +113% vs Exynos 2500 | +39% de NPU vs S25 | Exynos (salto 3x maior) |
| Velocidade do Stable Diffusion | 2,4x mais rápido que o Exynos 2500 | Sem benchmark de Stable Diffusion publicado | Exynos (verificado; Snapdragon pendente) |
| Regiões/variantes disponíveis | S26 (global), S26+ (global) | S26 (EUA/China/Japão), S26 Ultra (todas as regiões) | Exynos (disponibilidade global) |
| Banda de memória | LPDDR5X 85,6 GB/s (típico) | LPDDR5X 84,8 GB/s (típico) | Exynos (marginalmente superior) |
| Veredito | Melhor para LLM e geração de imagens no dispositivo | Competitivo; disponibilidade do EdgeFusion não é clara | Exynos (escolha S26/S26+ em vez do S26 Ultra) |
Executando Seu Próprio LLM no Galaxy S26
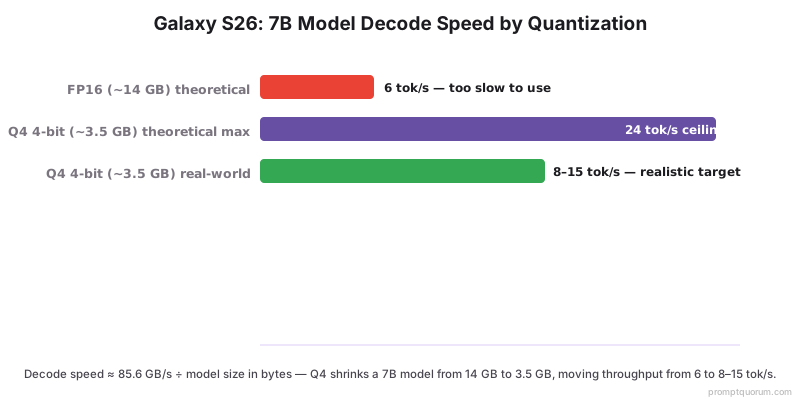
A banda de memória do Galaxy S26 é o fator limitante. LPDDR5X a 85,6 GB/s significa que a geração de tokens (a "fase de decodificação" da inferência de LLM) tem um teto de aproximadamente banda_de_memória / tamanho_do_modelo_em_bytes tokens por segundo.
Matemática: um modelo de 7B parâmetros em FP16 (floats de 16 bits) pesa ~14 GB. A 85,6 GB/s ÷ 14 GB ≈ 6 tokens/seg como máximo teórico. Mas a quantização muda isso drasticamente.
Quantizado em Q4 (4-bit, armazenando 2 parâmetros por byte), o mesmo modelo 7B reduz para ~3,5 GB. O throughput escala: 85,6 GB/s ÷ 3,5 GB ≈ 24 tokens/seg como máximo teórico. No mundo real é menor devido à sobrecarga computacional, mas as metas realistas são de 8-15 tokens/seg no Galaxy S26 para um modelo 7B quantizado.
Melhores ferramentas: o MLC Chat (multiplataforma, modelos da comunidade) e o Ollama para Android (se disponível na data do seu lançamento). Ambos suportam modelos quantizados. Comece com um modelo 7B (Mistral 7B, Llama 2 7B, Phi 2.7B) em quantização Q4 ou Q5.
- Use quantização Q4 (4-bit) para modelos 7B; Q3 (3-bit) comporta modelos maiores, mas perde qualidade
- Evite modelos de precisão total FP16; eles são grandes demais para um throughput prático
- Melhores modelos open-weight para celular: Mistral 7B, Phi 2.7B, TinyLlama 1.1B
- Velocidade esperada: 8-15 tokens/seg para 7B Q4; 3-5 tokens/seg para 7B não quantizado
- Use o MLC Chat ou o Ollama; ambos se otimizam automaticamente para Exynos/Snapdragon
- Teste offline: se o Ollama fizer cache do modelo, a inferência funciona totalmente sem internet
Privacidade no Galaxy S26: O Que Sai do Seu Dispositivo?
O Knox Vault é o módulo de segurança em hardware da Samsung: um processador separado, isolado da CPU principal e do sistema operacional Android. Dados sensíveis — métodos de pagamento, impressões digitais, registros de saúde, senhas — ficam no Knox Vault e nunca são expostos a apps ou aos servidores da Samsung sem ação explícita do usuário.
O Personal Data Engine (PDE) aprende localmente: modelos de machine learning no dispositivo treinam com seus padrões de uso, calendário, mensagens, fotos e contatos. Por padrão, esses dados nunca tocam a nuvem da Samsung. Você controla esse limite com o toggle "Processar dados apenas no dispositivo" nas configurações do Galaxy AI.
Recursos em nuvem são opt-in: Creative Studio, agentes Gemini e Circle to Search exigem sua permissão e enviam dados para os servidores da Samsung e do Google, respectivamente. Cada recurso tem sua própria política de privacidade. Desativar esses recursos impede qualquer transmissão para a nuvem.
Privacidade entre dispositivos: o Knox Matrix sincroniza configurações de segurança e dados criptografados entre seus dispositivos Galaxy usando criptografia de ponta a ponta. A Samsung atua como retransmissora, não como camada de descriptografia.
Suposição padrão: se você não ativou explicitamente um recurso em nuvem, seus dados permanecem locais. Isso é o oposto da Apple Intelligence (nuvem PCC sempre ativa para recursos avançados) e o oposto do Google Gemini (integração em nuvem mais estreita por padrão).
- Knox Vault = enclave isolado por hardware para segredos; processador separado, SO separado, nunca sincronizado com a nuvem
- PDE = mecanismo de aprendizado local; treina com seus dados sem fazer upload
- Toggle "Processar dados apenas no dispositivo" = bloqueia todo fallback para a nuvem em recursos compatíveis
- Creative Studio = depende da nuvem; desativá-lo impede a transmissão de dados de geração de imagens
- Agentes Gemini = movidos pelo Google; usam sua conta Google para tarefas de múltiplas etapas
- Knox Matrix = sincronização entre dispositivos com criptografia de ponta a ponta; a Samsung vê blobs criptografados, não texto simples
Perguntas Frequentes
O Galaxy AI é totalmente no dispositivo ou usa a nuvem?
Híbrido. Bloqueio de Chamadas, Now Nudge, Now Brief e Detecção de Fraude rodam inteiramente no dispositivo usando o Personal Data Engine. A geração de imagens (Creative Studio), agentes Gemini e Circle to Search exigem servidores em nuvem. Ative "Processar dados apenas no dispositivo" nas configurações para forçar o processamento exclusivamente local em recursos compatíveis.
Qual é a diferença entre o Exynos 2600 e o Snapdragon 8 Elite Gen 5?
O Exynos 2600 (2nm, Samsung Foundry) é +113% mais rápido em IA do que o Exynos 2500 da geração anterior. O Snapdragon 8 Elite Gen 5 (3nm, TSMC) é +39% mais rápido em NPU do que o Snapdragon 8 Gen 1 (S25). O Exynos 2600 é o vencedor claro para inferência de LLM no dispositivo; ele é 2,4x mais rápido em Stable Diffusion.
Posso rodar um modelo de linguagem grande no Galaxy S26?
Sim, mas com limites. A banda LPDDR5X (85,6 GB/s) limita o throughput de decodificação. Um modelo 7B quantizado em Q4 atinge ~24 tokens/seg como máximo teórico (~8-15 realistas). Use o MLC Chat ou o Ollama para Android. Modelos maiores (13B, 70B) são impraticáveis devido às restrições de memória e banda.
O Galaxy AI funciona offline?
Parcialmente. Bloqueio de Chamadas, Now Nudge, Now Brief, Detecção de Fraude e LLMs no dispositivo (se rodando via Ollama) funcionam totalmente offline. Creative Studio, agentes Gemini e Circle to Search exigem internet. Ative "Processar dados apenas no dispositivo" para garantir que os recursos compatíveis não tentem fallback para a nuvem.
O que é o EdgeFusion e ele está disponível no Galaxy S26?
O EdgeFusion é o Stable Diffusion otimizado da Nota AI para NPUs móveis, gerando imagens de 512×512 em menos de 1 segundo no Exynos 2600. A Samsung fez parceria oficial com a Nota AI, mas "EdgeFusion" nunca foi mencionado pelo nome nos materiais oficiais do Galaxy Unpacked. O Creative Studio (o app de geração de imagens efetivamente distribuído) exige rede + conta Samsung, então o status exato do EdgeFusion no lançamento não é claro.
Quais dados a Samsung coleta via Galaxy AI?
Por padrão, nenhum. O Personal Data Engine permanece local. Quando você ativa recursos em nuvem — Creative Studio, agentes Gemini — os dados são enviados para a Samsung (no caso do Galaxy AI) ou para o Google (no caso do Gemini). Desative esses recursos para impedir a transmissão. Confira Configurações > Privacidade > Galaxy AI para ver o que está ativado.
O Knox Vault protege meus dados até mesmo da Samsung?
Sim. O Knox Vault é um processador de hardware separado, isolado do sistema operacional principal. Dados sensíveis (biometria, informações de pagamento, saúde) armazenados no Knox Vault não podem ser acessados por apps Android ou pelo software da Samsung sem um desbloqueio explícito. Nem mesmo engenheiros da Samsung conseguem extrair dados do Knox Vault sem acesso físico ao dispositivo e escalonamento de privilégios.
Posso desativar totalmente os recursos em nuvem do Galaxy AI?
Sim. Desative recursos individuais em Configurações > Galaxy AI. Você pode alternar Creative Studio, agentes Gemini e Circle to Search de forma independente. Ative "Processar dados apenas no dispositivo" para bloquear o fallback para a nuvem em recursos compatíveis. Os recursos no dispositivo (Bloqueio de Chamadas, Now Nudge) continuam funcionando.
O Galaxy S26 é melhor que o iPhone para rodar IA local?
Para rodar seus próprios LLMs quantizados, sim. O Exynos 2600 é mais rápido em Stable Diffusion do que o NPU A18 Pro da Apple, e o Android suporta mais ferramentas de modelos open-weight (Ollama, MLC Chat). Mas a filosofia on-device-first da Apple e o PCC criptograficamente auditável tornam-na mais forte em privacidade se você confia mais na infraestrutura da Apple do que na da Samsung.
Com que frequência os recursos do Galaxy AI serão atualizados?
Os recursos do Galaxy AI são lançados via atualizações do One UI (geralmente patches de segurança mensais + atualizações de recursos trimestrais). A Samsung se comprometeu com 7 anos de atualizações de SO e 7 anos de patches de segurança para o Galaxy S26, então espere novos recursos do Galaxy AI e melhorias de desempenho até 2033.