关键要点
- Galaxy AI是混合平台:通话过滤、Now Nudge、Now Brief和欺诈检测都通过Personal Data Engine(PDE)100%在本地设备上运行。Creative Studio图像生成和Gemini集成需要云服务器。
- Galaxy S26按地区划分硬件:Exynos 2600(欧洲/韩国/印度)的AI性能比Exynos 2500快+113%,而Snapdragon 8 Elite Gen 5(美国/中国/日本)比S25提升+39%的NPU性能。Exynos 2600是本地LLM推理更好的芯片。
- 隐私开关:在设置 > Galaxy AI中启用"仅在设备上处理数据"以阻止云端回退。Knox Vault硬件安全隔离区保护敏感数据;Knox Matrix在设备间同步设置。
- 本地设备图像生成:三星与Nota AI合作推出EdgeFusion,使用基于LCM的Stable Diffusion优化,在Exynos 2600 NPU上不到一秒即可生成512×512图像。Creative Studio(面向用户的应用)需要网络和三星账户。
- 运行你自己的LLM:LPDDR5X内存(85.6 GB/s)限制了解码吞吐量。经Q4(4位)量化的7B模型(约3.5 GB)理论最大速度约为24 tokens/秒。使用MLC Chat或Ollama for Android进行测试。
- Snapdragon内存:美国/中国/日本的S26和S26 Ultra机型使用Snapdragon 8 Elite Gen 5(84.8 GB/s LPDDR5X),由于NPU性能较低(而非内存),LLM推理略慢于Exynos 2600。
Galaxy S26上的Galaxy AI是什么?
Galaxy AI是三星的本地设备智能平台,构建于三星自研的Gauss大语言模型系列以及Gemini集成之上。该平台随Galaxy S24推出,在S25上得到改进,并在S26(2026年2月25日发布)上进一步扩展,在隐私本地处理与云端功能强大性之间取得平衡。
Personal Data Engine(PDE)是核心:它从你设备上的数据——短信、日历、照片、位置历史——中学习,除非你明确选择使用云端功能,否则不会向三星服务器发送任何内容。Knox Vault是一个硬件安全隔离区,即使对三星自己的软件,也会隔离敏感数据(凭证、健康记录、支付信息)。
Galaxy AI功能分为三类:纯本地设备(通话过滤)、默认本地优先的混合模式(Now Nudge、Now Brief、欺诈检测),以及依赖云端(Creative Studio、Gemini智能体、Circle to Search)。
用户控制是核心:Galaxy AI设置中的单个开关——"仅在设备上处理数据"——会阻止兼容功能的所有云端回退。这不是事后添加的隐私功能;除非你需要更强大的功能,否则这就是默认行为。
📍 简单一句话
Galaxy AI通过Personal Data Engine(PDE)运行本地设备功能,并按需运行云端功能,一个开关即可强制仅设备处理。
💬 简单来说
Knox Vault = 保护机密信息的硬件锁;PDE = 从你的手机学习而不上传数据;开关 = 你选择是否开启云端功能。
本地设备 vs 云端:哪些功能保留在本地?
功能 | 处理方式 | 是否发送用户数据? | 是否需要网络? |
|---|---|---|---|
| 通话过滤 | 本地设备(NPU) | 否——来电音频在本地转录 | 否 |
| Now Nudge | 本地设备(PDE) | 否——在本地读取屏幕和日历 | 否 |
| Now Brief | 本地设备(PDE) | 否——摘要本地预订和事件 | 否 |
| 欺诈检测 | 本地设备(NPU + Gemini模型) | 否——通话音频和意图在本地标记 | 否 |
| Creative Studio(图像生成) | 云端(三星服务器) | 是——文本提示词+参考图像 | 是——需要账户+互联网 |
| Gemini智能体(多步骤任务) | 云端(Google Gemini) | 是——任务意图发送至Google服务器 | 是 |
| Circle to Search | 云端(Google) | 是——截屏区域发送至Google | 是 |
| Photo Assist(复杂编辑) | 混合(本地分割,云端生成) | 部分——图像发送用于生成模型 | 删除对象/更换背景需要 |
S26上的本地设备图像生成
三星与Nota AI(韩国)合作,为移动NPU推理优化了Stable Diffusion。结果是:文本生成图像不到一秒即可完成,完全在本地设备上生成512×512像素的照片级真实图像,无需网络。
这项技术被称为EdgeFusion(来自Nota AI的研究):它使用Latent Consistency Model(LCM)调度器,以2步去噪代替标准的50步,将计算量减少约96%。模型级平铺(tiling)将交叉注意力延迟降低约73%。混合精度量化(U-Net中的W8A16)在保持质量的同时将VRAM占用减半。
性能:已在Exynos 2600 NPU上验证,可在1秒内生成512×512图像。Exynos 2600在Stable Diffusion上比Exynos 2500快2.4倍,因此这个数据是可信的。美国/中国/日本版本的Snapdragon 8 Elite Gen 5由于NPU性能较低,可能实现相近或略长的用时。
现实检验:三星实际发布的应用Creative Studio需要网络和三星账户登录。目前尚不清楚EdgeFusion是作为面向用户的功能在发布时上线,还是将支持未来的更新。三星在官方Galaxy Unpacked资料中从未提及"EdgeFusion"这一名称;该功能源自与Nota AI的研究合作。请据此管理预期:本地设备图像生成正在到来,但可能不会在首日以完整形态上线。
📍 简单一句话
EdgeFusion通过将Stable Diffusion的去噪步骤从50步减少到仅2步,并使用量化权重和模型级平铺,实现在设备上1秒内生成512×512图像。
💬 简单来说
更少的去噪步骤=更少的计算=更快的推理。量化压缩模型体积。平铺将注意力层拆分以适配手机VRAM。三者结合:离线也能瞬间出图。
- LCM调度器:2步去噪取代标准的50步扩散,计算步骤减少96%
- 模型级平铺:减少交叉注意力的内存访问,延迟改善约73%
- W8A16量化:8位权重,16位激活,无可感知的质量损失
- 目标分辨率:512×512像素,照片级真实输出
- NPU优化:Exynos 2600的张量核心处理大部分计算,CPU开销极小
- 支持离线:EdgeFusion激活时零网络依赖
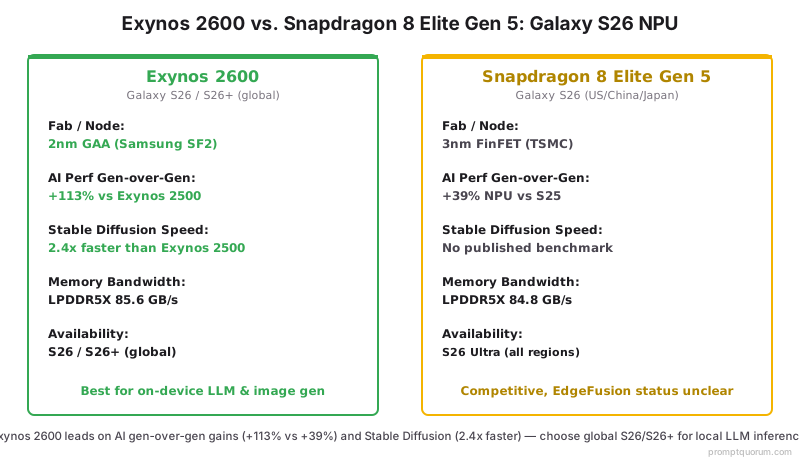
Exynos 2600 vs Snapdragon 8 Elite Gen 5 NPU对比
指标 | Exynos 2600 | Snapdragon 8 Elite Gen 5 | 本地AI的赢家? |
|---|---|---|---|
| 制程/代工厂 | 2nm GAA(三星SF2) | 3nm FinFET(台积电) | Exynos(更小、更高效) |
| 代际AI性能提升 | 比Exynos 2500快+113% | 比S25的NPU快+39% | Exynos(提升幅度大3倍) |
| Stable Diffusion速度 | 比Exynos 2500快2.4倍 | 未公布Stable Diffusion基准 | Exynos(已验证;Snapdragon待定) |
| 可用地区/机型 | S26(全球)、S26+(全球) | S26(美国/中国/日本)、S26 Ultra(全地区) | Exynos(全球可用) |
| 内存带宽 | LPDDR5X 85.6 GB/s(典型值) | LPDDR5X 84.8 GB/s(典型值) | Exynos(略高) |
| 结论 | 最适合本地设备LLM和图像生成 | 具有竞争力;EdgeFusion是否可用尚不明确 | Exynos(选择S26/S26+而非S26 Ultra) |
在Galaxy S26上运行你自己的LLM
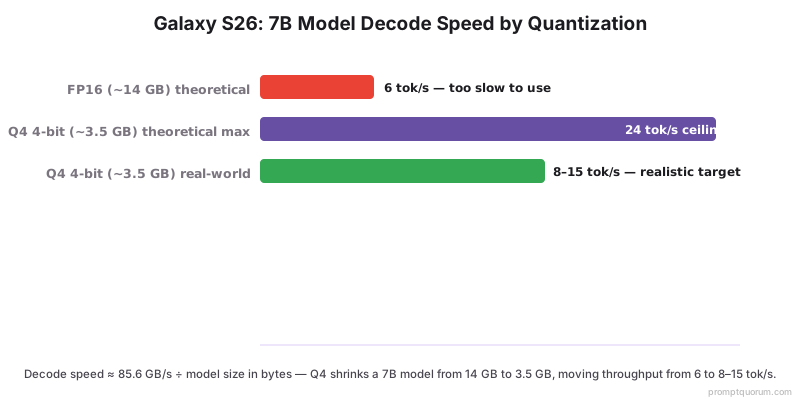
Galaxy S26的内存带宽是限制因素。LPDDR5X为85.6 GB/s,意味着token生成(LLM推理的"解码阶段")的速度大致以内存带宽÷模型字节大小(tokens/秒)为上限。
计算方式:一个7B参数模型在FP16(16位浮点数)下约为14 GB。85.6 GB/s ÷ 14 GB ≈ 理论最大值6 tokens/秒。但量化会极大改变这一情况。
经Q4(4位,每字节存储2个参数)量化后,同一个7B模型缩小到约3.5 GB。吞吐量随之提升:85.6 GB/s ÷ 3.5 GB ≈ 理论最大值24 tokens/秒。由于计算开销,实际数值会更低,但在Galaxy S26上,量化后的7B模型的现实目标是8-15 tokens/秒。
最佳工具:MLC Chat(跨平台,社区模型)和Ollama for Android(如果在你的发布日期可用)。两者都支持量化模型。建议从7B模型(Mistral 7B、Llama 2 7B、Phi 2.7B)以Q4或Q5量化开始。
- 7B模型使用Q4(4位)量化;Q3(3位)可容纳更大模型但会损失质量
- 避免使用FP16全精度模型;对实际吞吐量而言体积过大
- 移动端最佳开源模型:Mistral 7B、Phi 2.7B、TinyLlama 1.1B
- 预期速度:7B Q4约为8-15 tokens/秒;未量化7B约为3-5 tokens/秒
- 使用MLC Chat或Ollama;两者都会针对Exynos/Snapdragon自动优化
- 离线测试:如果Ollama缓存了模型,推理可以完全在无网络的情况下运行
Galaxy S26隐私:哪些数据会离开你的设备?
Knox Vault是三星的硬件安全模块:一个与主CPU和Android系统隔离的独立处理器。支付方式、指纹、健康记录、密码等敏感数据存储在Knox Vault中,未经用户明确操作,绝不会暴露给应用或三星的服务器。
Personal Data Engine(PDE)在本地学习:本地设备上的机器学习模型会基于你的使用模式、日历、消息、照片和联系人进行训练。默认情况下,这些数据永远不会接触三星的云端。你可以通过Galaxy AI设置中的"仅在设备上处理数据"开关来控制这一边界。
云端功能是可选启用的:Creative Studio、Gemini智能体和Circle to Search需要你的授权,并分别向三星和Google服务器发送数据。每项功能都有各自的隐私政策。禁用这些功能可阻止任何云端传输。
跨设备隐私:Knox Matrix使用端到端加密在你的Galaxy设备之间同步安全设置和加密数据。三星充当中继,而非解密层。
默认假设:如果你没有明确启用某项云端功能,你的数据将保留在本地。这与Apple Intelligence(高级功能始终依赖云端PCC)相反,也与Google Gemini(默认更紧密的云端集成)相反。
- Knox Vault = 用于机密信息的硬件隔离区;独立处理器、独立系统,从不同步到云端
- PDE = 本地学习引擎;基于你的数据进行训练而不上传
- "仅在设备上处理数据"开关 = 阻止兼容功能的所有云端回退
- Creative Studio = 依赖云端;禁用它可阻止图像生成数据的传输
- Gemini智能体 = 由Google驱动;使用你的Google账户执行多步骤任务
- Knox Matrix = 使用端到端加密的跨设备同步;三星只能看到加密数据块,而非明文
常见问题
Galaxy AI是完全本地的还是使用云端?
混合模式。通话过滤、Now Nudge、Now Brief和欺诈检测完全使用Personal Data Engine在本地设备上运行。图像生成(Creative Studio)、Gemini智能体和Circle to Search需要云服务器。在设置中启用"仅在设备上处理数据",可对支持的功能强制仅本地处理。
Exynos 2600和Snapdragon 8 Elite Gen 5有什么区别?
Exynos 2600(2nm,三星代工)的AI性能比上一代Exynos 2500快+113%。Snapdragon 8 Elite Gen 5(3nm,台积电)的NPU性能比Snapdragon 8 Gen 1(S25)快+39%。对于本地设备LLM推理,Exynos 2600明显更胜一筹,在Stable Diffusion上快2.4倍。
我能在Galaxy S26上运行大语言模型吗?
可以,但有限制。LPDDR5X带宽(85.6 GB/s)限制了解码吞吐量。经Q4量化的7B模型理论最大速度约为24 tokens/秒(实际约8-15 tokens/秒)。使用MLC Chat或Ollama for Android。更大的模型(13B、70B)由于内存和带宽限制并不实用。
Galaxy AI能离线使用吗?
部分可以。通话过滤、Now Nudge、Now Brief、欺诈检测以及本地设备LLM(如果通过Ollama运行)可完全离线工作。Creative Studio、Gemini智能体和Circle to Search需要联网。启用"仅在设备上处理数据"可确保支持的功能不会尝试云端回退。
什么是EdgeFusion,Galaxy S26上有吗?
EdgeFusion是Nota AI针对移动NPU优化的Stable Diffusion,可在Exynos 2600上不到1秒生成512×512图像。三星官方与Nota AI合作,但官方Galaxy Unpacked资料中从未提及"EdgeFusion"这个名称。实际发布的图像生成应用Creative Studio需要网络和三星账户,因此EdgeFusion在发布时的确切状态尚不清楚。
三星通过Galaxy AI收集了哪些数据?
默认情况下不收集任何数据。Personal Data Engine保持本地运行。当你启用云端功能——Creative Studio、Gemini智能体——数据会被发送至三星(用于Galaxy AI)或Google(用于Gemini)。禁用这些功能可防止数据传输。前往设置 > 隐私 > Galaxy AI查看已启用功能的明细。
Knox Vault能保护我的数据不被三星获取吗?
可以。Knox Vault是与主系统隔离的独立硬件处理器。存储在Knox Vault中的敏感数据(生物识别、支付信息、健康信息)在没有明确解锁的情况下,无法被Android应用或三星软件访问。即使是三星的工程师,若没有物理设备访问权限和权限提升,也无法提取Knox Vault的数据。
我能完全禁用Galaxy AI的云端功能吗?
可以。在设置 > Galaxy AI中禁用单个功能。你可以独立开关Creative Studio、Gemini智能体和Circle to Search。启用"仅在设备上处理数据"可阻止支持功能的云端回退。本地设备功能(通话过滤、Now Nudge)会继续正常工作。
在运行本地AI方面,Galaxy S26比iPhone更好吗?
如果是运行你自己的量化LLM,答案是肯定的。Exynos 2600在Stable Diffusion上比苹果的A18 Pro NPU更快,且Android支持更多开源模型工具(Ollama、MLC Chat)。但如果你更信任苹果的基础设施而非三星,苹果的本地优先理念和可加密审计的PCC在隐私方面更具优势。
Galaxy AI功能多久更新一次?
Galaxy AI功能通过One UI更新推出(通常为月度安全补丁+季度功能更新)。三星承诺为Galaxy S26提供7年操作系统更新和7年安全补丁,因此预计到2033年都会有新的Galaxy AI功能和性能改进。