快速开始:3分钟运行您的第一个本地LLM
1. 安装Ollama (1分钟)
从ollama.com下载并运行安装程序。无需配置。
2. 运行Llama 3.2 3B (2分钟)
打开终端并运行:`ollama run llama3.2:3b`
Ollama会在首次运行时下载模型(约2 GB)。这是大多数用户推荐的首个模型。
3. 开始聊天 (立即)
模型加载后,输入您的问题或提示并按Enter。您会看到在典型笔记本上以25–45词/秒的速度生成的回答。
就是这样。 无需手动配置,无需GPU。如果您有8GB以上内存,您已准备好。如果您有4–6GB,请使用`ollama run gemma4:e2b`(更快,使用1.7GB内存)。
入门级检查清单:本地是否适合您?
下载第一个模型前,请回答这三个问题:
1. 您有8GB或更多RAM吗? (如否,云API更快开始。)
2. 您需要数据保持隐私吗? (如否,云API提供更好质量。)
3. 您能接受20~40分钟的设置吗? (如否,云API在5分钟内准备就绪。)
如果您有两个或更多问题回答"否",阅读完整的本地vs云比较 ——查看云API是否更适合您的硬件和时间表。初学者经常假设本地LLM总是更好——这不是真的。正确的选择取决于您的具体约束条件。
如何选择入门级本地LLM模型?
本地LLM的模型选择取决于三个约束条件:可用内存、推理速度和任务类型——按此优先顺序排列。
参数量(3B、7B、13B)是内存需求的主要决定因素。在4位量化——大多数本地推理工具的默认设置——下,将参数量乘以约0.5即可估算所需GB内存。Q4_K_M量化下的7B模型大约需要4.5 GB内存。
对于大多数初学者,Q4_K_M量化的7B模型在8 GB或更多内存的机器上提供最佳质量、速度和内存使用平衡。在4–6 GB内存的机器上,3B模型是实际上限。

#1 Meta Llama 3.2 3B — 综合最佳入门模型
Meta Llama 3.2 3B是大多数用户的最佳起点。 下载时间不到5分钟,可在任何配备4 GB内存的机器上运行,且指令遵循能力明显优于以前的3B模型。它使用128K上下文窗口——远大于同等规模的模型。
Llama 3.2 3B在8核笔记本电脑CPU上大约为25–45词/秒,在M3 Pro等Apple Silicon上更高(粗略估计;PromptQuorum未在此实测,速度因硬件和设置而异)。质量适合摘要、问答和简单编程任务,但在多步推理方面不及7B模型。
规格 | 值 |
|---|---|
| 参数量 | 3B |
| 所需内存 | ~2.5 GB(Q4_K_M) |
| 下载大小 | ~2 GB |
| 上下文窗口 | 128K词元 |
| CPU速度(8核笔记本) | 25–45词/秒 |
| Ollama命令 | ollama run llama3.2:3b |
#2 Microsoft Phi-4 Mini 3.8B — 低内存最佳选择
Phi-4 Mini是微软专为小规模推理和编程任务优化的紧凑型模型。 它达到68% MMLU和70% HumanEval——得益于专注于问题解决的高质量合成数据训练,这些分数超过了2024年的许多7B模型。
对于内存为4–6 GB且质量要求较高的机器,这是推荐的首选模型。Phi-4 Mini使用2.5 GB内存(低于Phi-3.5 Mini的3 GB),使其在4 GB机器上更易访问。
规格 | 值 |
|---|---|
| 参数量 | 3.8B |
| 所需内存 | ~2.5 GB(Q4_K_M) |
| 下载大小 | ~2.3 GB |
| MMLU分数 | 68% |
| 上下文窗口 | 128K词元 |
| CPU速度(8核笔记本) | 30–50词/秒 |
| Ollama命令 | ollama run phi4-mini |
#3 Google Gemma 4 E2B — 速度较快的2B模型之一
Gemma 4 E2B是谷歌更新的2B模型,是仅CPU推理中较快的选择之一。 它在中端笔记本电脑CPU上约生成40–60词/秒(粗略估计,并非PromptQuorum实测,因硬件而异)。Gemma 4 E2B相比早期Gemma系列有重大改进:上下文窗口从Gemma 2的8K扩展到128K词元,消除了文档任务的主要限制。
当响应速度最重要时、在内存≤4 GB的机器上,或作为验证本地LLM设置再下载更大模型前的测试模型时,Gemma 4 E2B是理想选择。
规格 | 值 |
|---|---|
| 参数量 | 2B |
| 所需内存 | ~1.7 GB(Q4_K_M) |
| 下载大小 | ~1.6 GB |
| 上下文窗口 | 128K词元 |
| CPU速度(8核笔记本) | 40–60词/秒 |
| Ollama命令 | ollama run gemma4:e2b |
#4 Meta Llama 3.1 8B — 最佳7B/8B全能模型
Meta Llama 3.1 8B是当前该规格下的通用全能模型,HumanEval得分72%,英语推理能力扎实。 它取代Mistral 7B成为本列表7B/8B推荐——Mistral 7B曾是2023–2024年的社区标准,但如今在同等内存需求下,较新的模型在公开基准上通常得分更高,更适合作为旧版可选项(详见下方"常见错误"部分说明我们为何不再默认推荐它)。
对于8 GB内存的机器,Llama 3.1 8B是从3B模型升级的自然选择。它在处理更长文本、更复杂指令和多轮对话方面比任何3B模型都更可靠,并拥有128K上下文窗口。
规格 | 值 |
|---|---|
| 参数量 | 8B |
| 所需内存 | ~5.5 GB(Q4_K_M) |
| 下载大小 | ~5 GB |
| 上下文窗口 | 128K词元 |
| HumanEval得分 | 72% |
| CPU速度(8核笔记本) | 10–18词/秒 |
| Ollama命令 | ollama run llama3.1:8b-instruct |
#5 Qwen3 8B — 多语言场景最佳选择
Qwen3 8B(82亿参数)HumanEval得分57.3%,MMLU与Llama 3.1 8B持平或更优,原生支持29种以上语言,包括中文、日语、韩语、阿拉伯语和所有主要欧洲语言。 它是非英语工作流或以编程为主用例的推荐选择,取代早期的Qwen2.5 7B成为本列表的多语言推荐。
Qwen3 8B使用32K上下文窗口(通过YaRN可扩展至131K),支持带JSON模式的结构化输出,并可选启用面向更难推理任务的"思考模式"(速度较慢,但更准确)。该模型提供instruct和base变体——用于对话时,始终使用instruct版本。详细基准数据请参见Qwen vs Llama vs Mistral基准对比。
规格 | 值 |
|---|---|
| 参数量 | 8.2B |
| 所需内存 | ~5.2 GB(Q4_K_M) |
| 下载大小 | ~5.2 GB |
| 上下文窗口 | 32K词元(通过YaRN可达131K) |
| HumanEval得分 | 57.3% |
| CPU速度(8核笔记本) | 10–18词/秒(非思考模式) |
| Ollama命令 | ollama run qwen3:8b |
哪个模型在内存、速度和上下文窗口方面胜出?
模型 | RAM | 速度(CPU) | 上下文 | 最适用途 |
|---|---|---|---|---|
| Llama 3.2 3B | 2.5 GB | 25–45词/秒 | 128K | 通用,首选模型 |
| Phi-4 Mini 3.8B | 2.5 GB | 30–50词/秒 | 128K | 推理、编程、低内存 |
| Gemma 4 E2B | 1.7 GB | 40–60词/秒 | 128K | 速度优先,极低内存 |
| Llama 3.1 8B | 5.5 GB | 10–18词/秒 | 128K | 通用全能,72% HumanEval |
| Qwen3 8B | 5.2 GB | 10–18词/秒 | 32K(YaRN可达131K) | 多语言、编程 |

从哪个模型开始?
- 2 GB内存(极低端):`ollama run llama3.2:1b` — 可用的最小选项,约1.3 GB下载。质量明显低于3B以上模型,但可在非常老旧或受限的硬件上运行。
- 4 GB内存或以下:`ollama run gemma4:e2b` — 下载最快、内存占用最低、128K上下文。基础任务质量可接受。
- 8 GB内存,首选模型:`ollama run llama3.2:3b` — 初次体验时质量与内存的最佳平衡。
- 4–6 GB内存,推理/编程:`ollama run phi4-mini` — 68% MMLU、70% HumanEval,仅需2.5 GB内存。在结构化任务上优于Llama 3.2 3B。
- 8 GB内存,严肃使用:`ollama run llama3.1:8b-instruct`或`ollama run qwen3:8b` — 适合更长文档、更复杂指令的升级选择。
- 主要编程任务:`ollama run llama3.1:8b-instruct` — 本列表中HumanEval数值最高(72%);如需专用编程模型,可试试 `ollama run qwen2.5-coder:7b`。
- 中文或非英语语言:`ollama run qwen3:8b` — 原生支持29种以上语言,无需翻译开销,中文分词效率更高。

如何根据所在地区选择模型?
中国(数据安全法与个人信息保护法):中国《数据安全法》(2021年)和《个人信息保护法》(PIPL,2021年)在特定情形下(如关键信息基础设施运营者或达到一定数量的处理者)可能要求境内存储,请结合自身情况确认。通过Ollama在本地运行推理,提示词、上下文和输出保留在本地硬件上,可简化该环节的数据本地化问题;但Ollama仍可能为下载模型和检查更新而联网(除非您将其禁用),且是否合规取决于您整体的数据处理。对于金融、医疗和法律等受监管行业,本地LLM推理可以减少向云API披露数据的情形,但并非合规保证。Qwen3 8B(阿里巴巴达摩院)是中文工作流的自然首选,具备原生中文分词支持和29种以上语言能力。
亚太地区(数据跨境合规):日本METI AI治理指南(2024年)、韩国《个人信息保护法》修正案和新加坡PDPA等相关指引通常涉及AI系统的记录与问责,记录所用模型的名称和版本是良好实践。本列表所有五款模型均有版本化的Ollama标签,便于做到这一点。对于中文优先的工作流,Qwen3 8B具备原生亚洲语言支持,是常见选择之一;在这五款入门级模型中,Qwen3 8B的原生韩语分词能力也最强。
企业部署(银行、医疗、法律):对于在本地运行LLM的中国大型企业,Qwen3 8B(阿里巴巴)采用Apache 2.0许可。Apache 2.0许可的Mistral AI模型可作为需要EU-China双合规文档场景的备选,但目前Mistral Small系列(24B以上)已超出本页4–8 GB入门内存范围。建议在所有企业部署中:对模型权重启用完整磁盘加密,并审计所有安装的推理引擎扩展。
一般信息,不构成法律建议:以上地区说明仅为一般性信息,不构成法律建议;请就您的具体情况向合格的专业人士确认相关要求。
如何下载和运行这些模型?
所有五款模型均可通过单条Ollama命令安装——无需手动配置。 安装步骤请参见如何安装Ollama,然后查看运行您的第一个本地LLM获取分步首次运行指南。如果您在内存有限的笔记本电脑上运行,如何在笔记本电脑上运行本地LLM涵盖了受限硬件的量化和性能调优。
一旦你的第一个模型运行起来,下一步就是学习如何有效地提示它。从Prompt工程基础开始——16篇指南涵盖每个提示词所需的构建块,从温度设置到输出格式化。
初学者在选择本地LLM时常犯哪些错误?
- 仅根据参数量选择模型——4位量化的7B可能优于量化不佳的13B。
- 未考虑GPU显存量化开销——模型所需显存可能比文件大小多10–15%。
- 使用较旧的量化方式(Q3_K_S)而非提供更好质量的新方式(Q4_K_M)。
- 将Mistral 7B作为默认7B模型:它曾是2023–2024年的社区标准(7B,约4.1 GB下载,`ollama run mistral`),但在相同RAM需求下,Qwen3 8B(编程)和Llama 3.1 8B(英语推理)等较新模型在公开基准上通常得分更高。如果您的工具或教程默认使用`ollama run mistral`,请切换到`ollama run qwen3:8b`或`ollama run llama3.1:8b-instruct`以获得更好结果,而无需增加内存。注意:这与当前的24B以上"Mistral Small 3.x"系列是不同、不相关的模型,后者所需内存远超本页任何一款模型。
- 未先检查可用内存就拉取模型:如果拉取的模型超出可用内存,Ollama会回退到带部分磁盘交换的慢速CPU推理——有时低于1词/秒。拉取7B以上模型前,请始终运行`free -h`(Linux/macOS)或检查任务管理器(Windows)。
常见问题
2026年初学者最佳本地LLM模型是哪款?
大多数用户推荐Llama 3.2 3B——可在任何4 GB内存的机器上运行,下载时间不到5分钟,指令遵循输出质量强。8 GB内存时,Qwen3 8B提供更好的编程和多语言性能。内存要求最低的是Gemma 4 E2B,仅需1.7 GB,CPU上运行速度40–60词/秒,或Llama 3.2 1B在2 GB内存或以下运行。
运行本地LLM的最低内存是多少?
实用输出的实际最低要求是4 GB内存配合Q4_K_M量化的3B模型。在2 GB内存或以下,Llama 3.2 1B是可用的最小选择,但质量明显下降。8 GB内存可解锁7–8B模型,在复杂任务上效果明显更好。
最好的10亿参数(1B)本地LLM是什么?
Llama 3.2 1B是推荐的1B模型——约1.3 GB下载,通过`ollama run llama3.2:1b`即可在2 GB内存或以下运行。适合基础摘要和简短问答,但在多步推理上明显弱于3B以上模型。仅在硬件确实无法支持3B模型时使用。
Mistral Small 3.2适合作为初学者本地LLM吗?
不适合——Mistral Small 3.2是一款24B参数模型,大约需要14 GB以上的内存/显存,远超本页4–8 GB的入门范围。它与本页此前推荐的7B "Mistral 7B"是不同、更大的模型。如果您有8 GB内存,请改用Llama 3.1 8B或Qwen3 8B。运行Mistral Small 3.2所需的16GB以上GPU等级请参见硬件指南。
如何用Ollama运行这些模型?
从ollama.com安装Ollama,然后运行:`ollama run llama3.2:3b`启动推荐的入门模型。Ollama在首次运行时自动下载模型。这里列出的所有五款模型均在Ollama库中可用。
Llama 3.2 3B足够满足日常任务吗?
适合以下场景:摘要、简单问答、基础代码说明和对话聊天。不适合:多步推理、复杂编程和长格式结构化写作。对于这些任务,请在8 GB内存下升级到Llama 3.1 8B或Qwen3 8B。
3B和7B模型有什么区别?
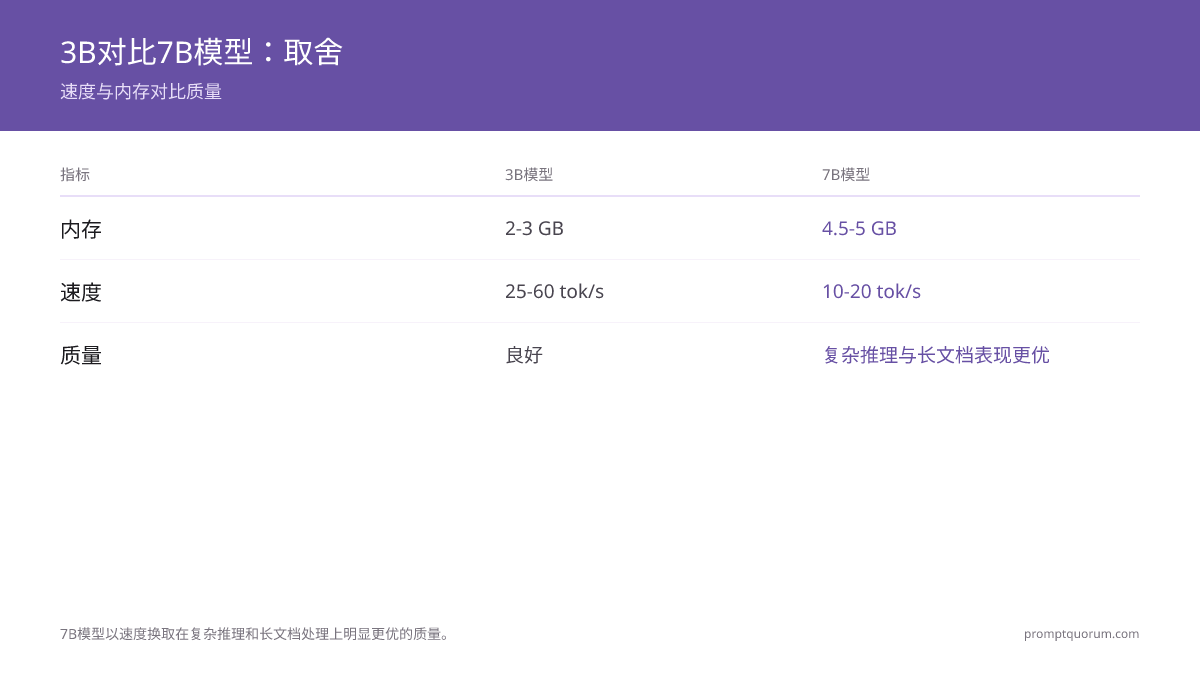
7B模型在复杂指令和推理方面的输出质量明显更好。3B模型使用约一半的内存,运行速度快2–3倍。选择几乎总是由可用内存决定——4–6 GB机器用3B,8 GB机器用7B。
哪款模型最适合编程任务?
在本表的五款模型中,Llama 3.1 8B的HumanEval数值最高(72%,Phi-4 Mini 3.8B为70%,Qwen3 8B为57.3%);Qwen3 8B更适合多语言场景。如需专用编程模型,可试试 `ollama run qwen2.5-coder:7b`。在4–6 GB内存限制下,Phi-4 Mini 3.8B是此处所列模型中HumanEval数值最高的(2.5 GB内存达70%)。
哪款模型适合中文或非英语语言?
Qwen3 8B原生支持29种以上语言,包括中文、日语、韩语、阿拉伯语和所有主要欧洲语言。社区反馈显示,Qwen3 处理中文文本时通常分词开销较低,具体因文本而异。
这些模型用于私人数据安全吗?
推理在您自己的硬件上运行,因此提示词不会发送到云API。这有助于简化数据本地化方面的考量,但是否符合中国《数据安全法》取决于您整体的数据处理,且不构成法律建议;Ollama仍可能为下载模型和检查更新而联网,除非您将其禁用。对于金融、医疗等敏感数据,这可以避免与云服务商共享提示词,但并非合规保证。
下载这些模型需要多长时间?
以100 Mbps连接为例:Llama 3.2 1B(1.3 GB)约2分钟。Gemma 4 E2B(1.6 GB)约2分钟。Llama 3.2 3B(2 GB)约3分钟。Phi-4 Mini(2.3 GB)约3分钟。Llama 3.1 8B(约5 GB)和Qwen3 8B(约5.2 GB)各约6–7分钟。模型首次下载后会缓存——后续运行几秒内启动。
可以在同一台机器上运行多个模型吗?
可以——所有五款可同时共存于磁盘上。如果全部安装,预留15–20 GB空间。Ollama每次只加载一个模型,在5分钟不活动后卸载。
参考来源
- Meta AI.(2024年)"Llama 3.2 Model Card." llama.meta.com/ — Llama 3.2 3B和1B模型的官方规格和基准。
- Microsoft.(2025年)"Phi-4 Mini Technical Report." huggingface.co/microsoft/Phi-4-mini-instruct — Phi-4 Mini基准数据(68% MMLU、70% HumanEval)。
- Google DeepMind.(2025年)"Gemma Documentation." ai.google.dev/gemma/docs/core — Gemma 4 E2B规格和性能,包括128K上下文窗口升级。
- Ollama.(2026年)"Ollama Model Library." ollama.com/library — Ollama模型标签、大小和拉取命令的权威来源。
- Mistral AI.(2024年)"Mistral 7B Release Notes." mistral.ai/news/announcing-mistral-7b/ — "常见错误"部分提及的旧版7B模型的技术规格和Apache 2.0许可详情。
- 阿里巴巴达摩院.(2025年)"Qwen3 Technical Report." arXiv:2505.09388. arxiv.org/abs/2505.09388 — Qwen3 8B的多语言基准数据和架构详情。
- Meta AI.(2025年)"Llama 3.1 Model Card." llama.meta.com/ — Llama 3.1 8B的官方规格和基准。