关键要点
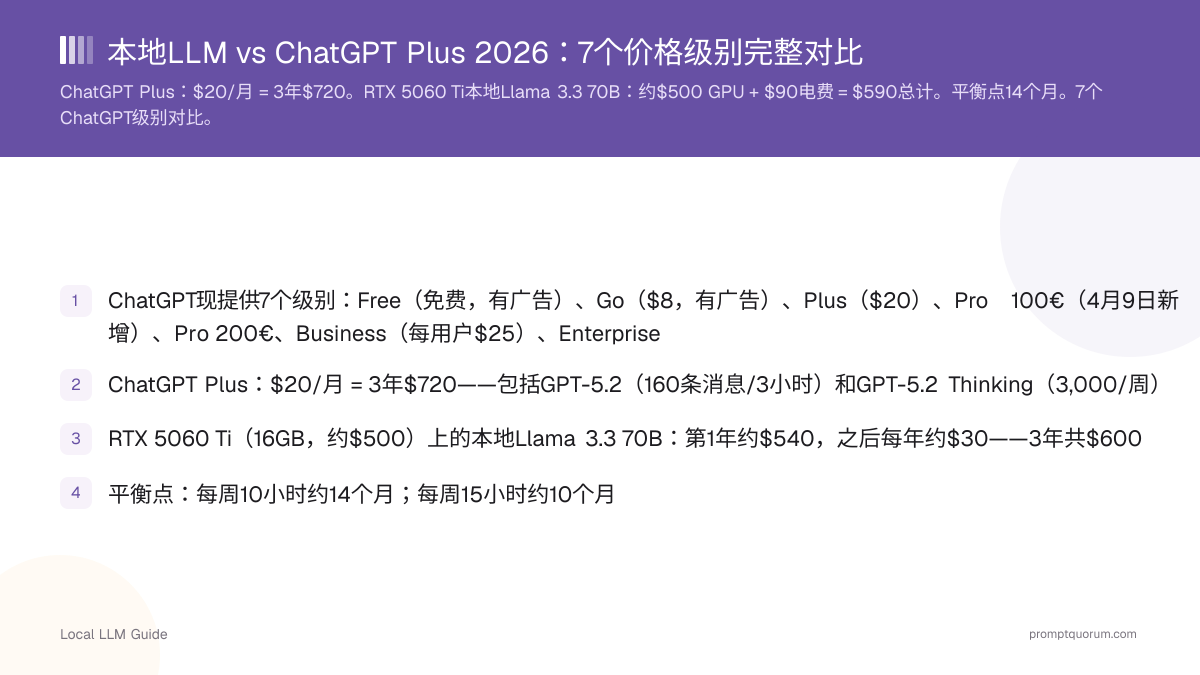
- ChatGPT现提供7个级别:Free(免费,有广告)、Go($8,有广告)、Plus($20)、Pro 100€(4月9日新增)、Pro 200€、Business(每用户$25)、Enterprise
- ChatGPT Plus:$20/月 = 3年$720——包括GPT-5.2(160条消息/3小时)和GPT-5.2 Thinking(3,000/周)
- RTX 5060 Ti(16GB,约$400)上的本地Llama 3.3 70B:第1年约$430,之后每年约$30——3年共$490
- 平衡点:每周10小时约11个月;每周15小时约8个月
- 品质:Llama 3.3 70B达到MMLU的82% vs GPT-5.2的87%——迄今为止本地和云端模型在MMLU基准测试中最接近的差距(截至2026年4月;EvalPlus排行榜)
- 本地优势:无速率限制、离线、100%私密、无订阅取消焦虑
- ChatGPT Plus优势:GPT-5.2 Thinking模式、多模态(图像/音频/视频)、无需设置、即用
- Pro 100€为高级用户提供强大价值——Plus限制的5倍,每月100€获得GPT-5.4 Pro访问权限
📍 简单一句话
ChatGPT Plus三年花费720美元,而在RTX 5060 Ti上运行的本地Llama 3.3 70B同期总花费约为490美元,对于每周使用10小时以上的用户来说,大约11个月即可回本。
💬 简单来说
如果你重度使用ChatGPT,订阅费用会很快累积——仅Plus三年就要720美元。本地方案前期花费更高,但对重度用户来说大约一年就能回本,之后每次查询都是免费的。代价在于质量:本地模型接近但达不到ChatGPT的水平。

快速事实
- ChatGPT Plus(2026年): $20/月 = 3年$720,GPT-5.2 + Thinking(3,000请求/周)
- ChatGPT Pro 100€(4月9日新增): $100/月 = 3年$3,600,GPT-5.4 Pro + o1 Pro模式,Plus限制的5倍
- RTX 5060 Ti上的本地Llama 3.3 70B: 约$400 GPU + $90电费 = 3年约$490总计
- 平衡点: 每周10小时11个月,每周15小时8个月
- 品质差距: Llama 3.3 70B = 82% MMLU vs GPT-5.2 = 87%——迄今为止本地和云端模型在MMLU基准测试中最接近的差距(截至2026年4月;EvalPlus排行榜)
2026年4月有哪7个ChatGPT价格级别?
截至2026年4月17日,ChatGPT提供7个价格级别——OpenAI历史上最复杂的产品线。 Pro 100€级别于4月9日推出,填补了Plus($20)和原始Pro($200)之间的空白。所有价格来自chatgpt.com/pricing的验证。
OpenAI在2026年2月在美国为Free和Go级别引入了广告。Plus、Pro 100€、Pro 200€、Business和Enterprise均不含广告。
- Free和Go现在有广告(2026年2月): OpenAI在美国为Free和Go级别引入了广告;Plus及以上仍无广告
- ChatGPT Plus vs API: $20/月订阅仅覆盖Web UI。OpenAI API单独计费:GPT-5.4成本$0.01/1K输入令牌,$0.04/1K输出令牌
- 无年度计费: 截至2026年4月,Plus、Go和Pro级别仅按月计费——无年度折扣可用
- ChatGPT Plus用户不获得API额度。 API访问需要platform.openai.com上的单独OpenAI平台帐户
级别 | 价格 | 模型 | 使用限制 |
|---|---|---|---|
| Free | $0/月 | GPT-5.3 + 广告 | 10条消息/5小时 |
| Go | $8/月 | GPT-5.3 + 广告 | ~100条消息/5小时 |
| Plus ★ 最佳价值 | $20/月 | GPT-5.2 + Thinking | 160条消息/3小时,3,000 Thinking/周 |
| Pro 100€ ★ 4月9日新增 | 100€/月 | GPT-5.4 Pro + o1 Pro | Plus限制的5倍 |
| Pro 200€ | 200€/月 | 所有模型 | Plus限制的20倍 |
| Business | 每用户$25/月 | GPT-5.2 + 管理功能 | 160条消息/3小时 + SSO |
| Enterprise | 自定义 | 全部 | 无限 + SLA |
2026年4月本地LLM设置成本是多少?
截至2026年4月,且在2026年8月依然适用,三个硬件层涵盖从休闲7B使用到GPT-5.2级别70B推理的范围——由于2026年GDDR7内存短缺,70B级别的GPU价格自春季以来已经上涨。 所有软件均免费:Ollama(推理引擎)、Open WebUI(聊天界面)和所有开源模型(Llama、Qwen、Mistral、Gemma、Phi)可免费下载和运行。
- 入门级——7B模型——RTX 4060 Ti 8GB(二手,$220-260): 运行Llama 3.1 8B、Mistral Small、Gemma 4 9B,速度为25-60 tokens/秒。完整构建:$700-900。
- 黄金点——13B-24B模型——RTX 5060 Ti 16GB(新,$390-400): 运行Mistral Small 3.1 24B和Qwen3 14B,速度为20-40 tokens/秒。完整构建:$900-1,200。覆盖85%的ChatGPT Plus用例。
- 70B层——GPT-5.2级别——三个硬件选项:
- 选项A:RTX 4090二手(24GB,约$1,999——因2026年GDDR7短缺已停产,价格上涨)——通过CUDA以~25 tokens/秒运行Llama 3.3 70B
- 选项B:Mac mini M5 Pro 64GB($1,699)——苹果2026年8月25日改款(2026年9月22日发售),通过Metal运行Llama 3.3 70B
- 选项C:Framework Desktop 128GB($2,199)——使用AMD Ryzen AI Max 395+以20+ tokens/秒运行Llama 3.3 70B
- 2026年4月免费模型: Llama 3.3 70B(Meta)、Llama 4 Scout 8B(Meta,2026年3月)、Qwen3 72B(阿里巴巴)、Mistral Small 3.1 24B、Gemma 4 9B(Google,2026年4月)、Phi-4 Mini 3.8B(微软)
本地设置何时与ChatGPT Plus平衡?
每周10小时使用的平衡点:约11个月,用于RTX 5060 Ti(约$400 GPU)与ChatGPT Plus($240/年)的对比。 11个月后,本地仅成本电费(约$30/年)。请参阅完整硬件成本指南了解详细的每推理小时计算。
每周15小时:平衡点约8个月。每周5小时:平衡点约14个月。每周2小时:ChatGPT Plus($20/月)在2年多的时间内比任何硬件购买都便宜——本地仅在隐私、无速率限制或离线访问重要时正当化。
与ChatGPT Go($8/月 = 年$96)比较:本地RTX 5060 Ti在约3.5年内与Go相比平衡。对于选择Free/Go或本地GPU的轻度用户,本地的经济案例仅在您需要24B+模型质量时成立(ChatGPT Go已通过GPT-5.3提供)。
每个选项的3年总成本是多少?
本地RTX 5060 Ti设置(3年$490)击败ChatGPT Plus($720)32%。 第1年后,本地仅成本电费(约$30/年)——随时间推移变得越来越便宜。电费假设美国平均$0.14/kWh的每天4小时活跃使用;欧盟用户加上约70%,日本加上约25%。
- 关键洞察: RTX 5060 Ti本地13B(3年$490)比ChatGPT Plus($720)便宜32%,且第1年后零月度费用
- ChatGPT Go惊喜: 以3年$288价格,纯成本上击败所有本地7B设置($340)——如果您能容忍广告和GPT-5.3模型
- 70B平价: 成本3年$1,719-2,239——仅在您还需要隐私、无速率限制、离线或多用户场景时正当化
设置 | 第1年 | 第2年 | 第3年 | 3年总计 |
|---|---|---|---|---|
| ChatGPT Free | $0(广告) | $0 | $0 | $0 |
| ChatGPT Go | $96 | $96 | $96 | $288 |
| ChatGPT Plus | $240 | $240 | $240 | $720 |
| ChatGPT Pro 100€ | $1,200 | $1,200 | $1,200 | $3,600 |
| ChatGPT Pro 200€ | $2,400 | $2,400 | $2,400 | $7,200 |
| 本地7B(RTX 4060 Ti二手) | $280 | $30 | $30 | $340 |
| 本地13B(RTX 5060 Ti新品)★ | $430 | $30 | $30 | $490 |
| 本地70B(RTX 4090二手) | $1,999 | $60 | $60 | $2,119 |
| 本地70B(Mac mini M5 Pro 64GB) | $1,699 | $10 | $10 | $1,719 |
| 本地70B(Framework Desktop 128GB) | $2,199 | $20 | $20 | $2,239 |
2026年4月GPT-5.2和本地模型品质如何比较?
GPT-5.2(ChatGPT Plus,2026年4月):87% MMLU、87% HumanEval——$20/月订阅中最强大的模型。 GPT-5.2 Thinking模式为复杂数学和分析添加深度思维链,包含在Plus中,每周3,000个查询。
Llama 3.3 70B(Meta,2024年12月):80% MMLU、88% HumanEval——本地推理领域的领先开源模型之一。与GPT-5.2的5点MMLU差距是迄今为止最小的(截至2026年4月;EvalPlus排行榜)。对于80%的业务任务(电子邮件、代码审查、摘要、问答),Llama 3.3 70B就足够了。
GPT-5.2 Thinking和GPT-5.4 Pro(Pro 100€级别)在新颖的多步骤推理、研究生级数学和自主代理任务中处于领先地位。对于这些用例,截至2026年4月,没有本地模型可以完全竞争。
模型 | 类型 | MMLU | HumanEval | 备注 |
|---|---|---|---|---|
| GPT-5.4 Pro | 云(Pro 100€+) | ~92% | ~93% | 最强大;需Pro 100€/月 |
| GPT-5.2 Thinking | 云(Plus) | ~89% | ~90% | 深度推理;Plus中每周3,000 |
| GPT-5.2 | 云(Plus) | ~87% | ~87% | 标准;Plus中160条消息/3小时 |
| Qwen3 72B | 本地 | 83% | 87% | 最适合中文;强大的编码 |
| Llama 3.3 70B | 本地 | 80% | 88% | 强大的开源模型(2024年12月) |
| Llama 4 Scout 8B | 本地 | 78% | 79% | 新增2026年3月;顶尖8B |
| Mistral Small 3.1 24B | 本地 | 73% | 75% | 高性能24B;适合RTX 5060 Ti 16GB |
| Gemma 4 9B | 本地 | 71% | 72% | Google;9B强大;2026年4月 |
| Phi-4 Mini 3.8B | 本地 | 68% | 70% | 微软;紧凑、强大推理 |
地区考虑事项
中国(数据安全法): 2021年《数据安全法》要求关键信息基础设施运营者和处理个人信息的组织采取措施防止数据跨国转移。本地Llama 3.3 70B或Qwen3在中国服务器或边缘节点上运行,满足完整的数据主权合规性,无需依赖美国云基础设施(如ChatGPT Plus)。金融机构、医疗提供商和政府机构日益采用本地AI推理来满足中国的严格数据驻留要求。
亚太地区(数据跨境): 日本(APPI)、韩国、越南、新加坡和台湾都有针对个人数据跨国传输的类似立法。本地推理完全消除对这些法律的合规风险。企业可以在东南亚地区处理敏感的医疗、财务和法律文件,无需美国云合同。
企业部署: 大型银行、医疗系统和律师事务所正在从ChatGPT Plus转向本地或私有化LLM部署,以最小化供应商锁定、降低合规风险并保持对敏感工作流的完全数据控制。RTX 5060 Ti或更强大的GPU上的Llama 3.3 70B是小到中型企业的实用选择。
常见问题
ChatGPT Plus是否值得每月$20与本地LLM相比?
对于轻度用户(每周少于5小时),是的——每月$20的Plus比购买$400 GPU更简单。对于定期专业使用(每周10小时以上),本地Llama 3.3 70B在RTX 5060 Ti上在约11个月内平衡,然后仅成本电费(约$30/年)。Plus通过GPT-5.2 Thinking在新颖推理上保持领先。
2026年4月推出的新ChatGPT Pro 100€级别是什么?
OpenAI于2026年4月9日推出Pro 100€,填补Plus($20)和Pro($200)之间的空白。Pro 100€包括Plus限制的5倍、GPT-5.4 Pro模型访问权限和用于更深入推理的o1 Pro模式。它针对触及Plus速率限制(160条消息/3小时)但不需要完整Pro 200€级别的高级用户。
2026年哪个本地LLM与GPT-5.2品质匹配?
没有完全匹配。Llama 3.3 70B最接近MMLU上GPT-5.2的~82%——迄今为止最小的差距(截至2026年4月;EvalPlus排行榜)。Qwen3 72B类似。对于编码具体而言,Qwen2.5-Coder 32B达到92.7% HumanEval,与GPT-5.2相当。差距每年都在缩小,但GPT-5.4 Pro在多步骤推理中保持领先。
本地70B设置与ChatGPT Plus的平衡点是什么?
取决于硬件:RTX 4090二手(约$1,999 + 构建)与Plus相比需要约8年平衡。Mac mini M5 Pro 64GB($1,699)约需7年。Framework Desktop 128GB($2,199)约需9年。本地70B仅当您还需要隐私、无速率限制、离线能力或多用户访问权限时,才在经济上合理。
2026年ChatGPT Plus有广告吗?
没有。广告仅在Free和Go级别(2026年2月推出,美国市场最先)。ChatGPT Plus、Pro 100€、Pro 200€、Business和Enterprise都无广告。OpenAI已声明不会在付费级别引入广告。
编程方面哪个更好:ChatGPT Plus还是本地Qwen3-Coder?
对于通用编程:接近。本地Qwen2.5-Coder 32B达到92.7% HumanEval,与GPT-5.2相当。对于自主编码代理和Codex集成,ChatGPT Plus有更好的工具。对于隐私敏感的代码库或离线工作,本地Qwen2.5-Coder 32B是正确选择。
我可以随时取消ChatGPT Plus吗?
是的。截至2026年4月,Plus仅按月计费,无年度承诺。通过ChatGPT中的设置→订阅来取消。访问权限继续至付费期末。OpenAI不提供部分月份退款。
2026年运行本地LLM的电费成本是多少?
RTX 5060 Ti活跃推理:~180W。美国平均$0.14/kWh。典型使用(每天4小时活跃,其余闲置):美国年$30-40。欧盟:2-3倍更高(年$90-120)。日本:年~$45。中国:年~$25。24/7完全活跃会成本美国年~$220——大多数用户没有现实的使用模式。
选择本地LLM和ChatGPT Plus时的常见错误
- 将本地与ChatGPT Free($0/广告)比较,而不是Plus($20)。有意义的比较是Plus vs本地——Free和Go有严格的限制(Free上10条消息/5小时)。
- 期望Llama 3.3 70B与GPT-5.2 Thinking相匹配。基础70B关闭MMLU差距的82%,但Thinking模式的深度思维链推理在多步骤数学和复杂分析上保持领先。
- 购买RTX 4090进行70B推理,而Mac mini M5 Pro 64GB通过Metal更流畅运行,无量化质量损失。
- 忽视RTX 5060 Ti 16GB甜点($390-400)。这张卡以全质量运行Mistral Small 3.1 24B,覆盖85%的Plus用例,3年$490 vs Plus $720。
- 在选择本地设置时不考虑ChatGPT Pro 100€作为替代方案。如果您需要5倍Plus限制而无硬件管理,Pro 100€以每月100€提供GPT-5.4 Pro访问权限——通常比构建70B钻机更好。
相关资源
- 本地LLM vs Claude Pro——与Anthropic Claude Pro($20/月)的隐私、成本和品质对比
- 如何在任何OS上安装Ollama——免费开源推理引擎,在5分钟内本地运行Llama 3.3
- 本地LLM vs云GPU:成本对比——损益分岐点分析:本地RTX 4070 vs Lambda Labs、Paperspace、AWS GPU
- 购买GPU是否值得vs支付AI订阅?——GPU购买vs ChatGPT Plus、Claude Pro、API订阅的ROI计算器
- 本地LLM最佳预算GPU——顶级经济选项:RTX 4060、RTX 3060、RX 6700,按性能/美元排名
- 本地LLM硬件指南2026——所有模型大小和预算的综合GPU和RAM推荐
来源
- OpenAI ChatGPT定价(2026年4月)——所有7个ChatGPT级别的官方定价,包括2026年4月9日推出的Pro 100€
- Meta Llama 3.3 70B模型卡——当前旗舰开源70B模型的官方基准(2024年12月)
- NVIDIA GeForce RTX 5060 Ti规格——推荐用于本地13B-24B推理的16GB变体的官方规格
- Framework Desktop(AMD Ryzen AI Max 395+)——为本地LLM专门设计的128GB统一内存台式机的规格