可以在 Radeon RX 6800M 上运行本地 LLM 吗?
Hans Kuepper 作者 · PromptQuorum创始人 · 开放权重与开源AI发现引擎
关键要点
- ✓RX 6800M 是移动版 RDNA 2 芯片(Navi 22,12 GB 显存)——不是桌面版 RX 6800(Navi 21,16 GB 显存)
- ✓在 Windows 和 Linux 上 Vulkan 是可靠路径;ROCm 不正式支持 6800M,且在 Windows 上 Ollama 的 ROCm 列表从 RX 7600 起
- ✓估计速度:8B(Q4_K_M)约 45–60 tok/s,14B 约 25–35 tok/s——根据同一芯片的 RX 6700 XT 基准推算,并非 PromptQuorum 实测
- ✓请接通电源使用:笔记本 GPU 在电池供电时功率限制更严,推理速度会下降
快速回答
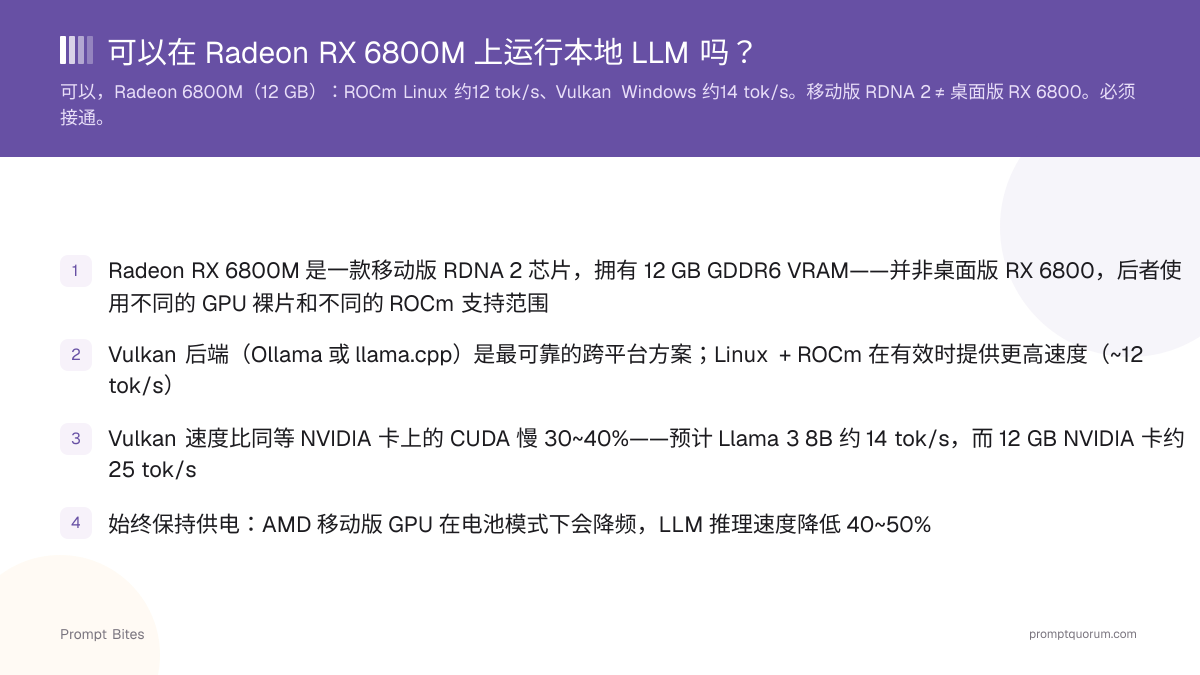
可以。Radeon RX 6800M 拥有 12 GB GDDR6 显存,在 Windows 和 Linux 上通过 Ollama 或 llama.cpp 的 Vulkan 后端即可良好运行本地 LLM。ROCm 不正式支持该芯片;在 Linux 上只能通过非官方覆盖方式使用。8B 模型(Q4_K_M)的估计速度约为 45–60 tok/s,依据同一芯片的 RX 6700 XT 基准推算,并非 PromptQuorum 实测。
- ▸Windows 和 Linux:Vulkan 是可靠路径(Ollama 默认启用)
- ▸ROCm:6800M 不在 AMD 或 Ollama 的支持列表中;Linux 需要 HSA_OVERRIDE_GFX_VERSION=10.3.0,且可能不稳定
- ▸12 GB 显存在适度上下文长度下支持 Q4_K_M 量化的最高 14B 模型
Radeon RX 6800M 实际能运行什么
Radeon RX 6800M 是移动版 RDNA 2 芯片(Navi 22,gfx1031),配备 12 GB GDDR6 显存——不是使用更大 Navi 21 芯片、配备 16 GB 的桌面版 RX 6800。12 GB 显存可在不卸载层的情况下容纳 Q4_K_M 量化的最高 14B 模型,容量与桌面版 RTX 3060 12 GB 相当。更长的上下文会在模型权重之外增加 KV 缓存占用。
单用户生成速度主要受内存带宽限制。6800M 与桌面版 RX 6700 XT 使用同一 Navi 22 芯片和 12 GB 显存配置,后者在llama.cpp Vulkan 成绩榜中使用 Vulkan 后端运行 Llama 2 7B Q4_0 约 84 tok/s。把该数值按更大的模型文件换算,就得到下表的估计值。笔记本的功率限制和散热可能使 6800M 低于桌面显卡。
这些速度是依据该公开基准推算的估计值,并非 PromptQuorum 在 6800M 上的测试。请在自己的机器上运行 llama-bench 获取真实数据。如需与 8 GB 显存的 CUDA 方案对比,请参见AMD 5700X + RTX 3070 Ti 对比。
| 模型 | 显存(Q4_K_M) | 估计速度(Vulkan) |
|---|---|---|
| Llama 3.1 8B | ~5 GB | ~45–60 tok/s |
| Qwen3 8B | ~5 GB | ~45–60 tok/s |
| Phi-4 14B | ~9 GB | ~25–35 tok/s |
| Qwen3 14B | ~9 GB | ~25–35 tok/s |
在 6800M 上设置本地 LLM
在 Windows 和 Linux 上安装 Ollama——它对 AMD GPU 使用 Vulkan 后端,无需 ROCm。Ollama GPU 文档指出,只要安装了该后端,Vulkan 默认启用;在 Linux 上可能还需要额外的 Vulkan 软件包。也可使用 llama.cpp 预编译的 Vulkan 二进制文件,并用 -ngl 99 加载 GGUF,将所有层卸载到 GPU。
ROCm 是更难的路径。RX 6800M 不在 AMD 的 ROCm 支持表中,也不在 Ollama 的 AMD 列表中;在 Windows 上,Ollama 的 ROCm 列表只覆盖 RX 7600 及更新型号。在 Linux 上,社区报告使用 HSA_OVERRIDE_GFX_VERSION=10.3.0 让 ROCm 把该芯片当作 gfx1030。这是非官方做法,可能崩溃或回退到 CPU,请先尝试 Vulkan。
务必接通电源——笔记本 GPU 在电池供电时功率限制更严,推理速度会下降。NVIDIA 与 AMD 的完整 GPU 对比请参见本地 LLM 最佳 GPU 指南。
ollama run llama3.1:8b,然后检查 ollama ps——PROCESSOR 列应显示 100% GPU。如果显示 CPU,请查看 Ollama 服务器日志中的 GPU 检测信息。Radeon RX 6800M 与桌面版 RX 6800
搜索“RX 6800”常常指向移动版芯片,但这两款显卡并不相同。桌面版 RX 6800 拥有 16 GB 显存和更高的内存带宽,能容纳更大的模型且生成更快。llama.cpp Vulkan 成绩榜列出桌面版 RX 6800 约 101 tok/s,RX 6700 XT 约 84 tok/s(Llama 2 7B Q4_0,Vulkan)。
桌面版 RX 6800 在 Ollama 的 Linux AMD 支持列表中,而 6800M 不在。本页关于 Vulkan 的其余内容对两款显卡都适用。
| 规格 | RX 6800M(笔记本) | RX 6800(桌面) |
|---|---|---|
| GPU 芯片 | Navi 22 (gfx1031) | Navi 21 (gfx1030) |
| 显存 | 12 GB GDDR6 | 16 GB GDDR6 |
| 内存带宽 | 384 GB/s | 512 GB/s |
| Ollama Linux AMD 支持列表 | 未列出 | 已列出 |
| Windows 上的 Ollama ROCm | 未列出 | 未列出 |
相关指南
关于 Radeon 6800M 与本地 LLM 的常见问题
Radeon 6800M 正式支持 ROCm 吗?▾
HSA_OVERRIDE_GFX_VERSION=10.3.0 运行,但这是非官方的变通方法。Vulkan 才是这款显卡受支持的路径。Radeon RX 6800M 有多少显存?▾
Ollama 能在 RX 6800M 上运行吗?▾
对本地 LLM 来说,桌面版 RX 6800 比 6800M 更好吗?▾
6800M 运行本地 LLM 比 RTX 3070 Mobile 更快吗?▾
llama-bench 对比真实结果。