Schnelleinstieg: Erstes lokales LLM in 3 Minuten ausführen
1. Ollama installieren (1 Minute)
Download von ollama.com und Installer ausführen. Keine Konfiguration erforderlich.
2. Llama 3.2 3B ausführen (2 Minuten)
Öffnen Sie Ihr Terminal und führen aus: `ollama run llama3.2:3b`
Ollama lädt das Modell (~2 GB) beim ersten Mal herunter. Dies ist das empfohlene erste Modell für die meisten Benutzer.
3. Sofort chatten (sofort)
Sobald das Modell geladen ist, geben Sie Ihre Frage oder Eingabeaufforderung ein und drücken Sie die Eingabetaste. Sie sehen Antworten mit 25–45 Tokens/Sekunde auf einem typischen Laptop.
Das war's. Keine manuelle Konfiguration, keine GPU erforderlich. Wenn Sie 8 GB+ RAM haben, können Sie sofort loslegen. Wenn Sie 4–6 GB haben, verwenden Sie stattdessen `ollama run gemma4:e2b` (schneller, nutzt 1,7 GB RAM).
Checkliste für Anfänger: Ist lokal die richtige Wahl für Sie?
Beantworten Sie diese drei Fragen, bevor Sie Ihr erstes Modell herunterladen:
1. Haben Sie 8 GB RAM oder mehr? (Falls nein, sind Cloud-APIs schneller für den Einstieg.)
2. Benötigen Sie, dass Ihre Daten privat bleiben? (Falls nein, bieten Cloud-APIs bessere Qualität.)
3. Können Sie 20–40 Minuten Setup akzeptieren? (Falls nein, sind Cloud-APIs in 5 Minuten einsatzbereit.)
Wenn Sie zwei oder mehr Fragen mit „nein" beantwortet haben, lesen Sie den vollständigen Vergleich lokal vs. Cloud, um zu prüfen, ob eine Cloud-API besser zu Ihrer Hardware und Ihrem Zeitplan passt. Anfänger nehmen oft an, dass lokale LLMs immer besser sind – das ist nicht wahr. Die richtige Wahl hängt von Ihren spezifischen Einschränkungen ab.
Wie wählt man ein lokales LLM-Einstiegsmodell aus?
Die Modellauswahl für lokale LLMs hängt von drei Einschränkungen ab: verfügbarer RAM, Inferenzgeschwindigkeit und Aufgabentyp – in dieser Prioritätsreihenfolge.
Die Parameteranzahl (3B, 7B, 13B) ist der primäre Treiber des RAM-Bedarfs. Bei 4-Bit-Quantisierung – dem Standard für die meisten lokalen Inferenz-Tools – multiplizieren Sie die Parameteranzahl mit ~0,5, um die benötigten GB RAM zu schätzen. Ein 7B-Modell bei Q4_K_M benötigt etwa 4,5 GB RAM.
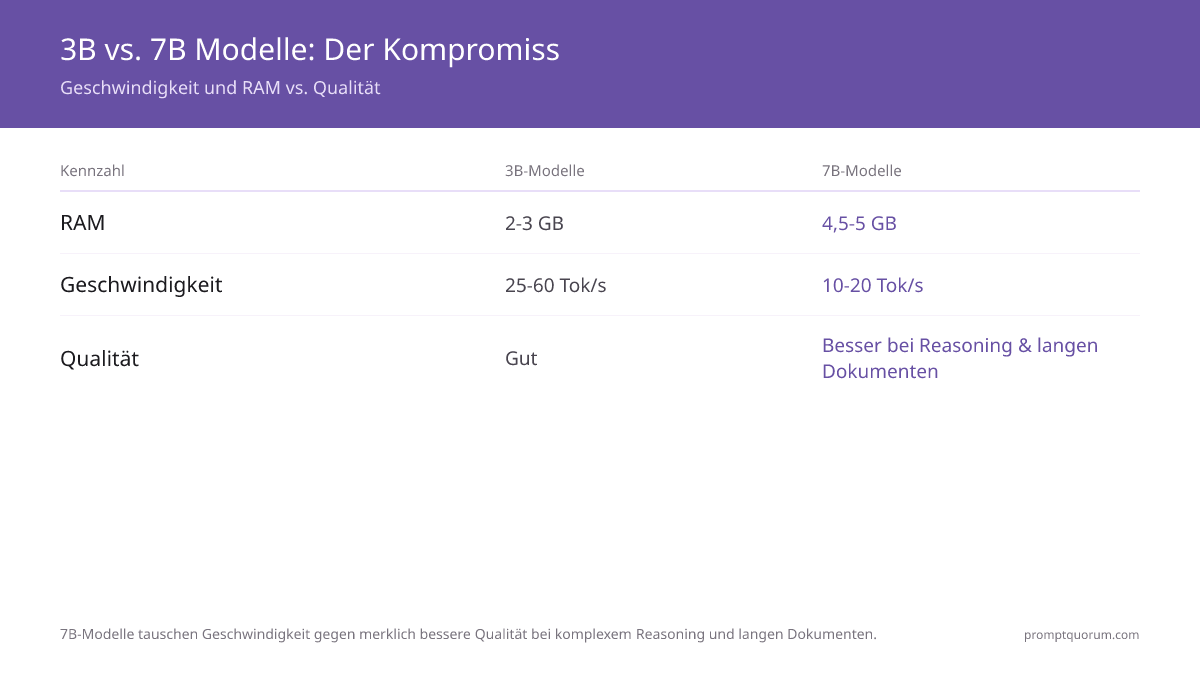
Für die meisten Einsteiger bieten 7B-Modelle bei Q4_K_M-Quantisierung die beste Balance aus Qualität, Geschwindigkeit und RAM-Verbrauch auf Maschinen mit 8 GB oder mehr. Auf Maschinen mit 4–6 GB RAM sind 3B-Modelle die praktische Obergrenze.

#1 Meta Llama 3.2 3B – Bestes Einstiegsmodell insgesamt
Meta Llama 3.2 3B ist der beste Ausgangspunkt für die meisten Benutzer. Es lädt in unter 5 Minuten herunter, läuft auf jeder Maschine mit 4 GB RAM und bietet spürbar bessere Anweisungsverarbeitung als frühere 3B-Modelle. Es verwendet ein 128K-Kontextfenster – deutlich größer als bei vergleichbaren Modellen.
Rechnen Sie mit etwa 25–45 Tokens/s auf einer 8-Kern-Laptop-CPU und deutlich mehr auf Apple Silicon wie dem M3 Pro (grobe Schätzwerte; PromptQuorum hat dies hier nicht gemessen, und die Geschwindigkeit hängt von Hardware und Einstellungen ab). Die Qualität ist für Zusammenfassungen, Q&A und einfache Coding-Aufgaben ausreichend, bleibt aber bei mehrstufigem Reasoning hinter 7B-Modellen zurück.
Spezifikation | Wert |
|---|---|
| Parameter | 3B |
| Benötigter RAM | ~2,5 GB (Q4_K_M) |
| Download-Größe | ~2 GB |
| Kontextfenster | 128K Tokens |
| CPU-Geschwindigkeit (8-Kern-Laptop) | 25–45 Tok/s |
| Ollama-Befehl | ollama run llama3.2:3b |
#2 Microsoft Phi-4 Mini 3.8B – Bestes Modell für wenig RAM
Phi-4 Mini ist Microsofts kompaktes Modell, das für Reasoning- und Coding-Aufgaben in kleinem Maßstab optimiert ist. Es erreicht 68 % MMLU und 70 % HumanEval – Werte, die viele 7B-Modelle aus 2024 übertreffen – dank Training mit hochwertigen synthetischen Daten, die auf Problemlösung ausgerichtet sind.
Es ist das empfohlene Modell für Maschinen mit 4–6 GB RAM, wo Qualität wichtig ist. Phi-4 Mini benötigt 2,5 GB RAM (gegenüber 3 GB bei Phi-3.5 Mini), was es auf 4-GB-Maschinen zugänglicher macht.
Spezifikation | Wert |
|---|---|
| Parameter | 3,8B |
| Benötigter RAM | ~2,5 GB (Q4_K_M) |
| Download-Größe | ~2,3 GB |
| MMLU-Score | 68 % |
| Kontextfenster | 128K Tokens |
| CPU-Geschwindigkeit (8-Kern-Laptop) | 30–50 Tok/s |
| Ollama-Befehl | ollama run phi4-mini |
#3 Google Gemma 4 E2B – Eines der schnelleren 2B-Modelle
Gemma 4 E2B ist Googles aktualisiertes 2B-Modell und eine der schnelleren Optionen für reine CPU-Inferenz. Es erzeugt etwa 40–60 Tokens/s auf einem Mid-Range-Laptop-CPU (grobe Schätzung, keine Messung von PromptQuorum; abhängig von der Hardware). Gemma 4 E2B verbessert frühere Gemma-Generationen erheblich: Das Kontextfenster wird von 8K (Gemma 2) auf 128K Tokens erweitert, wodurch eine wesentliche Einschränkung für Dokumentenaufgaben entfällt.
Gemma 4 E2B ist eine gute Wahl, wenn Antwortgeschwindigkeit am wichtigsten ist, auf Maschinen mit ≤4 GB RAM, oder als Test-Modell, um die lokale LLM-Einrichtung zu überprüfen, bevor größere Modelle heruntergeladen werden.
Spezifikation | Wert |
|---|---|
| Parameter | 2B |
| Benötigter RAM | ~1,7 GB (Q4_K_M) |
| Download-Größe | ~1,6 GB |
| Kontextfenster | 128K Tokens |
| CPU-Geschwindigkeit (8-Kern-Laptop) | 40–60 Tok/s |
| Ollama-Befehl | ollama run gemma4:e2b |
#4 Meta Llama 3.1 8B – Bestes 7B/8B-Allround-Modell
Meta Llama 3.1 8B ist das aktuelle universell einsetzbare Modell dieser Größenklasse, erreicht 72 % HumanEval und bietet solides englisches Reasoning. Es ersetzt Mistral 7B als 7B/8B-Empfehlung dieser Liste – Mistral 7B war 2023–2024 der Community-Standard, erzielt aber inzwischen bei gleichem RAM-Bedarf in veröffentlichten Benchmarks schlechtere Werte als neuere Modelle und ist eher als Legacy-Option zu betrachten (siehe Häufige Fehler unten, warum es nicht mehr als Standardwahl empfohlen wird).
Für Maschinen mit 8 GB RAM ist Llama 3.1 8B ein natürlicher Aufstieg gegenüber 3B-Modellen. Es verarbeitet längere Texte, komplexere Anweisungen und mehrstufige Gespräche zuverlässiger als jedes 3B-Modell, mit einem 128K-Kontextfenster.
Spezifikation | Wert |
|---|---|
| Parameter | 8B |
| Benötigter RAM | ~5,5 GB (Q4_K_M) |
| Download-Größe | ~5 GB |
| Kontextfenster | 128K Tokens |
| HumanEval-Score | 72 % |
| CPU-Geschwindigkeit (8-Kern-Laptop) | 10–18 Tok/s |
| Ollama-Befehl | ollama run llama3.1:8b-instruct |
#5 Qwen3 8B – Bestes Modell für Mehrsprachigkeit
Qwen3 8B (8,2 Mrd. Parameter) erreicht 57,3 % HumanEval, liegt bei MMLU auf Augenhöhe mit oder vor Llama 3.1 8B und unterstützt nativ 29+ Sprachen, darunter Chinesisch, Japanisch, Koreanisch, Arabisch und alle wichtigen europäischen Sprachen. Es ist die empfohlene Wahl für nicht-englische Workflows oder coding-intensive Anwendungsfälle und ersetzt das frühere Qwen2.5 7B als Mehrsprachigkeits-Empfehlung dieser Liste.
Qwen3 8B verwendet ein 32K-Kontextfenster (erweiterbar auf 131K mit YaRN) und unterstützt strukturierte Ausgaben mit JSON-Modus sowie einen optionalen „Thinking Mode" für anspruchsvollere Reasoning-Aufgaben (langsamer, aber präziser). Das Modell ist in Instruct- und Base-Varianten verfügbar – für Chat-Nutzung immer die Instruct-Version verwenden. Siehe den Qwen vs Llama vs Mistral Benchmark-Vergleich für detaillierte Benchmark-Daten.
Spezifikation | Wert |
|---|---|
| Parameter | 8,2B |
| Benötigter RAM | ~5,2 GB (Q4_K_M) |
| Download-Größe | ~5,2 GB |
| Kontextfenster | 32K Tokens (131K mit YaRN) |
| HumanEval-Score | 57,3 % |
| CPU-Geschwindigkeit (8-Kern-Laptop) | 10–18 Tok/s (Non-Thinking-Modus) |
| Ollama-Befehl | ollama run qwen3:8b |
Welches Modell gewinnt nach RAM, Geschwindigkeit und Kontextfenster?
Modell | RAM | Geschwindigkeit (CPU) | Kontext | Einsatzgebiet |
|---|---|---|---|---|
| Llama 3.2 3B | 2,5 GB | 25–45 Tok/s | 128K | Allgemeine Nutzung, erstes Modell |
| Phi-4 Mini 3.8B | 2,5 GB | 30–50 Tok/s | 128K | Reasoning, Coding, wenig RAM |
| Gemma 4 E2B | 1,7 GB | 40–60 Tok/s | 128K | Geschwindigkeit, sehr wenig RAM |
| Llama 3.1 8B | 5,5 GB | 10–18 Tok/s | 128K | Allgemeines Allround-Modell, 72 % HumanEval |
| Qwen3 8B | 5,2 GB | 10–18 Tok/s | 32K (131K YaRN) | Mehrsprachigkeit, Coding |

Mit welchem Modell sollten Sie beginnen?
- 2 GB RAM (extremes Low-End): `ollama run llama3.2:1b` – kleinste sinnvolle Option, ~1,3 GB Download. Die Qualität liegt spürbar unter 3B+-Modellen, läuft aber auf sehr alter oder eingeschränkter Hardware.
- 4 GB RAM oder weniger: `ollama run gemma4:e2b` – schnellster Download, niedrigster Speicherverbrauch, 128K-Kontext. Akzeptable Qualität für grundlegende Aufgaben.
- 8 GB RAM, erstes Modell: `ollama run llama3.2:3b` – beste Balance aus Qualität und RAM für eine erste Erfahrung.
- 4–6 GB RAM, Reasoning/Coding: `ollama run phi4-mini` – 68 % MMLU, 70 % HumanEval bei nur 2,5 GB RAM. Besser als Llama 3.2 3B bei strukturierten Aufgaben.
- 8 GB RAM, ernsthafter Einsatz: `ollama run llama3.1:8b-instruct` oder `ollama run qwen3:8b` – Aufstieg für längere Dokumente und komplexe Anweisungen.
- Hauptsächlich Coding-Aufgaben: `ollama run llama3.1:8b-instruct` – höchster HumanEval-Wert in dieser Liste (72 %); für ein dediziertes Coding-Modell probieren Sie `ollama run qwen2.5-coder:7b`.
- Nicht-englische Sprache: `ollama run qwen3:8b` – native Unterstützung für 29+ Sprachen, kein Übersetzungsaufwand.

Welches Modell sollten Sie je nach Region wählen?
EU / DSGVO: Für EU-Organisationen, die personenbezogene Daten lokal verarbeiten, spielt die Herkunft des Modells für die Compliance-Dokumentation eine Rolle. Die Dokumentation von Modellherkunft und Lizenztyp ist für KI-Systeme in professionellen Kontexten eine gute Praxis. Llama (Meta/USA), Gemma (Google/USA) und Qwen (Alibaba/China): Lokale Inferenz allein schließt keines dieser Modelle nach der DSGVO aus; ob Ihr Einsatz rechtmäßig ist, hängt von Rechtsgrundlage, technischen und organisatorischen Maßnahmen und Zweck ab – für die sauberste EU-Herkunftsnarrative bietet Mistral AI (Frankreich) Apache-2.0-lizenzierte Modelle, wobei die aktuellen Mistral-Small-Versionen (24B+) den in diesem Artikel behandelten 4–8-GB-Einsteigerbereich übersteigen; siehe den Hardware-Guide für die benötigte GPU-Klasse.
Japan (METI): Für japanischsprachige Workflows ist Qwen3 8B ein guter erster Kandidat – laut Community-Berichten benötigt der Tokenizer von Qwen3 bei japanischem Text tendenziell weniger Tokens als der von Llama; die Ergebnisse variieren je nach Text. Befehl: `ollama run qwen3:8b`. Die Dokumentation von Modellname und Version ist eine gute Praxis für KI-Governance in Japan (siehe die KI-Leitlinien des METI) – alle fünf hier aufgeführten Modelle haben versionierte Ollama-Tags, die dies erleichtern.
China: Qwen3 8B (Alibaba) ist das natürliche erste Modell für chinesischsprachige Workflows. Native chinesische Tokenisierung und 29+-Sprachen-Unterstützung machen es zum Standard für Mandarin-orientierte Workflows. Für den chinesischen Unternehmenseinsatz unter dem Datensicherheitsgesetz Chinas (数据安全法) hält lokale Inferenz via Ollama Prompts und Ausgaben auf Ihrer Hardware, was Fragen der Datenlokalisierung für diese Ebene vereinfachen kann; ob Ihr Einsatz konform ist, hängt von Ihrer gesamten Datenverarbeitung ab.
Korea: Unter diesen fünf Einsteiger-Modellen hat Qwen3 8B die stärkste native koreanische Tokenisierung. Für dedizierte koreanischsprachige lokale Modelle jenseits dieser Einsteigerstufe siehe Beste koreanischsprachige Modelle für lokalen Einsatz.
Allgemeine Information, keine Rechtsberatung: Die obigen regionalen Hinweise sind allgemeine Informationen und keine Rechtsberatung; klären Sie die Anforderungen für Ihren Fall mit einer qualifizierten Fachperson.
Wie lädt man diese Modelle herunter und startet sie?
Alle fünf Modelle installieren sich mit einem einzigen Ollama-Befehl – keine manuelle Konfiguration erforderlich. Siehe Ollama installieren für die Einrichtung, dann Erstes lokales LLM starten für eine schrittweise Anleitung. Wenn Sie auf einem Laptop mit begrenztem RAM arbeiten, finden Sie unter Lokale LLMs auf dem Laptop ausführen Informationen zur Quantisierung und Leistungsoptimierung für eingeschränkte Hardware.
Sobald Ihr erstes Modell läuft, ist der nächste Schritt, es effektiv zu prompten. Beginnen Sie mit den Prompt-Engineering-Grundlagen — 16 Guides, die die Bausteine jedes Prompts abdecken, von Temperatureinstellungen bis zur Output-Formatierung.
Welche Fehler machen Einsteiger bei der Wahl eines lokalen LLMs?
- Modellgröße nur nach Parameteranzahl wählen – 7B bei 4-Bit-Quantisierung kann ein schlecht quantisiertes 13B-Modell übertreffen.
- VRAM-Quantisierungs-Overhead nicht berücksichtigen – ein Modell kann 10–15 % mehr VRAM benötigen als die Dateigröße.
- Ältere Quantisierungen (Q3_K_S) verwenden, wenn neuere (Q4_K_M) bessere Qualität bei gleicher Größe bieten.
- Mistral 7B als Standard-7B-Modell wählen: Es war 2023–2024 der Community-Standard (7B, ~4,1 GB Download, `ollama run mistral`), erzielt aber inzwischen in veröffentlichten Benchmarks bei gleichem RAM-Bedarf schlechtere Werte als neuere Modelle wie Qwen3 8B (Coding) und Llama 3.1 8B (englisches Reasoning). Wenn ein Tutorial oder Tool standardmäßig `ollama run mistral` verwendet, wechseln Sie zu `ollama run qwen3:8b` oder `ollama run llama3.1:8b-instruct` für bessere Ergebnisse ohne mehr RAM. Hinweis: Dies ist ein anderes, nicht verwandtes Modell als die aktuelle 24B+-Reihe „Mistral Small 3.x", die deutlich mehr RAM benötigt als jedes Modell auf dieser Seite.
- Ein Modell herunterladen, ohne zuerst den verfügbaren RAM zu prüfen: Wenn Sie ein Modell herunterladen, das den verfügbaren RAM überschreitet, fällt Ollama auf langsame CPU-Inferenz mit partiellem Disk-Swapping zurück – manchmal unter 1 Tok/s. Führen Sie immer zuerst `free -h` (Linux/macOS) aus oder überprüfen Sie den Task-Manager (Windows), bevor Sie Modelle über 7B herunterladen.
Häufig gestellte Fragen
Welches lokale LLM-Modell ist 2026 am besten für Einsteiger?
Llama 3.2 3B für die meisten Benutzer – läuft auf jeder Maschine mit 4 GB RAM, lädt in unter 5 Minuten herunter und bietet starke Anweisungsverarbeitung. Bei 8 GB RAM bietet Qwen3 8B bessere Coding- und Mehrsprachigkeits-Leistung. Für absolut niedrigsten RAM läuft Gemma 4 E2B mit 1,7 GB bei 40–60 Tok/s auf der CPU, oder Llama 3.2 1B auf 2 GB oder weniger.
Wie viel RAM ist mindestens erforderlich, um ein lokales LLM zu betreiben?
Das praktische Minimum für nützliche Ausgaben sind 4 GB RAM mit einem 3B-Modell bei Q4_K_M-Quantisierung. Auf 2 GB oder weniger ist Llama 3.2 1B die kleinste sinnvolle Option, wobei die Qualität spürbar sinkt. 8 GB RAM schalten 7–8B-Modelle frei, die bei komplexen Aufgaben deutlich bessere Ergebnisse liefern.
Was ist das beste lokale LLM mit 1B Parametern?
Llama 3.2 1B ist das empfohlene 1B-Modell – ~1,3 GB Download, läuft auf 2 GB RAM oder weniger via `ollama run llama3.2:1b`. Es eignet sich für einfache Zusammenfassungen und kurze Q&A, ist aber bei mehrstufigem Reasoning spürbar schwächer als 3B+-Modelle. Nutzen Sie es nur, wenn die Hardware ein 3B-Modell tatsächlich nicht unterstützt.
Ist Mistral Small 3.2 ein gutes Einsteiger-LLM?
Nein – Mistral Small 3.2 ist ein Modell mit 24 Mrd. Parametern, das etwa 14 GB+ RAM/VRAM benötigt, weit über dem in diesem Artikel behandelten 4–8-GB-Einsteigerbereich. Es ist ein anderes, deutlich größeres Modell als das hier früher empfohlene 7B-Modell „Mistral 7B". Bei 8 GB RAM starten Sie stattdessen mit Llama 3.1 8B oder Qwen3 8B. Siehe den Hardware-Guide für die 16GB+-GPU-Klasse, die für Mistral Small 3.2 benötigt wird.
Wie führe ich diese Modelle mit Ollama aus?
Installieren Sie Ollama von ollama.com, dann führen Sie aus: `ollama run llama3.2:3b` für das empfohlene Einstiegsmodell. Ollama lädt das Modell beim ersten Ausführen herunter. Alle fünf hier aufgeführten Modelle sind in der Ollama-Bibliothek verfügbar.
Ist Llama 3.2 3B gut genug für alltägliche Aufgaben?
Ja für: Zusammenfassungen, einfaches Q&A, grundlegende Code-Erklärungen und konversationellen Chat. Nein für: mehrstufiges Reasoning, komplexes Coding und langes strukturiertes Schreiben. Für diese Aufgaben upgraden Sie auf Llama 3.1 8B oder Qwen3 8B mit 8 GB RAM.
Was ist der Unterschied zwischen 3B- und 7B-Modellen?
Ein 7B-Modell liefert bei komplexen Anweisungen und Reasoning deutlich bessere Ausgaben. Ein 3B-Modell verwendet ungefähr halb so viel RAM und läuft 2–3× schneller. Die Wahl wird fast immer durch den verfügbaren RAM bestimmt – 3B auf 4–6-GB-Maschinen, 7B auf 8-GB-Maschinen.
Welches Modell ist am besten für Coding-Aufgaben?
Llama 3.1 8B hat in dieser Tabelle den höchsten HumanEval-Wert der fünf Modelle (72 %, gegenüber 70 % bei Phi-4 Mini 3.8B und 57,3 % bei Qwen3 8B); Qwen3 8B ist die Wahl für mehrsprachige Nutzung. Für ein dediziertes Coding-Modell probieren Sie `ollama run qwen2.5-coder:7b`. Bei 4–6 GB RAM hat Phi-4 Mini 3.8B den höchsten HumanEval-Wert der hier genannten Modelle (70 % bei 2,5 GB RAM).
Welches Modell sollte ich für nicht-englische Sprachen verwenden?
Qwen3 8B unterstützt nativ 29+ Sprachen, darunter Chinesisch, Japanisch, Koreanisch, Arabisch und alle wichtigen europäischen Sprachen. Laut Community-Berichten benötigt sein Tokenizer bei nicht-englischen Texten tendenziell weniger Tokens als der von Llama; die Ergebnisse variieren je nach Text.
Sind diese Modelle sicher für die Verwendung mit privaten Daten?
Die Inferenz läuft auf Ihrer eigenen Hardware, daher werden Prompts nicht an eine Cloud-API gesendet; Ollama kann für Modell-Downloads und Update-Prüfungen weiterhin das Netzwerk nutzen, sofern Sie dies nicht deaktivieren. Bei sensiblen Daten vermeidet das die Weitergabe von Prompts an einen Cloud-Anbieter, ist aber keine Compliance-Garantie.
Muss ich bei der Verwendung lokaler LLMs die DSGVO beachten?
Lokale Inferenz via Ollama sendet Prompts nicht an einen externen Cloud-Anbieter, wodurch sich die Frage nach einer Auftragsverarbeitung (Art. 28 DSGVO) für die Inferenzebene verringern kann; ob Ihre Verarbeitung insgesamt DSGVO-konform ist, hängt von Rechtsgrundlage, technischen und organisatorischen Maßnahmen und Zweck ab. Es empfiehlt sich, Modellname, Version und Lizenz zu dokumentieren. Dies ist keine Rechtsberatung; fragen Sie im Zweifel Ihren Datenschutzbeauftragten. Für die sauberste EU-Herkunftsnarrative bietet Mistral AI (Frankreich) Apache-2.0-lizenzierte Modelle, wobei die aktuellen Mistral-Small-Versionen (24B+) weit über dem RAM-Bereich dieser Seite liegen. Für regulierte EU-Sektoren wie Gesundheitswesen und Finanzdienstleistungen sind Llama 3.1 8B und Qwen3 8B in diesem 4–8-GB-Bereich die praktikableren Empfehlungen.
Ist der Einsatz lokaler LLMs für den deutschen Mittelstand geeignet?
Ja – lokale LLMs via Ollama können für KMU mit sensiblen Geschäftsdaten eine Option sein. Kein Datentransfer an Cloud-APIs kann einzelne Compliance-Fragen vereinfachen (z. B. Auftragsverarbeitung für die Inferenzebene); die Gesamtbewertung hängt von Ihrer Verarbeitung ab. Niedrigere laufende Kosten sind möglich, hängen aber von Hardware und Nutzung ab. Für den Mittelstand empfiehlt sich Llama 3.1 8B für allgemeines englisches Reasoning oder Qwen3 8B für mehrsprachige und Coding-Workflows. Lokal ausgeführte, versionierte Modelle können die Dokumentation im Rahmen von IT-Sicherheitskonzepten (z. B. nach BSI IT-Grundschutz) erleichtern; sie ersetzen keine eigene Prüfung. Dies ist keine Rechtsberatung.
Wie lange dauert das Herunterladen dieser Modelle?
Bei einer 100-Mbit/s-Verbindung: Llama 3.2 1B (1,3 GB) ~2 Minuten. Gemma 4 E2B (1,6 GB) ~2 Minuten. Llama 3.2 3B (2 GB) ~3 Minuten. Phi-4 Mini (2,3 GB) ~3 Minuten. Llama 3.1 8B (~5 GB) und Qwen3 8B (~5,2 GB) je ~6–7 Minuten. Modelle werden nach dem ersten Download zwischengespeichert – nachfolgende Starts beginnen in Sekunden.
Kann ich mehrere Modelle auf derselben Maschine betreiben?
Ja – alle fünf können gleichzeitig auf der Festplatte koexistieren. Planen Sie 15–20 GB ein, wenn Sie alle fünf installieren. Ollama lädt jeweils ein Modell und entlädt es nach 5 Minuten Inaktivität.
Quellen
- Meta AI. (2024). „Llama 3.2 Model Card." llama.meta.com/ – Offizielle Spezifikationen und Benchmarks für Llama 3.2 3B und 1B-Modelle.
- Microsoft. (2025). „Phi-4 Mini Technical Report." huggingface.co/microsoft/Phi-4-mini-instruct – Benchmark-Daten für Phi-4 Mini (68 % MMLU, 70 % HumanEval).
- Google DeepMind. (2025). „Gemma Documentation." ai.google.dev/gemma/docs/core – Spezifikationen und Leistung für Gemma 4 E2B, einschließlich 128K-Kontextfenster-Upgrade.
- Ollama. (2026). „Ollama Model Library." ollama.com/library – Kanonische Quelle für Ollama-Modell-Tags, Größen und Pull-Befehle.
- Mistral AI. (2024). „Mistral 7B Release Notes." mistral.ai/news/announcing-mistral-7b/ – Technische Spezifikationen und Apache-2.0-Lizenzdetails für das in den Häufigen Fehlern erwähnte Legacy-7B-Modell.
- Alibaba Qwen Team. (2025). „Qwen3 Technical Report." arXiv:2505.09388. arxiv.org/abs/2505.09388 – Mehrsprachige Benchmark-Daten und Architekturdetails für Qwen3 8B.
- Meta AI. (2025). „Llama 3.1 Model Card." llama.meta.com/ – Offizielle Spezifikationen und Benchmarks für Llama 3.1 8B.