Es gibt kein „bestes" KI-Modell — wählen Sie nach Aufgabe
📍 In One Sentence
Führende Modelle unterscheiden sich heute weniger in der reinen Leistungsfähigkeit als darin, wo ihre Stärken liegen; sinnvoll ist daher die Frage, welches Modell zur Aufgabe passt, nicht welches insgesamt am höchsten rangiert.
💬 In Plain Terms
Zu fragen, welches Modell das beste sei, ist wie zu fragen, welches Fahrzeug das beste sei. Die ehrliche Antwort lautet: Was transportieren Sie, und wie weit? Benchmarks beschreiben einen Durchschnitt — Ihre Arbeit ist ein konkreter Auftrag, den keine Rangliste sieht.
Kein einzelnes KI-Modell ist für jede Aufgabe das beste. GPT-6 Astra eignet sich gut für Tool-Integration und Reasoning; Claude Opus 5.5 wird oft für Text- und Code-Qualität bevorzugt; Gemini 4 Argon verbindet ein 1M-Token-Kontextfenster mit tiefer Google-Workspace-Integration; DeepSeek und Baidu ERNIE sind für Workloads in Festlandchina unverzichtbar.
Bei einer neuen Aufgabe lautet die erste Frage nicht „Welches Modell ist das beste?", sondern „Welches Modell ist das beste für DIESE Aufgabe, in DIESER Region, mit DIESEM Budget?" Benchmarks und Ranglisten verschieben sich alle paar Monate. Ihre konkrete Aufgabe — Ihr Schreibstil, Ihre Codebasis, Ihre Kunden in China, Ihre Datensensibilität — sollte die Wahl bestimmen.
PromptQuorum ist ein Multi-Modell-KI-Dispatch-Tool, das genau das löst: Senden Sie einen strukturierten Prompt gleichzeitig an GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, DeepSeek, Baidu ERNIE und lokale LLMs (Ollama, LM Studio). Sehen Sie alle Antworten nebeneinander. Lassen Sie PromptQuorum bewerten, welches Modell für IHRE Aufgabe, IHRE Daten und IHRE Markensprache am besten abschneidet — nicht für ein YouTube-Benchmark.
Schnelle Entscheidungsmatrix — Ihr Startmodell
Wählen Sie Ihr Startmodell nach Ihrer Hauptaufgabe. Die meisten Teams nutzen mehrere Modelle — beginnen Sie mit dem richtigen und wechseln Sie bei Bedarf.
- GPT-6 Astra gewinnt: Multi-Agenten-Workflows, Tool-Integration, API-Ökosystem, Multimodalität (Bilder/Audio). Starten Sie hier, wenn Integrationen zählen.
- Claude Opus 5.5 gewinnt: Textqualität, Code-Review, Reasoning-Tiefe, Enterprise-Sicherheit. Starten Sie hier für Content- und Code-Qualität.
- Gemini 4 Argon gewinnt: lange Dokumente (1M Tokens), Batch-Verarbeitung, Google Workspace. Starten Sie hier für großflächige Dokumentenanalyse.
- DeepSeek/Baidu ERNIE gewinnt: Festlandchina (Pflicht für Latenz und Zugang), kostensensitive Aufgaben mit hohem Volumen. Einzige Option, wenn Daten in China bleiben.
- Testen Sie alle 5 mit PromptQuorum an Ihrer echten Aufgabe — Benchmarks täuschen; Ihre Daten sagen die Wahrheit.
Ihre Priorität | Starten Sie mit | Warum | Wann wechseln |
|---|---|---|---|
| Anspruchsvolle Texte & Analysen | Claude Opus 5.5 | Höchste Ausgabequalität; spart Überarbeitungsrunden | Zu GPT-6 Astra, wenn Sie Multi-Tool-Workflows oder Integrationen brauchen |
| Programmieren & Entwicklungstempo | Gemini 4 Argon oder Flash | 1M Kontext (ganze Projekte); niedriger Einführungspreis | Zu Claude für tiefes Debugging oder Code-Review; zu GPT für Tool-Integration |
| Multi-Agenten-Workflows / APIs | GPT-6 Astra | Größtes Drittanbieter-Ökosystem; bestes Tool-Calling | Zu Gemini, um bei hohem Volumen Kosten zu sparen |
| Nutzer/Daten in Festlandchina | DeepSeek-V4 oder Baidu ERNIE | Einzig praktikable Wahl — westliche Modelle eingeschränkt/langsam | Entfällt — Compliance und Latenz lassen keinen Wechsel zu |
Schnelle Fakten
Auf einen Blick — die wichtigsten Zahlen vorab:
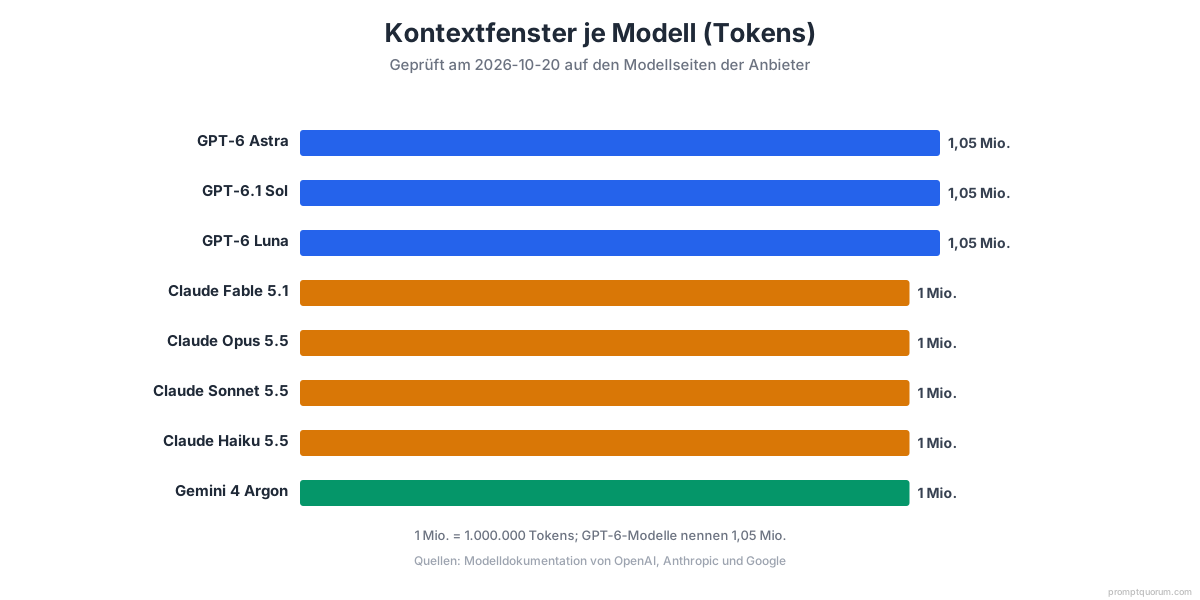
- Kontextfenster: GPT-6 Astra (ca. 1,05M), Claude Opus 5.5 (1M), Gemini 4 Argon (1M) — alle drei ungefähr gleichauf
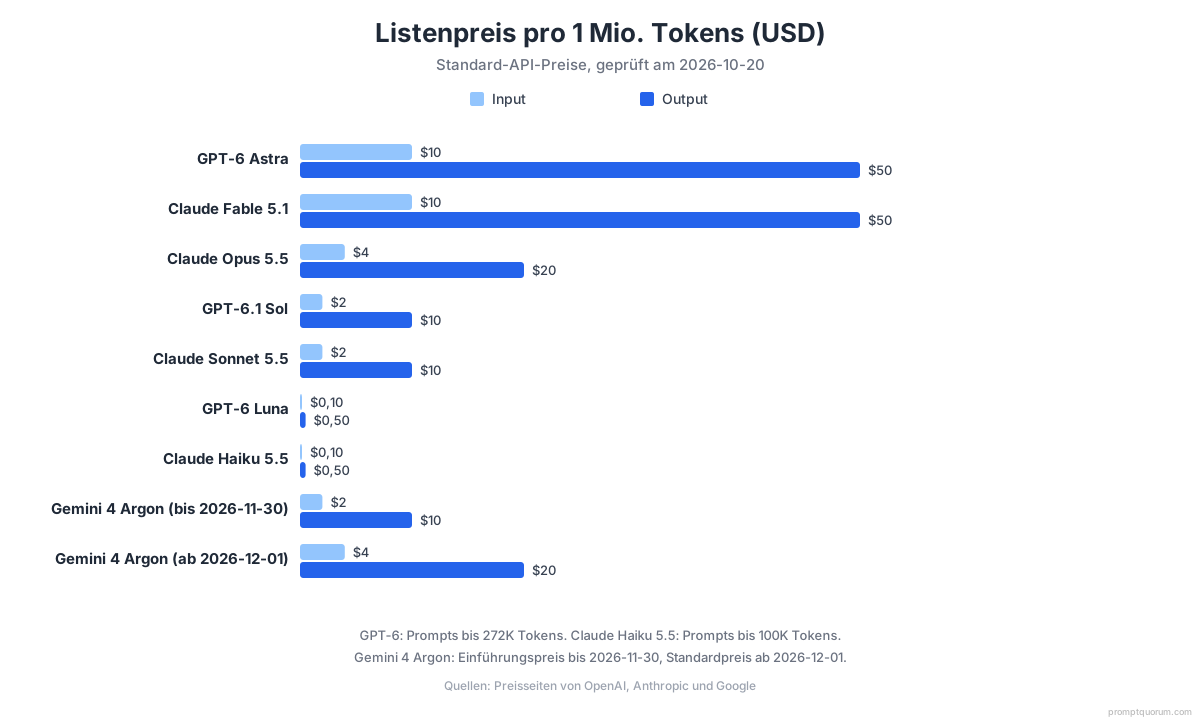
- Preise (pro 1M Tokens, Input/Output): GPT-6 Astra $10/$50, Claude Opus 5.5 $4/$20, Gemini 4 Argon $2/$10 bis 2026-11-30 (ab 2026-12-01 $4/$20)
- Oft für Texte bevorzugt: Claude Opus 5.5 — prägnant und strukturiert (Anthropic empfiehlt Claude Fable 5.1 für anspruchsvolles Reasoning und langfristige agentische Arbeit)
- Tool-Integration: GPT-6 Astra — sehr großes Drittanbieter-Ökosystem
- Niedrigster Flaggschiff-Listenpreis (befristet): Gemini 4 Argon mit $2/$10 bis 2026-11-30, danach $4/$20 wie Claude Opus 5.5; Gemini 3.8 Flash ($0,75/$3,75 bis 2026-12-31, danach $1,50/$7,50) oder GPT-6 Luna ($0,10/$0,50) für hohe Volumina
- Pflicht für China: DeepSeek oder Baidu ERNIE — westliche Modelle eingeschränkt oder mit hoher Latenz
- Privat/lokal: Ollama oder LM Studio — keine Cloud-API-Aufrufe für die Inferenz
Worauf kommt es bei der Modellwahl an?
Die Modellauswahl beginnt bei Ihrem Anwendungsfall und Ihren Rahmenbedingungen — nicht bei Hype oder Ranglistenplatz. Diese 7 Dimensionen sind tatsächlich entscheidend:
- Qualität für Ihre Aufgabe: Ist das Modell stark beim Schreiben, Programmieren, Analysieren oder Reasoning? Prüfen Sie die Leistung bei Aufgaben wie Ihren — nicht bei generischen Benchmarks.
- Kosten pro Token und Preisstufen: Frontier-Modelle kosten $2–50 pro Million Tokens; Budget-Modelle $0,10–3,75. Der Preis skaliert über Input- und Output-Tokens. Token-Ökonomie im Detail.
- Latenz und Rate Limits: Wie schnell antwortet das Modell? Verkraftet es Ihr Anfragevolumen? Manche Modelle sind bei 100 Anfragen pro Minute gedeckelt, andere schaffen 10.000+.
- Größe des Kontextfensters: GPT-6 Astra: ca. 1,05M Tokens. Claude Opus 5.5: 1M Tokens. Gemini 4 Argon: 1M Tokens (alle drei ungefähr gleichauf). Mehr zu Kontextfenstern.
- Multimodale Fähigkeiten: Verarbeitet das Modell Bilder, Audio oder Video? GPT-6 Astra und Gemini 4 Argon verarbeiten Bilder zuverlässig. DeepSeek und Baidu ERNIE sind auf Text ausgerichtet.
- Ökosystem und Integrationen: Wie viele Drittanbieter-Tools, Plug-ins und APIs unterstützen das Modell? GPT-6 Astra hat hier ein sehr großes Ökosystem. Lokale Modelle über Ollama oder LM Studio bringen Tausende Community-Integrationen mit.
- Region und Datenresidenz: Ist das Modell in Ihrer Region verfügbar? Müssen Ihre Daten im Land oder im Firmennetz bleiben? Festlandchina erfordert lokale Modelle (DeepSeek, Baidu ERNIE) wegen Vorschriften und Latenz.
Wann sollten Sie GPT-6 Astra verwenden?
GPT-6 Astra ist OpenAIs multimodales Frontier-Modell — gut geeignet für tool-lastige agentische Workflows und mit einem sehr großen Ökosystem an Drittanbieter-Integrationen. Verwenden Sie GPT-6 Astra, wenn Tooling, Integrationen und Multimodalität wichtiger sind als die Kosten.
- Stärken: Sehr gutes allgemeines Reasoning und Chat über alle Domänen. Starke Multimodalität — verarbeitet Bilder, Audio und teilweise Video zuverlässig. Ausgereiftes Tool-Calling-Ökosystem mit einer sehr großen Bibliothek an Drittanbieter-Integrationen. Breit im Produktiveinsatz.
- Beste Anwendungsfälle: Mehrstufige Agenten-Workflows. Komplexe Ketten, die Tool-Calling (APIs, Datenbanken, Codeausführung) erfordern. Aufgaben mit Screenshot- oder Bildanalyse. Projekte im OpenAI-Ökosystem (ChatGPT, Assistants API, Codex, Fine-Tuning).
- Kompromisse: Premium-Frontier-Modelle kosten mehr pro Token ($10 Input / $50 Output pro Million); GPT-6.1 Sol ($2 / $10) ist die günstigere Near-Astra-Option von OpenAI. Die Ausgaben können ausschweifend sein — das erfordert Prompt-Disziplin, um Kürze zu erzwingen.
- Kontextfenster: ca. 1.050.000 Tokens (entspricht etwa 800 Textseiten).
Wann sollten Sie Claude Opus 5.5 verwenden?
Claude Opus 5.5 von Anthropic eignet sich gut für sorgfältiges Reasoning, Textqualität und Code-Refactoring und wird mit Anthropics Constitutional-AI-Ansatz für Sicherheit trainiert. Verwenden Sie Claude, wenn Ausgabequalität, Klarheit und Verlässlichkeit im Vordergrund stehen.
- Stärken: Hochwertige Texte und Zusammenfassungen; die Ausgaben sind prägnant, gut strukturiert und publikationsreif. Sehr gutes Codeverständnis, Refactoring und Erklärungen — hilft oft, Fehler zu finden. Solide Handhabung langer Kontexte für Recherche- und Dokumenten-Workflows. Sicherheitsorientierter Trainingsansatz, den manche Teams in regulierten Branchen schätzen.
- Beste Anwendungsfälle: Berichte, Analysen und Wissensarbeit, bei denen Struktur und Klarheit entscheidend sind. Komplexe Codebasen und Architekturdiskussionen. Enterprise-Umgebungen mit Compliance- und Sicherheitsanforderungen. Inhalte, die möglichst wenig Nachbearbeitung erfordern sollen.
- Kompromisse: Höherer Preis in den Top-Stufen; für einfache Aufgaben oft überdimensioniert. Manche Drittanbieter-Integrationen sind jünger als die GPT-6 Astra-Pendants.
- Weitergedacht: Anthropic bietet zusätzlich Claude Fable 5.1 ($10 Input / $50 Output pro Million Tokens) für anspruchsvolles Reasoning und langfristige agentische Arbeit an. Anthropic empfiehlt, mit Opus 5.5 zu beginnen und zu Fable 5.1 zu wechseln, wenn Ihre Evals mit Opus 5.5 bei höherem Aufwand weiterhin nicht ausreichen.
- Kontextfenster: 1.000.000 Tokens (entspricht etwa 800 Textseiten).
Wann sollten Sie Gemini 4 Argon verwenden?
Gemini 4 Argon von Google DeepMind ist Googles Flaggschiff für Reasoning, mit 1M-Token-Kontextfenster und tiefer Google-Workspace-Integration; der Preis von $2/$10 ist ein Einführungspreis (bis 2026-11-30, danach $4/$20). Verwenden Sie Gemini, wenn Sie viele lange Dokumente verarbeiten oder Ihr Team in Google Workspace arbeitet.
- Stärken: Sehr gute Coding-Leistung zu attraktiven Preisen — besonders die Flash-Modelle der Mittelklasse. Starker langer Kontext (1M Tokens) und Retrieval; hervorragend für Recherche über viele Dokumente plus Live-Websuche. Native Integration in Google Workspace (Docs, Sheets, Drive, Gmail, Slides).
- Beste Anwendungsfälle: Teams, die in Google Workspace arbeiten. Batch-Coding und Datenaufgaben, bei denen das Preis-Leistungs-Verhältnis entscheidet. Recherche-Workflows, die lokale Dokumente mit Websuche verbinden. Verarbeitung von 100+ Seiten PDFs oder Transkripten.
- Kompromisse: Der Schreibstil wirkt gegenüber Claude oder GPT eher zurückhaltend oder generisch. Außerhalb des Google-Ökosystems hinken manche Integrationen hinterher.
- Kontextfenster: 1.000.000 Tokens (entspricht etwa 800 Textseiten).
Welches KI-Modell eignet sich 2026 am besten zum Programmieren?
Claude Opus 5.5 wird oft für Code-Qualität und Refactoring bevorzugt; GPT-6 Astra eignet sich gut für Tool-Integration und Reasoning über mehrere Dateien; Gemini 4 Argon hat den niedrigsten Flaggschiff-Listenpreis, solange der Einführungspreis gilt; DeepSeek ist die Wahl für Entwickler in Festlandchina. Das „beste" Modell zum Programmieren hängt von Ihrer Hauptherausforderung ab: Code-Qualität, Integrationsbreite, Kosten pro Token oder Region.
- GPT-6 Astra: Stark bei mehrstufigen Coding-Aufgaben mit Tool-Nutzung (Dateisystemzugriff, APIs, Shell-Befehle). Sehr gut im Reasoning über große Codebasen und beim Erzeugen komplexer Workflows. Erste Wahl, wenn Integrationen mit GitHub, AWS oder APIs entscheidend sind.
- Claude Opus 5.5: Am besten für Code-Review, Refactoring und Architekturdiskussionen. Oft hilfreich, um subtile Fehler zu finden. Bevorzugt für die Pflege bestehender Codebasen und das Erklären von Legacy-Code. Höhere Token-Kosten, dafür meist weniger Nachfrage-Runden.
- Gemini 4 Argon: Attraktiver Listenpreis für Batch-Coding, solange der Einführungspreis gilt (Datenverarbeitung, Hilfsskripte, Automatisierung). 1M Kontext bedeutet, dass Sie ganze Projekte auf einmal laden können. Ideal für Tempo vom Prototyp zur Produktion, wenn Kosten zählen.
- DeepSeek-V4: Beim Programmieren als kostengünstigere Alternative positioniert. Am besten für Entwickler in Festlandchina und Coding-Aufgaben mit hohem Volumen (Gerüstcode, Boilerplate, Routine-Refactoring). Sehr stark bei Algorithmenaufgaben und Wettbewerbsprogrammierung.
Bestes LLM für langen Kontext und große Dokumente 2026?
Alle drei Frontier-Modelle unterstützen 1M Kontext-Tokens (etwa 800 Seiten). Der Rückstand beim langen Kontext ist aufgeholt. Für Aufgaben jenseits von 1M Tokens kommen lokale Modelle wie Llama 4 Scout (10M Tokens) infrage. Entscheiden Sie nach Kosten, Retrieval-Präzision und der Frage, ob Sie mehrere Dateien gleichzeitig laden müssen.
- Gemini 4 Argon (1M Tokens): Laden Sie ganze Codebasen, Vertragssammlungen oder Rechercheeaarchive. Die Websuche-Integration erlaubt Verweise auf externe Quellen innerhalb des langen Kontexts. Am besten für: Due-Diligence-Prüfungen, regulatorische Analysen, Wissensdatenbank-Suche, PDFs mit 100+ Seiten.
- Claude Opus 5.5 (1M Tokens): Sehr gut für detaillierte Analysen und das Herausarbeiten feiner Nuancen aus langen Dokumenten. Kompromiss: höchste Kosten pro Token, dafür oft weniger Überarbeitungsrunden.
- GPT-6 Astra (~1,05M Tokens): Stark bei mehrstufigem Reasoning über lange Dokumente. Erste Wahl, wenn Sie Tool-Calling zusätzlich zum langen Kontext brauchen (Dateisystem, APIs).
- Praktische Strategie: Alle drei unterstützen jetzt gleichermaßen 1M Tokens. Entscheiden Sie nach Kosten, Ausgabequalität für Ihre Aufgabe oder Tool-Ökosystem.
Wie wählen Sie ein KI-Modell, wenn Sie in China sind oder niedrige Latenz brauchen?
Für Nutzer und Daten in Festlandchina sind DeepSeek und Baidu ERNIE in der Regel die praktische Wahl. Westliche Frontier-Modelle (GPT-6 Astra, Claude, Gemini) sind in China wegen Netzsperren und regulatorischer Vorgaben häufig eingeschränkt oder langsam. Latenz und Compliance (Datenresidenz, Inhaltsmoderation) sind große Schmerzpunkte. Ein westliches Modell in Festlandchina kann bedeuten: nicht verfügbarer Dienst, hohe Latenz für Nutzer oder regulatorische Risiken. In Festlandchina gehostete Modelle vermeiden die meisten dieser Probleme; aktuelle Vorgaben sollten Sie rechtlich prüfen lassen.
DeepSeek (Frontier-Modell, starkes Programmieren): Konkurrenzfähige Coding- und Reasoning-Leistung, niedrige Preise, sehr gute Unterstützung für Chinesisch und gemischte chinesisch-englische Aufgaben. Gehostet auf Infrastruktur in Festlandchina, daher in der Regel geringe Netzwerklatenz. Am besten für Entwickler-Workflows in Festlandchina und kostensensitive Workloads mit hohem Volumen. Kompromisse: kleineres Ökosystem außerhalb Chinas, weniger Drittanbieter-Integrationen als GPT/Claude/Gemini.
Baidu ERNIE (Enterprise und Consumer): Enge Anbindung an Baidu-Suche und -Cloud, starke Verankerung in chinesischen Webinhalten und Unternehmensdaten. Auf den regulatorischen Rahmen Festlandchinas ausgelegt (Inhaltsmoderation, Datenresidenz, Keyword-Filterung); die Compliance-Pflichten bleiben beim einsetzenden Unternehmen. Am besten für Consumer- und Enterprise-Anwendungen mit chinesischer Zielgruppe sowie für Anwendungen auf Baidu-Cloud-Infrastruktur, wo Compliance nicht verhandelbar ist. Kompromisse: primär auf Chinesisch optimiert; Englisch und andere Sprachen können hinter westlichen Frontier-Modellen zurückbleiben.
GPT-6 Astra vs Claude Opus 5.5 vs Gemini 4 Argon: Vergleich im Überblick
Diese Tabelle vergleicht 5 KI-Modelle über 8 Dimensionen: allgemeines Reasoning, Textqualität, Programmieren, langer Kontext, Multimodalität, Kosteneffizienz, globales Ökosystem und China-Zugang.
Dimension | GPT-6 Astra | Claude Opus 5.5 | Gemini 4 Argon | DeepSeek | Baidu ERNIE |
|---|---|---|---|---|---|
| Allgemeine Fragen | Sehr stark global | Sehr gut, vorsichtig | Sehr gut + Retrieval | Stark, führend in CN | Stark, führend in CN |
| Textqualität | Gut, teils ausschweifend | Beste Struktur & Klarheit | Gut, neutraler Ton | Gut, Chinesisch zuerst | Gut, Chinesisch zuerst |
| Programmieren | Stark | Sehr stark, Premium | Stark; niedriger Einführungspreis | Sehr stark für CN-Devs | Gut, Business-Praxis |
| Langer Kontext | Stark (~1,05M) | Stark (1M) | Stark (1M) + Web | Gut | Gut mit Baidu-Daten |
| Multimodal | Führend (Bild/Audio) | Gute Bildanalyse | Sehr stark (Video/Web) | Unterschiedlich | Text + CN-Web |
| Kosteneffizienz | $10/$50 (höchster) | $4/$20 | $2/$10 bis 2026-11-30, dann $4/$20 | Sehr preisgünstig | Günstig (CN-Enterprise) |
| Globales Ökosystem | Am umfangreichsten | Wachsend, v. a. Enterprise | Stark in der Google-Welt | Außerhalb Chinas begrenzt | Stark im Baidu-Ökosystem |
| China-Zugang/Latenz | Oft eingeschränkt | Oft eingeschränkt | Oft eingeschränkt | Nativ / niedrige Latenz | Nativ / erforderlich |
Wie wählen Sie das richtige KI-Modell aus?
Beginnen Sie beim Hauptanwendungsfall, ergänzen Sie Ihre Rahmenbedingungen und wählen Sie dann das Modell, das zu beidem passt.
Wenn: allgemeiner Assistent, agentische Multi-Tool-Workflows. Dann: Beginnen Sie mit GPT-6 Astra. Sie brauchen das umfangreichste Tooling und die meisten Integrationen.
Wenn: anspruchsvolle Texte, Analysen, komplexer Code oder hohe Sicherheitsanforderungen. Dann: Beginnen Sie mit Claude Opus 5.5. Qualität und Verlässlichkeit wiegen schwerer als die Kosten.
Wenn: intensive Google-Workspace-Nutzung, Batch-Coding/Daten oder 100+ lange Dokumente. Dann: Beginnen Sie mit Gemini 4 Argon. Langer Kontext und Ökosystem-Anbindung sparen Zeit.
Wenn: Nutzer und Daten überwiegend in Festlandchina. Dann: Beginnen Sie mit DeepSeek (coding-lastig) oder Baidu ERNIE (Consumer-/Business-Apps). Westliche Modelle sind eingeschränkt oder langsam.
- Knappes Budget, hohes Volumen: Gemini Flash / DeepSeek / kleinere GPT-Modelle bevorzugen.
- Strenge Compliance, Enterprise-Verträge: Claude Enterprise, für China Baidu ERNIE.
- Multimodalität nötig (Screenshots, Diagramme, Audio): GPT-6 Astra oder Gemini 4 Argon.
- Ausschließlich private Daten: Lokale LLMs über Ollama oder LM Studio (Prompts werden nicht an eine Cloud-API gesendet).
Wie vergleichen sich Kosten und Token-Limits?
Alle großen Modelle werden pro Input- und Output-Token abgerechnet, die Rate Limits richten sich nach Ihrer Stufe. Frontier-Modelle kosten pro Token 10–100× mehr als Budget-Modelle. Die Preise variieren je nach Region (besonders in China).
- Frontier-Modelle (teuerste pro Token): GPT-6 Astra ($10 Input / $50 Output pro Million Tokens), Claude Opus 5.5 ($4 Input / $20 Output pro Million Tokens), Claude Fable 5.1 ($10 Input / $50 Output pro Million Tokens).
- Günstigeres Flaggschiff (befristet): Gemini 4 Argon ($2 Input / $10 Output pro Million Tokens bis 2026-11-30, danach $4 / $20 ab 2026-12-01, gleich Claude Opus 5.5) — solange der Einführungspreis gilt, das günstigste der drei Flaggschiffe.
- Kosteneffiziente Mittelklasse: GPT-6.1 Sol ($2 Input / $10 Output), Gemini 3.8 Flash ($0,75 Input / $3,75 Output pro Million Tokens bis 2026-12-31, danach $1,50 / $7,50) und GPT-6 Luna ($0,10 Input / $0,50 Output). Darunter liegt Gemini 3.5 Flash-Lite als Effizienzstufe.
- Preisgünstige Alternativen: DeepSeek-V4 (niedrige Preise), lokale Modelle über Ollama/LM Studio (kostenlos, laufen auf Ihrer Hardware).
- Rate Limits: Frontier-Modelle starten oft bei 100 Anfragen/Minute; skalierte Stufen erreichen 10.000+ Anfragen/Minute. Bei lokalen Modellen entscheidet Ihre Hardware.
- Mehr zu Kontextfenstern und ihrer Rolle bei der Modellwahl.
Warum 2026 mehrere KI-Modelle statt nur eines?
Benchmarks und Ranglisten ändern sich alle paar Monate. Unterschiedliche Aufgaben werden von unterschiedlichen Modellen am besten bedient. Und geografische Vorgaben (EU-Datenresidenz, China-Latenz) erzwingen Multi-Modell-Stacks.
- Grund 1: aufgabenspezifische Stärke. Kein Modell gewinnt überall. Claude wird oft für Texte bevorzugt, Gemini für Recherche mit langem Kontext, GPT für mehrstufiges Reasoning. Leiten Sie jede Aufgabe an den Spezialisten.
- Grund 2: Kostenoptimierung. Nutzen Sie kleine bzw. günstige Modelle für wiederkehrende Massenaufgaben (Zusammenfassen, Kategorisieren). Reservieren Sie Frontier-Modelle für komplexes Reasoning. Günstige Stufen kosten nur einen Bruchteil der Frontier-Preise; wer geeignete Aufgaben dorthin leitet, kann die Kosten deutlich senken und die Qualität dort halten, wo sie zählt.
- Grund 3: regulatorische und geografische Vorgaben. Die EU verlangt EU-Datenresidenz (lokal per Ollama). China verlangt lokale Modelle. Multi-Modell-Stacks erfüllen alle Vorgaben gleichzeitig.
- Beispiel-Stack: Claude für Texte, Gemini für Code, GPT für Agenten, DeepSeek/ERNIE für China-Nutzer. Das ist nicht kompliziert — sondern praktisch.
Wie hilft PromptQuorum beim Vergleichen und Routen von Modellen?
PromptQuorum löst das Problem des manuellen Modellwechsels: Ein strukturierter Prompt geht gleichzeitig an alle Modelle, die Ergebnisse werden automatisch verglichen. Kein Kopieren zwischen Tabs mehr und kein Raten, welches Modell am besten abgeschnitten hat.
- Ein strukturierter Prompt → viele Modelle gleichzeitig. Schreiben Sie Ihren Prompt einmal. PromptQuorum verteilt ihn parallel an GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, DeepSeek, Baidu ERNIE und lokale LLMs (Ollama, LM Studio). Alle Antworten stehen nebeneinander.
- Gemeinsame Vorlagen sorgen für faire Vergleiche. Gleiche Prompt-Struktur, gleiche Vorgaben, gleiche Formate über alle Modelle. Das entkräftet den Einwand „Claude war besser, weil der Prompt für Claude geschrieben war".
- Konsens- und Bewertungsansicht. PromptQuorum zeigt Ihnen, welches Modell in Ihrer Markensprache am besten schreibt, welches den korrektesten Code liefert, welches Ihre internen Dokumente am zuverlässigsten verarbeitet und welches für IHRE Aufgabe am schnellsten und günstigsten ist.
- Routing-Regeln: Günstige Massenaufgaben an kleine oder lokale Modelle, komplexes Reasoning an Premium-Modelle. Die Modellauswahl läuft automatisch nach Aufgabentyp.
- Unterstützung lokaler LLMs. Binden Sie Ollama oder LM Studio für vollständig lokale Inferenz ein. Prompts werden nicht an eine Cloud-API gesendet; prüfen Sie dennoch die Update- und Telemetrie-Einstellungen des Tools. Sensible Aufgaben laufen lokal, Standardaufgaben über Cloud-APIs.
- Schluss mit dem Raten anhand von YouTube-Benchmarks. Testen Sie Ihre eigenen Aufgaben an Ihren eigenen Daten. Nur das zählt.
Das PromptQuorum-Dashboard: alle Modelle auf einen Blick
Ein Prompt, und Sie sehen die Ausgaben von GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, DeepSeek und Baidu ERNIE in einer Ansicht. Der direkte Vergleich erspart Ihnen das manuelle Wechseln zwischen Modellen.
Praktische Rezepte: 4 Wege, PromptQuorum zum Modellvergleich zu nutzen
Multi-Modell-Tests in PromptQuorum zeigen, welches Modell für IHRE konkrete Aufgabe, IHRE Daten und IHRE Marke am besten funktioniert — nicht für generische Benchmarks. Hier sind 4 konkrete Szenarien:
Rezept 1: Herausfinden, welches Modell in Ihrer Markensprache am besten schreibt
Sie schreiben Produkttexte für eine B2B-SaaS-Landingpage. Der Ton soll fundiert, aber zugänglich sein — kein Marketing-Geschwurbel, keine vagen Superlative. Testen Sie dasselbe Briefing mit GPT-6 Astra, Claude Opus 5.5 und Gemini. Welches Modell trifft Ihre Markensprache am besten? Lassen Sie es durch PromptQuorum laufen und bewerten Sie jede Ausgabe nach Ton, Klarheit und Einhaltung Ihrer Markenrichtlinien. Der Sieger wird Ihr Standardmodell für Texte. Beispiel-Prompt: „Schreiben Sie diese Feature-Beschreibung in unserer Markensprache um: Styleguide + bestehender Text einfügen. Welches Modell passt am besten?"
Rezept 2: Code-Qualität und Kosten für Ihren Backend-Stack vergleichen
Sie haben eine Python-Codebasis. Test: „Prüfen Sie diese Funktion auf Performance und Fehler. Schlagen Sie ein Refactoring vor." Lassen Sie das durch GPT-6 Astra, Claude Opus 5.5 und Gemini 3.8 Flash laufen. Welches Modell findet die meisten Fehler? Welches Refactoring ist am saubersten? Welches ist pro Anfrage am günstigsten? Bewerten Sie die Code-Qualität in PromptQuorum. Gemini 3.8 Flash kostet pro Token laut Listenpreis etwa ein Fünftel von Claude Opus 5.5 ($0,75/$3,75 gegenüber $4/$20); prüfen Sie, ob es für Ihren Anwendungsfall genug Probleme findet. Beispiel: „Optimieren Sie diese Datenbankabfrage auf Geschwindigkeit. Wie ist die Zeitkomplexität?" — an Claude für die tiefe Analyse, an Gemini für budgetbewusstes Iterieren.
Rezept 3: Globalen Stack plus China-Stack aufsetzen (GPT / Claude / Gemini + DeepSeek / ERNIE)
Ihr Produkt bedient Nutzer weltweit und in Festlandchina. Leiten Sie globale Nutzer auf GPT, Claude oder Gemini (Ihren globalen Stack). Leiten Sie China-Nutzer auf DeepSeek oder Baidu ERNIE (Pflicht für Latenz und Compliance). Prüfen Sie mit PromptQuorum die Modellleistung an Ihren echten Nutzer-Prompts in jeder Region. So bleibt die Qualität konsistent, ohne regionale Vorgaben zu verletzen.
Rezept 4: Lokale LLMs für private Daten, Frontier-Modelle für den Feinschliff
Sie haben sensible Kundendaten. Schritt 1: lokal mit Ollama oder LM Studio verarbeiten (Prompts werden nicht an eine Cloud-API gesendet). Schritt 2: das bereinigte Ergebnis an Claude oder GPT für Feinschliff und Qualitätsprüfung senden. Dieser hybride Ansatz ist günstig, datenschutzfreundlich und liefert hohe Qualität. Testen Sie ihn in PromptQuorum, um das lokale Modell zu finden, das für Ihre Pipeline am besten funktioniert.
So wählen Sie ein KI-Modell für Ihre Aufgabe
- 1Bestimmen Sie den Aufgabentyp: Geht es um Fakten und Analyse (Rechtsanalyse, Code-Review, Datenextraktion) oder um Kreatives (Brainstorming, Copywriting, Ideenfindung)? Faktische Aufgaben sprechen für GPT-6 Astra oder Claude Opus 5.5; kreative Aufgaben funktionieren bei allen Frontier-Modellen.
- 2Wägen Sie Geschwindigkeit gegen Kosten ab: GPT-6 Astra ist der breiteste Allrounder, aber nicht der günstigste. Claude Opus 5.5 eignet sich gut für langes Reasoning und Genauigkeit. Gemini 4 Argon hat den niedrigsten Flaggschiff-Listenpreis, solange der Einführungspreis gilt, und bietet multimodale Eingaben mit 1M-Token-Kontextfenster; Gemini 3.8 Flash, GPT-6.1 Sol und GPT-6 Luna sind günstigere Stufen. Vergleichen Sie alle drei mit PromptQuorum an Ihrem konkreten Prompt.
- 3Starten Sie mit einem Frontier-Modell (GPT-6.1 Sol, Claude Opus 5.5 oder Gemini 4 Argon) und stufen Sie dann ab: Eine Aufgabe, die auf GPT-6.1 Sol gut läuft, läuft womöglich genauso gut auf GPT-6 Luna (rund 20× günstiger). Testen Sie Ihren Prompt auf günstigeren Modellen, sobald eine funktionierende Version steht.
- 4Für lokale/private Workflows Ollama oder LM Studio nutzen — mit Abstrichen bei der Qualität: Lokale Modelle verarbeiten private Daten ohne externe API-Aufrufe, erreichen aber nicht die Genauigkeit der Frontier-Modelle. Nutzen Sie einen Hybrid: lokales Modell für den ersten Durchlauf, Frontier-Modell für die Qualitätsprüfung.
- 5Bei geografisch verteilten Nutzern nach Region routen: Globale Nutzer (USA, EU, Japan) → GPT-6 Astra / Claude / Gemini. China → DeepSeek oder Baidu ERNIE (regulatorische Vorgabe). Testen Sie jede Region mit PromptQuorum separat.
- 6Testen Sie alle drei (oder mehr) mit PromptQuorum, bevor Sie sich festlegen: Senden Sie Ihren Prompt gleichzeitig an GPT-6 Astra, Claude Opus 5.5 und Gemini 4 Argon. Der Vergleich zeigt, welches Modell am besten zu Ihrer Aufgabe passt.
Häufige Fehler bei der Wahl eines KI-Modells
❌ Nach Benchmark-Ranglisten statt nach der eigenen Aufgabe auswählen
Why it hurts: Die Platzierungen in der LMSYS Arena und in HumanEval-Ranglisten verschieben sich monatlich. Ein Modell, das bei MMLU führt, kann bei Ihrer konkreten Coding-, Schreib- oder Analyseaufgabe zurückfallen.
Fix: Testen Sie Ihre echten Prompts auf 2–3 Modellen, bevor Sie sich festlegen. Vergleichen Sie mit PromptQuorum an IHREN Daten.
❌ Annehmen, ein großes Kontextfenster bedeute automatisch Qualität bei langen Dokumenten
Why it hurts: Alle drei Frontier-Modelle unterstützen 1M Tokens — beim Kontextfenster herrscht Gleichstand. Ein gefülltes 1M-Kontextfenster heißt aber nicht, dass das Modell alles davon gut nutzt. Durch das „Lost in the Middle"-Problem können Informationen in der Mitte sehr langer Kontexte untergehen.
Fix: Zerlegen und verdichten Sie Dokumente ab etwa 200 Seiten, statt alles in einen Prompt zu kopieren — unabhängig von der Kontextfenstergröße. Für Dokumente jenseits von 1M Tokens kommen lokale Modelle wie Llama 4 Scout (10M) infrage.
❌ Für jede Aufgabe ein Frontier-Modell einsetzen
Why it hurts: GPT-6 Astra kostet mit $10/$50 pro Million Tokens rund 13× so viel wie Gemini 3.8 Flash mit $0,75/$3,75 (bis 2026-12-31). Viele Klassifikations-, Extraktions- und Zusammenfassungsaufgaben liefern auf günstigeren Modellen vergleichbare Qualität.
Fix: Beginnen Sie mit dem günstigsten Modell. Steigen Sie erst dann auf ein Frontier-Modell um, wenn das günstigere bei Ihrer Aufgabe messbar scheitert.
❌ Region und Datenresidenz ignorieren
Why it hurts: Personenbezogene EU-Daten an US-APIs zu senden erfordert Standardvertragsklauseln. Nutzer in Festlandchina über GPT/Claude zu bedienen kann spürbare Latenz verursachen und regulatorische Fragen aufwerfen.
Fix: Routen Sie nach Region. Sensible EU-Daten → lokale LLMs oder API-Endpunkte in der EU-Region. China → DeepSeek oder Baidu ERNIE. Global → beliebiges Frontier-Modell.
❌ Sich ohne Abstraktionsschicht auf das SDK eines Anbieters festlegen
Why it hurts: Wenn ein neues Modell erscheint — und das passiert alle paar Monate — können Sie nicht wechseln, ohne Ihre Integration neu zu schreiben.
Fix: Nutzen Sie anbieterunabhängige SDKs (LiteLLM, PromptQuorum) oder das OpenAI-kompatible API-Format, das auch Claude, Gemini und lokale Modelle unterstützen.
Häufig gestellte Fragen
Wenn ich nur ein Abonnement bezahlen kann — welches?
Beginnen Sie mit Claude Opus 5.5. Es liefert die höchste Qualität über Texte, Reasoning und Code hinweg. Wenn Ihr Hauptbedarf Tool-Integration und Multimodalität (Bilder/Audio) ist, wählen Sie GPT-6 Astra. Bei einem Google-Workspace-lastigen Team mit knappem Budget wählen Sie Gemini. Liegen Ihre Nutzer in Festlandchina, wählen Sie ein in Festlandchina gehostetes Modell wie DeepSeek oder Baidu ERNIE (meist notwendig wegen Latenz und Compliance).
Wie oft sollte ich meine Modellwahl überprüfen?
Quartalsweise. Alle 3–4 Monate erscheinen neue Modelle und die Rangfolge verschiebt sich. Testen Sie Ihre kritischsten Aufgaben mit PromptQuorum erneut auf den aktuellen Modellen. Was vor 6 Monaten am besten war, muss es heute nicht mehr sein.
Kann ich mehrere Modelle in einem Produkt oder Agenten kombinieren?
Ja — und Sie sollten es. Leiten Sie Aufgaben gezielt weiter: Claude für Texte, Gemini für Retrieval, GPT für Agenten. Nutzen Sie bedingte Logik: Handelt es sich um eine Schreibaufgabe, verwenden Sie Claude; bei einer Retrieval-Aufgabe Gemini. Genau so arbeiten Produktionssysteme.
Wie gehe ich mit Anbieterabhängigkeit um?
Anbieterabhängigkeit entsteht, wenn Ihr System vom API-Format, von Sonderfunktionen oder von der Preisgestaltung eines einzigen Modells abhängt. So schützen Sie sich: (1) Verwenden Sie Prompt-Strukturen, die über Modelle hinweg funktionieren. (2) Nutzen Sie Abstraktionsschichten (wie PromptQuorum), die mehrere Anbieter unterstützen. (3) Testen Sie regelmäßig auf mehreren Modellen, um anbieterspezifische Abweichungen zu erkennen. (4) Halten Sie für kritische Systeme lokale Modelle (Ollama, LM Studio) als Rückfalloption bereit.
Welche Rolle spielen lokale Open-Source-Modelle?
Lokale Modelle (Llama 4 Scout, Qwen3.6, Mistral Small 4 und weitere über Ollama oder LM Studio) eignen sich am besten für: wiederkehrende Aufgaben mit hohem Volumen (klassifizieren, zusammenfassen, extrahieren), private Daten (keine API-Aufrufe), kostensensitive Workloads und Tests, bevor Sie sich auf API-Kosten festlegen. Sie erreichen die Qualität der Frontier-Modelle nicht, punkten aber bei Datenschutz und Kosten. Verwenden Sie sie für die 80 % der Aufgaben, die kein Frontier-Reasoning brauchen.
Ist Claude besser als ChatGPT?
Bei Textqualität, Code-Review und strukturiertem Reasoning wird Claude Opus 5.5 oft gegenüber ChatGPT (GPT-6 Astra) bevorzugt, die Ergebnisse hängen jedoch vom Prompt ab. Bei Tool-Integration, Multi-Agenten-Workflows und einem sehr großen Drittanbieter-Ökosystem ist GPT-6 Astra eine starke Wahl. Keines ist generell besser — die richtige Wahl hängt von Ihrer Aufgabe ab. Testen Sie beide mit PromptQuorum an Ihren echten Prompts und vergleichen Sie die Ergebnisse direkt.
Welches KI-Modell ist am genauesten?
Kein einzelnes Modell ist über alle Aufgaben hinweg am genauesten. Claude Opus 5.5 wird oft für Texte und strukturierte Analyse bevorzugt, GPT-6 Astra für tool-gestütztes Reasoning und Gemini 4 Argon für die Recherche in langen Dokumenten mit Live-Web-Anbindung. Genauigkeit ist aufgabenspezifisch — der einzige verlässliche Test ist, Ihre echten Prompts über alle Modelle laufen zu lassen und die Ergebnisse zu messen.
Was ist der Unterschied zwischen GPT-6 Astra und GPT-6 Luna?
GPT-6 Astra ist das leistungsfähigste GPT-6-Modell von OpenAI ($10 Input / $50 Output pro Million Tokens). GPT-6.1 Sol bietet nahezu Astra-Leistung für $2 / $10, und GPT-6 Luna ist die kostensensible Stufe ($0,10 / $0,50) — rund 100× günstiger als Astra und 20× günstiger als Sol, bei geringerer Leistungsfähigkeit. Verwenden Sie GPT-6 Luna für Klassifikation, Zusammenfassung und Aufgaben mit hohem Volumen, die kein Frontier-Reasoning erfordern. GPT-6.1 Sol nehmen Sie für komplexes mehrstufiges Reasoning und Agenten-Workflows, GPT-6 Astra für die anspruchsvollsten Aufgaben, bei denen Qualität am meisten zählt.
Quellen & weiterführende Literatur
Modellstärken und Preise stammen aus den vom jeweiligen Anbieter veröffentlichten Tarifen und aus öffentlichen Benchmarks (LMSYS Arena, SWE-Bench, GPQA). Fähigkeiten und Preise ändern sich häufig — prüfen Sie die offiziellen Preisseiten und testen Sie an Ihrer Aufgabe, bevor Sie sich produktiv festlegen.
Weiterführende Artikel
- Grundlagen: Tokens, Kosten & Limits — die Ökonomie des Promptens — Token-Preise, Rate Limits und Kostenoptimierung verstehen
- Grundlagen: System-Prompt vs. User-Prompt — der Unterschied — wie System-Prompts das Modellverhalten steuern
- Grundlagen: Welches Prompt-Framework sollten Sie verwenden? — Frameworks funktionieren modellübergreifend; wählen Sie eines, das zur Aufgabe passt
- Techniken: Prompt Chaining — mehrstufige Workflows, in denen verschiedene Modelle verschiedene Schritte übernehmen
- Grundlagen: Kontextfenster erklärt — warum KI vergisst — wie die Kontextfenstergröße die Modellwahl bei langen Dokumenten bestimmt
- Techniken: Chain-of-Thought-Prompting — eine Technik, die bei GPT-6 Astra, Claude und Gemini unterschiedlich wirkt
- Lokale LLMs: Qwen vs Llama vs Mistral — wie Open-Weights-Modelle abschneiden, wenn Sie lokal statt Cloud wählen
- Lokale LLMs: Die besten lokalen LLMs zum Programmieren — lokale Coding-Alternativen zu GPT-6 Astra und Claude
- Grundlagen: Open Source vs. proprietäre LLMs — wann lokale Modelle mit Cloud-APIs mithalten und wann nicht