Aucun « meilleur » modèle d'IA — choisissez selon la tâche
📍 In One Sentence
Les modèles de pointe diffèrent aujourd'hui moins par leur capacité brute que par leurs domaines de force : la question utile est donc quel modèle convient à la tâche, et non lequel domine le classement général.
💬 In Plain Terms
Demander quel modèle est le meilleur revient à demander quel véhicule est le meilleur. La réponse honnête : que transportez-vous, et sur quelle distance ? Les benchmarks décrivent une moyenne ; votre travail est une mission précise, invisible pour un classement.
Aucun modèle d'IA n'est le meilleur pour toutes les tâches. GPT-6 Astra est bien adapté à l'intégration d'outils et au raisonnement ; Claude Opus 5.5 est souvent privilégié pour la rédaction et le code ; Gemini 4 Argon associe une fenêtre de contexte de 1M de tokens à une intégration profonde à Google Workspace ; DeepSeek et Baidu ERNIE sont indispensables pour les charges de travail en Chine continentale.
Face à une nouvelle tâche, la première question n'est pas « quel est le meilleur modèle ? » mais « quel modèle est le meilleur pour CETTE tâche, dans CETTE zone géographique, avec CE budget ? » Les benchmarks et les classements changent tous les quelques mois. C'est votre tâche réelle — votre style rédactionnel, votre base de code, vos clients en Chine, la sensibilité de vos données — qui doit guider le choix.
PromptQuorum est un outil de dispatch multi-modèles qui répond directement à ce besoin : envoyez un prompt structuré simultanément à GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, DeepSeek, Baidu ERNIE et à des LLM locaux (Ollama, LM Studio). Visualisez toutes les réponses côte à côte. Laissez PromptQuorum déterminer quel modèle performe le mieux pour VOTRE tâche, VOS données et VOTRE voix de marque — pas pour un benchmark YouTube.
Matrice de décision rapide — choisissez votre modèle de départ
Choisissez votre modèle de départ en fonction de votre tâche principale. La plupart des équipes utilisent plusieurs modèles : commencez par le bon et changez au besoin.
- GPT-6 Astra l'emporte : workflows multi-agents, intégration d'outils, écosystème d'API, multimodal (images/audio). Commencez ici si les intégrations comptent.
- Claude Opus 5.5 l'emporte : qualité rédactionnelle, revue de code, profondeur de raisonnement, sécurité en entreprise. Commencez ici pour la qualité du contenu et du code.
- Gemini 4 Argon l'emporte : documents longs (1M de tokens), traitement par lots, Google Workspace. Commencez ici pour l'analyse documentaire à grande échelle.
- DeepSeek/Baidu ERNIE l'emporte : Chine continentale (indispensable pour la latence et l'accès), tâches à fort volume sensibles au coût. Seule option si les données restent en Chine.
- Testez les 5 sur votre tâche réelle avec PromptQuorum — les benchmarks trompent ; vos données disent la vérité.
Votre priorité | Commencez par | Pourquoi | Quand changer |
|---|---|---|---|
| Rédaction et analyse exigeantes | Claude Opus 5.5 | Qualité de sortie maximale ; moins de cycles de relecture | Vers GPT-6 Astra si vous avez besoin de workflows multi-outils ou d'intégrations |
| Code et vitesse de développement | Gemini 4 Argon ou Flash | 1M de contexte (projets entiers) ; prix de lancement bas | Vers Claude pour le débogage poussé ou la revue de code ; GPT pour les outils |
| Workflows multi-agents / API | GPT-6 Astra | Écosystème tiers le plus riche ; meilleur appel d'outils | Vers Gemini pour réduire les coûts sur les tâches à fort volume |
| Utilisateurs/données en Chine continentale | DeepSeek-V4 ou Baidu ERNIE | Seul choix réaliste — modèles occidentaux restreints/lents | Sans objet — la conformité et la latence rendent le changement impossible |
Chiffres clés
En un coup d'œil, avant d'entrer dans le détail :
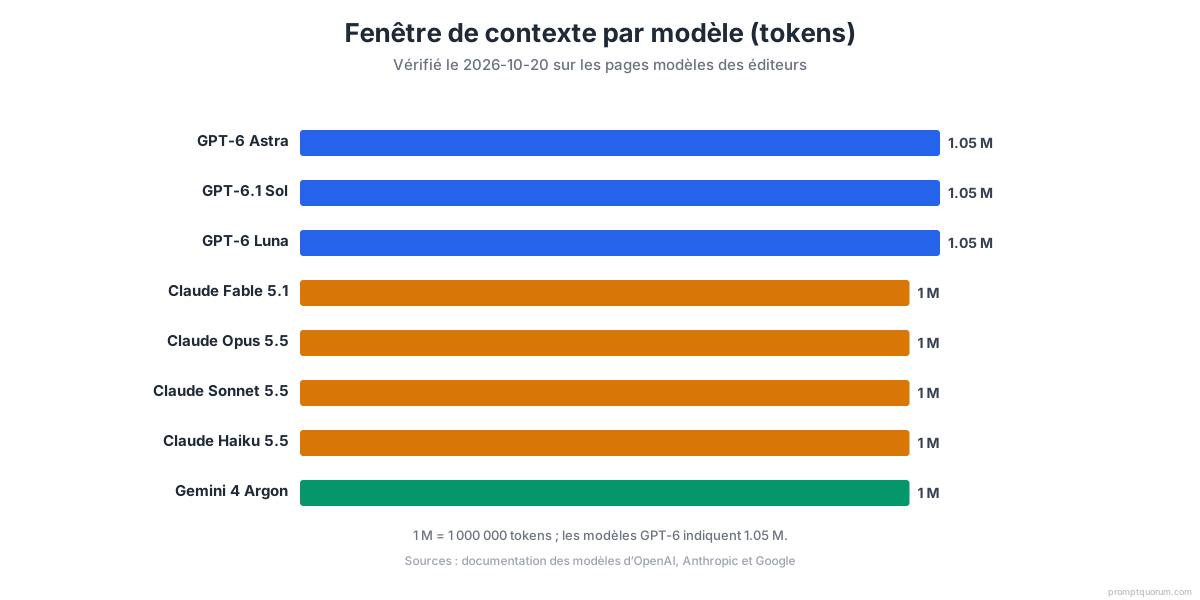
- Fenêtres de contexte : GPT-6 Astra (environ 1,05M), Claude Opus 5.5 (1M), Gemini 4 Argon (1M) — les trois sont à peu près à égalité
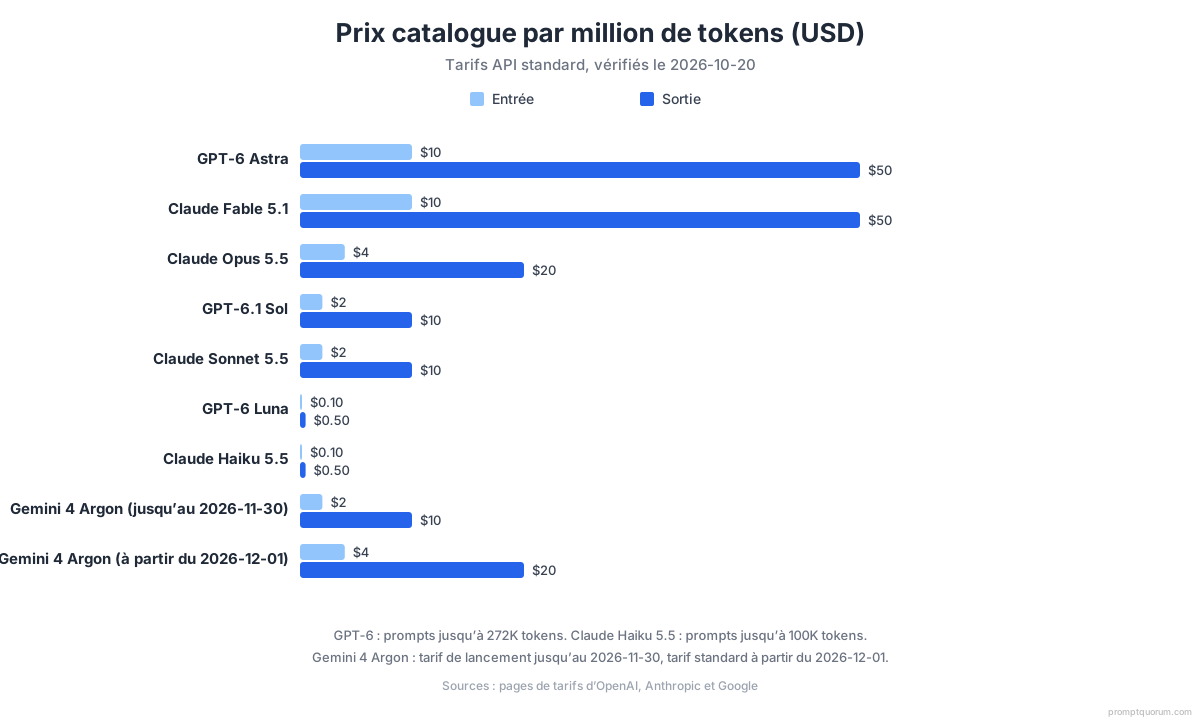
- Tarifs (par million de tokens, entrée/sortie) : GPT-6 Astra 10 $/50 $, Claude Opus 5.5 4 $/20 $, Gemini 4 Argon 2 $/10 $ jusqu'au 2026-11-30 (4 $/20 $ à partir du 2026-12-01)
- Souvent privilégié pour la rédaction : Claude Opus 5.5 — concis et structuré (Anthropic recommande Claude Fable 5.1 pour le raisonnement exigeant et le travail agentique de longue haleine)
- Intégration d'outils : GPT-6 Astra — très vaste écosystème tiers
- Prix catalogue le plus bas des modèles phares (temporaire) : Gemini 4 Argon à 2 $/10 $ jusqu'au 2026-11-30, puis 4 $/20 $, comme Claude Opus 5.5 ; Gemini 3.8 Flash (0,75 $/3,75 $ jusqu'au 2026-12-31, puis 1,50 $/7,50 $) ou GPT-6 Luna (0,10 $/0,50 $) pour les gros volumes
- Indispensable en Chine : DeepSeek ou Baidu ERNIE — les modèles occidentaux sont restreints ou lents
- Privé/local : Ollama ou LM Studio — aucun appel d'API cloud pour l'inférence
Qu'est-ce qui compte vraiment dans le choix d'un modèle ?
Le choix d'un modèle part de votre cas d'usage et de vos contraintes, pas du battage médiatique ni d'un classement. Voici les 7 dimensions qui comptent réellement :
- Qualité sur votre tâche : ce modèle excelle-t-il en rédaction, en code, en analyse ou en raisonnement ? Vérifiez ses performances sur des tâches proches des vôtres, pas sur des benchmarks génériques.
- Coût par token et paliers tarifaires : les modèles frontier coûtent 2 à 50 $ par million de tokens ; les modèles économiques 0,10 à 3,75 $. Le prix se calcule sur les tokens d'entrée et de sortie. Voir l'économie des tokens en détail.
- Latence et limites de débit : à quelle vitesse le modèle répond-il ? Encaisse-t-il votre volume ? Certains plafonnent à 100 requêtes par minute, d'autres dépassent 10 000.
- Taille de la fenêtre de contexte : GPT-6 Astra : environ 1,05M de tokens. Claude Opus 5.5 : 1M de tokens. Gemini 4 Argon : 1M de tokens (les trois sont à peu près à égalité). En savoir plus sur les fenêtres de contexte.
- Capacités multimodales : le modèle traite-t-il images, audio ou vidéo ? GPT-6 Astra et Gemini 4 Argon gèrent bien les images. DeepSeek et Baidu ERNIE se concentrent sur le texte.
- Écosystème et intégrations : combien d'outils tiers, de plugins et d'API le prennent en charge ? GPT-6 Astra dispose d'un très vaste écosystème. Les modèles locaux via Ollama ou LM Studio disposent de milliers d'intégrations communautaires.
- Zone géographique et résidence des données : le modèle est-il disponible dans votre région ? Vos données doivent-elles rester dans un pays ou sur votre réseau ? La Chine continentale impose des modèles locaux (DeepSeek, Baidu ERNIE) pour des raisons réglementaires et de latence.
Quand utiliser GPT-6 Astra ?
GPT-6 Astra est le modèle multimodal frontier d'OpenAI — bien adapté aux workflows agentiques riches en outils, avec un très vaste écosystème d'intégrations tierces. Utilisez GPT-6 Astra quand l'outillage, les intégrations et le multimodal comptent plus que le coût.
- Points forts : excellent raisonnement général et conversation dans tous les domaines. Fortes capacités multimodales : traite de façon fiable les images, l'audio et parfois la vidéo. Écosystème d'appel d'outils mature, avec une très vaste bibliothèque d'intégrations tierces. Largement utilisé en production.
- Meilleurs cas d'usage : workflows d'agents en plusieurs étapes. Chaînes complexes nécessitant l'appel d'outils (API, bases de données, exécution de code). Tâches d'analyse de captures d'écran ou d'images. Projets dans l'écosystème OpenAI (ChatGPT, Assistants API, Codex, fine-tuning).
- Compromis : les modèles frontier premium coûtent plus cher par token (10 $ en entrée / 50 $ en sortie par million) ; GPT-6.1 Sol (2 $ / 10 $) est l'option d'OpenAI plus économique et proche d'Astra. Les réponses peuvent être verbeuses — il faut de la rigueur dans le prompt pour imposer la concision.
- Fenêtre de contexte : environ 1 050 000 tokens (environ 800 pages de texte).
Quand utiliser Claude Opus 5.5 ?
Claude Opus 5.5 d'Anthropic est bien adapté au raisonnement soigné, à la qualité rédactionnelle et à la refactorisation de code, et il est entraîné selon l'approche Constitutional AI d'Anthropic en matière de sécurité. Utilisez Claude quand la qualité, la clarté et la fiabilité priment.
- Points forts : rédaction et synthèse de haute qualité ; les sorties sont concises, bien structurées et prêtes à publier. Excellente compréhension du code, refactorisation et explication — il aide souvent à repérer des bugs. Bonne gestion du contexte long pour la recherche et les workflows documentaires. Approche d'entraînement axée sur la sécurité, appréciée par certaines équipes des secteurs réglementés.
- Meilleurs cas d'usage : rapports, analyses et travail de connaissance où structure et clarté sont déterminantes. Bases de code complexes et discussions d'architecture. Contextes d'entreprise avec exigences de conformité et de sécurité. Contenus qui doivent demander un minimum de retouches.
- Compromis : tarif élevé sur les niveaux supérieurs ; parfois surdimensionné pour des tâches simples. Certaines intégrations tierces sont plus récentes que leurs équivalents GPT-6 Astra.
- Pour aller plus loin : Anthropic propose aussi Claude Fable 5.1 (10 $ en entrée / 50 $ en sortie par million de tokens) pour le raisonnement exigeant et le travail agentique de longue haleine. Anthropic conseille de commencer par Opus 5.5 et de passer à Fable 5.1 si vos évaluations sur Opus 5.5 à effort élevé restent insuffisantes.
- Fenêtre de contexte : 1 000 000 de tokens (environ 800 pages de texte).
Quand utiliser Gemini 4 Argon ?
Gemini 4 Argon de Google DeepMind est le modèle de raisonnement phare de Google, avec une fenêtre de contexte de 1M de tokens et une intégration profonde à Google Workspace ; son prix de 2 $/10 $ est un tarif de lancement (jusqu'au 2026-11-30, puis 4 $/20 $). Utilisez Gemini pour traiter de nombreux documents longs ou si votre équipe travaille dans Google Workspace.
- Points forts : très bonnes performances de code à un tarif attractif — en particulier les modèles Flash de milieu de gamme. Contexte long solide (1M de tokens) et recherche documentaire ; excellent pour la recherche sur de nombreux documents avec recherche web en direct. Intégration native à Google Workspace (Docs, Sheets, Drive, Gmail, Slides).
- Meilleurs cas d'usage : équipes qui travaillent dans Google Workspace. Code et traitement de données par lots où le rapport coût/performance est déterminant. Workflows de recherche combinant documents locaux et recherche web. Traitement de PDF ou de transcriptions de plus de 100 pages.
- Compromis : le ton rédactionnel paraît plus prudent ou générique que celui de Claude ou GPT. Hors écosystème Google, certaines intégrations sont en retard.
- Fenêtre de contexte : 1 000 000 de tokens (environ 800 pages de texte).
Quel modèle d'IA pour le code en 2026 ?
Claude Opus 5.5 est souvent privilégié pour la qualité de code et la refactorisation ; GPT-6 Astra est bien adapté à l'intégration d'outils et au raisonnement multi-fichiers ; Gemini 4 Argon a le prix catalogue le plus bas des modèles phares tant que le tarif de lancement s'applique ; DeepSeek s'impose pour les développeurs en Chine continentale. Le « meilleur » modèle pour le code dépend de votre contrainte principale : qualité du code, étendue des intégrations, coût par token ou zone géographique.
- GPT-6 Astra : solide pour les tâches de développement en plusieurs étapes avec usage d'outils (accès au système de fichiers, API, commandes shell). Excellent pour raisonner sur de grandes bases de code et générer des workflows complexes. Le meilleur choix si les intégrations GitHub, AWS ou API sont déterminantes.
- Claude Opus 5.5 : idéal pour la revue de code, la refactorisation et les discussions d'architecture. Souvent utile pour repérer des bugs subtils. Privilégié pour maintenir des bases existantes et expliquer du code hérité. Coût par token plus élevé, mais souvent moins d'allers-retours.
- Gemini 4 Argon : prix catalogue attractif pour le code par lots tant que le tarif de lancement s'applique (traitement de données, scripts utilitaires, automatisation). 1M de contexte permet de charger des projets entiers d'un coup. Excellent pour aller vite du prototype à la production quand le coût compte.
- DeepSeek-V4 : positionné comme une alternative moins coûteuse pour le code. Idéal pour les développeurs en Chine continentale et les tâches de code à fort volume (échafaudage, boilerplate, refactorisation de routine). Très solide sur les problèmes d'algorithmique et la programmation compétitive.
Quel LLM pour le contexte long et les documents volumineux en 2026 ?
Les trois modèles frontier prennent en charge 1M de tokens de contexte (environ 800 pages). L'écart sur le contexte long est comblé. Au-delà d'un million de tokens, envisagez des modèles locaux comme Llama 4 Scout (10M de tokens). Choisissez selon le coût, la précision de la recherche et le besoin de charger plusieurs fichiers simultanément.
- Gemini 4 Argon (1M de tokens) : chargez des bases de code entières, des ensembles de documents juridiques ou des archives de recherche. L'intégration de la recherche web permet de citer des sources externes dans un contexte long. Idéal pour : audits de due diligence, analyses réglementaires, recherche dans une base de connaissances, PDF de plus de 100 pages.
- Claude Opus 5.5 (1M de tokens) : excellent pour l'analyse détaillée et l'extraction d'informations nuancées dans de longs documents. Compromis : le coût par token le plus élevé, compensé par une qualité qui réduit les cycles de relecture.
- GPT-6 Astra (~1,05M de tokens) : solide pour le raisonnement en plusieurs étapes sur des documents longs. Le meilleur choix si vous avez besoin d'appel d'outils en plus du contexte long (système de fichiers, API).
- Stratégie pratique : les trois offrent désormais 1M de tokens à égalité. Choisissez selon le coût, la qualité de sortie pour votre tâche ou l'écosystème d'outils.
Comment choisir un modèle d'IA si vous êtes en Chine ou avez besoin d'une faible latence ?
Pour des utilisateurs et des données en Chine continentale, DeepSeek et Baidu ERNIE sont généralement le choix pratique. Les modèles frontier occidentaux (GPT-6 Astra, Claude, Gemini) y sont souvent restreints ou lents en raison des restrictions réseau et des exigences réglementaires. La latence et la conformité (résidence des données, modération des contenus) sont des points de blocage majeurs. Utiliser un modèle occidental en Chine continentale peut entraîner un service indisponible, une latence élevée pour les utilisateurs ou un risque réglementaire. Les modèles hébergés en Chine continentale évitent la plupart de ces problèmes ; faites valider les règles en vigueur par un conseil juridique.
DeepSeek (modèle frontier, code compétitif) : performances compétitives en code et en raisonnement, tarifs bas, excellente prise en charge du chinois et des tâches mixtes chinois-anglais. Hébergé sur une infrastructure en Chine continentale, donc généralement avec une faible latence réseau. Idéal pour les workflows de développement en Chine continentale et les charges à fort volume sensibles au coût. Compromis : écosystème plus restreint hors de Chine, moins d'intégrations tierces que GPT/Claude/Gemini.
Baidu ERNIE (entreprise et grand public) : intégration étroite à la recherche et au cloud Baidu, forte assise sur les contenus web chinois et les données d'entreprise. Conçu pour fonctionner dans le cadre réglementaire de la Chine continentale (modération des contenus, résidence des données, filtrage par mots-clés) ; les obligations de conformité restent à la charge de l'organisation qui le déploie. Idéal pour les applications grand public et professionnelles ciblant les utilisateurs chinois, ainsi que pour les applications hébergées sur Baidu Cloud où la conformité n'est pas négociable. Compromis : optimisé avant tout pour le chinois ; l'anglais et les autres langues peuvent rester en retrait des modèles frontier occidentaux.
GPT-6 Astra vs Claude Opus 5.5 vs Gemini 4 Argon : comparaison rapide
Ce tableau compare 5 modèles d'IA sur 8 dimensions clés : raisonnement général, rédaction, code, contexte long, multimodal, rapport coût/performance, écosystème mondial et accès en Chine.
Dimension | GPT-6 Astra | Claude Opus 5.5 | Gemini 4 Argon | DeepSeek | Baidu ERNIE |
|---|---|---|---|---|---|
| Questions générales | Excellent à l'échelle mondiale | Très bon, prudent | Très bon + recherche | Solide, référence en CN | Solide, référence en CN |
| Rédaction | Très bon, parfois verbeux | Structure et clarté au top | Bon, ton neutre | Bon, chinois d'abord | Bon, chinois d'abord |
| Code | Solide | Excellent, premium | Solide ; prix de lancement bas | Très solide pour devs CN | Bon, usage métier |
| Contexte long | Solide (~1,05M) | Solide (1M) | Solide (1M) + web | Bon | Bon avec données Baidu |
| Multimodal | Leader (image/audio) | Bonne vision | Très fort (vidéo/web) | Variable | Texte + web CN |
| Rapport coût/performance | 10 $/50 $ (le plus élevé) | 4 $/20 $ | 2 $/10 $ jusqu'au 2026-11-30, puis 4 $/20 $ | Très compétitif | Compétitif (entreprises CN) |
| Écosystème mondial | Le plus étendu | En croissance, surtout entreprise | Fort dans l'univers Google | Limité hors de Chine | Fort dans l'écosystème Baidu |
| Accès/latence en Chine | Souvent restreint | Souvent restreint | Souvent restreint | Natif / faible latence | Natif / requis |
Comment choisir le bon modèle d'IA ?
Partez de votre cas d'usage principal, ajoutez vos contraintes, puis choisissez le modèle qui répond aux deux.
Si : assistant généraliste, workflows agentiques multi-outils. Alors : commencez par GPT-6 Astra. Il vous faut l'outillage et les intégrations les plus étendus.
Si : rédaction poussée, analyse, code complexe ou fortes exigences de sécurité. Alors : commencez par Claude Opus 5.5. La qualité et la fiabilité comptent plus que le coût.
Si : usage intensif de Google Workspace, code/données par lots, ou traitement de plus de 100 documents longs. Alors : commencez par Gemini 4 Argon. Le contexte long et l'intégration à l'écosystème font gagner du temps.
Si : utilisateurs et données principalement en Chine continentale. Alors : commencez par DeepSeek (orienté code) ou Baidu ERNIE (applications grand public et métier). Les modèles occidentaux y sont restreints ou lents.
- Budget serré, volume élevé : privilégiez Gemini Flash / DeepSeek / les petits modèles GPT.
- Conformité stricte, contrats entreprise : Claude en offre entreprise, Baidu ERNIE pour la Chine.
- Besoin de multimodal (captures d'écran, graphiques, audio) : GPT-6 Astra ou Gemini 4 Argon.
- Données strictement privées : LLM locaux via Ollama ou LM Studio (les prompts ne sont pas envoyés à une API cloud).
Comment se comparent les coûts et les limites de tokens ?
Tous les grands modèles sont facturés par token d'entrée et de sortie, avec des limites de débit liées à votre palier. Les modèles frontier coûtent 10 à 100 fois plus par token que les modèles économiques. Les tarifs varient selon la région (surtout en Chine).
- Modèles frontier (les plus chers par token) : GPT-6 Astra (10 $ en entrée / 50 $ en sortie par million de tokens), Claude Opus 5.5 (4 $ en entrée / 20 $ en sortie par million de tokens), Claude Fable 5.1 (10 $ en entrée / 50 $ en sortie par million de tokens).
- Modèle phare plus économique (temporaire) : Gemini 4 Argon (2 $ en entrée / 10 $ en sortie par million de tokens jusqu'au 2026-11-30, puis 4 $ / 20 $ à partir du 2026-12-01, comme Claude Opus 5.5) — le moins cher des trois modèles phares tant que le tarif de lancement s'applique.
- Milieu de gamme économique : GPT-6.1 Sol (2 $ en entrée / 10 $ en sortie), Gemini 3.8 Flash (0,75 $ en entrée / 3,75 $ en sortie par million de tokens jusqu'au 2026-12-31, puis 1,50 $ / 7,50 $) et GPT-6 Luna (0,10 $ en entrée / 0,50 $ en sortie). En dessous, Gemini 3.5 Flash-Lite constitue le palier d'efficacité.
- Alternatives économiques : DeepSeek-V4 (tarifs agressifs), modèles locaux via Ollama/LM Studio (gratuits, exécutés sur votre machine).
- Limites de débit : les modèles frontier démarrent souvent à 100 requêtes/minute ; les paliers étendus atteignent plus de 10 000 requêtes/minute. Pour les modèles locaux, tout dépend de votre matériel.
- En savoir plus sur les fenêtres de contexte et leur influence sur le choix du modèle.
Pourquoi utiliser plusieurs modèles d'IA plutôt qu'un seul en 2026 ?
Les benchmarks et les classements changent tous les quelques mois. Chaque tâche est mieux servie par un modèle différent. Et les contraintes géographiques (résidence des données dans l'UE, latence en Chine) imposent des piles multi-modèles.
- Raison 1 : l'excellence par tâche. Aucun modèle ne gagne partout. Claude est souvent privilégié pour la rédaction, Gemini pour la recherche à contexte long, GPT pour le raisonnement multi-étapes. Routez chaque tâche vers le spécialiste.
- Raison 2 : l'optimisation des coûts. Confiez les tâches répétitives à fort volume (résumé, catégorisation) à des modèles petits ou économiques. Réservez les modèles frontier au raisonnement complexe. Les paliers économiques sont facturés une fraction du prix des modèles frontier : y router les tâches adaptées peut réduire nettement les coûts tout en gardant la qualité là où elle compte.
- Raison 3 : les contraintes réglementaires et géographiques. L'UE impose la résidence des données (Ollama en local). La Chine impose des modèles locaux. Une pile multi-modèles permet de respecter toutes ces contraintes.
- Exemple de pile : Claude pour la rédaction, Gemini pour le code, GPT pour les agents, DeepSeek/ERNIE pour les utilisateurs chinois. Ce n'est pas complexe — c'est simplement pragmatique.
Comment PromptQuorum aide à comparer et router les modèles ?
PromptQuorum supprime la corvée du changement manuel de modèle : un prompt structuré part vers tous les modèles à la fois et les résultats sont comparés automatiquement. Fini le copier-coller entre onglets et les suppositions sur le modèle le plus performant.
- Un prompt structuré → plusieurs modèles simultanément. Rédigez votre prompt une seule fois. PromptQuorum l'envoie en parallèle à GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, DeepSeek, Baidu ERNIE et aux LLM locaux (Ollama, LM Studio). Toutes les réponses s'affichent côte à côte.
- Des cadres partagés pour une comparaison équitable. Même structure de prompt, mêmes contraintes, mêmes formats pour tous les modèles. Cela élimine l'argument « Claude a mieux répondu parce que le prompt était écrit pour Claude ».
- Vue consensus et scoring. PromptQuorum vous montre quel modèle écrit le mieux dans votre voix de marque, lequel produit le code le plus correct, lequel traite le plus fidèlement vos documents internes, et lequel est le plus rapide et le moins cher pour VOTRE tâche.
- Règles de routage : envoyez les tâches à fort volume et peu coûteuses vers des modèles petits ou locaux, et le raisonnement complexe vers des modèles premium. Le choix du modèle s'automatise selon le type de tâche.
- Prise en charge des LLM locaux. Connectez Ollama ou LM Studio pour une inférence entièrement locale. Les prompts ne sont pas envoyés à une API cloud, mais vérifiez quand même les paramètres de mise à jour et de télémétrie de chaque outil. Les tâches sensibles restent en local, les tâches courantes passent par les API cloud.
- Arrêtez de vous fier aux benchmarks YouTube. Testez vos propres tâches sur vos propres données. C'est la seule vérité qui compte.
Le tableau de bord PromptQuorum : tous les modèles d'un coup d'œil
Un seul prompt, et vous voyez les sorties de GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon, DeepSeek et Baidu ERNIE dans une même vue. La comparaison côte à côte supprime la corvée du changement manuel de modèle.
Recettes pratiques : 4 façons d'utiliser PromptQuorum pour comparer les modèles
Les tests multi-modèles dans PromptQuorum révèlent quel modèle fonctionne le mieux pour VOTRE tâche, VOS données et VOTRE marque — pas pour des benchmarks génériques. Voici 4 scénarios concrets :
Recette 1 : déterminer quel modèle écrit le mieux dans votre voix de marque
Vous rédigez le texte produit d'une page d'atterrissage SaaS B2B. Le ton doit faire autorité tout en restant accessible — sans jargon marketing ni superlatifs vagues. Testez le même brief sur GPT-6 Astra, Claude Opus 5.5 et Gemini. Voyez quel modèle capte le mieux votre voix de marque. Passez le tout dans PromptQuorum et notez chaque sortie sur le ton, la clarté et le respect de votre charte éditoriale. Le vainqueur devient votre modèle de référence pour la rédaction. Exemple de prompt : « Réécris cette description de fonctionnalité dans notre voix de marque : collez votre charte + le texte existant. Quel modèle s'en approche le plus ? »
Recette 2 : comparer qualité de code et coût pour votre backend
Vous avez une base de code Python. Test : « Analyse cette fonction pour les performances et les bugs. Propose une refactorisation. » Exécutez-le via GPT-6 Astra, Claude Opus 5.5 et Gemini 3.8 Flash. Lequel détecte le plus de bugs ? Quelle refactorisation est la plus propre ? Lequel coûte le moins cher par requête ? Utilisez PromptQuorum pour noter la qualité du code. Gemini 3.8 Flash coûte environ cinq fois moins que Claude Opus 5.5 par token au prix catalogue (0,75 $/3,75 $ contre 4 $/20 $) ; vérifiez s'il détecte assez de problèmes pour votre cas d'usage. Exemple : « Optimise cette requête de base de données. Quelle est sa complexité temporelle ? » — envoyé à Claude pour l'analyse fine, à Gemini pour itérer à moindre coût.
Recette 3 : monter une pile mondiale + Chine (GPT / Claude / Gemini + DeepSeek / ERNIE)
Votre produit sert des utilisateurs partout dans le monde et en Chine continentale. Routez les utilisateurs mondiaux vers GPT, Claude ou Gemini (votre pile globale). Routez les utilisateurs chinois vers DeepSeek ou Baidu ERNIE (indispensable pour la latence et la conformité). Utilisez PromptQuorum pour tester les performances des modèles sur vos prompts utilisateurs réels dans chaque zone. Vous gardez une qualité homogène tout en respectant les contraintes régionales.
Recette 4 : LLM locaux pour les données privées, modèles frontier pour la finition
Vous avez des données clients sensibles. Étape 1 : traitez-les localement avec Ollama ou LM Studio (les prompts ne sont pas envoyés à une API cloud). Étape 2 : envoyez le résultat épuré à Claude ou GPT pour la finition et le contrôle qualité. Cette approche hybride est économique, confidentielle et produit un résultat de qualité. Testez-la dans PromptQuorum pour identifier le modèle local le plus adapté à votre pipeline.
Comment choisir un modèle d'IA pour votre tâche
- 1Définissez le type de tâche : est-elle factuelle/analytique (analyse juridique, revue de code, extraction de données) ou créative/générative (brainstorming, rédaction publicitaire, idéation) ? Les tâches factuelles favorisent GPT-6 Astra ou Claude Opus 5.5 ; les tâches créatives fonctionnent sur tous les modèles frontier.
- 2Arbitrez entre vitesse et coût : GPT-6 Astra est le généraliste le plus complet, mais pas le moins cher. Claude Opus 5.5 est bien adapté au raisonnement long et à la précision. Gemini 4 Argon a le prix catalogue le plus bas des modèles phares tant que le tarif de lancement s'applique, et propose des entrées multimodales avec une fenêtre de contexte de 1M de tokens ; Gemini 3.8 Flash, GPT-6.1 Sol et GPT-6 Luna constituent des paliers plus économiques. Comparez les trois sur votre prompt précis avec PromptQuorum.
- 3Commencez par un modèle frontier (GPT-6.1 Sol, Claude Opus 5.5 ou Gemini 4 Argon), puis descendez en gamme si possible : une tâche qui fonctionne bien sur GPT-6.1 Sol tournera peut-être aussi bien sur GPT-6 Luna (environ 20 fois moins cher). Testez votre prompt sur des modèles moins chers une fois que vous avez une version qui marche.
- 4Pour les workflows locaux ou privés, utilisez Ollama ou LM Studio, en acceptant une qualité moindre : les modèles locaux traitent des données privées sans appel d'API externe, mais leur précision reste inférieure à celle des modèles frontier. Adoptez une approche hybride : modèle local pour le premier passage, modèle frontier pour le contrôle qualité.
- 5Pour des utilisateurs répartis géographiquement, routez par région : utilisateurs mondiaux (États-Unis, UE, Japon) → GPT-6 Astra / Claude / Gemini. Chine → DeepSeek ou Baidu ERNIE (exigence réglementaire). Testez chaque région séparément avec PromptQuorum.
- 6Testez les trois (ou plus) avec PromptQuorum avant de vous engager : envoyez votre prompt simultanément à GPT-6 Astra, Claude Opus 5.5 et Gemini 4 Argon. La comparaison des sorties révèle le modèle le mieux adapté à votre tâche.
Erreurs courantes dans le choix d'un modèle d'IA
❌ Choisir d'après les classements de benchmarks plutôt que d'après votre tâche réelle
Why it hurts: Les classements LMSYS Arena et HumanEval bougent chaque mois. Un modèle en tête sur MMLU peut décrocher sur votre tâche précise de code, de rédaction ou d'analyse.
Fix: Testez vos prompts réels sur 2 ou 3 modèles avant de vous engager. Comparez sur VOS données avec PromptQuorum.
❌ Croire qu'une grande fenêtre de contexte équivaut à la qualité sur les documents longs
Why it hurts: Les trois modèles frontier prennent en charge 1M de tokens — la parité est atteinte. Mais remplir une fenêtre d'un million de tokens ne garantit pas que le modèle l'exploite bien. Le problème du « perdu au milieu » fait que l'information située au centre de très longs contextes peut être ignorée.
Fix: Au-delà de 200 pages, découpez et résumez plutôt que de tout coller dans un seul prompt, quelle que soit la taille de la fenêtre. Pour les documents dépassant 1M de tokens, envisagez des modèles locaux comme Llama 4 Scout (10M).
❌ Utiliser un modèle frontier pour toutes les tâches
Why it hurts: GPT-6 Astra à 10 $/50 $ par million de tokens coûte environ 13 fois plus que Gemini 3.8 Flash à 0,75 $/3,75 $ (jusqu'au 2026-12-31). De nombreuses tâches de classification, d'extraction et de résumé donnent une qualité comparable sur des modèles moins chers.
Fix: Commencez par le modèle le moins cher. Ne montez vers un modèle frontier que si le modèle économique échoue de façon mesurable sur votre tâche.
❌ Ignorer la zone géographique et la résidence des données
Why it hurts: Envoyer des données personnelles européennes vers des API américaines nécessite des clauses contractuelles types. Servir des utilisateurs de Chine continentale via GPT/Claude peut ajouter une latence perceptible et soulever des questions réglementaires.
Fix: Routez par zone géographique. Données sensibles UE → LLM locaux ou points d'accès API en région UE. Chine → DeepSeek ou Baidu ERNIE. Monde → n'importe quel modèle frontier.
❌ S'enfermer dans le SDK d'un fournisseur sans couche d'abstraction
Why it hurts: Quand un nouveau modèle sort — et il en sort tous les quelques mois — vous ne pouvez pas changer sans réécrire votre intégration.
Fix: Utilisez des SDK indépendants du fournisseur (LiteLLM, PromptQuorum) ou le format d'API compatible OpenAI que Claude, Gemini et les modèles locaux prennent également en charge.
Questions fréquentes
Si je ne peux payer qu'un seul abonnement, lequel choisir ?
Commencez par Claude Opus 5.5 : c'est la meilleure qualité globale en rédaction, raisonnement et code. Si votre besoin principal est l'intégration d'outils et le multimodal (images/audio), choisissez GPT-6 Astra. Si votre équipe vit dans Google Workspace et que le coût est critique, choisissez Gemini. Si vos utilisateurs sont en Chine continentale, choisissez un modèle hébergé en Chine continentale, comme DeepSeek ou Baidu ERNIE (généralement nécessaire pour la latence et la conformité).
À quelle fréquence réévaluer mes choix de modèles ?
Chaque trimestre. Tous les 3 à 4 mois, de nouveaux modèles sortent et les classements changent. Utilisez PromptQuorum pour retester vos tâches les plus critiques sur les modèles actuels. Ce qui était optimal il y a 6 mois ne l'est plus forcément.
Puis-je combiner plusieurs modèles dans un même produit ou agent ?
Oui — et vous devriez le faire. Routez chaque type de tâche vers le modèle adapté : Claude pour la rédaction, Gemini pour la recherche documentaire, GPT pour les agents. Utilisez une logique conditionnelle : s'il s'agit d'une tâche rédactionnelle, Claude ; s'il s'agit de recherche documentaire, Gemini. C'est ainsi que fonctionnent les systèmes en production.
Comment aborder la dépendance à un fournisseur ?
La dépendance survient quand votre système repose sur le format d'API, les fonctions propriétaires ou la tarification d'un seul modèle. Protégez-vous : (1) utilisez des structures de prompt standard qui fonctionnent d'un modèle à l'autre ; (2) passez par des couches d'abstraction (comme PromptQuorum) compatibles avec plusieurs fournisseurs ; (3) testez régulièrement sur plusieurs modèles pour détecter les dérives propres à un fournisseur ; (4) pour les systèmes critiques, prévoyez des modèles locaux (Ollama, LM Studio) en repli.
Quelle place pour les modèles locaux open source ?
Les modèles locaux (Llama 4 Scout, Qwen3.6, Mistral Small 4 et d'autres via Ollama ou LM Studio) conviennent surtout aux tâches répétitives à fort volume (classer, résumer, extraire), aux données privées (aucun appel d'API), aux charges sensibles au coût et aux tests avant de s'engager sur des coûts d'API. Ils n'égalent pas les modèles frontier en qualité, mais excellent en confidentialité et en coût. Réservez-les aux 80 % de tâches qui n'exigent pas un raisonnement de niveau frontier.
Claude est-il meilleur que ChatGPT ?
Sur la qualité rédactionnelle, la revue de code et le raisonnement structuré, Claude Opus 5.5 est souvent préféré à ChatGPT (GPT-6 Astra), mais les résultats varient selon le prompt. Sur l'intégration d'outils, les workflows multi-agents et un très vaste écosystème tiers, GPT-6 Astra est un bon choix. Aucun n'est universellement meilleur : le bon choix dépend de votre tâche. Testez les deux avec PromptQuorum sur vos prompts réels et comparez directement.
Quel modèle d'IA est le plus précis ?
Aucun modèle n'est le plus précis sur toutes les tâches. Claude Opus 5.5 est souvent privilégié pour la rédaction et l'analyse structurée, GPT-6 Astra pour le raisonnement outillé et Gemini 4 Argon pour la recherche dans les documents longs avec ancrage web en direct. La précision dépend de la tâche : le seul test fiable consiste à exécuter vos prompts réels sur tous les modèles et à mesurer les résultats.
Quelle différence entre GPT-6 Astra et GPT-6 Luna ?
GPT-6 Astra est le modèle GPT-6 le plus performant d'OpenAI (10 $ en entrée / 50 $ en sortie par million de tokens). GPT-6.1 Sol offre des performances proches d'Astra pour 2 $ / 10 $, et GPT-6 Luna est le palier économique (0,10 $ / 0,50 $) : environ 100 fois moins cher qu'Astra et 20 fois moins cher que Sol, pour une capacité moindre. Utilisez Luna pour la classification, le résumé et les tâches à fort volume sans raisonnement frontier. Utilisez Sol pour le raisonnement complexe en plusieurs étapes et les workflows d'agents, et Astra pour les tâches les plus exigeantes où la qualité prime.
Sources et lectures complémentaires
Les points forts des modèles et les tarifs proviennent des grilles publiées par chaque fournisseur et de benchmarks publics (LMSYS Arena, SWE-Bench, GPQA). Les capacités et les prix évoluent souvent — consultez les pages tarifaires officielles et testez sur votre tâche avant de passer en production.
- OpenAI — modèles GPT-6 et tarifs
- Anthropic — vue d'ensemble des modèles Claude
- Google — tarifs de l'API Gemini
- DeepSeek — documentation API et modèles
- Baidu AI Cloud — plateforme ERNIE Bot
- ERNIE — documentation API
- LMSYS Chatbot Arena — classements de modèles en direct
- SWE-Bench — benchmarks de capacités en code
À lire également
- Fondamentaux : tokens, coûts et limites — l'économie du prompting — comprendre la tarification des tokens, les limites de débit et l'optimisation des coûts
- Fondamentaux : prompt système vs prompt utilisateur — comment les prompts système définissent le comportement des modèles
- Fondamentaux : quel framework de prompt utiliser ? — les frameworks fonctionnent d'un modèle à l'autre ; choisissez celui qui convient à votre tâche
- Techniques : chaînage de prompts — workflows en plusieurs étapes où différents modèles traitent différentes étapes
- Fondamentaux : les fenêtres de contexte expliquées — pourquoi l'IA oublie — comment la taille du contexte oriente le choix du modèle pour les documents longs
- Techniques : prompting en chaîne de pensée — une technique dont l'effet varie entre GPT-6 Astra, Claude et Gemini
- LLM locaux : Qwen vs Llama vs Mistral — comment se comparent les modèles à poids ouverts quand vous choisissez le local plutôt que le cloud
- LLM locaux : les meilleurs LLM locaux pour le code — les alternatives locales à GPT-6 Astra et Claude pour le code
- Fondamentaux : LLM open source vs propriétaires — quand les modèles locaux égalent les API cloud, et quand ils ne le font pas