2026年RunPod与Vast.ai该用哪个?
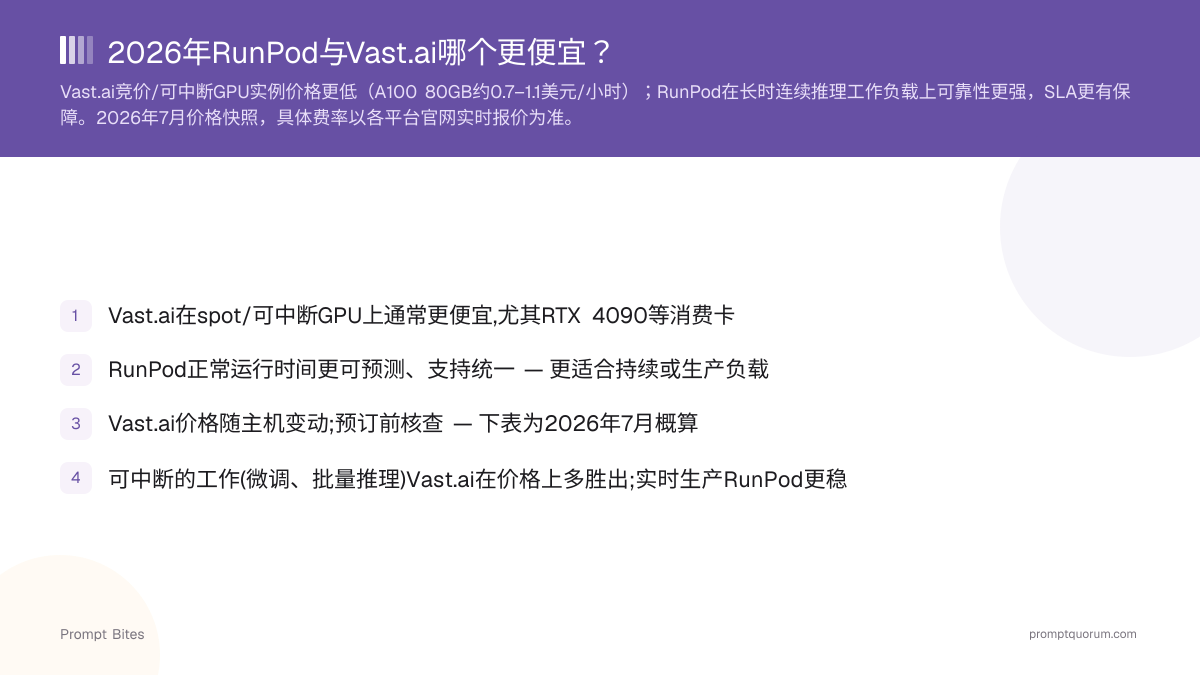
RunPod通常是可预测GPU租用中更简单的选择——部署简单、无需比价、可用性可靠。Vast.ai是主机间价格竞争的市场,因此可能更便宜,但这需要你自己比较出价并容忍更大的波动性。二者都不是绝对的"更便宜"——正确的选择取决于你更看重简单性还是最低价格。
本页包含指向第三方产品的参考链接。PromptQuorum 未加入任何联盟计划——这些是不产生佣金的普通链接。点击链接和后续步骤由您自行承担责任。这些链接不代表 PromptQuorum 的任何认可或验证。
快速回答
如果你想要简单、可预测的部署,RunPod是更好的默认选择。如果最低价格比便利性更重要,并且你愿意比较各主机的出价,Vast.ai是更好的选择。
- ▸RunPod:托管云,固定公开定价,稳定可用性 — 最适合生产环境和不想比价的用户。
- ▸Vast.ai:P2P市场,主机自行定价 — 尤其在消费级GPU上可能明显更便宜,但实例可能被中断。
- ▸GPU租用价格在两个平台上都持续变动 — 请在各自网站上查看当前费率,而非相信页面上的某个数字。
关键要点
- ✓简单性与生产环境首选:RunPod — 托管云、公开定价、稳定可用性
- ✓最低价格首选:Vast.ai — 只要你自己比价,这个P2P市场尤其在消费级GPU上可以压低到RunPod以下
- ✓不存在绝对更便宜的供应商 — GPU租用价格在两个平台上都持续变动,请比较实时费率而非相信本页数字
- ✓对70B级模型不要自动租用H100 — 用于推理时,更便宜的48-80GB显卡往往性价比更高
快速答案
RunPod通常是可预测GPU租用中更简单的选择——部署简单、设置容易,适合想快速让GPU跑起来的开发者。如果你愿意比较各家出价并容忍更大的波动性,Vast.ai可能更便宜。
- ▸🏆 简单性首选:RunPod — 可预测的部署、简单的设置,适合想快速让GPU跑起来的开发者
- ▸💰 最低价格首选:Vast.ai — 市场模式在你对GPU型号、位置和可用性有弹性时可以产生非常低的价格
- ▸🧑💻 生产环境首选:RunPod — 当可靠性和简单性比每小时省下最后几分钱更重要时选择它
RunPod vs Vast.ai 一览
这是相对比较,不是价格表——两个平台的确切费率变动太频繁,无法可靠列出。想要简单?选RunPod。想要尽可能低的价格并愿意比价?选Vast.ai。
RunPod:简单可预测部署的首选
如果你不想花时间在各种GPU出价中挑选,RunPod是更好的选择。它运营着公开定价、稳定可用性、统一支持渠道的托管云——你选择一款GPU即可部署,无需比较几十条出价。
适合:Ollama、vLLM、ComfyUI、通用AI开发、临时GPU服务器、模型测试和推理。选择理由:部署简单、开发者友好的工具、跨多个地区的丰富GPU选择、完善的文档,以及比波动的市场更容易做预算的定价。
Vast.ai:追求最低价格的首选
Vast.ai的运作方式不同——它是一个市场,独立主机列出可用硬件并自行定价。这种结构可以产生比托管云低得多的出价,但页面上最便宜的出价并不自动等于最好的交易。
在Vast.ai租用前请检查:GPU型号、显存、每小时价格、主机可靠性评分、带宽、存储费用、物理位置,以及供应商的口碑/评价。评价良好的主机稍贵的出价,往往比无评价的最低价出价更值得选择。
不要只比较$/小时
这是本页最重要的定价经验:如果价格更低的机器明显更慢,那么标价更低的GPU并不一定比标价更高的更划算。
对于类似本地LLM的推理任务,应改为计算每单位有效输出的成本——把每小时价格除以实际获得的每秒token数。一款每小时贵50%但每秒token数是另一款两倍的GPU,即使页面上时薪看起来更差,也是更好的选择。时薪更低的机器并不自动等于更划算。
70B模型场景
这是本比较对本地LLM读者最有意义的地方。Q4量化的70B模型通常需要40GB以上显存,这会指向A100 80GB、H100 80GB、A6000 48GB、H200 141GB或多卡配置等选项。
不要自动租用H100或H200。如果你运行的是推理而非训练,更便宜的48-80GB显卡在每单位有效输出成本上往往表现更好——在假设最快的GPU就是最划算之前,请先参考上方"不要只比较$/小时"一节。关于硬件选项及其权衡的完整介绍,请参见下方链接的70B模型最省钱运行方式指南。
短期任务还是24/7运行?
- ▸测试几个小时:Vast.ai可能非常有吸引力。
- ▸持续运行某项服务:RunPod通常更易于管理。
- ▸大批量工作负载:开始前比较两者的当前费率。
- ▸生产应用:优先考虑可靠性而非绝对最低的每小时价格。
延伸阅读
- ▸云GPU每小时多少钱? — 计算你的70B工作负载实际花费
- ▸本地运行70B模型的最省钱实用方法 — 何时购买硬件比租用更划算
- ▸2026本地LLM GPU购买指南 — 买与租决策背景
RunPod与Vast.ai问答
Vast.ai总是比RunPod便宜吗?▾
Vast.ai上的"可中断"是什么意思?▾
哪个更适合模型微调?▾
70B模型应该租用H100吗?▾
这些平台会单独收取存储和带宽费用吗?▾
想了解完整详情?
阅读完整指南 →相关 Prompt Bites