2026年、RunPodとVast.aiのどちらを使うべきですか?
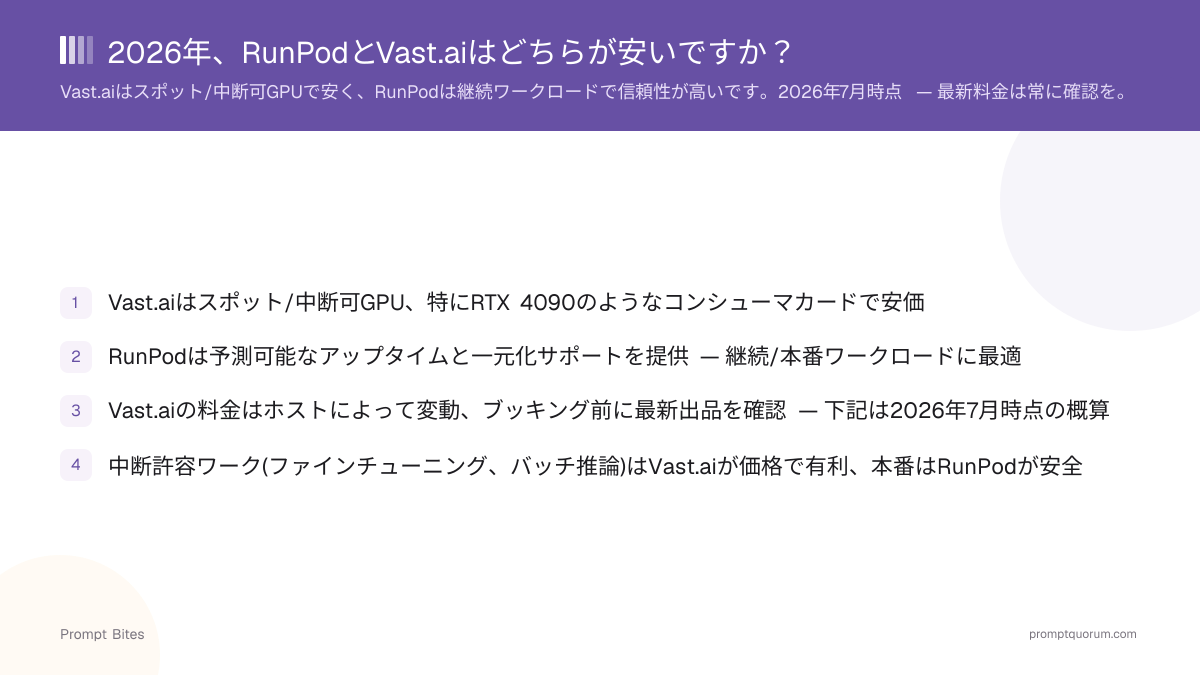
RunPodは予測可能なGPUレンタルにおいて、たいてい簡単な選択肢です — シンプルなデプロイ、出品比較不要、信頼できる可用性。Vast.aiは個々のホストが価格競争するマーケットプレイスであるため安くなることがありますが、そのためには出品を自分で比較し、より大きな変動を許容する必要があります。どちらが「安い」とは一概には言えません — シンプルさと最低価格のどちらを重視するかで正解が変わります。
このページには参考用の第三者製品へのリンクが含まれています。PromptQuorumはいかなるアフィリエイトプログラムにも参加しておらず、これらはコミッションを得ない単なる参照リンクです。リンクのクリックと次のステップはご自身の責任です。これらのリンクはPromptQuorumによる推奨や検証を表すものではありません。
クイック回答
シンプルで予測可能なデプロイを望むならRunPodが基本の選択です。利便性より最低価格が重要で、個々のホストの出品を比較する意思があるならVast.aiが良い選択です。
- ▸RunPod:マネージドクラウド、固定・公開料金、安定した可用性 — 本番運用や出品比較なしでデプロイしたい人に最適。
- ▸Vast.ai:ピアツーピアマーケットプレイス、ホストが自分で価格を設定 — 特にコンシューマGPUで大幅に安くなることがあるが、インスタンスが中断される可能性がある。
- ▸GPUレンタル価格は両プラットフォームで常に変動している — 記載された数字を信じるより、各サイトで最新料金を確認する。
重要なポイント
- ✓シンプルさと本番運用に最適:RunPod — マネージドクラウド、公開料金、安定した可用性
- ✓最低価格に最適:Vast.ai — 自分で出品を比較すれば、特にコンシューマGPUでRunPodを下回れるピアツーピアマーケットプレイス
- ✓絶対的に安いプロバイダーは存在しない — GPUレンタル価格は両プラットフォームで常に変動するため、このページの数字を鵜呑みにせずライブの料金を比較すること
- ✓70Bクラスのモデルでは自動的にH100を借りない方がよい — 推論用途では安価な48〜80GBカードの方が良い場合が多い
クイックアンサー
RunPodは予測可能なGPUレンタルにおいて、たいてい簡単な選択肢です — シンプルなデプロイ、簡単なセットアップで、素早くGPUを稼働させたい開発者に適しています。個々の出品を比較し、より大きな変動を許容できるなら、Vast.aiの方が安くなることがあります。
- ▸🏆 シンプルさで最適:RunPod — 予測可能なデプロイ、簡単なセットアップ、素早くGPUを稼働させたい開発者に最適
- ▸💰 最低価格で最適:Vast.ai — マーケットプレイス方式は、GPUの種類・場所・可用性に柔軟であれば非常に低価格を実現できる
- ▸🧑💻 本番運用で最適:RunPod — 信頼性とシンプルさが1時間あたり数セントの節約より重要な場合に選ぶ
RunPod vs Vast.ai 概観
これは価格表ではなく相対比較です — 両プラットフォームの正確な料金は変動が激しく、信頼できる形で記載できません。簡単さを求めるならRunPod。最低価格を求め、出品比較も厭わないならVast.ai。
RunPod:シンプルで予測可能なデプロイに最適
個々のGPU出品を探し回りたくないならRunPodが良い選択です。公開料金、安定した可用性、統一されたサポート窓口を備えたマネージドクラウドを運営しており、数十件の出品を比較することなくGPUを選んでデプロイできます。
向いている用途:Ollama、vLLM、ComfyUI、一般的なAI開発、一時的なGPUサーバー、モデルのテスト、推論。選ぶ理由:シンプルなデプロイ、開発者向けのツール、複数リージョンにわたる幅広いGPU選択肢、しっかりしたドキュメント、そして変動するマーケットプレイスより予算を立てやすい料金体系。
Vast.ai:最低価格を追求するなら最適
Vast.aiは仕組みが異なります — 独立したホストが利用可能なハードウェアを出品し、自分で価格を設定するマーケットプレイスです。この仕組みはマネージドクラウドより大幅に安い出品を生むことがありますが、ページ上で最安の出品が自動的に最良の取引とは限りません。
Vast.aiで借りる前に確認すべき点:GPUモデル、VRAM、時間あたりの価格、ホストの信頼性評価、帯域幅、ストレージ費用、物理的な所在地、そして提供者の評判・レビュー。評価の高いホストのやや高い出品の方が、レビューのない最安出品より良い選択であることが多いです。
$/時間だけで比較しない
このページで最も重要な料金の教訓はこれです:時間単価が安いGPUが、必ずしも高いGPUより安いとは限りません。安いマシンが著しく遅い場合は特にそうです。
ローカルLLM的な推論では、代わりに「有用な出力あたりのコスト」を計算してください — 時間単価を実際に得られる秒間トークン数で割った値です。時間単価が50%高くても秒間トークン数が2倍のGPUは、ページ上の時間単価が悪く見えても、より良い選択です。時間単価が安いマシンが自動的にお得とは限りません。
70Bモデルの場合
ここがローカルLLM読者にとってこの比較が最も重要になる部分です。Q4量子化の70Bモデルは一般に40GB以上のメモリを必要とし、A100 80GB、H100 80GB、A6000 48GB、H200 141GB、またはマルチGPU構成といった選択肢が候補になります。
自動的にH100やH200を借りないでください。トレーニングではなく推論を実行するなら、安価な48〜80GBカードの方が有用な出力あたりのコストで大きく上回ることがあります — 最速のGPUが最良の取引だと決めつける前に、上記の「$/時間だけで比較しない」セクションを参照してください。ハードウェア選択肢とそのトレードオフの詳細は、下記リンクの70Bモデルを最安で動かすガイドを参照してください。
短時間のジョブか24時間稼働か?
- ▸数時間のテスト:Vast.aiが非常に魅力的な選択肢になり得ます。
- ▸継続的な稼働:RunPodの方が管理しやすいことが多いです。
- ▸大規模なバッチワークロード:開始前に両方の現在の料金を比較してください。
- ▸本番アプリケーション:絶対的な最低時間単価より信頼性を優先してください。
関連記事
- ▸クラウドGPUの時間料金はいくら? — 70Bワークロードの実際のコストを計算する
- ▸70Bモデルをローカルで動かす最安の実践的方法 — ハードウェア購入がレンタルに勝つとき
- ▸2026年ローカルLLM向けGPU購入ガイド — 購入対レンタルの判断材料
RunPodとVast.aiのFAQ
Vast.aiは常にRunPodより安いですか?▾
Vast.aiの「中断可能」とはどういう意味ですか?▾
モデルのファインチューニングにはどちらが向きますか?▾
70Bモデルのために H100 を借りるべきですか?▾
これらのプラットフォームはストレージと帯域幅を別料金で請求しますか?▾
詳しく読みたいですか?
コンプリートガイドを読む →関連する Prompt Bites