Mistral Small 24B vs. Qwen3 14B vs. Llama 3.1 8B: Welches lokal ausführen?
Schnelle Antwort
Wählen Sie nach VRAM: Llama 3.1 8B (4,9 GB), Qwen3 14B (9,3 GB), Mistral Small 3.1 24B (14,4 GB). Qwen 14B gewinnt bei 12 GB VRAM. Mistral Small 24B gewinnt ab 16 GB bei Reasoning-Aufgaben.
- ▸Llama 3.1 8B Q4_K_M: 4,9 GB VRAM, ~45 tok/s auf RTX 4090, MMLU 66,6 % — beste Wahl für 6–8 GB Karten
- ▸Qwen3 14B Q4_K_M: 9,3 GB VRAM, ~28 tok/s, MMLU 74,8 % — optimaler Punkt für 12 GB Karten
- ▸Mistral Small 3.1 24B Q4_K_M: 14,4 GB VRAM, ~20 tok/s, MMLU ~81 % — nur für Karten mit 16 GB+
Wichtigste Punkte
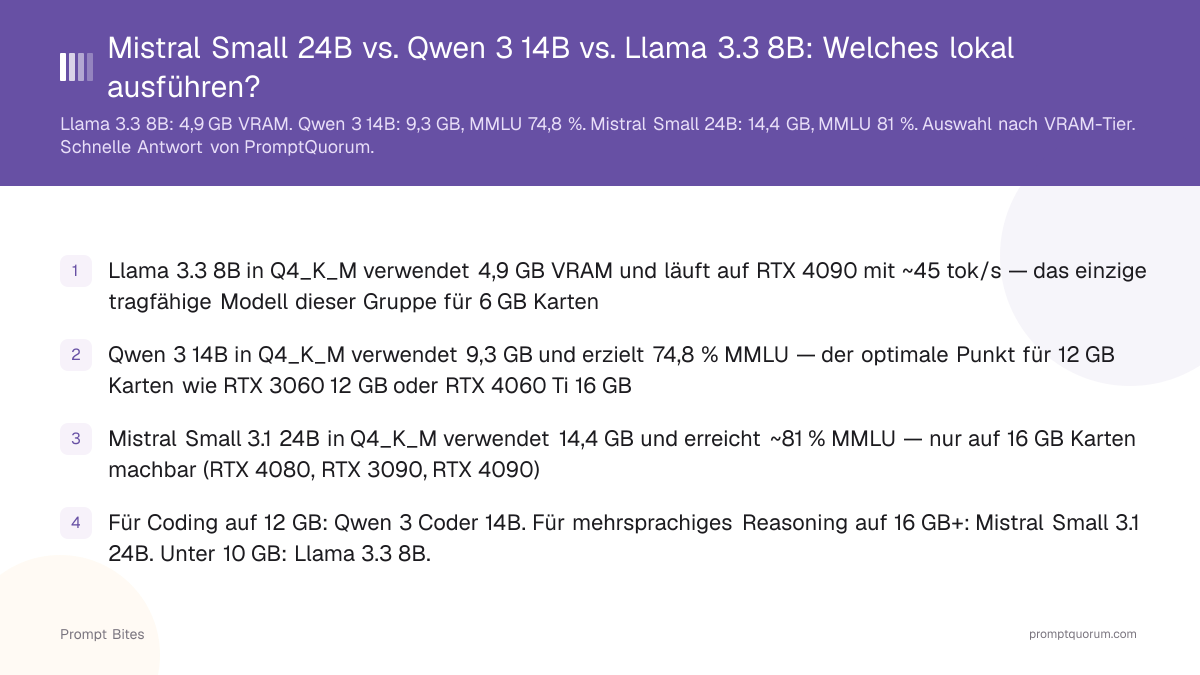
- ✓Llama 3.1 8B in Q4_K_M verwendet 4,9 GB VRAM und läuft auf RTX 4090 mit ~45 tok/s — das einzige tragfähige Modell dieser Gruppe für 6 GB Karten
- ✓Qwen3 14B in Q4_K_M verwendet 9,3 GB und erzielt 74,8 % MMLU — der optimale Punkt für 12 GB Karten wie RTX 3060 12 GB oder RTX 4060 Ti 16 GB
- ✓Mistral Small 3.1 24B in Q4_K_M verwendet 14,4 GB und erreicht ~81 % MMLU — nur auf 16 GB Karten machbar (RTX 4080, RTX 3090, RTX 4090)
- ✓Für Coding auf 12 GB: Qwen2.5-Coder 14B. Für mehrsprachiges Reasoning auf 16 GB+: Mistral Small 3.1 24B. Unter 10 GB: Llama 3.1 8B.
VRAM-Anforderungen: Welche Karte führt welches Modell aus
Die Wahl zwischen diesen drei Modellen ist primär eine VRAM-Entscheidung. Bei Q4_K_M-Quantisierung: Llama 3.1 8B verwendet 4,9 GB, Qwen3 14B 9,3 GB und Mistral Small 3.1 24B 14,4 GB. Dies ordnet sich direkt drei GPU-Tiers zu: 6–8 GB Karten (nur Llama 3.1 8B), 10–12 GB Karten (Qwen3 14B) und 16+ GB Karten (Mistral Small 24B).
Geschwindigkeit auf RTX 4090 bei Q4_K_M: Llama 3.1 8B läuft bei etwa 45 tok/s, Qwen3 14B bei ~28 tok/s und Mistral Small 3.1 24B bei ~20 tok/s. Auf einer RTX 3060 12 GB passen nur Llama 3.1 8B und Qwen3 14B — Mistral Small 24B benötigt mindestens eine 16 GB Karte, um kein CPU-RAM zu belegen.
Der Benchmark-Abstand ist bedeutsam: Mistral Small 24Bs 81 % MMLU liegt 14 Punkte über Llama 3.1 8B und 6 Punkte über Qwen3 14B. Bei komplexen mehrstufigen Reasoning- und Instruktionsbefolgungsaufgaben ist diese Lücke in der Praxis spürbar.
| Modell | VRAM (Q4_K_M) | Geschwindigkeit (RTX 4090) | MMLU | Mindest-GPU |
|---|---|---|---|---|
| Llama 3.1 8B | 4,9 GB | ~45 tok/s | 66,6 % | RTX 3060 6 GB |
| Qwen3 14B | 9,3 GB | ~28 tok/s | 74,8 % | RTX 3060 12 GB |
| Mistral Small 3.1 24B | 14,4 GB | ~20 tok/s | ~81 % | RTX 4080 16 GB |
Qualität vs. VRAM: Wann jedes Modell gewinnt
Llama 3.1 8B gewinnt bei VRAM-Effizienz. Mit 4,9 GB Q4_K_M ist es das einzige Modell dieser Gruppe, das auf eine 6 GB Karte passt und dabei noch Puffer für ein 4k-Token-Kontextfenster lässt. Es erzielt 66,6 % auf MMLU und liefert schnelle interaktive Antworten (~45 tok/s auf RTX 4090). Für Chat, schnelle Coding-Anfragen und den täglichen Einsatz auf eingeschränkter Hardware ist es die richtige Wahl.
Qwen3 14B gewinnt bei 12 GB VRAM. Mit 74,8 % MMLU liegt es deutlich über Llama 3.1 8B bei Reasoning und Coding — und passt in den verbreitetsten Prosumer-GPU-Tier. Die Qwen Coder 14B-Variante (gleiche Größe, code-optimiert) erzielt etwa 78 % auf HumanEval. Bei primärem Coding-Einsatz und 12 GB Karte ist Qwen3 14B die Antwort.
Mistral Small 3.1 24B gewinnt bei Qualität, wenn VRAM ausreicht. Mit 81 % MMLU und starker Mehrsprachleistung ist es die Top-Wahl für 16 GB Karten. Es bewältigt Long-Form-Reasoning, strukturierte Ausgabeaufgaben und komplexe Instruktionssets zuverlässiger als 14B-Klasse-Modelle. Auf einer RTX 4090 24 GB passt es bei Q5_K_M für noch bessere Qualität.
Für einen direkten 14B-Klasse-Vergleich siehe den Qwen 14B vs. Llama 8B-Vergleich, der Coding-Benchmark-Details enthält.