Wichtigste Erkenntnisse
- Whisper ist ein offenes Sprache-zu-Text-Modell, das lokal läuft – kein Audio verlässt Ihre Hardware
- Nutzen Sie das Whisper-(faster-whisper-)Add-on; es verbindet sich über Wyoming mit Assist
- Modellgrößen reichen tiny → base → small → medium → large; größer ist genauer, langsamer
- Auf reiner CPU-Hardware bevorzugen Sie tiny/base/small; eine GPU macht medium/large praktikabel
- Whisper ist mehrsprachig, sodass nicht-englische Befehle ohne Cloud-Dienst transkribiert werden
- Stimmen Sie Genauigkeit mit einem besseren Mikrofon und dem richtigen Modell ab, bevor Sie größer werden
- Die offizielle Whisper-App von Home Assistant basiert auf faster-whisper (wyoming-faster-whisper); für whisper.cpp gibt es keine offizielle Home-Assistant-App
- Einen direkten Geschwindigkeitsvergleich auf Home-Assistant-Hardware gibt es nicht: Die veröffentlichten Zahlen stammen aus unterschiedlichen Setups
- Piper übernimmt Text-to-Speech über Wyoming; MacWhisper ist eine Mac-Desktop-App, keine Home-Assistant-Komponente
Warum lokales Sprache-zu-Text nutzen?
Lokales Sprache-zu-Text hält Ihre Sprachaufnahmen auf Ihrer eigenen Hardware, sodass kein Audio an einen Dritten hochgeladen wird. Es funktioniert auch offline und hat keine Kosten pro Anfrage.
- Datenschutz: Cloud-Assistenten übertragen und behalten eventuell Aufnahmen; lokales Whisper nicht – siehe Smart-Home-Datenschutzrisiken.
- Offline: Die Transkription funktioniert bei Internetausfällen.
- Keine Gebühren: Für lokale Transkription gibt es keine Nutzungsgebühr.
Welche Whisper-Modellgröße sollten Sie nutzen?
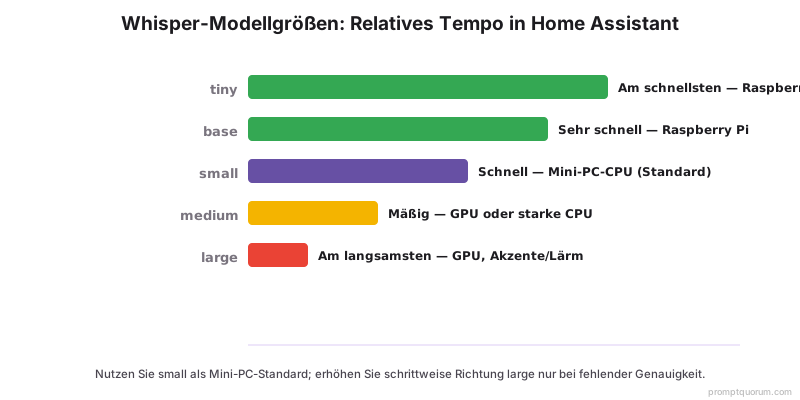
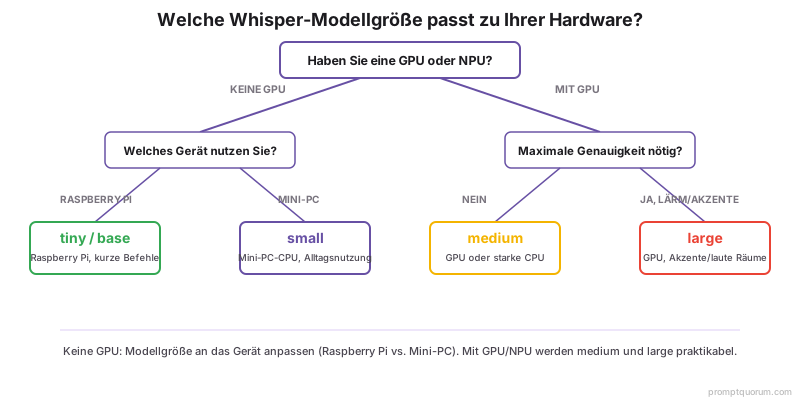
Wählen Sie das kleinste Whisper-Modell, das auf Ihrer Hardware akzeptable Genauigkeit liefert – tiny/base/small für reine CPU, medium/large, wenn Sie eine GPU haben. Größere Modelle verbessern die Genauigkeit bei Akzenten und verrauschtem Audio auf Kosten des Tempos.
- Nutzen Sie small als Standard auf einer Mini-PC-CPU; wechseln Sie nur zu medium/large, wenn die Genauigkeit fehlt.
- Nutzen Sie tiny/base auf einem Raspberry Pi, um die Latenz nutzbar zu halten.
Modell | Relative Genauigkeit | Relatives Tempo | Am besten für |
|---|---|---|---|
| tiny | Am niedrigsten | Am schnellsten | Stromsparende CPU, kurze Befehle |
| base | Niedrig | Sehr schnell | Raspberry Pi, einfache Phrasen |
| small | Gut | Schnell | Mini-PC-CPU, Alltagsnutzung |
| medium | Hoch | Mäßig | GPU oder starke CPU |
| large | Am höchsten | Am langsamsten | GPU, Akzente/laute Räume |
Wyoming-Einrichtung
Das Whisper-Add-on stellt einen Wyoming-Endpunkt bereit, den Assist für Sprache-zu-Text nutzt. Die Einrichtung ist: installieren → Modell wählen → in der Pipeline auswählen.
- 1Installieren Sie das Whisper-(faster-whisper-)Add-on aus dem Add-on-Store.
- 2Stellen Sie die Modellgröße in der Add-on-Konfiguration ein und starten Sie es.
- 3Das Add-on registriert sich automatisch als Wyoming-Sprache-zu-Text-Dienst.
- 4Setzen Sie unter Einstellungen → Sprachassistenten Whisper als STT-Engine für Ihre Assist-Pipeline.
- 5Testen Sie die Transkription über die Assist-Debug-Tools, bevor Sie Sprach-Hardware hinzufügen.
Hardware-Bedarf
Whisper läuft für kleine Modelle auf der CPU und profitiert bei medium/large-Modellen von einer GPU. Passen Sie die Modellgröße an das Gerät an, das es hostet.
- Raspberry Pi: bleiben Sie bei tiny/base für akzeptable Latenz.
- Mini-PC (CPU): small funktioniert gut; medium ist möglich, aber langsamer – siehe beste Hardware für ein lokales Smart Home.
- Mit einer GPU/NPU: medium und large werden für hohe Genauigkeit praktikabel.
- Sie können Whisper über Wyoming auf einer separaten, leistungsfähigeren Maschine betreiben, wenn Ihr Hub ein Pi ist.
Genauigkeit abstimmen
Verbessern Sie ein gutes Mikrofon und das richtige Modell, bevor Sie zum größten Whisper greifen. Die Audioqualität zählt bei Heimbefehlen oft mehr als die Modellgröße.
- Nutzen Sie ein hochwertiges Mikrofon oder Sprach-Satelliten-Hardware nahe am Sprecher.
- Reduzieren Sie Hintergrundgeräusche dort, wo das Mikrofon sitzt.
- Stellen Sie die korrekte Sprache im Add-on ein, um Fehltranskriptionen zu vermeiden.
- Erhöhen Sie die Modellgröße jeweils um eine Stufe und testen Sie erneut, statt zu large zu springen.
faster-whisper vs whisper.cpp für Home Assistant
Die offizielle Whisper-App von Home Assistant basiert auf faster-whisper; für whisper.cpp gibt es keine offizielle Home-Assistant-App, Sie müssen also einen separaten Wyoming-kompatiblen Server betreiben. Beide Engines führen OpenAIs Whisper-Modelle lokal aus; sie unterscheiden sich darin, wie sie sich in Assist einbinden.
- Home Assistant OS: Installieren Sie die Whisper-App unter Einstellungen > Apps; die Wyoming-Integration erkennt sie automatisch (Whisper-App-Doku). Apps hießen früher Add-ons.
- Standardmodell:
autowählttiny-int8auf ARM-Geräten wie dem Raspberry Pi 4 und sonstbase-int8; die-int8-Varianten sind etwas weniger genau, aber kleiner und schneller (Whisper-App-Doku). - Backends: Bei
stt_library=autonutzt Englisch ein Parakeet-Modell über sherpa, Chinesisch, Kantonesisch, Japanisch und Koreanisch nutzen SenseVoice über funasr, Russisch nutzt GigaAM, alles andere faster-whisper (Whisper-App-Doku). - Container oder separater Host: Starten Sie das Image
rhasspy/wyoming-whisper(im Beispiel Port 10300) und fügen Sie dann die Integration Wyoming Protocol mit Host und Port hinzu (wyoming-faster-whisper, Wyoming-Integrationsdoku). Wyoming-Dienste können auf einem anderen Gerät im lokalen Netz laufen, was zu ressourcenhungrigem Whisper passt. - GPU: Das NVIDIA-GPU-Image des Projekts wird nicht veröffentlicht; Sie bauen es selbst (etwa 10,7 GB gegenüber etwa 1,6 GB beim CPU-Image), und Home Assistant OS hat kein GPU-Passthrough (wyoming-faster-whisper).
- whisper.cpp: Das Beispiel
whisper-serverist ein HTTP-Server mit OpenAI-ähnlicher API, kein Wyoming-Server (whisper.cpp). Die Brücke rhasspy/wyoming-whisper-cpp ist archiviert; Community-Brücken existieren, wir haben aber keine getestet.
Aspekt | faster-whisper | whisper.cpp |
|---|---|---|
| Home-Assistant-App | Offizielle Whisper-App | Keine offizielle App |
| Wyoming-Server | wyoming-faster-whisper | wyoming-whisper-cpp (archiviert) |
| Installation auf HA OS | Einstellungen > Apps > Whisper | Separat betreiben, per Wyoming hinzufügen |
| Installation in Docker | Image rhasspy/wyoming-whisper | whisper-server (HTTP, nicht Wyoming) |
| GPU-Unterstützung | NVIDIA CUDA 12 + cuDNN 9 | CUDA, Vulkan, Metal, OpenVINO |
| CPU-Pfad | CTranslate2, int8 oder fp32 | Reines C/C++, quantisierte Modelle |
| Modelle | tiny bis large-v3, turbo, distil | ggml tiny bis large |
| Sprachen | Whispers 100 über Wyoming | Mehrsprachige und .en-Modelle |
Tempo: Was die veröffentlichten Benchmarks zeigen
Wir haben keine direkte Messung von faster-whisper und whisper.cpp auf Home-Assistant-Hardware gefunden, daher ist ein Vergleich für Raspberry Pi oder Mini-PC nicht möglich. Die einzigen Gegenüberstellungen stammen aus dem README von faster-whisper: 13 Minuten Audio auf einem Desktop-PC, mit faster-whisper v1.1.0 und whisper.cpp v1.7.2. Wir haben diese Tests nicht selbst durchgeführt.
- Das sind Transkriptionen 13-minütiger Dateien auf einer Desktop-GPU (CUDA 12.4) und einem Intel Core i7-12700K, keine 3-Sekunden-Sprachbefehle; sie sagen daher nichts über die Befehlslatenz auf Raspberry Pi oder Mini-PC voraus. Die Versionen sind älter als die aktuellen Releases.
- Die Home-Assistant-Doku nennt für Whisper „around 8 seconds" pro Sprachbefehl auf einem Raspberry Pi 4 und „under a second" auf einem Intel NUC; das Modell wird nicht genannt (Doku zu lokalem Assist).
- Dieselbe Seite nennt für Speech-to-Phrase, eine andere Engine, „under one second" auf Raspberry Pi 4 oder Home Assistant Green (Doku zu lokalem Assist).
- Das whisper.cpp-README enthält keine Zeittabelle; es verweist auf einen Community-Benchmark-Thread (Issue 89) und liefert das Beispiel
whisper-bench, mit dem Sie Ihre eigene Maschine messen.
Hardware und Modell | Engine und Einstellungen | Zeit, 13 Min. Audio |
|---|---|---|
| RTX 3070 Ti 8GB, large-v2 | faster-whisper, fp16, beam 5 | 1m03s |
| RTX 3070 Ti 8GB, large-v2 | whisper.cpp + Flash Attention, fp16, beam 5 | 1m05s |
| i7-12700K (8 threads), small | whisper.cpp, fp32, beam 5 | 2m05s |
| i7-12700K (8 threads), small | faster-whisper, fp32, beam 5 | 2m37s |
| i7-12700K (8 threads), small | faster-whisper, int8, beam 5 | 1m42s |
Modellgrößen und Speicherbedarf
Die Modellgröße bestimmt den Speicherbedarf am stärksten: Laut whisper.cpp-README sind es etwa 273 MB für tiny und etwa 3,9 GB für large. Die Werte unten stammen aus dem whisper.cpp-README.
- Das README von faster-whisper nennt für large-v2 auf der RTX 3070 Ti 4525MB VRAM (fp16) und 2926MB (int8) (faster-whisper-README).
- Für das small-Modell auf der CPU nennt dasselbe README 1477MB RAM (faster-whisper int8) und 2257MB (fp32); für whisper.cpp 1049MB (fp32).
- Die Whisper-App bietet außerdem
turbo(schneller alslarge-v3) und englischsprachige destillierte Modelle wiedistil-small.en(Whisper-App-Doku).
Modell | Datei (whisper.cpp) | Speicher (whisper.cpp) |
|---|---|---|
| tiny | 75 MiB | ~273 MB |
| base | 142 MiB | ~388 MB |
| small | 466 MiB | ~852 MB |
| medium | 1.5 GiB | ~2.1 GB |
| large | 2.9 GiB | ~3.9 GB |
Piper TTS: die Sprachausgabe der Voice-Pipeline
Piper ist die lokale Text-to-Speech-Engine im Voice-Setup von Home Assistant: Die Piper-App stellt sie über Wyoming bereit, so wie die Whisper-App das Sprache-zu-Text. Whisper versteht den Befehl, Piper spricht die Antwort.
- Installation: Einstellungen > Apps > Piper; die Wyoming-Integration erkennt sie (Piper-App-Doku). Außerhalb von Home Assistant OS läuft wyoming-piper als Wyoming-Server (im Beispiel Port 10200).
- Stimmen: Benannt nach
<language>_<REGION>-<name>-<quality>, Standarden_US-lessac-medium, automatisch von Hugging Face geladen. Die Qualitätenx_lowundlowhaben 16 kHz,mediumundhigh22,05 kHz. - Ressourcen: Laut App-Doku laufen auf einem Raspberry Pi 4 Stimmen bis
mediummit brauchbarer Geschwindigkeit; die Home-Assistant-Doku sagt, ein Pi mit Modellen mittlerer Qualität „can generate 1.6s of voice in a second" (Doku zu lokalem Assist). - Sprachen: Piper-Stimmenliste mit 44 Sprach- und Regionseinträgen, darunter Deutsch, Französisch, Spanisch, Portugiesisch (Brasilien und Portugal), Chinesisch und Arabisch (Jordanien). Einen japanischen oder koreanischen Eintrag haben wir dort nicht gefunden; die Piper-App dokumentiert optionale japanische und thailändische Stimmen, die einen zusätzlichen Phonemizer-Download brauchen (etwa 350 MB und 390 MB).
- Pflege: Das ursprüngliche Repository rhasspy/piper ist archiviert und verweist auf OHF-Voice/piper1-gpl (GPL-3.0), wo die Entwicklung weitergeht; laut README sucht die Open Home Foundation Maintainer. Das experimentelle Backend
omnivoiceder App klingt besser, ist aber „much slower" und „really needs a desktop or server CPU" (Piper-App-Doku). - Vertiefung: Piper-TTS-Test.
MacWhisper ist keine Home-Assistant-Komponente
MacWhisper ist eine Mac-Desktop-App und keine Home-Assistant-Komponente: Für Assist nutzen Sie die Whisper-App oder einen anderen Wyoming-Sprache-zu-Text-Server. MacWhisper transkribiert Audio, Video, Meetings und Systemaudio lokal auf Ihrem Mac; die Website erwähnt weder Home Assistant noch das Wyoming-Protokoll.
- MacWhisper für Dateien, Meetings und Diktat am Mac: MacWhisper-Test.
- Die Engines im direkten Vergleich: Vergleich lokaler Whisper-STT.
Projektaktivität
Die oben genannten Tools werden aktiv aktualisiert, mit Ausnahme der Wyoming-Brücke für whisper.cpp, die archiviert ist. Die Daten stammen aus dem jeweiligen GitHub-Repository.
Projekt | Letztes Release | Letzter Commit |
|---|---|---|
| faster-whisper | v1.2.1 (2025-10-31) | 2026-10-16 |
| whisper.cpp | v1.9.5 (2026-10-06) | 2026-10-12 |
| wyoming-faster-whisper | v3.8.1 (2026-09-14) | 2026-10-14 |
| wyoming-piper | v2.5.2 (2026-09-11) | 2026-09-11 |
| Piper (piper1-gpl) | v1.8.0 (2026-09-04) | 2026-10-17 |
| wyoming-whisper-cpp (archived) | Kein Release | 2024-02-29 |
⚠️Warnung: rhasspy/wyoming-whisper-cpp ist archiviert und wurde seit 2024-02-29 nicht mehr aktualisiert, ist also möglicherweise nicht mehr gepflegt: Prüfen Sie den aktuellen Stand einer Brücke, bevor Sie sich darauf verlassen. Auch das ursprüngliche Repository rhasspy/piper ist archiviert (letztes Update 2025-08-26).
Häufig gestellte Fragen
Was ist das Wyoming-Protokoll?
Wyoming ist das schlanke Netzwerkprotokoll, mit dem die Assist-Pipeline von Home Assistant mit Sprach-Add-ons kommuniziert — Speech-to-Text (wie das Whisper-Add-on), Text-to-Speech und Wake-Word-Erkennung. Es ermöglicht dem Add-on, als eigener Dienst zu laufen, sogar auf einer separaten, leistungsstärkeren Maschine, und sich automatisch bei Assist zu registrieren, statt eine manuelle API-Verkabelung zu benötigen. Sie konfigurieren Wyoming nicht direkt — die Installation des Whisper-Add-ons stellt einen Wyoming-Endpunkt bereit, den Assist erkennt und den Sie in Ihrer Pipeline auswählen können.
Welches Whisper-Modell sollte ich für Home Assistant nutzen?
Nutzen Sie small als Standard auf einer Mini-PC-CPU, tiny oder base auf einem Raspberry Pi und medium oder large nur, wenn Sie eine GPU haben und höhere Genauigkeit bei Akzenten oder lauten Räumen brauchen. Erhöhen Sie jeweils eine Stufe und testen Sie erneut.
Brauche ich eine GPU für lokales Whisper?
Nein für small und kleiner – die laufen auf der CPU. Eine GPU macht vor allem medium- und large-Modelle schnell genug für die Echtzeitnutzung. Sie können Whisper auch über das Wyoming-Protokoll auf eine leistungsfähigere Maschine auslagern.
Wie genau ist lokales Whisper offline?
Die Genauigkeit ist mit dem richtigen Modell und einem guten Mikrofon stark; größere Modelle bewältigen Akzente und Rauschen besser. Für klare Heimbefehle ist das small-Modell auf einem Mini-PC meist genau genug, und es läuft vollständig offline.
Ist lokales Whisper mehrsprachig?
Ja. Whisper unterstützt viele Sprachen, sodass nicht-englische Befehle lokal ohne Cloud-Dienst transkribiert werden. Stellen Sie die Sprache in der Add-on-Konfiguration für die besten Ergebnisse ein.
Ist faster-whisper oder whisper.cpp besser für Home Assistant?
faster-whisper ist der einfachere Weg, weil die offizielle Whisper-App von Home Assistant darauf basiert: Sie wird unter Einstellungen > Apps installiert und über die Wyoming-Integration erkannt. whisper.cpp hat keine offizielle App und braucht einen separaten Wyoming-kompatiblen Server. Die Projekte veröffentlichen Benchmarks auf unterschiedlicher Hardware mit unterschiedlichen Einstellungen, daher gibt es keinen direkten Geschwindigkeitsvergleich auf Home-Assistant-Hardware.
Kann ich whisper.cpp mit Home Assistant nutzen?
Ja, aber nicht über eine offizielle App. Home Assistant spricht mit Sprache-zu-Text-Engines über das Wyoming-Protokoll, während der whisper-server von whisper.cpp HTTP spricht. Die Brücke rhasspy/wyoming-whisper-cpp ist archiviert (letztes Update 2024-02-29); Community-Brücken existieren, wir haben sie nicht getestet. Einen Wyoming-Server fügen Sie unter Einstellungen > Geräte & Dienste mit Host und Port hinzu.
Was ist Piper in Home Assistant?
Piper ist eine lokale neuronale Text-to-Speech-Engine. Die Piper-App von Home Assistant stellt sie über Wyoming für gesprochene Antworten bereit, mit Stimmen wie en_US-lessac-medium. Die Entwicklung läuft bei OHF-Voice/piper1-gpl weiter; das ursprüngliche Repository rhasspy/piper ist archiviert.
Ist MacWhisper ein Home-Assistant-Add-on?
Nein. MacWhisper ist eine Mac-Desktop-App zum Transkribieren von Audio, Video und Meetings; die Website erwähnt weder Home Assistant noch Wyoming. Für Assist nutzen Sie die Whisper-App oder einen anderen Wyoming-Sprache-zu-Text-Server.