Wichtigste Erkenntnisse
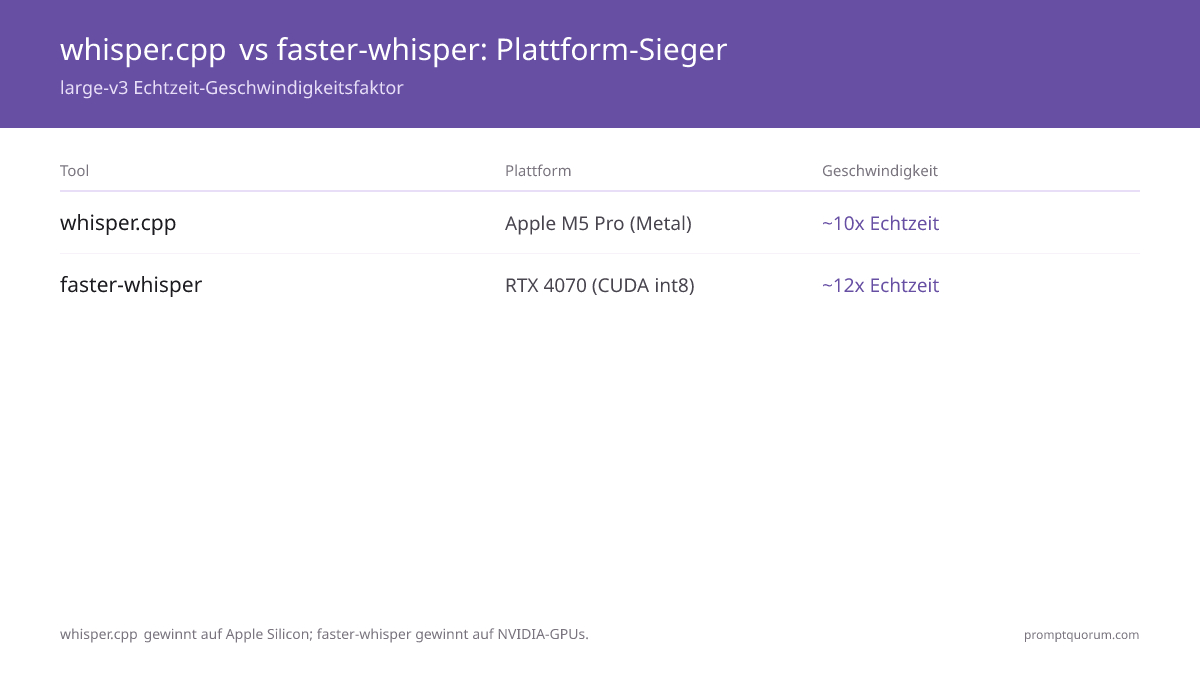
- whisper.cpp ist die beste lokale STT-Wahl für Apple Silicon. Der C/C++-Port nutzt Core ML und Apple Metal für Hardware-Beschleunigung – large-v3 mit ~10-facher Echtzeit auf dem M5 Pro, ohne Python-Abhängigkeit.
- faster-whisper ist die beste lokale STT-Wahl für NVIDIA-GPUs und Python-Pipelines. Die CTranslate2 int8-Quantisierung reduziert den VRAM-Bedarf um ~40 % und steigert den Durchsatz um ~4× gegenüber der ursprünglichen OpenAI-Implementierung – large-v3 mit ~12-facher Echtzeit auf dem RTX 4070 bei nur ~2,5 GB VRAM.
- Beide Tools verwenden identische Whisper-Modellgewichte von OpenAI. Der WER (Wortfehlerrate) ist bei beiden gleich – der Unterschied liegt ausschließlich in der Laufzeit-Performance und im Integrationspfad, nicht in der Transkriptionsgenauigkeit.
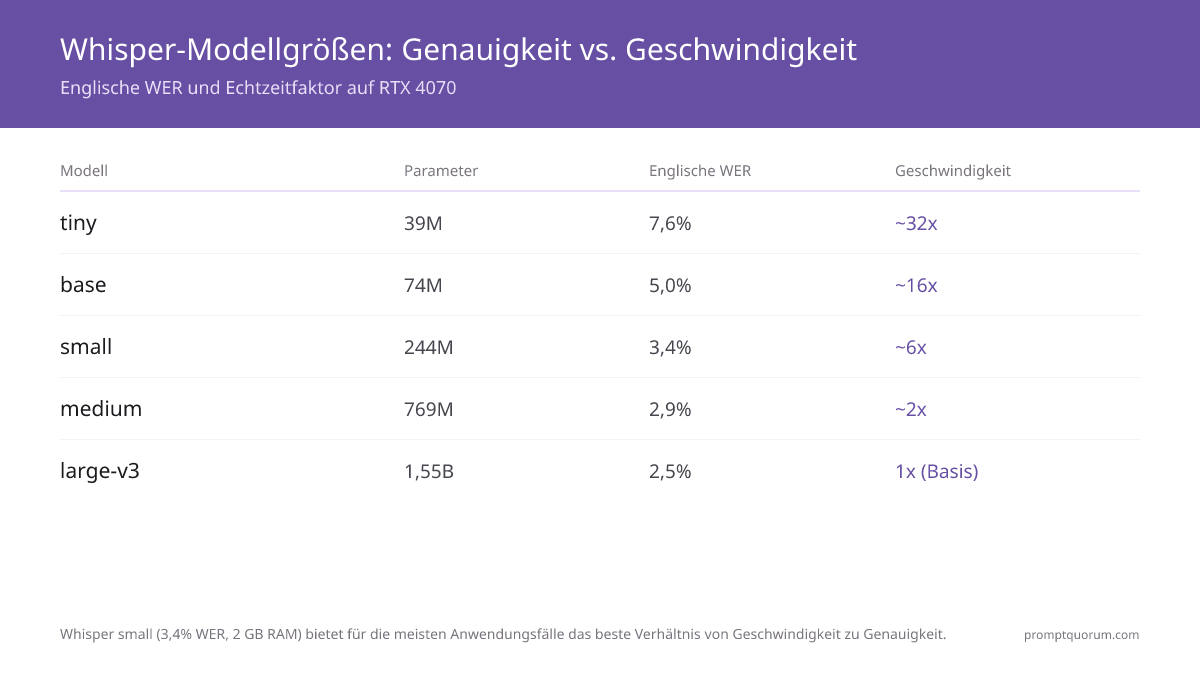
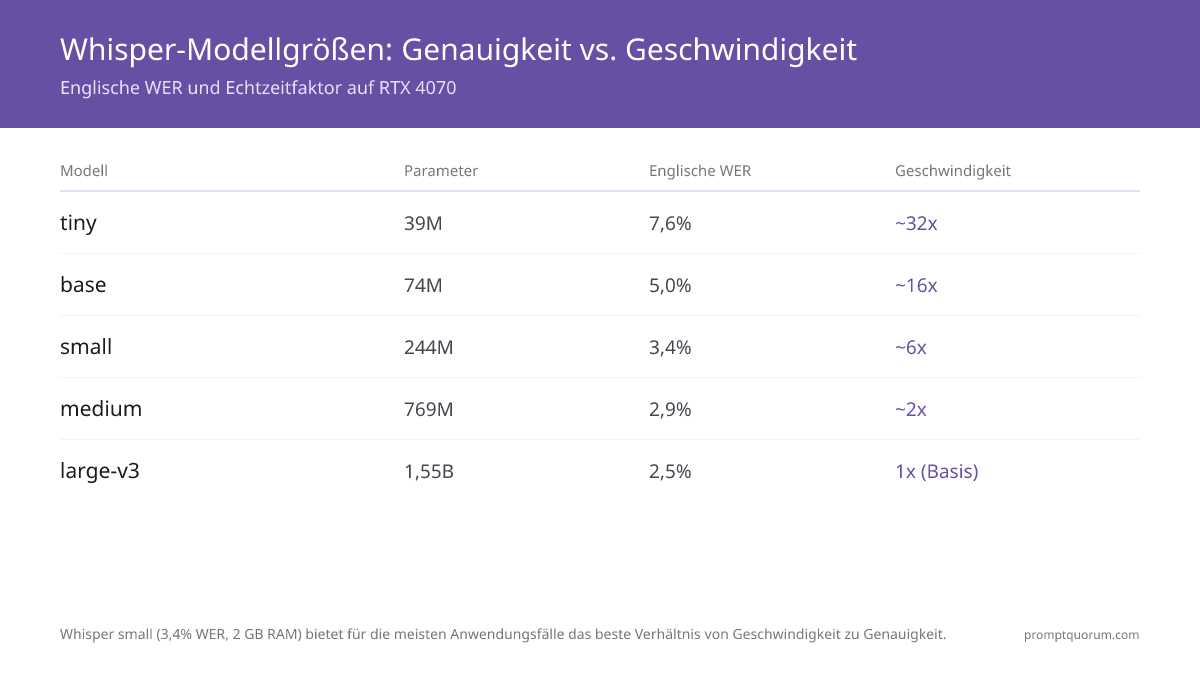
- Whisper large-v3 bietet die beste Genauigkeit mit 2,5 % WER auf Englisch. Für die meisten Produktivszenarien bietet Whisper small (3,4 % WER, 2 GB RAM) oder medium (2,9 % WER, 5 GB RAM) ein besseres Geschwindigkeit-Genauigkeits-Verhältnis.
- Echtzeit-Transkription ist mit beiden Tools erreichbar – whisper.cpp über den
--stream-Flag, faster-whisper über seine integrierte VAD-Pipeline (Sprachaktivitätserkennung). Die praktische Latenz liegt je nach Modellgröße bei 0,5–2 Sekunden hinter der Livesprache. - whisper.cpp läuft auf CPU, Metal, CUDA und Vulkan – und ist damit die naheliegende Wahl für plattformübergreifende Embedded-Nutzung (Raspberry Pi, Windows GPU-Setups, ARM-Server). faster-whisper unterstützt nur CPU und CUDA (kein Metal auf Mac).
- Für Raspberry Pi 5 und Embedded Linux sind whisper.cpp tiny und base auf der CPU die echtzeitfähigen Modelle – tiny läuft komfortabel schneller als Echtzeit, base etwa in Echtzeit mit
-t 4. Das small-Modell (3,4 % WER) läuft auf dem Pi 5 unterhalb der Echtzeit und eignet sich am besten für Batch-Jobs. Die gesamte Inferenz erfolgt auf der CPU (ARM NEON) – der Pi hat keinen nutzbaren GPU-Pfad für Whisper.
Auf einen Blick
- Beide Tools: Basieren auf OpenAIs quelloffenem Whisper-Modell (MIT-Lizenz). Gleiche Genauigkeit – unterschiedliche Laufzeiten.
- whisper.cpp: In C/C++ von Georgi Gerganov entwickelt. Unterstützt CPU (AVX2/NEON), CUDA, Metal (Apple), Vulkan. Kein Python erforderlich.
- faster-whisper: Python-Bibliothek auf Basis von CTranslate2. Unterstützt CPU (int8) und CUDA. Kein Apple Metal-Support.
- Whisper-Modellgrößen: tiny (39M), base (74M), small (244M), medium (769M), large-v3 (1,55B). Alle im GGML- / CTranslate2-Format.
- Bestes Modell für die meisten Anwendungsfälle: Whisper small – 3,4 % WER, läuft in 2 GB RAM, 6-fache Echtzeit auf modernem CPU.
- RTX 4070-Benchmark (large-v3): faster-whisper ~12-fache Echtzeit; whisper.cpp CUDA ~8-fache Echtzeit. faster-whisper gewinnt auf NVIDIA.
- M5 Pro-Benchmark (large-v3): whisper.cpp Metal ~10-fache Echtzeit; faster-whisper nur-CPU ~3-fache Echtzeit. whisper.cpp gewinnt auf Apple.
Warum lokale Spracherkennung?
Cloud-STT-Dienste (Google Speech-to-Text, AWS Transcribe, Azure Speech) berechnen Gebühren pro Audiominute – typischerweise ca. 0,005–0,022 €/Min. – und senden Audiodaten an externe Server. Für datenschutzsensible Anwendungen (medizinische Diktierlösungen, Rechtsaufzeichnungen, Journalisteninterviews, Unternehmensmeetings) eliminiert lokale Transkription das Datenschutzrisiko vollständig.
- Datenschutz: Audio verlässt niemals Ihr Gerät, sodass kein Cloud-Dienstleister an der Transkription beteiligt ist. Pflichten wie Rechtsgrundlage und sichere Speicherung bleiben bei Ihnen.
- Kosten: Keine minutenbasierten Gebühren. Ein Entwickler, der 8 Stunden Meetings pro Woche transkribiert, spart ca. 110–440 €/Monat gegenüber Cloud-STT-Preisen.
- Offline: Funktioniert im Flugzeug, in Sicherheitsbereichen, in Gebieten ohne stabiles Internet. Kein API-Schlüsselmanagement.
- Latenz: Kein Upload/Download-Roundtrip. Für Echtzeit-Sprachinterfaces reduziert lokale Verarbeitung die STT-Latenz von 300–800 ms (Cloud) auf 50–300 ms.
- Anpassbarkeit: Feinabstimmung auf domänenspezifisches Vokabular. Beliebige Modellgröße, die zur Hardware passt.
- Home-Assistant-Integration: Lokal laufendes Whisper bedeutet, dass Aktivierungswörter und Sprachbefehle das Heimnetzwerk nie verlassen. Siehe lokales Whisper in Home Assistant → für das Add-on-Setup, das Cloud-STT vollständig ersetzt.
Whisper-Modellgrößen – Grundlage beider Tools
Sowohl whisper.cpp als auch faster-whisper verwenden dieselben Whisper-Modellgewichte, konvertiert in das jeweilige Format (GGML für whisper.cpp, CTranslate2 für faster-whisper). Wählen Sie die Modellgröße anhand Ihres VRAM/RAM-Budgets und Ihrer Genauigkeitsanforderungen.
Modell | Parameter | VRAM / RAM | Englisch WER | Faktor vs. Echtzeit (RTX 4070) |
|---|---|---|---|---|
| tiny | 39M | ~1 GB | 7,6 % | ~32× |
| base | 74M | ~1 GB | 5,0 % | ~16× |
| small | 244M | ~2 GB | 3,4 % | ~6× |
| medium | 769M | ~5 GB | 2,9 % | ~2× |
| large-v3 | 1,55B | ~10 GB | 2,5 % | 1× (Referenz) |
| distil-large-v3 | ~756M | ~4 GB | ~2,6 % | ~6× |
WER-Werte (Wortfehlerrate) aus dem Whisper-Paper auf dem LibriSpeech Clean Test Set. Niedrigerer Wert ist besser. Geschwindigkeitsfaktoren für faster-whisper int8 auf RTX 4070. distil-large-v3-Werte aus dem Distil-Whisper-Paper.
Distil-Whisper: Die schnellere Alternative
distil-whisper/distil-large-v3 ist eine destillierte Variante von large-v3 mit ~50 % weniger Parametern, die ~6× schneller läuft und dabei den WER nur um ~1 % erhöht. Es ist die richtige Wahl, wenn Transkriptionsgeschwindigkeit wichtiger ist als das letzte Stück Genauigkeit. distil-large-v3 funktioniert sowohl mit faster-whisper (native CTranslate2-Unterstützung) als auch mit whisper.cpp (über GGML-Format-Konvertierung).
- Parameter: ~756M – etwa halb so viele wie large-v3s 1,55B; passt in ~4 GB VRAM statt ~10 GB.
- Geschwindigkeit: ~6-fache Echtzeit auf RTX 4070 (vs. 1× Referenz für large-v3) – vergleichbar mit medium in der Geschwindigkeit, bei large-v3-naher Genauigkeit.
- WER: ~2,6 % auf Englisch – nur ~0,1 % höher als large-v3s 2,5 %. In der Praxis kaum hörbarer Unterschied bei typischer Sprachqualität.
- Kompatibilität: Funktioniert mit faster-whisper nativ (
WhisperModel("distil-large-v3", device="cuda", compute_type="int8")). Für whisper.cpp: Konvertierung ins GGML-Format mit dem distil-whisper GGML-Konvertierungsskript. - Am besten geeignet für: Batch-Transkriptionsjobs, Server-Deployments mit begrenztem VRAM und alle Anwendungsfälle, bei denen large-v3-Qualität bei medium-Modell-Geschwindigkeit benötigt wird.
- Nicht geeignet für: Mehrsprachige Transkription – distil-large-v3 ist ausschließlich für Englisch optimiert. Für andere Sprachen: large-v3 oder medium verwenden.
whisper.cpp – Der C/C++-Port
whisper.cpp (von Georgi Gerganov) ist eine reine C/C++-Neuimplementierung von OpenAIs Whisper-Modell, optimiert für ressourcenarme und plattformübergreifende Inferenz. Kein Python, kein CUDA-Toolkit erforderlich – läuft auf nahezu jeder Hardware, vom Raspberry Pi bis zum Apple M5 Pro und Windows CUDA-Setups.
- Plattformunterstützung: CPU (AVX2, AVX512, ARM NEON), Apple Metal (Core ML), CUDA (NVIDIA), Vulkan (AMD/Intel GPU), OpenCL.
- Apple-Silicon-Vorteil: whisper.cpp exportiert Modelle ins Core ML-Format und ermöglicht damit Inferenz auf der Apple Neural Engine. Large-v3 läuft mit ~10-facher Echtzeit auf dem M5 Pro über Metal – schneller als jeder Cloud-Roundtrip.
- Installation: Repository klonen,
make(odercmake) ausführen. Vorgefertigte Binaries für gängige Plattformen verfügbar. Keine Python-Abhängigkeit. - Modell-Download:
bash ./models/download-ggml-model.sh base.en– lädt die GGML-Modelldatei herunter (~142 MB für base). - CLI-Beispiel:
./main -m models/ggml-base.bin -f audio.wav– transkribiert eine WAV-Datei nach stdout.-l defür Deutsch hinzufügen. - Echtzeit-Stream-Modus:
./stream -m models/ggml-base.bin --step 3000 --length 10000– transkribiert in 3-Sekunden-Chunks vom Mikrofon. - Python-Wrapper: pywhispercpp bietet eine Python-Anbindung für whisper.cpp und ermöglicht die Nutzung in Python-Pipelines ohne Verlust der Metal-Beschleunigung.
- Einschränkung: Kein nativer VAD (Sprachaktivitätserkennung). Der Stream-Modus erfordert die Feinabstimmung der Parameter
--stepund--lengthfür den jeweiligen Anwendungsfall.
# Build from source (macOS / Linux)
git clone https://github.com/ggerganov/whisper.cpp
cd whisper.cpp
make -j4

# Download a model
bash ./models/download-ggml-model.sh large-v3

# Transcribe a file
./main -m models/ggml-large-v3.bin -f recording.wav

# Enable Metal on Apple Silicon (Core ML)
make -j4 WHISPER_COREML=1
./main -m models/ggml-large-v3-encoder.mlmodelc -f recording.wav
whisper.cpp – Aktuelle Version & Updates
Die neueste whisper.cpp-Version ist v1.9.5, veröffentlicht am 6. Oktober 2026. Sie synchronisiert die gebündelte ggml-Bibliothek auf v0.26.0 mit Backend-Arbeiten für CUDA, Vulkan, Metal, SYCL, OpenCL und CPU-Kernels und bringt Whisper-Korrekturen wie einen Abbruch-Callback bei der Spracherkennung und eine Integer-Overflow-Korrektur bei parallelen Chunk-Offsets. whisper.cpp ist außerdem offiziell als Debian-Paket (sid) verfügbar (whisper.cpp, libwhisper-dev, libwhisper1), zusätzlich zum langjährigen inoffiziellen Snap. Die neueste getaggte faster-whisper-Version ist weiterhin v1.2.1 (31. Oktober 2025), das Repository wird aber aktiv gepflegt: Commits gab es zuletzt am 16. Oktober 2026. Beide Runtimes laden weiterhin dieselben OpenAI-Whisper-Gewichte; an der Transkriptionsgenauigkeit hat sich 2026 nichts geändert.
- whisper.cpp v1.9.5 (6. Oktober 2026): ggml-Sync auf v0.26.0 mit Updates für CUDA-, Vulkan-, Metal-, SYCL-, OpenCL-, WebGPU- und CPU-Kernels, ein Abbruch-Callback bei der Spracherkennung, Korrektur eines Integer-Overflows bei parallelen Chunk-Offsets und korrekter Fehlercode der CLI, wenn eine Datei fehlschlägt.
- whisper.cpp v1.9.4 (11. September 2026): Der Server liefert jetzt die erkannte Sprache zurück, der Encoder-Callback läuft vor der automatischen Spracherkennung, und Windows on ARM wurde zum Release-Job hinzugefügt.
- whisper.cpp v1.9.3 (20. August 2026): ggml-Sync auf v0.20.2 mit durchgängigen Performance-Verbesserungen, Metal-TQ2_0-Quantisierung, fusionierten CUDA/SYCL-Kernels und ARM/WASI-Korrekturen.
- whisper.cpp v1.9.0–v1.9.2 (Juni–August 2026): Punktreleases in derselben ggml-Sync- und Performance-Linie vor v1.9.3.
- whisper.cpp v1.8.6 (2. Juni 2026): Neu implementiertes
ffmpeg-transcodefür klarere optionale FFmpeg-Dekodierung komprimierter Audiodateien (MP3, M4A) plus eine Korrektur des CI-Beispielpfads. - whisper.cpp v1.8.5 (Mai 2026): Verbesserungen beim Streaming-VAD (Sprachaktivitätserkennung), Korrekturen für Server-Parameter-Leaks und Token-Zeitstempel sowie Behebung von Speicherlecks in den Ruby- und VAD-Bindings.
- whisper.cpp v1.8.4 (19. März 2026): Neueste
ggml-Synchronisierung mit breiten Performance-Gewinnen, ein neuer-g/--gpu-device-Flag (undGGML_CUDA-Geräteauswahl) zur GPU-Wahl sowie Korrekturen beim UTF-8-Segmentumbruch. - Nativer VAD ist jetzt in whisper.cpp integriert. Aktuelle Versionen haben einen nativen Pfad zur Sprachaktivitätserkennung ergänzt und verringern damit einen langjährigen Vorteil von faster-whisper – auch wenn die Silero-VAD-Integration von faster-whisper weiterhin gebrauchsfertiger ist.
- faster-whisper v1.2.1 (31. Oktober 2025): Neueste getaggte Version;
pip install faster-whisperinstalliert sie. 2026 gab es keine getaggte Version, der Main-Branch ist aber aktiv: Commits vom 16. Oktober 2026 ergänzen Eingabeprüfungen, etwa einen Fehler für Sprachen, die ein Modell nicht unterstützt. v1.2.0 (August 2025) brachte Unterstützung für distil-large-v3.5. - CTranslate2 v4.8.3 (13. Oktober 2026): Die Inferenz-Engine unter faster-whisper wird weiter gepflegt. Die v4.8-Linie brachte Windows-ROCm-Korrekturen, Härtung beim Modellladen und eine Korrektur für eine Division durch null in Whisper
align(), wenn ein Fenster keine Frames enthält. - Kein neues Whisper-Modell mit höherer Genauigkeit 2026. OpenAIs neueste mehrsprachige Gewichte bleiben large-v3-turbo (Oktober 2024; 809M Parameter, Decoder von 32 auf 4 Schichten reduziert, MIT-Lizenz), das einen kleinen Qualitätsverlust gegen deutlich mehr Geschwindigkeit eintauscht und in beiden Tools läuft. distil-large-v3 bleibt die rein englische Speed-Option. Updates an beiden Runtimes betreffen Laufzeit und Tooling, nicht die Genauigkeit.
faster-whisper – Der CTranslate2-Port
faster-whisper (von SYSTRAN) ist eine Python-Bibliothek, die Whisper-Inferenz mit CTranslate2 – einer hochoptimierten C++-Inferenz-Engine mit int8-Quantisierungsunterstützung – neu implementiert und dadurch VRAM-Bedarf reduziert und Durchsatz erhöht. Auf NVIDIA-GPUs ist faster-whisper die schnellste verfügbare lokale Whisper-Implementierung.
- Plattformunterstützung: CPU (int8-Quantisierung) und NVIDIA CUDA GPU. Kein Apple Metal-Support – läuft auf Mac nur über CPU.
- int8-Vorteil: CTranslate2 int8-Quantisierung reduziert den VRAM-Bedarf um ~40 % und erhöht die Inferenzgeschwindigkeit um ~2× gegenüber float16 bei vernachlässigbarer WER-Auswirkung (< 0,1 % absolut).
- Installation:
pip install faster-whisper– keine Kompilierung erforderlich (Python 3.9+). GPU-Nutzung erfordert NVIDIA cuBLAS für CUDA 12 und cuDNN 9; ältere CUDA-11-/cuDNN-8-Setups müssen ein älteresctranslate2(3.24.0) pinnen. - Integrierter VAD: faster-whisper enthält Silero VAD-Integration, die stille Audiosegmente automatisch überspringt – entscheidend für Echtzeit-Transkriptions-Pipelines.
- Python-nativ: Die direkte Python-API macht es trivial, faster-whisper mit LLMs, Audio-Verarbeitungsbibliotheken und Web-Frameworks zu verbinden.
- Geschwindigkeit: large-v3 int8 auf RTX 4070 mit ~12-facher Echtzeit und ~2,5 GB VRAM. CPU int8 erreicht ~20-fache Echtzeit für das tiny-Modell.
- Batch-Verarbeitung: faster-whisper unterstützt Batch-Inferenz für die effiziente Verarbeitung großer Audio-Archive.
- Einschränkung: Kein Metal-Support auf Mac – läuft auf Apple Silicon nur über CPU mit ~3-facher Echtzeit für large-v3 vs. whisper.cpps ~10-fache mit Metal.
from faster_whisper import WhisperModel

# Load model (downloads automatically on first run)
model = WhisperModel("large-v3", device="cuda", compute_type="int8")

# Transcribe
segments, info = model.transcribe("audio.wav", beam_size=5)

print(f"Detected language: {info.language} (probability: {info.language_probability:.2f})")
for segment in segments:
    print(f"[{segment.start:.2f}s → {segment.end:.2f}s] {segment.text}")
ggml-base.bin per pip beziehen (Python-Setup)
Um ggml-base.bin aus Python per pip zu nutzen, installieren Sie das pywhispercpp-Binding – pip install pywhispercpp – und laden dann Model("base"), das ggml-base.bin beim ersten Lauf automatisch herunterlädt. Es gibt kein pip install whisper.cpp; pywhispercpp ist der pip-Wrapper um die whisper.cpp-C/C++-Engine und behält Metal- und CUDA-Beschleunigung bei. Die GGML-Modelldatei (ggml-base.bin, ~142 MB) wird separat von Hugging Face heruntergeladen und lokal zwischengespeichert – das pip-Paket liefert die Inferenz-Engine, nicht die Gewichte.
📍 In einem Satz
pip install pywhispercpp ausführen; dann lädt Model("base") in Python ggml-base.bin beim ersten Aufruf automatisch herunter und speichert es zwischen.
💬 In einfachen Worten
pip installiert das Programm (pywhispercpp); die Modelldatei ggml-base.bin ist ein separater ~142-MB-Download, der beim ersten Laden des „base“-Modells erfolgt – oder den Sie manuell mit dem Skript download-ggml-model.sh holen.
- Binding installieren:
pip install pywhispercpp. Für NVIDIA-CUDA-Beschleunigung mitGGML_CUDA=1 pip install git+https://github.com/absadiki/pywhispercppbauen. - ggml-base.bin automatisch herunterladen:
from pywhispercpp.model import Model, dann lädtmodel = Model("base")beim ersten Laufggml-base.binvon Hugging Face (ggerganov/whisper.cpp) herunter und speichert es zwischen."base.en"für die rein englische Variante verwenden. - Manueller Download (CLI-Weg, ohne pip): In einem geklonten whisper.cpp-Repo speichert
bash ./models/download-ggml-model.sh basedie Datei untermodels/ggml-base.bin– dieselbe Datei, die pywhispercpp abruft. - Direkter Download:
curl -L -o ggml-base.bin https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.binlädt das Modell ohne Skript.basedurchtiny,small,mediumoderlarge-v3ersetzen. - Die Pakete nicht verwechseln:
pip install openai-whisperinstalliert OpenAIs ursprüngliches PyTorch-Whisper (es nutzt.pt-Checkpoints, nichtggml-base.bin).pip install faster-whispernutzt das CTranslate2-Format. Nurpywhispercppverarbeitet GGML-ggml-*.bin-Dateien. - Wo die Datei liegt: pywhispercpp speichert heruntergeladene GGML-Modelle in seinem Modul-Cache (oder einem Pfad, den Sie über
Model("base", models_dir="...")übergeben), sodass dieselbeggml-base.binüber mehrere Läufe wiederverwendet wird – kein erneuter Download.
# 1. Install the pip binding for whisper.cpp
pip install pywhispercpp

# 2. ggml-base.bin downloads automatically on first use
#    from pywhispercpp.model import Model
#    model = Model("base")          # fetches & caches ggml-base.bin (~142 MB)
#    for seg in model.transcribe("audio.wav"):
#        print(seg.text)

# --- Or get ggml-base.bin manually (no pip) ---
# From a cloned whisper.cpp checkout:
bash ./models/download-ggml-model.sh base       # -> models/ggml-base.bin

# Or download the file directly from Hugging Face:
curl -L -o ggml-base.bin \
  https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.bin
Direktvergleich: Benchmark-Tabelle
Alle Benchmarks verwenden das large-v3-Modell, sofern nicht anders angegeben. Die Geschwindigkeit wird in Vielfachen der Echtzeit gemessen (z. B. 10× bedeutet: 60 Minuten Audio werden in 6 Minuten transkribiert). VRAM-Angaben für GPU-Läufe; RAM-Angaben für CPU-Läufe.
📍 In einem Satz
Auf Apple Silicon läuft whisper.cpp mit Metal large-v3 mit ~10-facher Echtzeit; auf NVIDIA-GPUs erreicht faster-whisper mit int8 ~12-fache Echtzeit – jedes Tool gewinnt klar auf seiner Zielplattform.
💬 In einfachen Worten
Auf dem Mac: whisper.cpp wählen (nutzt die Apple Neural Engine); auf Windows/Linux mit NVIDIA GPU: faster-whisper wählen (verarbeitet Audio 12× schneller als Echtzeit bei 40 % weniger GPU-Speicher).
Metrik | whisper.cpp (large-v3) | faster-whisper (large-v3) |
|---|---|---|
| Plattform / Sprache | C/C++ (plattformübergreifend) | Python (CTranslate2) |
| GPU-Unterstützung | CUDA, Metal, Vulkan | Nur CUDA |
| CPU-Optimierung | AVX2, ARM NEON | int8-Quantisierung |
| Geschwindigkeit – RTX 4070, large-v3 | ~8-fache Echtzeit | ~12-fache Echtzeit ✓ |
| Geschwindigkeit – M5 Pro, large-v3 | ~10-fache Echtzeit (Metal) ✓ | ~3-fache Echtzeit (nur CPU) |
| Geschwindigkeit – nur CPU (x86), base | ~15-fache Echtzeit | ~20-fache Echtzeit ✓ |
| VRAM – large-v3, GPU | ~3 GB | ~2,5 GB (int8) ✓ |
| Python-Integration | Wrapper nötig (pywhispercpp) | Nativ ✓ |
| VAD (Stilles Audio erkennen) | Manuell (--step-Tuning) | Integriert (Silero VAD) ✓ |
| Echtzeit-Streaming | Ja (--stream-Flag) ✓ | Ja (VAD-Pipeline) |
| WER-Genauigkeit (large-v3) | 2,5 % (identisch) | 2,5 % (identisch) |
| Python-Abhängigkeit | Keine ✓ | Python 3.9+ |
| Raspberry Pi / Embedded | Ja – C-Binary ✓ | Eingeschränkt – Python-Overhead |
| Ausgabeformate | SRT, VTT, JSON, CSV, txt | Python-Objekte (start, end, text) |
whisper.cpp schreibt die Ausgabe direkt in gängige Untertitel- und Transkriptformate (SRT, VTT, JSON, CSV, txt) – ideal für Untertitel-Workflows. faster-whisper liefert einen Python-Generator von Segment-Objekten mit start-, end- und text-Attributen – ideal für LLM-Pipeline-Chaining. Für Untertitel-Generierung ist whisper.cpp einfacher; für Pipelines, die Segmente programmatisch verarbeiten, ist faster-whisper einfacher.
Referenz-Benchmark: GPU- vs. CPU-Laufzeiten von faster-whisper
Das faster-whisper-Projekt veröffentlicht eigene Laufzeiten für eine 13-minütige Audiodatei — sie zeigen, dass whisper.cpp mit Flash Attention auf einer GPU mit faster-whisper fp16 gleichzieht, während Batching und int8 faster-whisper den Vorsprung geben. Die Werte stammen aus der faster-whisper-README (large-v2 auf einer RTX 3070 Ti 8 GB mit CUDA 12.4 für die GPU-Zeilen; das small-Modell auf einem Intel Core i7-12700K mit 8 Threads für die CPU-Zeilen; Beam Size 5). Es sind nicht unsere eigenen Messungen, und Hardware und Modelle unterscheiden sich von den large-v3-Werten oben.
📍 In einem Satz
Im README-Benchmark von faster-whisper liegen whisper.cpp mit Flash Attention (1m05s) und faster-whisper fp16 (1m03s) auf der GPU praktisch gleichauf; faster-whisper int8 mit Batching schafft dieselbe 13-Minuten-Datei in 16 Sekunden.
Setup | Präzision | Zeit | VRAM / RAM |
|---|---|---|---|
| GPU · whisper.cpp (Flash Attn) | fp16 | 1m05s | 4127 MB |
| GPU · faster-whisper | fp16 | 1m03s | 4525 MB |
| GPU · faster-whisper | int8 | 59s | 2926 MB |
| GPU · faster-whisper, Batch 8 | int8 | 16s | 4500 MB |
| CPU · whisper.cpp | fp32 | 2m05s | 1049 MB |
| CPU · faster-whisper | int8 | 1m42s | 1477 MB |
| CPU · faster-whisper, Batch 8 | int8 | 51s | 3608 MB |
Lesen Sie dies neben der Direktvergleich-Tabelle: Bei einzelnem fp16-Stream liegt die GPU-Geschwindigkeit beider Tools in diesem Setup nah beieinander. Die bleibenden Vorteile von faster-whisper sind die int8-Speicherersparnis (2,9 GB vs. 4,1–4,5 GB bei fp16) und die Batch-Inferenz (16 s vs. 59 s). Auf der CPU liegen whisper.cpp fp32 und faster-whisper int8 ohne Batching etwa 25 % auseinander.
Echtzeit-Transkription einrichten
Echtzeit-Transkription verarbeitet Audio in Chunks, wie es vom Mikrofon ankommt, und erzeugt Text mit einer kurzen Verzögerung gegenüber der Sprache. Beide Tools unterstützen dies, jedoch mit unterschiedlichen Trade-offs.
- whisper.cpp Stream-Modus:
./stream -m models/ggml-small.bin --step 3000 --length 10000 -t 4ausführen. Verarbeitet 3-Sekunden-Audio-Chunks; ~0,5–1,5 Sekunden Verzögerung mit dem small-Modell. Kein Python erforderlich. - faster-whisper VAD-Pipeline:
vad_filter=Trueinmodel.transcribe()verwenden. Silero VAD segmentiert Audio automatisch an Stille-Grenzen – natürlichere Chunks als bei festen Zeitfenstern. - Praktische Latenz: 0,5–2 Sekunden hinter der Livesprache mit small- oder medium-Modellen. Tiny verwenden für geringste Latenz (< 0,5 Sekunden, aber höherer WER).
- Modellwahl für Echtzeit: small oder base ist der praktische Sweet Spot – schnell genug, um mit der Sprache mitzuhalten, genau genug für sauberes Audio. large-v3 nur für Echtzeit verwenden, wenn eine dedizierte GPU verfügbar ist.
- Mikrofon-Eingabe: whisper.cpp liest Rohaudiosignale über SDL2 oder portaudio. faster-whisper liest Audio-Arrays aus beliebigen Python-Audiobibliotheken (sounddevice, pyaudio, soundfile).
- Stabilität: whisper.cpp stream mode kann bei Stille wiederholte Tokens erzeugen. Mit
--suppress-blankund--no-speech-thresholdunterdrücken.
Apple Silicon: whisper.cpp gewinnt
Auf M1, M2, M3, M4 und M5 Macs ist whisper.cpp mit Core ML / Metal-Beschleunigung das richtige Tool – ohne Frage. faster-whisper hat keinen Metal-Support und läuft auf dem Mac nur über CPU mit rund 3-facher Echtzeit für large-v3. whisper.cpp mit Metal erreicht ~10-fache Echtzeit auf dem M5 Pro – ein 3-facher Geschwindigkeitsvorteil.
- Core ML-Export:
./models/generate-coreml-model.sh large-v3ausführen, um den Encoder ins Core ML-Format zu exportieren. Dies verlagert die Encoder-Inferenz auf die Apple Neural Engine. - M5 Pro-Benchmark (large-v3, Metal): ~10-fache Echtzeit. 60 Minuten Audio werden in ~6 Minuten transkribiert. Hinweis: Der M5 Pro wurde im März 2026 eingeführt – dies sind frühe Community-Benchmarks. Die Performance kann sich mit whisper.cpp-Updates verbessern, die für die M5 Neural Engine optimiert sind.
- M3 MacBook Air-Benchmark (large-v3, Metal): ~7-fache Echtzeit. 60 Minuten in ~8,5 Minuten.
- Arbeitsspeicher: Unified Memory bedeutet kein separater VRAM – ein 16 GB M5 Pro kann large-v3 (~3 GB) problemlos neben anderen Prozessen ausführen.
- faster-whisper auf Mac: Nur CPU, int8. Large-v3 mit ~3-facher Echtzeit. Für Batch-Transkription über Nacht nutzbar, aber nicht für Echtzeit oder zeitkritische Workflows.
- Empfehlung: whisper.cpp für alle Mac-STT-Aufgaben verwenden. pywhispercpp hinzufügen, wenn Python-Integration bei gleichzeitiger Metal-Beschleunigung benötigt wird.
NVIDIA GPU: faster-whisper gewinnt
Auf Windows und Linux mit NVIDIA-GPUs ist faster-whisper die überlegene Wahl. Der CTranslate2 CUDA-Backend ist besser optimiert als whisper.cpps CUDA-Pfad – ~12× vs. ~8-fache Echtzeit für large-v3 auf dem RTX 4070, bei geringerem VRAM-Verbrauch.
- RTX 4070 (12 GB)-Benchmark (large-v3 int8): ~12-fache Echtzeit, ~2,5 GB VRAM.
- RTX 3060 (12 GB)-Benchmark (large-v3 int8): ~8-fache Echtzeit, ~2,5 GB VRAM.
- RTX 4060 (8 GB)-Benchmark (large-v3 int8): ~7-fache Echtzeit, ~2,5 GB VRAM – passt problemlos.
- int8 vs. float16: int8 ist ~2× schneller und benötigt ~40 % weniger VRAM bei vernachlässigbarem Genauigkeitsverlust.
compute_type="int8"auf NVIDIA immer verwenden. - Batch-Verarbeitung: Der
batched=True-Parameter von faster-whisper ermöglicht die parallele Verarbeitung mehrerer Audiodateien und maximiert die GPU-Auslastung bei großen Transkriptionsjobs. - Python-Pipeline-Integration: faster-whisper fügt sich direkt in LangChain, Haystack und eigene Python-Pipelines ein. Kein Subprocess-Overhead im Vergleich zum Wrapping von whisper.cpp.
Ältere NVIDIA-GPUs (GTX 970): int8 fällt auf float32 zurück
Auf einer GTX 970 (Maxwell, Compute Capability 5.2) läuft faster-whisper weiterhin auf CUDA, aber compute_type="int8" liefert kein echtes int8 — CTranslate2 wandelt die Gewichte in float32 um. Die Quantisierungstabelle ordnet jeder GPU mit Compute Capability 6.0 oder niedriger für jeden angeforderten Typ float32 zu; die ~40 % VRAM-Ersparnis und der int8-Speedup, die für RTX-Karten genannt werden, gelten hier daher nicht.
📍 In einem Satz
Auf einer GTX 970 (Compute Capability 5.2) läuft faster-whisper auf CUDA nur in float32 — ein angeforderter int8-Compute-Typ wird automatisch umgewandelt.
💬 In einfachen Worten
Die GTX 970 ist zu alt für GPU-int8. Sie funktioniert weiterhin, aber ohne Speicherersparnis; bleiben Sie auf ihren 4 GB bei den Modellen tiny, base oder small.
- Was weiterhin funktioniert: Die vorgebauten CTranslate2-Binaries unterstützen NVIDIA-GPUs ab Compute Capability 3.5; eine GTX 970 (5.2) kann faster-whisper daher auf CUDA ausführen, sofern die installierten CUDA- und cuDNN-Bibliotheken zur Version passen (siehe Häufige Probleme).
- Wo GPU-int8 funktioniert: int8 benötigt Compute Capability 7.0 oder höher (Volta und RTX-20-Serie aufwärts) oder genau 6.1 (GTX 1050 bis 1080 Ti, int8_float32). Compute Capability 6.0, 6.2 und alles darunter fällt auf float32 zurück; float16 benötigt 7.0 oder höher.
- Folge für den Speicher: float32 belegt 4 Byte pro Parameter gegenüber 1 Byte bei int8; nach Parameterzahl braucht large-v3 (1,55B) allein für die Gewichte etwa 6 GB — mehr als die 4 GB der GTX 970. Small (244M, etwa 1 GB in float32) passt problemlos; medium (769M, etwa 3 GB) ist grenzwertig.
- Geschwindigkeit: Wir haben keine GTX 970 gemessen, daher gibt es hier keinen Messwert. Erwarten Sie float32-Durchsatz deutlich unter den RTX-4070-int8-Werten dieses Leitfadens und testen Sie tiny, base und small mit Ihrem eigenen Audio.
- Unterstützte Typen prüfen:
ctranslate2.get_supported_compute_types("cuda")listet die Compute-Typen auf, die CTranslate2 auf Ihrer Karte akzeptiert. - Alternativen: CPU-int8 (
device="cpu", compute_type="int8") funktioniert auf jeder modernen x86-CPU, und die quantisierten GGML-Modelle von whisper.cpp (etwaggml-large-v3-q5_0.bin, rund 3–4 GB) sind der übliche Weg, größere Modelle in 4 GB unterzubringen — prüfen Sie den CUDA- oder Vulkan-Build auf Ihrer Karte.
import ctranslate2
from faster_whisper import WhisperModel

# Which compute types does this GPU accept?
print(ctranslate2.get_supported_compute_types("cuda"))

# On compute capability < 6.1 (e.g. GTX 970), request float32 explicitly so nothing is converted silently
model = WhisperModel("small", device="cuda", compute_type="float32")
Whisper auf dem Raspberry Pi 5: tiny, base & small
Auf einem Raspberry Pi 5 führt whisper.cpp die Modelle tiny und base in Echtzeit für die Live-Transkription aus, während das small-Modell unterhalb der Echtzeit läuft und am besten Batch-Jobs vorbehalten bleibt. Der Quad-Core-Cortex-A76 des Pi 5 hat keinen nutzbaren GPU-Pfad für Whisper, sodass die gesamte Inferenz auf der CPU (ARM NEON) erfolgt. Verwenden Sie die quantisierten GGML-Modelle (ggml-*-q5_0.bin), um den Speicherbedarf zu senken und die Inferenz zu beschleunigen.
📍 In einem Satz
Auf einem Raspberry Pi 5 läuft das whisper.cpp-small-Modell langsamer als Echtzeit (~0,5×, nur Batch); tiny und base sind die Modelle, die mit Live-Sprache mithalten.
💬 In einfachen Worten
Ein Pi 5 kann Live-Audio mit den Whisper-Modellen tiny und base transkribieren, aber das small-Modell ist zu schwer, um in Echtzeit mitzuhalten – nutzen Sie small für aufgezeichnete Dateien, die Sie im Hintergrund verarbeiten, nicht für ein Live-Mikrofon.
- Whisper small auf dem Pi 5: Etwa 0,4–0,6× Echtzeit auf der CPU (ein 10-Minuten-Clip dauert ~17–25 Minuten). Genau mit 3,4 % WER, aber zu langsam für Live-Untertitelung – für nächtliche/Batch-Transkription verwenden.
- Whisper base auf dem Pi 5: Etwa Echtzeit bis ~2× mit Multithreading (
-t 4). Der praktische Sweet Spot für Live-Transkription auf dem Pi, mit akzeptablen 5,0 % WER. - Whisper tiny auf dem Pi 5: Schnellste Option, komfortabel schneller als Echtzeit für den Live-Einsatz, zum Preis höherer 7,6 % WER. Am besten für Wake-Word- und Kurzbefehl-Erkennung.
- Quantisierte Modelle verwenden:
bash ./models/download-ggml-model.sh small-q5_0senkt den RAM-Bedarf und beschleunigt die Inferenz bei minimalem Genauigkeitsverlust – wichtig beim geteilten Speicher des Pi 5. - faster-whisper auf dem Pi 5: Installierbar (
pip install faster-whisper, CPU int8) und wettbewerbsfähig für Batch-Jobs, aber das leichtere C-Binary von whisper.cpp ist die verbreitetere Embedded-Wahl. - Thermik: Anhaltende Transkription belastet die CPU des Pi 5 stark – verwenden Sie aktive Kühlung, um thermisches Throttling zu vermeiden, das diese Werte verschlechtert.
Wann welches Tool verwenden?
Eine direkte Zuordnung vom Anwendungsfall zum richtigen Tool:
📍 In einem Satz
whisper.cpp auf Apple Silicon und Embedded/plattformübergreifenden Targets verwenden; faster-whisper auf NVIDIA-GPUs und in Python-Pipelines.
💬 In einfachen Worten
Mit einem Mac: whisper.cpp wählen – es ist 3× schneller als faster-whisper auf Apple-Hardware. Mit einer NVIDIA GPU und Python: faster-whisper wählen – es ist schneller und benötigt 40 % weniger GPU-Speicher.
Szenario | Empfehlung | Begründung |
|---|---|---|
| Apple Silicon Mac (beliebiges Modell) | whisper.cpp | Metal / Core ML-Beschleunigung – 3× schneller als faster-whisper (nur CPU auf Mac) |
| NVIDIA GPU-Server (Linux/Windows) | faster-whisper | CTranslate2 int8 – schneller und geringerer VRAM als whisper.cpp CUDA-Pfad |
| Python-Datenpipeline | faster-whisper | Native Python-API; kein Subprocess-Wrapper; VAD integriert |
| Raspberry Pi / Embedded Linux | whisper.cpp | Reines C-Binary; kein Python-Runtime-Overhead; ARM NEON-optimiert |
| Echtzeit-Sprachassistent | whisper.cpp | Stream-Modus mit niedrigem Overhead; funktioniert ohne Python auf Pi / Embedded |
| Batch-Transkription (großes Audio-Archiv) | faster-whisper | Batch-Inferenz, GPU-Auslastung, Python-Async-Integration |
| AMD GPU (Vulkan) | whisper.cpp | Vulkan-Backend-Unterstützung; faster-whisper ist CUDA-only |
| Nur-CPU Linux-Server | faster-whisper | int8-Quantisierung gibt ~30 % Geschwindigkeitsvorteil auf x86 CPU |
Über whisper.cpp und faster-whisper hinaus
Zwei weitere Tools erweitern Whisper um Funktionen, die weder whisper.cpp noch faster-whisper standardmäßig bieten: Sprecherdiarisierung und extrem schnelle Batch-GPU-Inferenz.
- WhisperX: Basiert auf faster-whisper und fügt wortgenaue Zeitstempel sowie Sprecherdiarisierung hinzu – es wird identifiziert, welcher Sprecher was gesagt hat. Am besten für: Meeting-Transkription mit Sprecher-Labels, Podcast-Bearbeitung und Interview-Transkripte. Installation mit
pip install whisperxund Hugging-Face-Token für das Diarisierungsmodell. - insanely-fast-whisper: Ein Hugging Face Transformers Pipeline-Wrapper mit Flash-Attention-2-Unterstützung für deutlich schnellere GPU-Inferenz als standard faster-whisper auf NVIDIA-Hardware. Am besten für: Batch-Verarbeitung großer Audio-Archive auf NVIDIA-GPUs. Erfordert eine Flash-Attention-2-kompatible GPU (Ampere oder neuer: RTX 3000+, A100, H100).
Häufige Probleme und Lösungen
Die häufigsten Setup- und Laufzeit-Probleme mit direkten Lösungen:
- CUDA-Versionskonflikt: Aktuelle faster-whisper-Versionen benötigen cuBLAS für CUDA 12 und cuDNN 9. Wer an älteren Bibliotheken hängt, pinnt ctranslate2:
pip install --force-reinstall ctranslate2==4.4.0(CUDA 12 mit cuDNN 8) oder3.24.0(CUDA 11 mit cuDNN 8). CUDA-Version prüfen mitnvcc --version. - Metal-Modell-Export schlägt fehl: Xcode Command Line Tools müssen installiert sein –
xcode-select --installausführen. Das Core ML-Exportskript erfordert das Python-Paketcoremltools:pip install coremltools. - Halluzination bei Stille: Beide Tools können bei stillen Audiosegmenten wiederholte Füll-Tokens erzeugen.
--no-speech-threshold 0.6im whisper.cpp Stream-Modus verwenden odervad_filter=Truein faster-whispersmodel.transcribe(), um stille Segmente automatisch zu überspringen. - Speichermangel bei large-v3: Auf int8-Quantisierung in faster-whisper wechseln (
compute_type="int8") – reduziert VRAM von ~5 GB (float16) auf ~2,5 GB. Bei whisper.cpp: quantisierte GGML-Variante verwenden (z. B.ggml-large-v3-q5_0.bin), was den Speicher auf ~3–4 GB reduziert. - Unleserliche Ausgabe bei nicht-englischen Aufnahmen: Keine
.en-Modellvarianten (tiny.en, base.en) für nicht-englische Sprache verwenden – diese sind English-only. Mehrsprachige Modelle (base, small, medium, large-v3) verwenden und die Sprache explizit angeben:-l dein whisper.cpp oderlanguage="de"in faster-whisper. - Langsame CPU-Inferenz: Sicherstellen, dass die CPU AVX2-Instruktionen unterstützt (für optimierte CPU-Inferenz erforderlich). Prüfen mit
grep avx2 /proc/cpuinfounter Linux odersysctl machdep.cpu.featuresauf Mac. CPUs ohne AVX2 greifen auf generisches SIMD zurück und sind 2–3× langsamer.
Häufig gestellte Fragen
Gibt es ein Debian- oder apt-Paket für whisper.cpp?
Ja – whisper.cpp ist jetzt offiziell für Debian paketiert (derzeit in sid) und liefert die whisper.cpp-Binary sowie libwhisper-dev und libwhisper1 zum Linken als Shared Library. Es hat die stabilen Debian-Releases oder die Standard-Repos von Ubuntu noch nicht erreicht, daher braucht man auf den meisten Systemen weiterhin sid oder muss aus dem Quellcode bauen. Alternativ gibt es einen inoffiziellen Snap (sudo snap install whisper-cpp) für Debian 9+ und Ubuntu.
Wie prüfe ich, welche whisper.cpp-Version installiert ist?
Starten Sie die kompilierte Binary ohne Argumente oder mit --help – die Version steht in der Banner-Zeile. Alternativ prüfen Sie den genauen Commit mit git describe --tags im geklonten Repository, oder vergleichen Sie Ihr Build-Datum mit den Release Notes unter github.com/ggml-org/whisper.cpp/releases, um zu sehen, ob Sie hinter der aktuellen v1.9.5 liegen.
Ist die Transkriptionsgenauigkeit bei whisper.cpp und faster-whisper gleich?
Ja. Beide Tools verwenden dieselben OpenAI-Whisper-Modellgewichte – das Modell selbst ist identisch. Der Unterschied liegt ausschließlich in der Inferenz-Laufzeit (C/C++ vs. CTranslate2 Python). Der WER auf derselben Audiodatei liegt innerhalb von 0,1 % absolut voneinander – das liegt im Rahmen der normalen Variation durch Beam-Search-Zufälligkeit.
Kann ich faster-whisper auf einem Mac mit Apple Silicon verwenden?
Ja, aber es läuft nur über CPU – faster-whisper hat keinen Metal-Support. Auf einem M5 Pro läuft faster-whisper large-v3 mit ~3-facher Echtzeit (CPU int8), verglichen mit whisper.cpps ~10-facher Echtzeit mit Metal. Für die meisten Mac-Nutzer ist whisper.cpp 3× schneller für dasselbe Modell. Der einzige Grund, faster-whisper auf dem Mac zu verwenden, ist, wenn eine Python-Pipeline bereits davon abhängt und Geschwindigkeit keine kritische Rolle spielt.
Welche Whisper-Modellgröße sollte ich für einen Sprachassistenten verwenden?
Für Echtzeit-Sprachinterfaces ist Whisper small die Standardempfehlung – 3,4 % WER auf sauberem Englisch, ~200 ms STT-Latenz auf einer modernen CPU oder GPU und passt in 2 GB RAM. tiny verwenden bei sehr eingeschränkter Hardware (Raspberry Pi Zero 2W, ältere Smartphones) und wenn ~7,6 % WER akzeptabel sind. medium oder large-v3 nur für Batch-Transkription verwenden, bei der Latenz keine Rolle spielt.
Unterstützt whisper.cpp andere Sprachen als Englisch?
Ja. Alle mehrsprachigen Whisper-Modelle (base, small, medium, large-v3) unterstützen 99 Sprachen. `-l [Sprachcode] in der CLI hinzufügen: -l de für Deutsch, -l fr für Französisch, -l ja` für Japanisch usw. Die Modelle tiny.en und base.en sind English-only und etwas genauer für Englisch als ihre mehrsprachigen Äquivalente.
Wie installiere ich faster-whisper mit CUDA-Unterstützung?
Installation mit pip install faster-whisper. Aktuelle Versionen benötigen NVIDIA cuBLAS für CUDA 12 und cuDNN 9 auf dem System (unter Linux liefert pip install nvidia-cublas-cu12 "nvidia-cudnn-cu12==9.*" beides). Bei älteren CUDA-11-/cuDNN-8-Setups ctranslate2==3.24.0 pinnen (oder 4.4.0 für CUDA 12 mit cuDNN 8). Dann device="cuda" beim Laden des Modells angeben: WhisperModel("large-v3", device="cuda", compute_type="int8"). Mit device="auto" fällt faster-whisper auf die CPU zurück, wenn CUDA nicht verfügbar ist.
Welches ist genauer – whisper.cpp oder faster-whisper?
Identisch. Beide Tools verwenden dieselben OpenAI-Whisper-Modellgewichte und erzeugen denselben WER für dieselbe Audiodatei. Der Unterschied zwischen whisper.cpp und faster-whisper liegt in Geschwindigkeit und Plattformunterstützung, nicht in der Transkriptionsgenauigkeit. Jede WER-Differenz zwischen Läufen liegt im Rahmen normaler Beam-Search-Variation, nicht an der Laufzeit.
Kann ich Whisper large-v3 mit 8 GB RAM betreiben?
Ja auf der GPU – large-v3 int8 in faster-whisper benötigt ~2,5 GB VRAM und läuft auf jeder 8-GB-GPU. Auf reiner CPU-Hardware sind 8 GB RAM für large-v3 knapp (float32 benötigt ~10 GB). medium (5 GB RAM) oder small (2 GB RAM) auf Nur-CPU-Systemen verwenden. whisper.cpp ist auf der CPU speichereffizienter als faster-whisper durch geringeren Laufzeit-Overhead.
Was kostet lokales Whisper im Vergleich zu Cloud-STT?
Null laufende Kosten. Cloud-STT-Dienste berechnen ca. 0,005–0,022 €/Min. – ein Entwickler, der 8 Stunden Meetings pro Woche transkribiert, zahlt ca. 110–440 €/Monat. Lokales Whisper läuft auf bereits vorhandener Hardware, ohne minutenbasierte Gebühren, ohne API-Schlüsselverwaltung und ohne dass Audiodaten das eigene Gerät verlassen.
Hilft lokale Whisper-Transkription bei der DSGVO-Compliance?
Sie kann die Compliance erleichtern, garantiert sie aber nicht. Wenn die Audiodaten Ihr eigenes Gerät nie verlassen und kein externer Dienstleister beteiligt ist, entfällt für den Transkriptionsschritt in der Regel die Auftragsverarbeitung nach DSGVO Art. 28. Rechtsgrundlage, Informationspflichten, Speicherung und Zugriffsschutz bleiben jedoch Ihre Aufgabe, und ob Ihr konkreter Einsatz konform ist, hängt vom Einzelfall ab. Klären Sie das bei besonders sensiblen Daten (etwa Gesundheitsdaten) mit Ihrer Datenschutzbeauftragten oder einer Rechtsberatung. Dies ist keine Rechtsberatung.
Ist Whisper für den deutschen Mittelstand geeignet?
Ja – insbesondere für Branchen mit hohen Datenschutzanforderungen wie Anwaltskanzleien, Arztpraxen, Steuerberater und Unternehmensberatungen. Der Einsatz von whisper.cpp oder faster-whisper ermöglicht DSGVO-konforme Protokollierung von Kundengesprächen und Besprechungen ohne Cloud-Abhängigkeit. Kein laufendes Abonnement, keine API-Kosten, volle Kontrolle über die Audiodaten. Für den Einstieg empfiehlt sich Whisper small (3,4 % WER, 2 GB RAM) oder medium (2,9 % WER, 5 GB RAM) – beide laufen auf handelsüblicher Hardware ohne NVIDIA-GPU.
Funktioniert faster-whisper int8 auf einer GTX 970?
Nein — nicht als echtes int8. Die GTX 970 hat Compute Capability 5.2, und CTranslate2 führt int8 nur auf GPUs mit Compute Capability 7.0 oder höher (oder genau 6.1) aus; auf älteren Karten werden die Gewichte automatisch in float32 umgewandelt. faster-whisper läuft weiterhin auf der GPU in float32. Nutzen Sie tiny, base oder small, um in 4 GB zu bleiben, oder CPU-int8, das auf jeder modernen x86-CPU funktioniert. Wir haben keine GTX 970 gemessen, daher gibt es hier keinen Messwert.
Wie groß sind die Whisper-Modelldateien für whisper.cpp und faster-whisper?
Die README von whisper.cpp nennt GGML-Modelldateien von etwa 75 MiB (tiny), 142 MiB (base), 466 MiB (small), 1,5 GiB (medium) und 2,9 GiB (large) auf der Platte; sie benötigen rund 273 MB, 388 MB, 852 MB, 2,1 GB und 3,9 GB Speicher. faster-whisper lädt CTranslate2-Modelle beim ersten Start von Hugging Face; large-v3 ist dort etwa 3 GB groß (1,55B Parameter mit je 2 Byte in float16). Die Modellgrößen-Tabelle oben nennt die Parameterzahlen aller Größen.
Ist Whisper large-v3-turbo für lokale Transkription besser als large-v3?
Es ist schneller, nicht genauer. large-v3-turbo hat 809M Parameter, weil OpenAI den Decoder von 32 auf 4 Schichten gekürzt hat; die Model Card beschreibt es als deutlich schneller als large-v3 bei geringfügig geringerer Qualität, unter MIT-Lizenz. Die Karte warnt außerdem vor Halluzinationen und Textwiederholungen sowie unterschiedlicher Genauigkeit je Sprache. Behalten Sie large-v3 für schwierigstes Audio und nutzen Sie turbo (oder distil-large-v3 für Englisch), wenn Geschwindigkeit zählt. whisper.cpp und faster-whisper können es beide ausführen.
Kann whisper.cpp eine AMD- oder Intel-GPU statt CUDA nutzen?
Ja. Das Vulkan-Backend von whisper.cpp (-DGGML_VULKAN=1) funktioniert herstellerübergreifend, sofern der Treiber die Vulkan-API unterstützt; ROCm/HIP (-DGGML_HIP=1) zielt auf AMD-GPUs, und OpenVINO beschleunigt den Encoder auf Intel-CPUs und -GPUs. Die Dokumentation von faster-whisper behandelt nur NVIDIA CUDA; die CTranslate2-Release-Notes erwähnen ROCm-Wheels, diesen Weg haben wir aber nicht getestet.
Ist mlx-whisper auf einem Mac schneller als whisper.cpp?
Ein unabhängiger Test sagt ja für large-v3-turbo: Bill Mills Wiederholung vom Januar 2026 maß für mlx_whisper etwa 13,1 Sekunden gegenüber 26,7 Sekunden für whisper.cpp bei derselben langen Aufnahme, also rund 2× schneller. Ein Community-Speedtest mit einem kurzen Clip sah beide nah beieinander, wobei whisper.cpp Core ML und q5_0-Quantisierung nutzte. Die M5-Pro-Werte in diesem Leitfaden wurden nicht mit MLX verglichen; testen Sie daher Ihr eigenes Audio, bevor Sie sich entscheiden.
Quellen
- whisper.cpp auf GitHub — Quellcode, Build-Anleitungen, Modell-Download-Skripte und Metal/Core ML-Setup-Guide.
- faster-whisper auf GitHub — Quellcode, Python-API-Dokumentation und Benchmark-Ergebnisse.
- distil-whisper/distil-large-v3 auf Hugging Face — Modellkarte, Benchmark-Ergebnisse und Nutzungshinweise für die destillierte Whisper-Variante.
- WhisperX auf GitHub — Wortgenaue Zeitstempel und Sprecherdiarisierung basierend auf faster-whisper.
- insanely-fast-whisper auf GitHub — Flash-Attention-2 Whisper-Pipeline für maximalen NVIDIA-GPU-Durchsatz.
- OpenAI Whisper auf GitHub — Originales Whisper-Modell, Paper und Modellkarten für alle Größen.
- OpenAI Whisper Paper (Radford et al., 2022) — „Robust Speech Recognition via Large-Scale Weak Supervision." Quelle der WER-Werte.
- CTranslate2-Dokumentation — Quantisierungsdetails, Hardware-Unterstützung und int8-Optimierungsgrundlagen.
- CTranslate2-Dokumentation zur Quantisierung — Welche Compute-Typen welche GPU-Compute-Capability unterstützt (Grundlage des GTX-970-Abschnitts).
- faster-whisper-README-Benchmarks — 13-Minuten-Laufzeiten für GPU und CPU im Referenz-Benchmark sowie die aktuellen CUDA-12-/cuDNN-9-Anforderungen.
- openai/whisper-large-v3-turbo auf Hugging Face — Model Card: 809M Parameter, 4 Decoder-Schichten, MIT-Lizenz.
- Bill Mill: aktualisierter Benchmark mlx_whisper vs. whisper.cpp — Unabhängiger large-v3-turbo-Zeitvergleich auf Apple Silicon.
- whisper.cpp-Releases — Release Notes zu v1.9.4 und v1.9.5.