핵심 요점
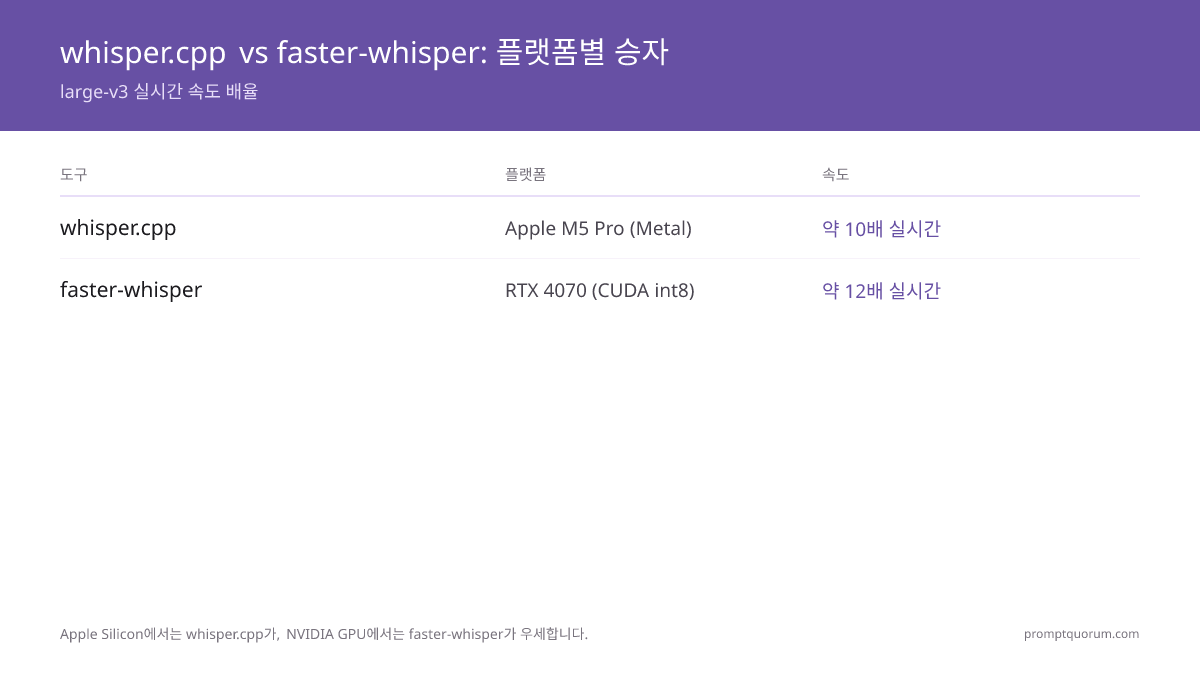
- whisper.cpp는 Apple Silicon을 위한 최선의 로컬 STT 선택입니다. C/C++ 포트는 하드웨어 가속을 위해 Core ML과 Apple Metal을 활용합니다 — Python 의존성 없이 M5 Pro에서 large-v3가 ~10배 실시간 속도로 동작합니다.
- faster-whisper는 NVIDIA GPU 및 Python 파이프라인을 위한 최선의 로컬 STT 선택입니다. CTranslate2의 int8 양자화는 VRAM을 ~40% 줄이고 처리량을 원본 OpenAI 구현 대비 ~4배 향상시킵니다 — RTX 4070에서 large-v3가 ~2.5GB VRAM만으로 ~12배 실시간 속도를 달성합니다.
- 두 도구 모두 동일한 OpenAI Whisper 모델 가중치를 사용합니다. WER(단어 오류율)은 동일합니다 — 차이점은 런타임 성능과 통합 방식에만 있으며, 전사 정확도에는 차이가 없습니다.
- Whisper large-v3는 영어에서 2.5% WER로 최고의 정확도를 제공합니다. 대부분의 프로덕션 사용 사례에서는 Whisper small(3.4% WER, 2GB RAM) 또는 medium(2.9% WER, 5GB RAM)이 속도와 정확도 사이에서 더 나은 균형을 제공합니다.
- 실시간 전사는 두 도구 모두로 달성 가능합니다 — whisper.cpp는
--stream플래그를 통해, faster-whisper는 내장 VAD(음성 활동 감지) 파이프라인을 통해 지원합니다. 실제 지연 시간은 모델 크기에 따라 라이브 음성보다 0.5~2초 지연됩니다. - whisper.cpp는 CPU, Metal, CUDA, Vulkan에서 동작합니다 — 크로스 플랫폼 임베디드 사용(Raspberry Pi, Windows GPU 구성, ARM 서버)을 위한 가장 현실적인 옵션입니다. faster-whisper는 CPU와 CUDA만 지원합니다(Mac에서 Metal 미지원).
- Raspberry Pi 5 및 임베디드 Linux에서는 CPU의 whisper.cpp tiny와 base가 실시간을 처리할 수 있는 모델입니다. tiny는 실시간보다 여유 있게 빠르고, base는
-t 4에서 실시간 수준입니다. small 모델(WER 3.4%)은 Pi 5에서 실시간보다 느려 배치 작업에 가장 적합합니다. 모든 추론은 CPU(ARM NEON)에서 이루어지며, Pi에는 Whisper용으로 쓸 만한 GPU 경로가 없습니다.
빠른 사실 정리
- 두 도구 모두: OpenAI의 오픈소스 Whisper 모델(MIT 라이선스) 기반. 동일한 정확도 — 런타임만 다름.
- whisper.cpp: Georgi Gerganov가 C/C++로 작성. CPU(AVX2/NEON), CUDA, Metal(Apple), Vulkan 지원. Python 불필요.
- faster-whisper: CTranslate2를 사용하는 Python 라이브러리. CPU(int8)와 CUDA 지원. Apple Metal 미지원.
- Whisper 모델 크기: tiny(39M), base(74M), small(244M), medium(769M), large-v3(1.55B). 모두 ggml / CTranslate2 형식.
- 대부분의 경우 최선의 모델: Whisper small — 3.4% WER, 2GB RAM에서 동작, 현대적 CPU 또는 GPU에서 6배 실시간 속도.
- RTX 4070 벤치마크(large-v3): faster-whisper ~12배 실시간; whisper.cpp CUDA ~8배 실시간. NVIDIA에서는 faster-whisper 승.
- M5 Pro 벤치마크(large-v3): whisper.cpp Metal ~10배 실시간; faster-whisper CPU 전용 ~3배 실시간. Apple에서는 whisper.cpp 승.
로컬 음성 인식이 필요한 이유
클라우드 STT 서비스(Google Speech-to-Text, AWS Transcribe, Azure Speech)는 오디오 분당 요금을 부과하며 — 일반적으로 $0.006–$0.024/분 — 오디오를 원격 서버로 전송합니다. 개인 정보 보호가 중요한 애플리케이션(의료 받아쓰기, 법적 녹음, 저널리즘 인터뷰, 기업 회의)의 경우, 로컬 전사는 데이터 노출을 완전히 제거합니다.
- 개인 정보 보호: 오디오가 기기를 떠나지 않으므로 전사 과정에 클라우드 사업자가 관여하지 않습니다. 법적 근거와 안전한 보관 같은 개인정보 보호 의무는 여전히 사용자에게 있습니다.
- 비용: 분당 요금 없음. 주당 8시간 회의를 전사하는 개발자는 클라우드 STT 가격 대비 월 $120–480를 절약할 수 있습니다.
- 오프라인: 비행기, 보안 시설, 안정적인 인터넷이 없는 지역에서 동작합니다. API 키 관리 불필요.
- 지연 시간: 업로드/다운로드 왕복 없음. 실시간 음성 인터페이스의 경우, 로컬 처리는 STT 지연 시간을 클라우드의 300–800ms에서 50–300ms로 단축합니다.
- 커스터마이즈: 도메인별 어휘로 모델을 미세 조정합니다. 하드웨어에 맞는 모델 크기를 실행합니다.
- Home Assistant 통합: 로컬 Whisper는 웨이크 워드와 음성 명령이 홈 네트워크를 떠나지 않음을 의미합니다. 클라우드 STT를 완전히 대체하는 애드온 설정은 Home Assistant에서의 로컬 Whisper →를 참조하십시오.
Whisper 모델 크기 — 두 도구의 공통 기반
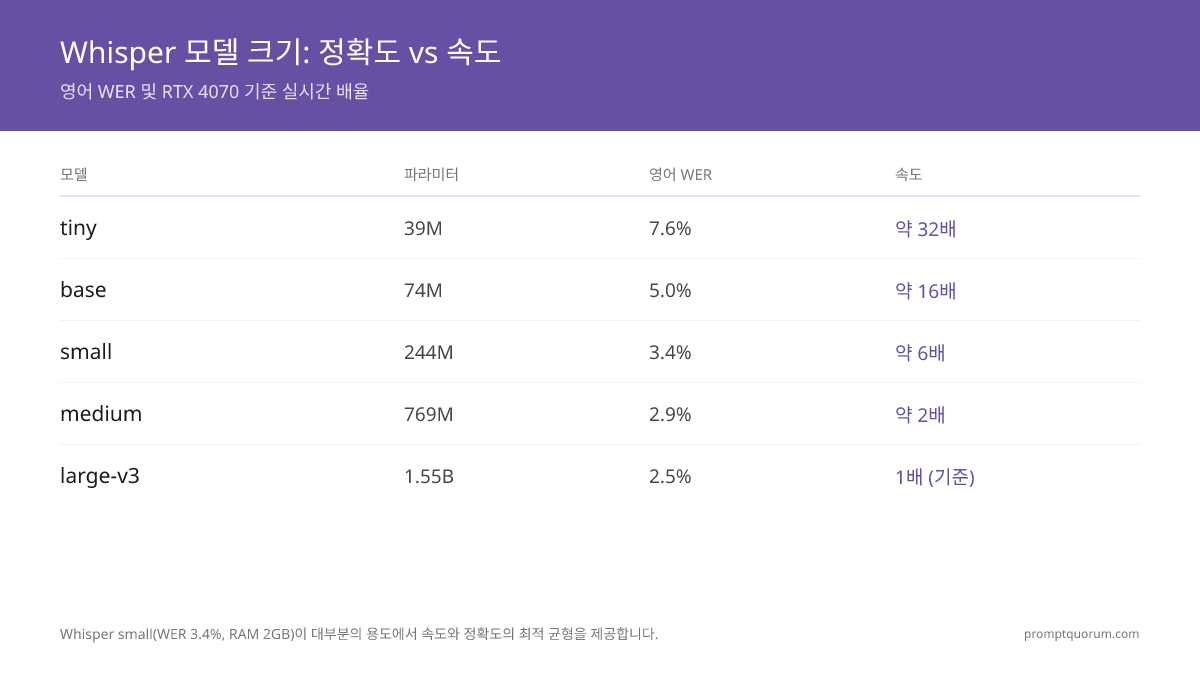
whisper.cpp와 faster-whisper 모두 동일한 Whisper 모델 가중치를 사용하며, 각자의 형식으로 변환됩니다(whisper.cpp는 GGML, faster-whisper는 CTranslate2). VRAM/RAM 예산과 정확도 요구 사항에 따라 모델 크기를 선택하십시오.
모델 | 파라미터 | VRAM / RAM | 영어 WER | 속도 배율 (RTX 4070 실시간 대비) |
|---|---|---|---|---|
| tiny | 39M | ~1 GB | 7.6% | ~32× |
| base | 74M | ~1 GB | 5.0% | ~16× |
| small | 244M | ~2 GB | 3.4% | ~6× |
| medium | 769M | ~5 GB | 2.9% | ~2× |
| large-v3 | 1.55B | ~10 GB | 2.5% | 1× (기준) |
| distil-large-v3 | ~756M | ~4 GB | ~2.6% | ~6× |
WER(단어 오류율) 값은 LibriSpeech 클린 테스트 세트에 대한 Whisper 논문에서 가져왔습니다. 낮을수록 좋습니다. 속도 배율은 RTX 4070에서의 faster-whisper int8 기준입니다. distil-large-v3 값은 Distil-Whisper 논문에서 가져왔습니다.
Distil-Whisper: 더 빠른 대안
distil-whisper/distil-large-v3는 large-v3의 지식 증류 변형으로, 파라미터가 ~50% 적으면서 WER이 원본의 ~1% 이내로 유지되며 ~6배 빠르게 동작합니다. 전사 속도가 마지막 정확도 퍼센트 이상으로 중요한 경우에 올바른 선택입니다. distil-large-v3는 faster-whisper(네이티브 CTranslate2 지원)와 whisper.cpp(GGML 형식 변환을 통해) 모두와 호환되어, 이미 사용 중인 런타임에 통합됩니다.
- 파라미터: ~756M — large-v3의 1.55B의 약 절반, ~10GB 대신 ~4GB VRAM에 수용됩니다.
- 속도: RTX 4070에서 ~6배 실시간(large-v3의 기준인 1× 대비) — 속도는 medium 모델과 유사하면서 정확도는 large-v3에 근접합니다.
- WER: 영어에서 ~2.6% — large-v3의 2.5%보다 단 ~0.1% 높습니다. 실제로는 일반적인 음성에서 차이를 거의 느낄 수 없습니다.
- 호환성: faster-whisper에서 네이티브로 동작합니다(
WhisperModel("distil-large-v3", device="cuda", compute_type="int8")). whisper.cpp의 경우, distil-whisper의 GGML 변환 스크립트를 사용하여 GGML 형식으로 변환하십시오. - 최적 사용 사례: 배치 전사 작업, VRAM이 제한된 서버 배포, large-v3 품질을 medium 모델 속도로 원하는 모든 사용 사례.
- 비권장 사용 사례: 다국어 전사 — distil-large-v3는 영어 전용입니다. 다른 언어의 경우 large-v3 또는 medium을 사용하십시오.
whisper.cpp — C/C++ 포트
whisper.cpp(Georgi Gerganov 제작)는 OpenAI Whisper 모델의 순수 C/C++ 재구현으로, 저자원 크로스 플랫폼 추론에 최적화되어 있습니다. Python, CUDA 툴킷이 필요 없으며, Raspberry Pi부터 Apple M5 Pro, Windows CUDA 구성까지 거의 모든 하드웨어에서 동작합니다.
- 플랫폼 지원: CPU(AVX2, AVX512, ARM NEON), Apple Metal(Core ML), CUDA(NVIDIA), Vulkan(AMD/Intel GPU), OpenCL.
- Apple Silicon 강점: whisper.cpp는 모델을 Core ML 형식으로 내보내 Apple Neural Engine에서 추론을 가능하게 합니다. Metal을 통해 M5 Pro에서 large-v3가 ~10배 실시간 속도로 동작합니다 — 클라우드 왕복보다 빠릅니다.
- 설치: 저장소를 클론하고
make(또는cmake)를 실행합니다. 일반 플랫폼용 사전 빌드된 바이너리가 제공됩니다. Python 의존성 없음. - 모델 다운로드:
bash ./models/download-ggml-model.sh base.en— GGML 형식의 모델 파일을 다운로드합니다(base의 경우 ~142MB). - CLI 예시:
./main -m models/ggml-base.bin -f audio.wav— WAV 파일을 표준 출력으로 전사합니다. 한국어는-l ko를 추가하십시오. - 실시간 스트림 모드:
./stream -m models/ggml-base.bin --step 3000 --length 10000— 마이크에서 3초 청크 단위로 전사합니다. - Python 래퍼: pywhispercpp은 whisper.cpp를 위한 Python 바인딩을 제공하여, Metal 가속을 희생하지 않고 Python 파이프라인에서 사용할 수 있게 합니다.
- 한계: 네이티브 VAD(음성 활동 감지) 없음. 스트림 모드는 사용 사례에 따라
--step및--length파라미터를 조정해야 합니다.
# Build from source (macOS / Linux)
git clone https://github.com/ggerganov/whisper.cpp
cd whisper.cpp
make -j4

# Download a model
bash ./models/download-ggml-model.sh large-v3

# Transcribe a file
./main -m models/ggml-large-v3.bin -f recording.wav

# Enable Metal on Apple Silicon (Core ML)
make -j4 WHISPER_COREML=1
./main -m models/ggml-large-v3-encoder.mlmodelc -f recording.wav
whisper.cpp 최신 버전 및 업데이트
whisper.cpp의 최신 릴리스는 2026년 10월 6일에 공개된 v1.9.5입니다. 번들된 ggml 라이브러리를 v0.26.0으로 동기화하며(CUDA, Vulkan, Metal, SYCL, OpenCL, CPU 커널 백엔드 작업), 언어 감지 중 중단 콜백과 병렬 청크 오프셋의 정수 오버플로 수정 같은 Whisper 수정이 포함됩니다. whisper.cpp는 비공식 Snap과 별개로 Debian 공식 패키지(sid, whisper.cpp / libwhisper-dev / libwhisper1)로도 제공됩니다. faster-whisper의 최신 태그 릴리스는 여전히 v1.2.1(2025년 10월 31일)이지만 저장소는 활발히 관리되고 있으며, 2026년 10월 16일에도 커밋이 있었습니다. 두 런타임 모두 동일한 OpenAI Whisper 가중치를 불러오며, 2026년에 전사 정확도와 관련해 달라진 것은 없습니다.
- whisper.cpp v1.9.5(2026년 10월 6일): ggml을 v0.26.0으로 동기화(CUDA, Vulkan, Metal, SYCL, OpenCL, WebGPU, CPU 커널 업데이트), 언어 감지 중 중단 콜백 추가, 병렬 청크 오프셋의 정수 오버플로 수정, 파일 처리 실패 시 CLI가 올바른 오류 코드를 반환하도록 수정.
- whisper.cpp v1.9.4(2026년 9월 11일): 서버가 감지된 언어를 반환하고, 인코더 콜백이 언어 자동 감지 전에 호출되며, 릴리스 작업에 Windows on ARM이 추가되었습니다.
- whisper.cpp v1.9.3(2026년 8월 20일): ggml을 v0.20.2로 동기화하여 전 백엔드 성능 개선, Metal TQ2_0 양자화 지원, 융합 CUDA/SYCL 커널, ARM/WASI 수정.
- whisper.cpp v1.9.0–v1.9.2(2026년 6월–8월): v1.9.3에 이르기까지 같은 ggml 동기화 및 백엔드 성능 개선 계열의 포인트 릴리스.
- whisper.cpp v1.8.6(2026년 6월 2일): 압축 오디오(MP3, M4A)의 선택적 FFmpeg 디코딩을 더 명확하게 하도록
ffmpeg-transcode를 재구현하고 CI 예제 경로를 수정. - whisper.cpp v1.8.5(2026년 5월): 스트리밍 VAD(음성 활동 감지) 개선, 서버 파라미터 누수 및 토큰 타임스탬프 수정, Ruby 및 VAD 바인딩의 메모리 누수 수정.
- whisper.cpp v1.8.4(2026년 3월 19일): 폭넓은 성능 향상을 담은 최신
ggml동기화, GPU를 선택하는 새-g/--gpu-device플래그(및GGML_CUDA장치 선택), UTF-8 세그먼트 줄바꿈 수정. - 네이티브 VAD가 whisper.cpp에 내장되었습니다. 최근 릴리스에 네이티브 음성 활동 감지 경로가 추가되어 오랜 faster-whisper의 강점이 줄었습니다. 다만 faster-whisper의 Silero VAD 통합이 여전히 더 바로 쓰기 쉽습니다.
- faster-whisper v1.2.1(2025년 10월 31일): 최신 태그 릴리스이며
pip install faster-whisper로 설치됩니다. 2026년에 태그 릴리스는 없지만 메인 브랜치는 활발합니다. 2026년 10월 16일 커밋에서 모델이 지원하지 않는 언어에 대한 오류 같은 입력 검증이 추가되었습니다. v1.2.0(2025년 8월)에서 distil-large-v3.5 지원이 추가되었습니다. - CTranslate2 v4.8.3(2026년 10월 13일): faster-whisper 아래의 추론 엔진도 계속 릴리스되고 있습니다. v4.8 계열은 Windows ROCm 수정, 모델 로드 시 방어 강화, 윈도에 프레임이 없을 때 Whisper
align()의 0으로 나누기 수정을 추가했습니다. - 2026년에는 정확도 등급의 새 Whisper 모델이 없습니다. OpenAI의 최신 다국어 가중치는 여전히 large-v3-turbo(2024년 10월, 809M 파라미터, 디코더를 32층에서 4층으로 축소, MIT 라이선스)이며, 약간의 품질 저하를 감수하고 훨씬 높은 속도를 얻고 두 도구 모두에서 동작합니다. distil-large-v3는 영어 전용 속도 옵션으로 남아 있습니다. 두 런타임의 업데이트는 런타임과 도구의 변경이지 정확도 변경이 아닙니다.
faster-whisper — CTranslate2 포트
faster-whisper(SYSTRAN 제작)는 CTranslate2를 사용하여 Whisper 추론을 재구현한 Python 라이브러리입니다 — int8 양자화 지원을 통해 VRAM 사용량을 줄이고 처리량을 향상시키는 고도로 최적화된 C++ 추론 엔진입니다. NVIDIA GPU에서 faster-whisper는 사용 가능한 가장 빠른 로컬 Whisper 구현체입니다.
- 플랫폼 지원: CPU(int8 양자화)와 NVIDIA GPU CUDA. Apple Metal 미지원 — Mac에서는 CPU 전용으로만 동작합니다.
- int8 강점: CTranslate2의 int8 양자화는 VRAM을 ~40% 줄이고 float16 대비 추론 속도를 ~2배 향상시키며, WER 영향은 무시할 수준(절대값 < 0.1%)입니다.
- 설치:
pip install faster-whisper— 컴파일 불필요(Python 3.9+). GPU 사용에는 CUDA 12용 NVIDIA cuBLAS와 cuDNN 9가 필요하며, 오래된 CUDA 11 / cuDNN 8 환경에서는 더 오래된ctranslate2(3.24.0)로 고정해야 합니다. - 내장 VAD: faster-whisper에는 Silero VAD 통합이 포함되어 있어 음성이 없는 오디오 세그먼트를 자동으로 건너뜁니다 — 실시간 전사 파이프라인에 필수적입니다.
- 네이티브 Python: 직접적인 Python API는 LLM, 오디오 처리 라이브러리, 웹 프레임워크와의 통합을 용이하게 합니다.
- 속도: RTX 4070에서 large-v3 int8이 ~2.5GB VRAM을 사용하며 ~12배 실시간 속도로 동작합니다. CPU int8은 tiny 모델에서 ~20배 실시간 속도를 달성합니다.
- 배치 처리: faster-whisper는 대량의 오디오 파일을 효율적으로 처리하기 위한 배치 추론을 지원합니다.
- 한계: Mac에서 Metal 미지원 — Apple Silicon에서 CPU 전용으로만 동작하며, Metal을 사용하는 whisper.cpp의 ~10배 대비 large-v3로 ~3배 실시간 속도를 달성합니다.
from faster_whisper import WhisperModel

# Load model (downloads automatically on first run)
model = WhisperModel("large-v3", device="cuda", compute_type="int8")

# Transcribe
segments, info = model.transcribe("audio.wav", beam_size=5)

print(f"Detected language: {info.language} (probability: {info.language_probability:.2f})")
for segment in segments:
    print(f"[{segment.start:.2f}s → {segment.end:.2f}s] {segment.text}")
pip로 ggml-base.bin 받기(Python 설정)
pip로 Python에서 ggml-base.bin을 사용하려면 pywhispercpp 바인딩을 설치하고(pip install pywhispercpp) Model("base")를 로드하십시오. 처음 실행할 때 ggml-base.bin이 자동으로 다운로드됩니다. pip install whisper.cpp는 존재하지 않으며, pywhispercpp가 whisper.cpp C/C++ 엔진을 감싼 pip 래퍼이고 Metal 및 CUDA 가속을 유지합니다. GGML 모델 파일(ggml-base.bin, 약 142 MB)은 Hugging Face에서 별도로 내려받아 로컬에 캐시되며, pip 패키지는 가중치가 아니라 추론 엔진만 포함합니다.
📍 한 문장으로
pip install pywhispercpp를 실행한 뒤 Python에서 Model("base")를 호출하면 처음 사용할 때 ggml-base.bin이 자동으로 내려받아져 캐시됩니다.
💬 쉽게 말하면
pip는 프로그램(pywhispercpp)을 설치하고, ggml-base.bin 모델 파일은 "base" 모델을 처음 로드할 때 내려받는 별도의 약 142 MB 파일입니다. download-ggml-model.sh 스크립트로 직접 받을 수도 있습니다.
- 바인딩 설치:
pip install pywhispercpp. NVIDIA CUDA 가속이 필요하면GGML_CUDA=1 pip install git+https://github.com/absadiki/pywhispercpp로 빌드하십시오. - ggml-base.bin 자동 다운로드:
from pywhispercpp.model import Model후model = Model("base")를 실행하면 처음 실행 시 Hugging Face(ggerganov/whisper.cpp)에서ggml-base.bin을 내려받아 캐시합니다. 영어 전용 변형은"base.en"을 사용하십시오. - 수동 다운로드(CLI 방식, pip 없음): 클론한 whisper.cpp 저장소에서
bash ./models/download-ggml-model.sh base를 실행하면models/ggml-base.bin에 저장되며, pywhispercpp가 받는 것과 같은 파일입니다. - 직접 다운로드:
curl -L -o ggml-base.bin https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.bin으로 스크립트 없이 모델을 받을 수 있습니다.base를tiny,small,medium,large-v3로 바꾸십시오. - 패키지를 혼동하지 마십시오:
pip install openai-whisper는 OpenAI의 원본 PyTorch Whisper를 설치하며(.pt체크포인트를 사용하고ggml-base.bin을 사용하지 않음),pip install faster-whisper는 CTranslate2 형식을 사용합니다. GGMLggml-*.bin파일을 사용하는 것은pywhispercpp뿐입니다. - 파일 위치: pywhispercpp는 내려받은 GGML 모델을 모듈 캐시(또는
Model("base", models_dir="...")로 지정한 경로)에 저장하므로 같은ggml-base.bin을 다시 받지 않고 재사용합니다.
# 1. Install the pip binding for whisper.cpp
pip install pywhispercpp

# 2. ggml-base.bin downloads automatically on first use
#    from pywhispercpp.model import Model
#    model = Model("base")          # fetches & caches ggml-base.bin (~142 MB)
#    for seg in model.transcribe("audio.wav"):
#        print(seg.text)

# --- Or get ggml-base.bin manually (no pip) ---
# From a cloned whisper.cpp checkout:
bash ./models/download-ggml-model.sh base       # -> models/ggml-base.bin

# Or download the file directly from Hugging Face:
curl -L -o ggml-base.bin \
  https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.bin
직접 비교: 벤치마크 표
모든 벤치마크는 달리 명시되지 않는 한 large-v3 모델을 사용합니다. 속도는 실시간 배율로 측정됩니다(예: 10×는 60분 오디오를 6분에 전사함을 의미). VRAM 수치는 GPU 실행 기준이며, RAM 수치는 CPU 실행 기준입니다.
📍 한 문장으로
Apple Silicon에서 Metal을 사용한 whisper.cpp는 large-v3를 ~10배 실시간 속도로 처리하고, NVIDIA GPU에서 int8을 사용한 faster-whisper는 ~12배 실시간 속도를 달성합니다 — 각 도구는 자신의 대상 플랫폼에서 결정적인 우위를 보입니다.
💬 쉽게 말하면
Mac에서는 whisper.cpp를 선택하십시오(Apple Neural Engine 활용), Windows/Linux의 NVIDIA GPU에서는 faster-whisper를 선택하십시오(실시간보다 12배 빠르게 오디오를 처리하며 GPU 메모리를 40% 덜 사용합니다).
지표 | whisper.cpp (large-v3) | faster-whisper (large-v3) |
|---|---|---|
| 플랫폼 / 언어 | C/C++ (크로스 플랫폼) | Python (CTranslate2) |
| GPU 지원 | CUDA, Metal, Vulkan | CUDA 전용 |
| CPU 최적화 | AVX2, ARM NEON | int8 양자화 |
| 속도 — RTX 4070, large-v3 | ~8배 실시간 | ~12배 실시간 ✓ |
| 속도 — M5 Pro, large-v3 | ~10배 실시간 (Metal) ✓ | ~3배 실시간 (CPU 전용) |
| 속도 — CPU 전용 (x86), base | ~15배 실시간 | ~20배 실시간 ✓ |
| VRAM — large-v3, GPU | ~3 GB | ~2.5 GB (int8) ✓ |
| Python 통합 | 래퍼 필요 (pywhispercpp) | 네이티브 ✓ |
| VAD (침묵 감지) | 수동 (--step 조정) | 내장 (Silero VAD) ✓ |
| 실시간 스트리밍 | 예 (--stream 플래그) ✓ | 예 (VAD 파이프라인) |
| WER 정확도 (large-v3) | 2.5% (동일) | 2.5% (동일) |
| Python 의존성 | 없음 ✓ | Python 3.9+ |
| Raspberry Pi / 임베디드 | 예 — C 바이너리 ✓ | 제한적 — Python 오버헤드 |
| 출력 형식 | SRT, VTT, JSON, CSV, txt | Python 객체 (start, end, text) |
whisper.cpp는 출력을 표준 자막 및 전사 형식(SRT, VTT, JSON, CSV, txt)으로 직접 작성합니다 — 추가 코드 없이 디스크에 파일이 필요한 자막 워크플로에 이상적입니다. faster-whisper는 start, end, text 속성을 가진 세그먼트 객체의 Python 제너레이터를 반환합니다 — 세그먼트 텍스트를 중간 파일 작성 없이 다운스트림 모델에 직접 전달하는 LLM 파이프라인 연결에 이상적입니다. 자막 생성의 경우 whisper.cpp가 더 간단합니다. 세그먼트를 프로그래밍 방식으로 처리하는 파이프라인의 경우 faster-whisper가 더 간단합니다.
참고 벤치마크: faster-whisper의 GPU와 CPU 소요 시간
faster-whisper 프로젝트는 13분 길이 오디오 파일에 대한 자체 소요 시간을 공개하고 있으며, GPU에서는 Flash Attention을 적용한 whisper.cpp가 faster-whisper fp16과 비슷하고, 배치 처리와 int8에서 faster-whisper가 앞선다는 것을 보여 줍니다. 아래 수치는 faster-whisper README에서 가져온 것입니다(GPU 행은 RTX 3070 Ti 8 GB, CUDA 12.4에서 large-v2, CPU 행은 Intel Core i7-12700K 8스레드에서 small 모델, 빔 크기 5). 저희가 직접 측정한 값이 아니며, 위의 large-v3 수치와는 하드웨어와 모델이 다릅니다.
📍 한 문장으로
faster-whisper README 벤치마크에서 GPU의 Flash Attention 적용 whisper.cpp(1m05s)와 faster-whisper fp16(1m03s)은 거의 동률이며, 배치 처리를 적용한 faster-whisper int8은 같은 13분 파일을 16초에 처리합니다.
구성 | 정밀도 | 시간 | VRAM / RAM |
|---|---|---|---|
| GPU · whisper.cpp (Flash Attn) | fp16 | 1m05s | 4127 MB |
| GPU · faster-whisper | fp16 | 1m03s | 4525 MB |
| GPU · faster-whisper | int8 | 59s | 2926 MB |
| GPU · faster-whisper, 배치 8 | int8 | 16s | 4500 MB |
| CPU · whisper.cpp | fp32 | 2m05s | 1049 MB |
| CPU · faster-whisper | int8 | 1m42s | 1477 MB |
| CPU · faster-whisper, 배치 8 | int8 | 51s | 3608 MB |
위의 직접 비교 표와 함께 읽어 주십시오. 이 구성에서 단일 스트림 fp16 GPU 속도는 두 도구가 비슷합니다. faster-whisper의 지속적인 강점은 int8 메모리 절감(fp16의 4.1~4.5 GB 대비 2.9 GB)과 배치 추론(59초 대비 16초)입니다. CPU에서는 배치 처리 없이 whisper.cpp fp32와 faster-whisper int8의 차이가 약 25% 이내입니다.
실시간 전사 설정
실시간 전사는 마이크에서 들어오는 오디오를 청크 단위로 처리하여 음성보다 약간 지연된 텍스트를 생성합니다. 두 도구 모두 이를 지원하지만, 서로 다른 트레이드오프가 있습니다.
- whisper.cpp 스트림 모드:
./stream -m models/ggml-small.bin --step 3000 --length 10000 -t 4를 실행합니다. 3초 청크를 처리하며, small 모델로 ~0.5–1.5초의 지연 시간. Python 불필요. - faster-whisper VAD 파이프라인:
model.transcribe()에서vad_filter=True를 사용합니다. Silero VAD가 침묵 경계에서 자동으로 오디오를 세그먼트화합니다 — 고정 길이 창보다 더 자연스러운 청크. - 실제 지연 시간: small 또는 medium 모델로 라이브 음성보다 0.5–2초 지연. 더 낮은 지연 시간(< 0.5초, 단 WER 더 높음)을 위해서는 tiny를 사용하십시오.
- 실시간용 모델 선택: small 또는 base가 실질적인 최적 지점입니다 — 음성을 따라가기에 충분히 빠르고, 깨끗한 오디오에 대해 충분히 정확합니다. 전용 GPU가 없는 한 실시간에서 large-v3는 피하십시오.
- 마이크 입력: whisper.cpp는 SDL2 또는 portaudio를 통해 원시 오디오를 읽습니다. faster-whisper는 모든 Python 오디오 라이브러리(sounddevice, pyaudio, soundfile)에서 오디오 배열을 읽습니다.
- 안정성: whisper.cpp의 스트림 모드는 침묵 중에 반복 채움 토큰("환각")을 생성할 수 있습니다.
--suppress-blank와--no-speech-threshold로 억제하십시오.
Apple Silicon: whisper.cpp 승
M1, M2, M3, M4, M5 탑재 Mac의 경우, Core ML / Metal 가속을 사용하는 whisper.cpp가 올바른 도구입니다 — 의심의 여지가 없습니다. faster-whisper는 Metal 지원이 없어 Mac에서 CPU 전용으로만 동작하며 large-v3로 ~3배 실시간 속도를 달성합니다. Metal을 사용하는 whisper.cpp는 M5 Pro에서 ~10배 실시간 속도를 달성합니다 — 3배의 속도 이점.
- Core ML 내보내기:
./models/generate-coreml-model.sh large-v3를 실행하여 인코더를 Core ML 형식으로 내보냅니다. 이를 통해 인코더 추론이 Apple Neural Engine으로 오프로드됩니다. - M5 Pro 벤치마크(large-v3, Metal): ~10배 실시간. 60분 오디오를 ~6분에 전사. 참고: M5 Pro는 2026년 3월 출시 — 이것은 커뮤니티의 초기 벤치마크입니다. whisper.cpp가 M5 Neural Engine을 최적화하는 업데이트에 따라 성능이 향상될 수 있습니다.
- M3 MacBook Air 벤치마크(large-v3, Metal): ~7배 실시간. 60분을 ~8.5분에.
- 메모리: 통합 메모리는 별도의 VRAM이 없음을 의미합니다 — 16GB M5 Pro는 large-v3(~3GB)를 다른 프로세스와 함께 편안하게 실행할 수 있습니다.
- Mac에서의 faster-whisper: CPU 전용, int8. Large-v3로 ~3배 실시간 속도. 야간 배치 전사에는 사용 가능하지만, 실시간이나 시간에 민감한 워크플로에는 적합하지 않습니다.
- 권장 사항: Mac에서의 모든 STT 작업에 whisper.cpp를 사용하십시오. Metal 가속을 유지하면서 Python 통합이 필요한 경우 pywhispercpp을 추가하십시오.
NVIDIA GPU: faster-whisper 승
NVIDIA GPU를 탑재한 Windows 및 Linux에서는 faster-whisper가 우수한 선택입니다. CTranslate2의 CUDA 백엔드는 whisper.cpp의 CUDA 경로보다 더 최적화되어 있습니다 — RTX 4070에서 large-v3으로 ~12배 대 ~8배 실시간 속도, 더 낮은 VRAM 사용량.
- RTX 4070(12GB) 벤치마크(large-v3 int8): ~12배 실시간, ~2.5GB VRAM.
- RTX 3060(12GB) 벤치마크(large-v3 int8): ~8배 실시간, ~2.5GB VRAM.
- RTX 4060(8GB) 벤치마크(large-v3 int8): ~7배 실시간, ~2.5GB VRAM — 여유 있게 수용됩니다.
- int8 vs float16: int8은 ~2배 빠르고 VRAM을 ~40% 적게 사용하며 정확도 손실은 무시할 수준입니다. NVIDIA에서는 항상
compute_type="int8"을 사용하십시오. - 배치 처리: faster-whisper의
batched=True파라미터는 여러 오디오 파일의 병렬 처리를 가능하게 하여, 대규모 전사 작업에서 GPU 활용을 극대화합니다. - Python 파이프라인 통합: faster-whisper는 LangChain, Haystack 및 커스텀 Python 파이프라인에 직접 통합됩니다. whisper.cpp 래핑과 비교하여 서브프로세스 오버헤드 없음.
구형 NVIDIA GPU(GTX 970): int8이 float32로 대체됨
GTX 970(Maxwell, compute capability 5.2)에서도 faster-whisper는 CUDA로 동작하지만, compute_type="int8"을 지정해도 실제 int8이 되지 않고 CTranslate2가 가중치를 float32로 변환합니다. 양자화 표는 compute capability 6.0 이하의 모든 GPU를 요청한 타입과 무관하게 float32로 매핑하므로, RTX 카드에서 언급되는 약 40%의 VRAM 절감과 int8 속도 향상은 적용되지 않습니다.
📍 한 문장으로
GTX 970(compute capability 5.2)에서 faster-whisper는 CUDA에서 float32로만 동작하며, 요청한 int8 연산 타입은 자동으로 변환됩니다.
💬 쉽게 말하면
GTX 970은 GPU int8을 쓰기에는 너무 오래되었습니다. 동작은 하지만 메모리 절감이 없으므로 4 GB에서는 tiny, base, small 모델을 사용하십시오.
- 여전히 동작하는 것: CTranslate2의 사전 빌드 바이너리는 compute capability 3.5 이상의 NVIDIA GPU를 지원하므로 GTX 970(5.2)에서도 설치된 CUDA와 cuDNN 라이브러리가 릴리스와 맞는다면 faster-whisper를 CUDA로 실행할 수 있습니다(일반적인 문제 참조).
- GPU int8이 동작하는 범위: int8은 compute capability 7.0 이상(Volta 및 RTX 20 시리즈 이후) 또는 정확히 6.1(GTX 1050~1080 Ti, int8_float32)이 필요합니다. 6.0, 6.2 및 그 이하는 float32로 대체되며, float16은 7.0 이상이 필요합니다.
- 메모리에 미치는 영향: float32는 파라미터당 4바이트로 int8의 1바이트보다 큽니다. 파라미터 수로 계산하면 large-v3(1.55B)는 가중치만으로 약 6 GB가 필요하여 GTX 970의 4 GB를 넘습니다. small(244M, float32로 약 1 GB)은 여유 있게 들어가고 medium(769M, 약 3 GB)은 빠듯합니다.
- 속도: GTX 970을 벤치마크하지 않았으므로 여기에는 실측값이 없습니다. 이 가이드의 RTX 4070 int8 수치보다 훨씬 낮은 float32 처리량을 예상하시고, tiny, base, small을 직접 가진 오디오로 테스트하십시오.
- GPU가 지원하는 타입 확인:
ctranslate2.get_supported_compute_types("cuda")는 CTranslate2가 해당 카드에서 허용하는 연산 타입을 나열합니다. - 대안: CPU int8(
device="cpu", compute_type="int8")은 최신 x86 CPU 어디에서나 동작하며, whisper.cpp의 양자화 GGML 모델(예:ggml-large-v3-q5_0.bin, 약 3~4 GB)은 더 큰 모델을 4 GB에 맞추는 일반적인 방법입니다. 사용 중인 카드에서 CUDA 또는 Vulkan 빌드를 확인하십시오.
import ctranslate2
from faster_whisper import WhisperModel

# Which compute types does this GPU accept?
print(ctranslate2.get_supported_compute_types("cuda"))

# On compute capability < 6.1 (e.g. GTX 970), request float32 explicitly so nothing is converted silently
model = WhisperModel("small", device="cuda", compute_type="float32")
Raspberry Pi 5의 Whisper: tiny, base, small
Raspberry Pi 5에서 whisper.cpp는 tiny와 base 모델을 실시간 전사에 사용할 수 있지만, small 모델은 실시간보다 느리므로 배치 작업에 쓰는 것이 좋습니다. Pi 5의 쿼드코어 Cortex-A76에는 Whisper용으로 쓸 만한 GPU 경로가 없어 모든 추론이 CPU(ARM NEON)에서 이루어집니다. 양자화 GGML 모델(ggml-*-q5_0.bin)을 사용하면 메모리 사용량이 줄고 추론이 빨라집니다.
📍 한 문장으로
Raspberry Pi 5에서 whisper.cpp small 모델은 실시간보다 느리게(약 0.5×, 배치 전용) 동작하며, 실시간 음성을 따라가는 것은 tiny와 base입니다.
💬 쉽게 말하면
Pi 5는 tiny와 base Whisper 모델로 실시간 오디오를 전사할 수 있지만, small 모델은 실시간을 따라가기에 너무 무겁습니다. small은 라이브 마이크가 아니라 백그라운드에서 처리하는 녹음 파일에 사용하십시오.
- Pi 5의 Whisper small: CPU에서 대략 실시간의 0.4~0.6배(10분 클립에 약 17~25분)입니다. WER 3.4%로 정확하지만 라이브 자막에는 너무 느리므로 야간/배치 전사에 사용하십시오.
- Pi 5의 Whisper base: 멀티스레딩(
-t 4)으로 실시간에서 약 2배 사이입니다. WER 5.0%를 허용할 수 있다면 Pi에서 실시간 전사에 가장 현실적인 선택입니다. - Pi 5의 Whisper tiny: 가장 빠른 옵션으로 실시간 사용에 충분히 여유가 있지만 WER이 7.6%로 높습니다. 웨이크 워드와 짧은 명령 인식에 적합합니다.
- 양자화 모델 사용:
bash ./models/download-ggml-model.sh small-q5_0은 정확도 손실을 최소화하면서 RAM을 줄이고 추론을 빠르게 합니다. Pi 5의 공유 메모리에서는 중요합니다. - Pi 5의 faster-whisper: 설치할 수 있고(
pip install faster-whisper, CPU int8) 배치 작업에서는 경쟁력이 있지만, 임베디드에서는 더 가벼운 C 바이너리인 whisper.cpp가 더 흔한 선택입니다. - 발열: 지속적인 전사는 Pi 5 CPU에 큰 부하를 주므로, 이 수치가 떨어지는 열 스로틀링을 피하려면 능동 냉각을 사용하십시오.
어느 것을 사용해야 하는가
시나리오에서 적합한 도구로의 직접적인 매핑:
📍 한 문장으로
Apple Silicon 및 임베디드/크로스 플랫폼 대상에서는 whisper.cpp를, NVIDIA GPU 및 Python 파이프라인에서는 faster-whisper를 사용하십시오.
💬 쉽게 말하면
Mac이 있다면 whisper.cpp를 선택하십시오 — Apple 하드웨어에서 faster-whisper보다 3배 빠릅니다. NVIDIA GPU가 있고 Python을 작성한다면 faster-whisper를 선택하십시오 — 더 빠르고 GPU 메모리를 40% 덜 필요로 합니다.
시나리오 | 최선의 선택 | 이유 |
|---|---|---|
| Apple Silicon Mac (모든 모델) | whisper.cpp | Metal / Core ML 가속 — Mac에서 CPU 전용인 faster-whisper보다 3배 빠름 |
| NVIDIA GPU 서버 (Linux/Windows) | faster-whisper | CTranslate2 int8 — whisper.cpp의 CUDA 경로보다 빠르고 VRAM 적게 사용 |
| Python 데이터 파이프라인 | faster-whisper | 네이티브 Python API; 서브프로세스 래퍼 없음; 내장 VAD |
| Raspberry Pi / 임베디드 Linux | whisper.cpp | 순수 C 바이너리; Python 런타임 오버헤드 없음; ARM NEON 최적화 |
| 실시간 음성 어시스턴트 | whisper.cpp | 낮은 오버헤드의 스트림 모드; Pi / 임베디드에서 Python 없이 동작 |
| 배치 전사 (대용량 오디오 파일) | faster-whisper | 배치 추론, GPU 활용, 비동기 Python 통합 |
| AMD GPU (Vulkan) | whisper.cpp | Vulkan 백엔드 지원; faster-whisper는 CUDA 전용 |
| CPU 전용 Linux 서버 | faster-whisper | int8 양자화가 x86 CPU에서 ~30% 속도 이점 제공 |
whisper.cpp와 faster-whisper를 넘어서
두 가지 추가 도구는 Whisper를 두 기본 도구 모두가 기본적으로 제공하지 않는 기능으로 확장합니다: 화자 분리(diarization)와 초고속 GPU 배치 추론.
- WhisperX: faster-whisper 기반으로 구축된 WhisperX는 단어 수준 타임스탬프와 화자 분리를 추가합니다 — 어떤 화자가 어떤 단어를 말했는지 식별합니다. 최적 사용 사례: 화자 레이블이 있는 회의 전사, 팟캐스트 편집, 인터뷰 전사.
pip install whisperx로 설치하고 분리 모델에 대한 Hugging Face 토큰을 제공하십시오. - insanely-fast-whisper: Flash Attention 2 지원을 추가하는 Hugging Face Transformers 파이프라인 래퍼로, NVIDIA 하드웨어에서 표준 faster-whisper보다 훨씬 빠른 GPU 추론을 제공합니다. 최적 사용 사례: NVIDIA GPU에서 대용량 오디오 파일 배치 처리. Flash Attention 2 호환 GPU 필요(Ampere 이상: RTX 3000+, A100, H100).
일반적인 문제 및 해결책
가장 자주 발생하는 설정 및 런타임 문제와 직접적인 해결책:
- CUDA 버전 불일치: 현재의 faster-whisper 릴리스에는 CUDA 12용 cuBLAS와 cuDNN 9가 필요합니다. 오래된 라이브러리에 묶여 있다면 ctranslate2를 고정하십시오:
pip install --force-reinstall ctranslate2==4.4.0(CUDA 12와 cuDNN 8) 또는3.24.0(CUDA 11과 cuDNN 8). CUDA 버전은nvcc --version으로 확인하십시오. - Metal 모델 내보내기 실패: Xcode Command Line Tools가 설치되어 있는지 확인하십시오 —
xcode-select --install을 실행합니다. Core ML 내보내기 스크립트는coremltoolsPython 패키지가 필요합니다:pip install coremltools. - 침묵 중 환각: 두 도구 모두 음성이 없는 오디오 세그먼트에서 반복 채움 토큰을 생성할 수 있습니다. whisper.cpp 스트림 모드에서는
--no-speech-threshold 0.6을, faster-whisper의model.transcribe()에서는vad_filter=True를 사용하여 자동으로 음성이 없는 세그먼트를 건너뛰십시오. - large-v3 메모리 부족: faster-whisper에서 int8 양자화로 전환하십시오(
compute_type="int8") — VRAM을 ~5GB(float16)에서 ~2.5GB로 줄입니다. whisper.cpp에서는 양자화된 GGML 변형을 사용하십시오(예:ggml-large-v3-q5_0.bin) — 메모리를 ~3–4GB로 줄입니다. - 영어가 아닌 오디오에서 알아볼 수 없는 출력: 영어가 아닌 음성에
.en모델 변형(tiny.en, base.en)을 사용하지 마십시오 — 이것들은 영어 전용입니다. 다국어 모델(base, small, medium, large-v3)을 사용하고 언어를 명시적으로 지정하십시오: whisper.cpp에서-l ko또는 faster-whisper에서language="ko". - 느린 CPU 추론: CPU가 AVX2 명령어를 지원하는지 확인하십시오(최적화된 CPU 추론에 필요). Linux에서
grep avx2 /proc/cpuinfo또는 Mac에서sysctl machdep.cpu.features로 확인하십시오. AVX2 없는 CPU는 일반 SIMD로 폴백되어 2–3배 느립니다.
자주 묻는 질문
whisper.cpp용 Debian 또는 apt 패키지가 있습니까?
예 — whisper.cpp는 이제 Debian(현재 sid)에 공식 패키지로 제공되며, whisper.cpp 바이너리와 함께 공유 라이브러리로 링크할 수 있는 libwhisper-dev, libwhisper1도 제공합니다. 아직 Debian 안정 버전이나 Ubuntu 기본 저장소에는 도달하지 않았으므로, 대부분의 시스템에서는 여전히 sid를 사용하거나 소스에서 빌드해야 합니다. 소스 빌드를 원하지 않는다면 Debian 9 이상과 Ubuntu용 비공식 Snap(sudo snap install whisper-cpp)도 사용할 수 있습니다.
설치된 whisper.cpp 버전은 어떻게 확인합니까?
컴파일된 바이너리를 인자 없이 또는 --help와 함께 실행하면 배너 줄에 버전이 출력됩니다. 클론한 저장소 안에서 git describe --tags로 정확한 커밋을 확인하거나, 빌드 날짜를 github.com/ggml-org/whisper.cpp/releases의 릴리스 노트와 비교해 현재 버전인 v1.9.5보다 뒤처졌는지 확인할 수도 있습니다.
whisper.cpp와 faster-whisper의 전사 정확도는 동일합니까?
그렇습니다. 두 도구 모두 동일한 OpenAI Whisper 모델 가중치를 사용합니다 — 모델 자체는 동일합니다. 차이는 추론 런타임(C/C++ vs CTranslate2 Python)에만 있습니다. 동일한 오디오 파일에 대한 WER은 서로 절대값 0.1% 이내로, 이는 beam search 무작위성으로 인한 정상적인 변동 범위 내입니다.
Apple Silicon Mac에서 faster-whisper를 사용할 수 있습니까?
예, 하지만 CPU 전용으로만 동작합니다 — faster-whisper는 Metal 지원이 없습니다. M5 Pro에서 faster-whisper large-v3는 ~3배 실시간 속도(CPU int8)로 동작하며, Metal을 사용하는 whisper.cpp의 ~10배와 비교됩니다. 대부분의 Mac 사용자에게 whisper.cpp는 동일한 모델로 3배 더 빠릅니다. Mac에서 faster-whisper를 사용하는 유일한 이유는 Python 파이프라인이 이미 이에 의존하고 있으며 속도가 중요하지 않은 경우입니다.
음성 어시스턴트에 어떤 Whisper 모델 크기를 사용해야 합니까?
실시간 음성 인터페이스의 경우, Whisper small이 표준 권장 사항입니다 — 깨끗한 영어에서 3.4% WER, 현대적인 CPU 또는 GPU에서 ~200ms STT 지연 시간, 2GB RAM에 수용됩니다. 하드웨어가 매우 제한된 경우(Raspberry Pi Zero 2W, 구형 전화기) ~7.6% WER을 허용할 수 있다면 tiny를 사용하십시오. 지연 시간이 제약이 아닌 배치 전사의 경우에만 medium 또는 large-v3를 사용하십시오.
whisper.cpp는 영어 외의 언어를 지원합니까?
그렇습니다. 모든 다국어 Whisper 모델(base, small, medium, large-v3)은 99개 언어를 지원합니다. CLI에 `-l [언어 코드]를 추가하십시오: 한국어는 -l ko, 독일어는 -l de, 일본어는 -l ja` 등. tiny.en 및 base.en 모델은 영어 전용이며 다국어 대응물보다 영어에서 약간 더 정확합니다.
CUDA 지원을 포함하여 faster-whisper를 어떻게 설치합니까?
pip install faster-whisper로 설치합니다. 현재 릴리스에는 시스템에 CUDA 12용 NVIDIA cuBLAS와 cuDNN 9가 필요합니다(Linux에서는 pip install nvidia-cublas-cu12 "nvidia-cudnn-cu12==9.*"로 설치할 수 있습니다). 오래된 CUDA 11 / cuDNN 8 환경에서는 ctranslate2==3.24.0(CUDA 12와 cuDNN 8이라면 4.4.0)으로 고정하십시오. 그런 다음 모델 로딩 시 device="cuda"를 지정합니다: WhisperModel("large-v3", device="cuda", compute_type="int8"). CUDA를 사용할 수 없을 때 CPU로 폴백하려면 device="auto"를 사용하십시오.
whisper.cpp와 faster-whisper 중 어느 것이 더 정확합니까?
동일합니다. 두 도구 모두 동일한 OpenAI Whisper 모델 가중치를 사용하며 동일한 오디오 파일에 대해 동일한 WER을 생성합니다. whisper.cpp와 faster-whisper의 차이점은 속도와 플랫폼 지원이지 전사 정확도가 아닙니다. 실행 간에 측정되는 WER 차이는 런타임 자체에서 비롯된 것이 아니라 beam search의 정상적인 변동 범위 내에 있습니다.
8GB RAM으로 Whisper large-v3를 실행할 수 있습니까?
GPU에서는 가능합니다 — faster-whisper의 large-v3 int8은 ~2.5GB VRAM을 사용하며 8GB GPU에서 동작합니다. CPU 전용 하드웨어에서 8GB RAM은 large-v3(float32는 ~10GB 사용)에 빠듯합니다. CPU 전용 시스템에서는 medium(5GB RAM) 또는 small(2GB RAM)을 사용하십시오. whisper.cpp는 런타임 오버헤드가 적어 CPU에서 faster-whisper보다 메모리 효율이 높습니다.
로컬 Whisper vs 클라우드 STT의 비용은 얼마입니까?
지속적인 비용은 없습니다. 클라우드 STT 서비스는 오디오 분당 $0.006–$0.024를 부과합니다 — 주당 8시간 회의를 전사하는 개발자에게는 월 $120–480입니다. 로컬 Whisper는 이미 소유한 하드웨어에서 동작하며, 분당 요금 없고, API 키 관리 없고, 오디오 데이터가 기기를 떠나지 않습니다.
GTX 970에서 faster-whisper int8이 동작합니까?
실제 int8로는 동작하지 않습니다. GTX 970의 compute capability는 5.2이며, CTranslate2는 compute capability 7.0 이상(또는 정확히 6.1)의 GPU에서만 int8을 실행합니다. 더 오래된 카드에서는 가중치가 자동으로 float32로 변환됩니다. faster-whisper는 여전히 GPU에서 float32로 동작하므로 4 GB 안에 머물려면 tiny, base, small을 사용하거나 최신 x86 CPU에서 동작하는 CPU int8을 사용하십시오. GTX 970을 벤치마크하지 않았으므로 실측 속도 수치는 없습니다.
whisper.cpp와 faster-whisper의 Whisper 모델 파일은 얼마나 큽니까?
whisper.cpp README는 GGML 모델 파일의 디스크 크기를 tiny 약 75 MiB, base 142 MiB, small 466 MiB, medium 1.5 GiB, large 2.9 GiB로 나열하며, 필요한 메모리는 각각 약 273 MB, 388 MB, 852 MB, 2.1 GB, 3.9 GB입니다. faster-whisper는 처음 사용할 때 Hugging Face에서 CTranslate2 모델을 내려받으며, large-v3는 약 3 GB입니다(1.55B 파라미터 × float16 2바이트). 위의 모델 크기 표에 각 크기의 파라미터 수가 나와 있습니다.
로컬 전사에서 Whisper large-v3-turbo가 large-v3보다 낫습니까?
더 빠를 뿐 더 정확하지는 않습니다. large-v3-turbo는 OpenAI가 디코더를 32층에서 4층으로 줄였기 때문에 809M 파라미터이며, 모델 카드는 large-v3보다 훨씬 빠르고 품질 저하는 경미하다고 설명합니다(MIT 라이선스). 카드는 환각이나 텍스트 반복 가능성과 언어별 정확도 편차도 경고합니다. 가장 어려운 오디오에는 large-v3를, 속도가 중요하면 turbo(영어라면 distil-large-v3)를 사용하십시오. whisper.cpp와 faster-whisper 모두 실행할 수 있습니다.
whisper.cpp는 CUDA 대신 AMD나 Intel GPU를 사용할 수 있습니까?
예. whisper.cpp의 Vulkan 백엔드(-DGGML_VULKAN=1)는 드라이버가 Vulkan API를 지원하면 제조사와 무관하게 동작하고, ROCm/HIP(-DGGML_HIP=1)은 AMD GPU를 대상으로 하며, OpenVINO는 Intel CPU와 GPU에서 인코더를 가속합니다. faster-whisper 자체 문서는 NVIDIA CUDA만 다루며, CTranslate2 릴리스 노트에는 ROCm 휠이 언급되지만 해당 경로는 테스트하지 않았습니다.
Mac에서 mlx-whisper가 whisper.cpp보다 빠릅니까?
large-v3-turbo에 대해서는 독립적인 테스트가 그렇다고 말합니다. Bill Mill의 2026년 1월 재측정에서는 같은 긴 녹음에서 mlx_whisper가 약 13.1초, whisper.cpp가 26.7초로 약 2배 빨랐습니다. 짧은 클립에 대한 커뮤니티 속도 테스트에서는 두 도구가 비슷했으며, whisper.cpp는 Core ML과 q5_0 양자화를 사용했습니다. 이 가이드의 M5 Pro 수치는 MLX와 비교하지 않았으므로 선택하기 전에 직접 가진 오디오로 벤치마크하십시오.
참고 자료
- GitHub의 whisper.cpp — 소스 코드, 빌드 지침, 모델 다운로드 스크립트, Metal/Core ML 설정 가이드.
- GitHub의 faster-whisper — 소스 코드, Python API 문서, 벤치마크 결과.
- Hugging Face의 distil-whisper/distil-large-v3 — 모델 카드, 벤치마크 결과, 증류된 Whisper 변형 사용 지침.
- GitHub의 WhisperX — faster-whisper 기반 단어 수준 타임스탬프 및 화자 분리.
- GitHub의 insanely-fast-whisper — NVIDIA GPU 최대 처리량을 위한 Whisper Flash Attention 2 파이프라인.
- GitHub의 OpenAI Whisper — 원본 Whisper 모델, 논문, 모든 크기의 모델 카드.
- OpenAI Whisper 논문 (Radford et al., 2022) — "Robust Speech Recognition via Large-Scale Weak Supervision". WER 값의 출처.
- CTranslate2 문서 — 양자화 세부 사항, 하드웨어 지원, int8 최적화 기초.
- CTranslate2 양자화 문서 — GPU compute capability별로 지원되는 연산 타입(GTX 970 섹션의 근거).
- faster-whisper README 벤치마크 — 참고 벤치마크에 사용한 13분 GPU·CPU 소요 시간과 현재 CUDA 12 / cuDNN 9 요구 사항.
- Hugging Face의 openai/whisper-large-v3-turbo — 모델 카드: 809M 파라미터, 디코더 4층, MIT 라이선스.
- Bill Mill: mlx_whisper와 whisper.cpp 벤치마크 업데이트 — Apple Silicon에서 large-v3-turbo 소요 시간의 독립 비교.
- whisper.cpp 릴리스 — v1.9.4와 v1.9.5 릴리스 노트.