Conclusiones clave
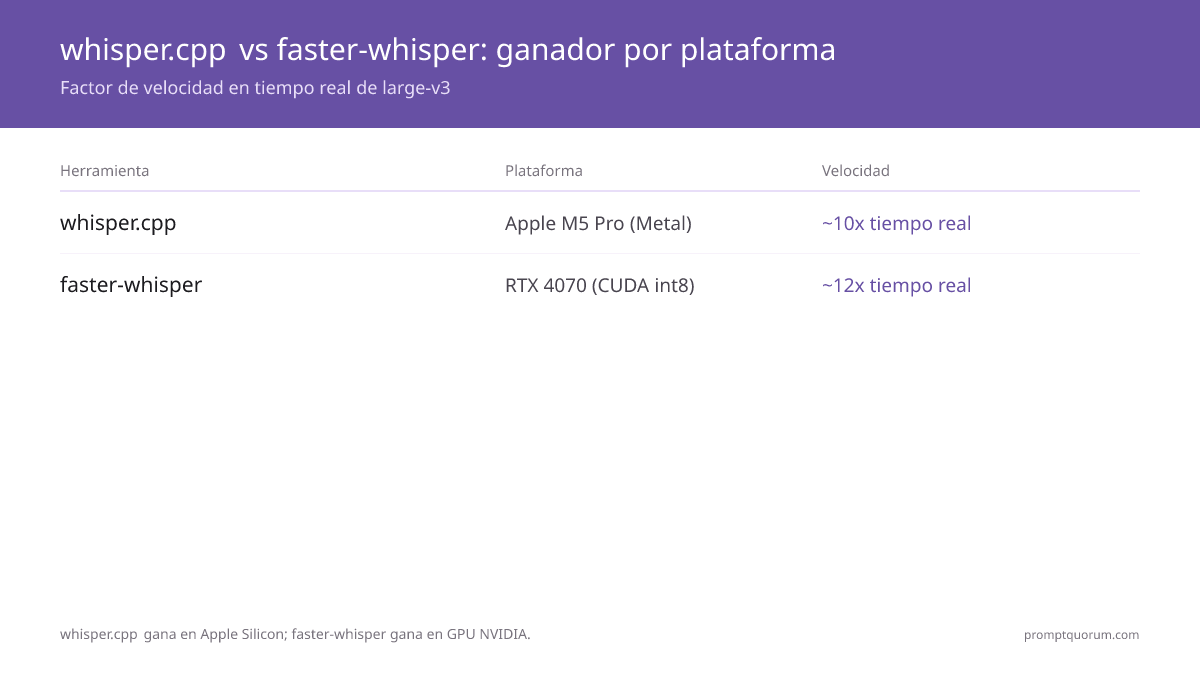
- whisper.cpp es la mejor opción STT local para Apple Silicon. El port C/C++ aprovecha Core ML y Apple Metal para aceleración por hardware — large-v3 a ~10× tiempo real en M5 Pro, sin dependencia de Python.
- faster-whisper es la mejor opción STT local para GPUs NVIDIA y pipelines Python. La cuantización int8 de CTranslate2 reduce el VRAM en ~40% y aumenta el rendimiento ~4× respecto a la implementación original de OpenAI — large-v3 a ~12× tiempo real en RTX 4070, usando solo ~2,5 GB de VRAM.
- Ambas herramientas usan los mismos pesos del modelo Whisper de OpenAI. El WER (tasa de error de palabras) es idéntico — la diferencia está únicamente en el rendimiento del runtime y el camino de integración, no en la precisión de transcripción.
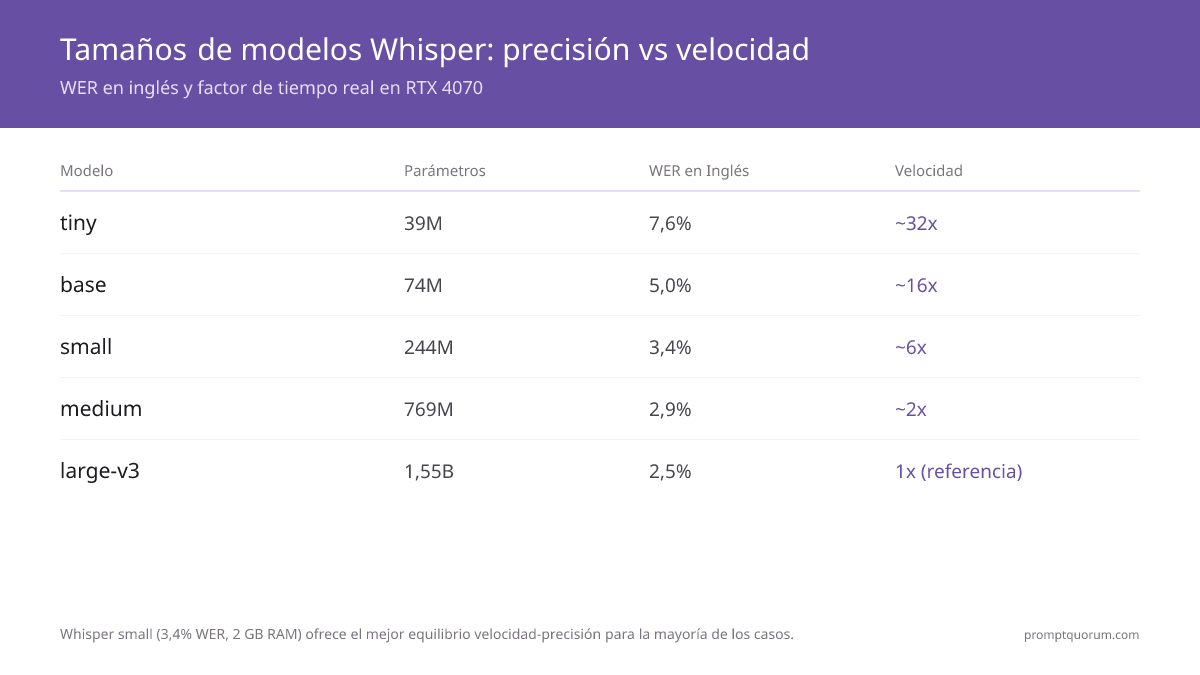
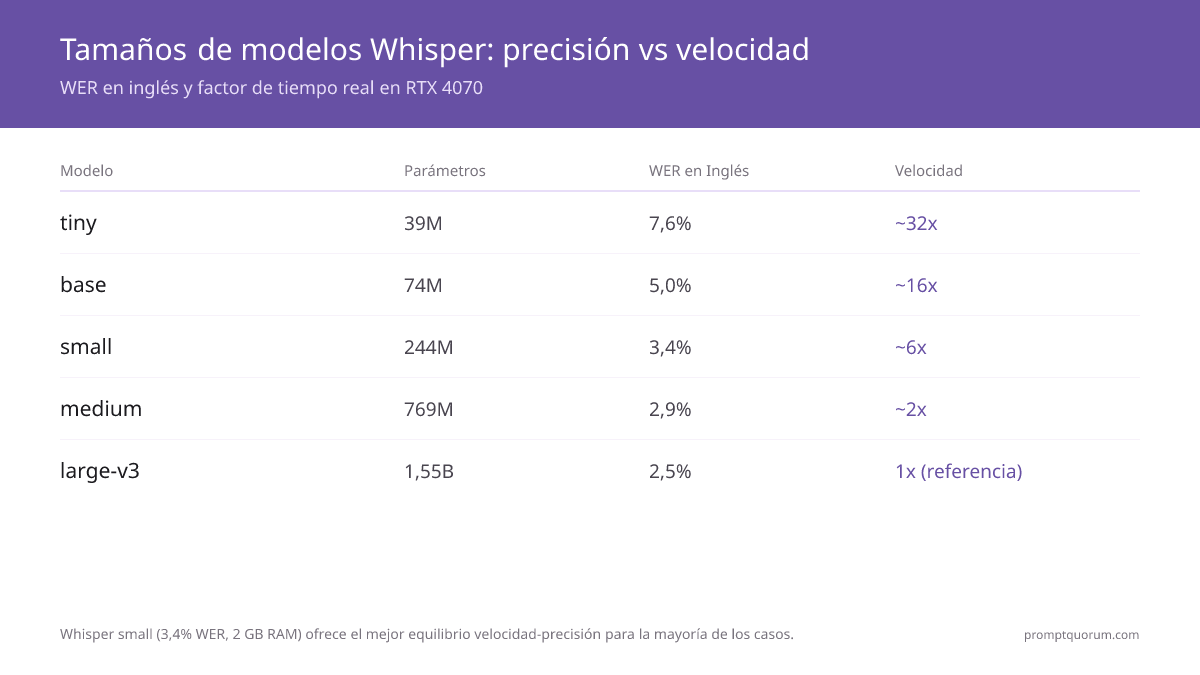
- Whisper large-v3 ofrece la mejor precisión con 2,5% WER en inglés. Para la mayoría de casos de producción, Whisper small (3,4% WER, 2 GB RAM) o medium (2,9% WER, 5 GB RAM) ofrece mejor equilibrio entre velocidad y precisión.
- La transcripción en tiempo real es alcanzable con ambas herramientas — whisper.cpp mediante su flag
--stream, faster-whisper mediante su pipeline VAD (detección de actividad de voz) integrado. La latencia práctica es de 0,5–2 segundos detrás del habla en vivo según el tamaño del modelo. - whisper.cpp funciona en CPU, Metal, CUDA y Vulkan — siendo la opción más práctica para uso embebido multiplataforma (Raspberry Pi, configuraciones GPU en Windows, servidores ARM). faster-whisper solo admite CPU y CUDA (sin Metal en Mac).
- Para Raspberry Pi 5 y Linux embebido, whisper.cpp tiny y base en CPU son los modelos capaces de tiempo real — tiny funciona cómodamente más rápido que el tiempo real, base en torno al tiempo real con
-t 4. El modelo small (3,4% WER) funciona por debajo del tiempo real en el Pi 5 y conviene reservarlo para trabajos por lotes. Toda la inferencia es en CPU (ARM NEON) — el Pi no tiene una ruta GPU utilizable para Whisper.
Datos rápidos
- Ambas herramientas: basadas en el modelo Whisper de código abierto de OpenAI (licencia MIT). Misma precisión — runtimes diferentes.
- whisper.cpp: escrito en C/C++ por Georgi Gerganov. Admite CPU (AVX2/NEON), CUDA, Metal (Apple), Vulkan. No requiere Python.
- faster-whisper: librería Python usando CTranslate2. Admite CPU (int8) y CUDA. Sin soporte para Apple Metal.
- Tamaños del modelo Whisper: tiny (39M), base (74M), small (244M), medium (769M), large-v3 (1,55B). Todos en formato ggml / CTranslate2.
- Mejor modelo para la mayoría de casos: Whisper small — 3,4% WER, funciona en 2 GB de RAM, 6× tiempo real en CPU moderno.
- Benchmark RTX 4070 (large-v3): faster-whisper ~12× tiempo real; whisper.cpp CUDA ~8× tiempo real. faster-whisper gana en NVIDIA.
- Benchmark M5 Pro (large-v3): whisper.cpp Metal ~10× tiempo real; faster-whisper solo-CPU ~3× tiempo real. whisper.cpp gana en Apple.
¿Por qué reconocimiento de voz local?
Los servicios STT en la nube (Google Speech-to-Text, AWS Transcribe, Azure Speech) cobran por minuto de audio — típicamente $0,006–$0,024/minuto — y envían el audio a servidores remotos. Para aplicaciones sensibles a la privacidad (dictado médico, grabaciones legales, entrevistas periodísticas, reuniones corporativas), la transcripción local elimina completamente la exposición de datos.
- Privacidad: el audio nunca sale de tu equipo, así que ningún proveedor cloud interviene en la transcripción. Las obligaciones de protección de datos, como la base legal y el almacenamiento seguro, siguen siendo tuyas.
- Costo: sin tarifas por minuto. Un desarrollador que transcribe 8 horas de reuniones por semana ahorra $120–480/mes respecto a precios STT en la nube.
- Offline: funciona en aviones, instalaciones seguras y zonas sin internet estable. Sin gestión de API keys.
- Latencia: sin ida y vuelta de subida/descarga. Para interfaces de voz en tiempo real, el procesamiento local reduce la latencia STT de 300–800 ms (nube) a 50–300 ms.
- Personalización: ajusta el modelo con vocabulario específico del dominio. Ejecuta el tamaño de modelo que quepa en tu hardware.
- Integración con Home Assistant: Whisper en local significa que las palabras de activación y los comandos de voz nunca salen de tu red doméstica. Ver Whisper local en Home Assistant → para la configuración del complemento que reemplaza completamente el STT en la nube.
Tamaños del modelo Whisper — base de ambas herramientas
Tanto whisper.cpp como faster-whisper usan los mismos pesos del modelo Whisper, convertidos a sus formatos respectivos (GGML para whisper.cpp, CTranslate2 para faster-whisper). Elige el tamaño del modelo según tu presupuesto de VRAM/RAM y tus requisitos de precisión.
Modelo | Parámetros | VRAM / RAM | WER inglés | Factor vs tiempo real (RTX 4070) |
|---|---|---|---|---|
| tiny | 39M | ~1 GB | 7,6% | ~32× |
| base | 74M | ~1 GB | 5,0% | ~16× |
| small | 244M | ~2 GB | 3,4% | ~6× |
| medium | 769M | ~5 GB | 2,9% | ~2× |
| large-v3 | 1,55B | ~10 GB | 2,5% | 1× (referencia) |
| distil-large-v3 | ~756M | ~4 GB | ~2,6% | ~6× |
Valores WER (tasa de error de palabras) del paper de Whisper en el conjunto de prueba limpio de LibriSpeech. Menor es mejor. Factores de velocidad para faster-whisper int8 en RTX 4070. Valores de distil-large-v3 del paper de Distil-Whisper.
Distil-Whisper: la alternativa más rápida
distil-whisper/distil-large-v3 es una variante destilada de large-v3 con ~50% menos parámetros, que funciona ~6× más rápido manteniendo el WER dentro del ~1% del original. Es la elección correcta cuando la velocidad de transcripción importa más que exprimir el último porcentaje de precisión. distil-large-v3 funciona con faster-whisper (soporte CTranslate2 nativo) y whisper.cpp (mediante conversión al formato GGML), integrándose en el runtime que ya uses.
- Parámetros: ~756M — aproximadamente la mitad de los 1,55B de large-v3, cabe en ~4 GB de VRAM en lugar de ~10 GB.
- Velocidad: ~6× tiempo real en RTX 4070 (vs. 1× de referencia para large-v3) — comparable al modelo medium en velocidad, con precisión cercana a large-v3.
- WER: ~2,6% en inglés — solo ~0,1% superior al 2,5% de large-v3. En la práctica, la diferencia es imperceptible en habla típica.
- Compatibilidad: funciona con faster-whisper de forma nativa (
WhisperModel("distil-large-v3", device="cuda", compute_type="int8")). Para whisper.cpp, convierte al formato GGML usando el script de conversión GGML de distil-whisper. - Mejor para: trabajos de transcripción por lotes, despliegues en servidor con VRAM limitada y cualquier caso de uso donde quieras calidad de large-v3 a velocidad del modelo medium.
- No recomendado para: transcripción multilingüe — distil-large-v3 es solo inglés. Para otros idiomas, usa large-v3 o medium.
whisper.cpp — el port C/C++
whisper.cpp (de Georgi Gerganov) es una reimplementación pura en C/C++ del modelo Whisper de OpenAI, optimizada para inferencia de bajo consumo de recursos y multiplataforma. No requiere Python, ni CUDA toolkit, y funciona en prácticamente cualquier hardware — desde Raspberry Pi hasta Apple M5 Pro o configuraciones Windows CUDA.
- Soporte de plataformas: CPU (AVX2, AVX512, ARM NEON), Apple Metal (Core ML), CUDA (NVIDIA), Vulkan (GPU AMD/Intel), OpenCL.
- Ventaja en Apple Silicon: whisper.cpp exporta modelos al formato Core ML, habilitando inferencia en el Apple Neural Engine. Large-v3 funciona a ~10× tiempo real en M5 Pro mediante Metal — más rápido que cualquier ida y vuelta a la nube.
- Instalación: clona el repositorio, ejecuta
make(ocmake). Binarios precompilados disponibles para plataformas comunes. Sin dependencia de Python. - Descarga de modelo:
bash ./models/download-ggml-model.sh base.en— descarga el archivo de modelo en formato GGML (~142 MB para base). - Ejemplo de CLI:
./main -m models/ggml-base.bin -f audio.wav— transcribe un archivo WAV a la salida estándar. Añade-l espara español. - Modo stream en tiempo real:
./stream -m models/ggml-base.bin --step 3000 --length 10000— transcribe desde el micrófono en chunks de 3 segundos. - Wrapper Python: pywhispercpp proporciona un binding Python para whisper.cpp, permitiendo su uso en pipelines Python sin sacrificar la aceleración Metal.
- Limitación: sin VAD (detección de actividad de voz) nativo. El modo stream requiere ajustar los parámetros
--stepy--lengthsegún el caso de uso.
# Build from source (macOS / Linux)
git clone https://github.com/ggerganov/whisper.cpp
cd whisper.cpp
make -j4

# Download a model
bash ./models/download-ggml-model.sh large-v3

# Transcribe a file
./main -m models/ggml-large-v3.bin -f recording.wav

# Enable Metal on Apple Silicon (Core ML)
make -j4 WHISPER_COREML=1
./main -m models/ggml-large-v3-encoder.mlmodelc -f recording.wav
whisper.cpp: última versión y novedades
La última versión de whisper.cpp es la v1.9.5, publicada el 6 de octubre de 2026. Sincroniza la biblioteca ggml incluida con la v0.26.0 (trabajo en los backends CUDA, Vulkan, Metal, SYCL, OpenCL y los kernels de CPU) y añade correcciones de Whisper, como un callback de aborto durante la detección de idioma y una corrección de desbordamiento de enteros en los desplazamientos de chunks paralelos. whisper.cpp también cuenta con paquete oficial de Debian (sid) (whisper.cpp, libwhisper-dev, libwhisper1), además del Snap no oficial. La última versión etiquetada de faster-whisper sigue siendo la v1.2.1 (31 de octubre de 2025), pero el repositorio se mantiene activamente: hubo commits tan recientes como el 16 de octubre de 2026. Ambos runtimes siguen cargando los mismos pesos de OpenAI Whisper; nada cambió en 2026 sobre la precisión de la transcripción.
- whisper.cpp v1.9.5 (6 de octubre de 2026): sincroniza ggml con la v0.26.0 (actualizaciones de kernels CUDA, Vulkan, Metal, SYCL, OpenCL, WebGPU y CPU), añade un callback de aborto durante la detección de idioma, corrige un desbordamiento de enteros en los desplazamientos de chunks paralelos y hace que la CLI devuelva el código de error correcto cuando falla un archivo.
- whisper.cpp v1.9.4 (11 de septiembre de 2026): el servidor ahora devuelve el idioma detectado, el callback del encoder se ejecuta antes de la detección automática de idioma y se añadió Windows on ARM al job de publicación.
- whisper.cpp v1.9.3 (20 de agosto de 2026): sincronización de ggml con v0.20.2, mejoras de rendimiento en todos los backends, cuantización Metal TQ2_0, kernels CUDA/SYCL fusionados y correcciones ARM/WASI.
- whisper.cpp v1.9.0-v1.9.2 (junio-agosto de 2026): versiones intermedias de la misma línea de sincronización de ggml antes de la v1.9.3.
- whisper.cpp v1.8.6 (2 de junio de 2026): reimplementación de
ffmpeg-transcodepara una decodificación opcional con FFmpeg más clara de audio comprimido (MP3, M4A), además de una corrección de la ruta de ejemplos en CI. - whisper.cpp v1.8.5 (mayo de 2026): mejoras en el VAD por streaming (detección de actividad de voz), correcciones de fugas de parámetros del servidor y de marcas de tiempo de tokens, y correcciones de fugas de memoria en los bindings de Ruby y VAD.
- whisper.cpp v1.8.4 (19 de marzo de 2026): última sincronización de
ggmlcon amplias mejoras de rendimiento, un nuevo flag-g/--gpu-device(y selección de dispositivoGGML_CUDA) para elegir una GPU, y correcciones del ajuste de segmentos UTF-8. - El VAD nativo ya está integrado en whisper.cpp. Las versiones recientes añadieron una ruta nativa de detección de actividad de voz, reduciendo una ventaja de larga data de faster-whisper — aunque la integración de Silero VAD de faster-whisper sigue siendo más lista para usar.
- faster-whisper v1.2.1 (31 de octubre de 2025): última versión etiquetada;
pip install faster-whisperla instala. No hay versión etiquetada en 2026, pero la rama principal está activa: los commits del 16 de octubre de 2026 añaden validaciones de entrada, como un error para idiomas que un modelo no admite. La v1.2.0 (agosto de 2025) añadió compatibilidad con distil-large-v3.5. - CTranslate2 v4.8.3 (13 de octubre de 2026): el motor de inferencia bajo faster-whisper sigue publicándose. La serie v4.8 añadió correcciones de ROCm en Windows, endurecimiento de la carga de modelos y una corrección de una división por cero en Whisper
align()cuando una ventana no tiene fotogramas. - Ningún modelo Whisper nuevo de clase superior en 2026. Los pesos multilingües más recientes de OpenAI siguen siendo large-v3-turbo (octubre de 2024; 809M de parámetros, decoder reducido de 32 a 4 capas, licencia MIT), que cambia una pequeña pérdida de calidad por mucha más velocidad y funciona en ambas herramientas. distil-large-v3 sigue siendo la opción rápida solo para inglés. Las actualizaciones de ambos runtimes son cambios de runtime y herramientas, no de precisión.
faster-whisper — el port CTranslate2
faster-whisper (de SYSTRAN) es una librería Python que reimplementa la inferencia de Whisper usando CTranslate2 — un motor de inferencia C++ altamente optimizado con soporte de cuantización int8, reduciendo el uso de VRAM y aumentando el rendimiento. En GPUs NVIDIA, faster-whisper es la implementación local de Whisper más rápida disponible.
- Soporte de plataformas: CPU (cuantización int8) y GPU NVIDIA CUDA. Sin soporte para Apple Metal — funciona solo en CPU en Mac.
- Ventaja de int8: la cuantización int8 de CTranslate2 reduce el VRAM en ~40% y aumenta la velocidad de inferencia ~2× respecto a float16, con impacto WER negligible (< 0,1% absoluto).
- Instalación:
pip install faster-whisper— sin compilación necesaria (Python 3.9+). El uso de GPU requiere NVIDIA cuBLAS para CUDA 12 y cuDNN 9; las configuraciones antiguas con CUDA 11 / cuDNN 8 deben fijar unctranslate2anterior (3.24.0). - VAD integrado: faster-whisper incluye integración con Silero VAD, que omite automáticamente segmentos de audio silencioso — crítico para pipelines de transcripción en tiempo real.
- Python nativo: la API Python directa facilita la integración con LLMs, librerías de procesamiento de audio y frameworks web.
- Velocidad: large-v3 int8 en RTX 4070 funciona a ~12× tiempo real usando ~2,5 GB de VRAM. CPU int8 alcanza ~20× tiempo real para el modelo tiny.
- Procesamiento por lotes: faster-whisper admite inferencia en lotes para procesar grandes archivos de audio de forma eficiente.
- Limitación: sin soporte Metal en Mac — funciona solo en CPU en Apple Silicon, logrando ~3× tiempo real con large-v3 vs. ~10× de whisper.cpp con Metal.
from faster_whisper import WhisperModel

# Load model (downloads automatically on first run)
model = WhisperModel("large-v3", device="cuda", compute_type="int8")

# Transcribe
segments, info = model.transcribe("audio.wav", beam_size=5)

print(f"Detected language: {info.language} (probability: {info.language_probability:.2f})")
for segment in segments:
    print(f"[{segment.start:.2f}s → {segment.end:.2f}s] {segment.text}")
Obtén ggml-base.bin con pip (configuración Python)
Para usar ggml-base.bin desde Python con pip, instala el binding pywhispercpp — pip install pywhispercpp — y luego carga Model("base"), que descarga ggml-base.bin automáticamente en la primera ejecución. No existe pip install whisper.cpp; pywhispercpp es el envoltorio pip del motor C/C++ de whisper.cpp y conserva la aceleración Metal y CUDA. El archivo del modelo GGML (ggml-base.bin, ~142 MB) se descarga por separado desde Hugging Face y se cachea localmente — el paquete pip incluye el motor de inferencia, no los pesos.
📍 En una frase
Ejecuta pip install pywhispercpp, y luego Model("base") en Python obtiene y cachea ggml-base.bin automáticamente en el primer uso.
💬 En términos simples
pip instala el programa (pywhispercpp); el archivo del modelo ggml-base.bin es una descarga aparte de ~142 MB que ocurre la primera vez que cargas el modelo «base» — o que obtienes a mano con el script download-ggml-model.sh.
- Instala el binding:
pip install pywhispercpp. Para aceleración NVIDIA CUDA, compila conGGML_CUDA=1 pip install git+https://github.com/absadiki/pywhispercpp. - Descarga automática de ggml-base.bin:
from pywhispercpp.model import Modely luegomodel = Model("base")descargaggml-base.bindesde Hugging Face (ggerganov/whisper.cpp) en la primera ejecución y lo cachea. Usa"base.en"para la variante solo en inglés. - Descarga manual (vía CLI, sin pip): desde un repo whisper.cpp clonado,
bash ./models/download-ggml-model.sh baseguarda el archivo enmodels/ggml-base.bin— el mismo archivo que obtiene pywhispercpp. - Descarga directa:
curl -L -o ggml-base.bin https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.binobtiene el modelo sin script. Cambiabaseportiny,small,mediumolarge-v3. - No confundas los paquetes:
pip install openai-whisperinstala el Whisper PyTorch original de OpenAI (usa checkpoints.pt, noggml-base.bin).pip install faster-whisperusa el formato CTranslate2. Solopywhispercppconsume archivos GGMLggml-*.bin. - Dónde queda el archivo: pywhispercpp almacena los modelos GGML descargados en su caché de módulo (o en una ruta que pases con
Model("base", models_dir="...")), de modo que el mismoggml-base.binse reutiliza entre ejecuciones — sin volver a descargar.
# 1. Install the pip binding for whisper.cpp
pip install pywhispercpp

# 2. ggml-base.bin downloads automatically on first use
#    from pywhispercpp.model import Model
#    model = Model("base")          # fetches & caches ggml-base.bin (~142 MB)
#    for seg in model.transcribe("audio.wav"):
#        print(seg.text)

# --- Or get ggml-base.bin manually (no pip) ---
# From a cloned whisper.cpp checkout:
bash ./models/download-ggml-model.sh base       # -> models/ggml-base.bin

# Or download the file directly from Hugging Face:
curl -L -o ggml-base.bin \
  https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.bin
Comparativa directa: tabla de benchmarks
Todos los benchmarks usan el modelo large-v3 salvo que se indique lo contrario. La velocidad se mide en múltiplos del tiempo real (p. ej., 10× significa 60 minutos de audio transcritos en 6 minutos). Cifras de VRAM para ejecuciones en GPU; cifras de RAM para ejecuciones en CPU.
📍 En una frase
En Apple Silicon, whisper.cpp con Metal ejecuta large-v3 a ~10× tiempo real; en GPUs NVIDIA, faster-whisper con int8 alcanza ~12× tiempo real — cada herramienta gana de forma decisiva en su plataforma objetivo.
💬 En términos simples
En Mac elige whisper.cpp (usa el Apple Neural Engine), y en Windows/Linux con GPU NVIDIA elige faster-whisper (procesa audio 12× más rápido que en tiempo real usando un 40% menos de memoria GPU).
Métrica | whisper.cpp (large-v3) | faster-whisper (large-v3) |
|---|---|---|
| Plataforma / lenguaje | C/C++ (multiplataforma) | Python (CTranslate2) |
| Soporte GPU | CUDA, Metal, Vulkan | Solo CUDA |
| Optimización CPU | AVX2, ARM NEON | Cuantización int8 |
| Velocidad — RTX 4070, large-v3 | ~8× tiempo real | ~12× tiempo real ✓ |
| Velocidad — M5 Pro, large-v3 | ~10× tiempo real (Metal) ✓ | ~3× tiempo real (solo CPU) |
| Velocidad — solo CPU (x86), base | ~15× tiempo real | ~20× tiempo real ✓ |
| VRAM — large-v3, GPU | ~3 GB | ~2,5 GB (int8) ✓ |
| Integración Python | Requiere wrapper (pywhispercpp) | Nativo ✓ |
| VAD (detección de silencio) | Manual (ajuste de --step) | Integrado (Silero VAD) ✓ |
| Streaming en tiempo real | Sí (flag --stream) ✓ | Sí (pipeline VAD) |
| Precisión WER (large-v3) | 2,5% (idéntico) | 2,5% (idéntico) |
| Dependencia Python | Ninguna ✓ | Python 3.9+ |
| Raspberry Pi / embebido | Sí — binario C ✓ | Limitado — overhead de Python |
| Formatos de salida | SRT, VTT, JSON, CSV, txt | Objetos Python (start, end, text) |
whisper.cpp escribe la salida directamente en formatos estándar de subtítulos y transcripción (SRT, VTT, JSON, CSV, txt) — ideal para flujos de trabajo de subtitulado donde necesitas un archivo en disco sin código adicional. faster-whisper devuelve un generador Python de objetos de segmento con atributos start, end y text — ideal para encadenamiento de pipelines LLM, donde pasas el texto del segmento directamente a un modelo posterior sin escribir archivos intermedios. Para generación de subtítulos, whisper.cpp es más sencillo. Para pipelines que procesan segmentos programáticamente, faster-whisper es más sencillo.
Benchmark de referencia: tiempos de GPU vs CPU de faster-whisper
El proyecto faster-whisper publica sus propios tiempos sobre un archivo de audio de 13 minutos: muestran que whisper.cpp con Flash Attention iguala a faster-whisper fp16 en GPU, mientras que el batching y el int8 son donde faster-whisper se adelanta. Las cifras de abajo proceden del README de faster-whisper (large-v2 en una RTX 3070 Ti de 8 GB con CUDA 12.4 para las filas de GPU; el modelo small en un Intel Core i7-12700K con 8 hilos para las filas de CPU; beam size 5). No son mediciones propias y usan hardware y modelos distintos de las cifras de large-v3 de arriba.
📍 En una frase
En el benchmark del README de faster-whisper, whisper.cpp con Flash Attention (1m05s) y faster-whisper fp16 (1m03s) quedan casi empatados en GPU; faster-whisper int8 con batching termina el mismo archivo de 13 minutos en 16 segundos.
Configuración | Precisión | Tiempo | VRAM / RAM |
|---|---|---|---|
| GPU · whisper.cpp (Flash Attn) | fp16 | 1m05s | 4127 MB |
| GPU · faster-whisper | fp16 | 1m03s | 4525 MB |
| GPU · faster-whisper | int8 | 59s | 2926 MB |
| GPU · faster-whisper, batch 8 | int8 | 16s | 4500 MB |
| CPU · whisper.cpp | fp32 | 2m05s | 1049 MB |
| CPU · faster-whisper | int8 | 1m42s | 1477 MB |
| CPU · faster-whisper, batch 8 | int8 | 51s | 3608 MB |
Léelo junto a la tabla comparativa: con un solo flujo fp16, la velocidad en GPU de ambas herramientas es parecida en esta configuración. Las ventajas duraderas de faster-whisper son el ahorro de memoria de int8 (2,9 GB frente a 4,1–4,5 GB en fp16) y la inferencia por lotes (16 s frente a 59 s). En CPU, whisper.cpp fp32 y faster-whisper int8 están a un 25 % aproximadamente uno del otro sin batching.
Configuración de transcripción en tiempo real
La transcripción en tiempo real procesa el audio en chunks a medida que llega desde el micrófono, produciendo texto con un breve retraso respecto al habla. Ambas herramientas lo admiten, pero con diferentes compromisos.
- Modo stream de whisper.cpp: ejecuta
./stream -m models/ggml-small.bin --step 3000 --length 10000 -t 4. Procesa chunks de 3 segundos; latencia ~0,5–1,5 segundos con el modelo small. Sin Python necesario. - Pipeline VAD de faster-whisper: usa
vad_filter=Trueenmodel.transcribe(). Silero VAD segmenta el audio automáticamente en los límites de silencio — chunks más naturales que ventanas de longitud fija. - Latencia práctica: 0,5–2 segundos detrás del habla en vivo con modelos small o medium. Usa tiny para la menor latencia (< 0,5 segundos, pero mayor WER).
- Selección de modelo para tiempo real: small o base es el punto óptimo práctico — suficientemente rápido para seguir el habla, suficientemente preciso para audio limpio. Evita large-v3 en tiempo real salvo que tengas una GPU dedicada.
- Entrada de micrófono: whisper.cpp lee audio raw mediante SDL2 o portaudio. faster-whisper lee arrays de audio desde cualquier librería Python de audio (sounddevice, pyaudio, soundfile).
- Estabilidad: el modo stream de whisper.cpp puede producir tokens repetidos ("alucinaciones" de rellenos cortos) en silencio. Suprime con
--suppress-blanky--no-speech-threshold.
Apple Silicon: gana whisper.cpp
En Macs con M1, M2, M3, M4 y M5, whisper.cpp con aceleración Core ML / Metal es la herramienta correcta — sin duda. faster-whisper no tiene soporte Metal y solo funciona en CPU en Mac, alcanzando ~3× tiempo real con large-v3. whisper.cpp con Metal logra ~10× tiempo real en M5 Pro — una ventaja de velocidad de 3×.
- Exportación a Core ML: ejecuta
./models/generate-coreml-model.sh large-v3para exportar el encoder al formato Core ML. Esto descarga la inferencia del encoder al Apple Neural Engine. - Benchmark M5 Pro (large-v3, Metal): ~10× tiempo real. 60 minutos de audio transcritos en ~6 minutos. Nota: el M5 Pro salió en marzo de 2026 — estos son benchmarks tempranos de la comunidad. El rendimiento puede mejorar con actualizaciones de whisper.cpp optimizando el M5 Neural Engine.
- Benchmark M3 MacBook Air (large-v3, Metal): ~7× tiempo real. 60 minutos en ~8,5 minutos.
- Memoria: la memoria unificada significa que no hay VRAM separada — un M5 Pro de 16 GB puede ejecutar large-v3 (~3 GB) cómodamente junto a otros procesos.
- faster-whisper en Mac: solo CPU, int8. Large-v3 a ~3× tiempo real. Usable para transcripción por lotes nocturna, pero no para tiempo real o flujos de trabajo sensibles al tiempo.
- Recomendación: usa whisper.cpp para todo el trabajo STT en Mac. Añade pywhispercpp si necesitas integración Python manteniendo la aceleración Metal.
GPU NVIDIA: gana faster-whisper
En Windows y Linux con GPUs NVIDIA, faster-whisper es la opción superior. Su backend CUDA de CTranslate2 está más optimizado que el camino CUDA de whisper.cpp — ~12× vs. ~8× tiempo real con large-v3 en RTX 4070, con menor uso de VRAM.
- Benchmark RTX 4070 (12 GB) (large-v3 int8): ~12× tiempo real, ~2,5 GB VRAM.
- Benchmark RTX 3060 (12 GB) (large-v3 int8): ~8× tiempo real, ~2,5 GB VRAM.
- Benchmark RTX 4060 (8 GB) (large-v3 int8): ~7× tiempo real, ~2,5 GB VRAM — cabe con margen.
- int8 vs float16: int8 es ~2× más rápido y usa ~40% menos VRAM con pérdida de precisión negligible. Usa siempre
compute_type="int8"en NVIDIA. - Procesamiento por lotes: el parámetro
batched=Truede faster-whisper permite el procesamiento paralelo de múltiples archivos de audio, maximizando la utilización GPU en trabajos grandes de transcripción. - Integración en pipeline Python: faster-whisper se integra directamente en LangChain, Haystack y pipelines Python personalizados. Sin overhead de subproceso comparado con envolver whisper.cpp.
GPU NVIDIA antiguas (GTX 970): int8 retrocede a float32
En una GTX 970 (Maxwell, compute capability 5.2), faster-whisper sigue funcionando en CUDA, pero compute_type="int8" no da int8 real: CTranslate2 convierte los pesos a float32. Su tabla de cuantización asigna float32 a toda GPU con compute capability 6.0 o inferior para cualquier tipo solicitado, así que el ahorro de ~40 % de VRAM y la aceleración int8 citados para las tarjetas RTX no se aplican.
📍 En una frase
En una GTX 970 (compute capability 5.2), faster-whisper funciona en CUDA solo en float32: un tipo de cómputo int8 solicitado se convierte automáticamente.
💬 En términos simples
La GTX 970 es demasiado antigua para int8 en GPU. Funciona, pero sin ahorro de memoria, así que quédate con los modelos tiny, base o small en sus 4 GB.
- Lo que sigue funcionando: los binarios precompilados de CTranslate2 admiten GPU NVIDIA con compute capability 3.5 o superior, por lo que una GTX 970 (5.2) puede ejecutar faster-whisper en CUDA, siempre que tus bibliotecas CUDA y cuDNN instaladas coincidan con la versión (ver Problemas comunes).
- Dónde funciona int8 en GPU: int8 necesita compute capability 7.0 o superior (Volta y serie RTX 20 en adelante) o exactamente 6.1 (GTX 1050 a 1080 Ti, int8_float32). Las compute capability 6.0, 6.2 e inferiores retroceden a float32; float16 necesita 7.0 o superior.
- Consecuencia en memoria: float32 usa 4 bytes por parámetro frente a 1 byte de int8; por número de parámetros, large-v3 (1,55B) necesita unos 6 GB solo para los pesos, más que los 4 GB de la GTX 970. Small (244M, ~1 GB en float32) cabe sin problemas; medium (769M, ~3 GB) está al límite.
- Velocidad: no hemos medido una GTX 970, así que aquí no hay cifra medida. Espera un rendimiento float32 muy inferior a las cifras RTX 4070 int8 de esta guía y prueba tiny, base y small con tu propio audio.
- Comprueba qué admite tu GPU:
ctranslate2.get_supported_compute_types("cuda")lista los tipos de cómputo que CTranslate2 acepta en tu tarjeta. - Alternativas: int8 en CPU (
device="cpu", compute_type="int8") funciona en cualquier CPU x86 moderna, y los modelos GGML cuantizados de whisper.cpp (por ejemploggml-large-v3-q5_0.bin, unos 3–4 GB) son la forma habitual de encajar modelos mayores en 4 GB; verifica la compilación CUDA o Vulkan en tu tarjeta.
import ctranslate2
from faster_whisper import WhisperModel

# Which compute types does this GPU accept?
print(ctranslate2.get_supported_compute_types("cuda"))

# On compute capability < 6.1 (e.g. GTX 970), request float32 explicitly so nothing is converted silently
model = WhisperModel("small", device="cuda", compute_type="float32")
Whisper en Raspberry Pi 5: tiny, base y small
En una Raspberry Pi 5, whisper.cpp ejecuta los modelos tiny y base en tiempo real para transcripción en vivo, mientras que el modelo small funciona por debajo del tiempo real y conviene reservarlo para trabajos por lotes. El Cortex-A76 de cuatro núcleos del Pi 5 no tiene una ruta GPU utilizable para Whisper, así que toda la inferencia es en CPU (ARM NEON). Usa los modelos GGML cuantizados (ggml-*-q5_0.bin) para reducir el uso de memoria y acelerar la inferencia.
📍 En una frase
En una Raspberry Pi 5, el modelo small de whisper.cpp funciona más lento que el tiempo real (~0,5×, solo por lotes); tiny y base son los modelos que siguen el ritmo del habla en vivo.
💬 En términos simples
Una Pi 5 puede transcribir audio en vivo con los modelos Whisper tiny y base, pero el modelo small es demasiado pesado para seguir el ritmo en tiempo real — usa small para archivos grabados que proceses en segundo plano, no para un micrófono en vivo.
- Whisper small en Pi 5: aproximadamente 0,4–0,6× tiempo real en CPU (un clip de 10 minutos tarda ~17–25 minutos). Preciso con 3,4% WER pero demasiado lento para subtitulado en vivo — úsalo para transcripción nocturna/por lotes.
- Whisper base en Pi 5: en torno al tiempo real hasta ~2× con multihilo (
-t 4). El punto óptimo práctico para transcripción en vivo en el Pi, con un WER aceptable de 5,0%. - Whisper tiny en Pi 5: la opción más rápida, cómodamente más rápida que el tiempo real para uso en vivo, a costa de un WER más alto de 7,6%. Ideal para reconocimiento de palabra de activación y comandos cortos.
- Usa modelos cuantizados:
bash ./models/download-ggml-model.sh small-q5_0recorta la RAM y acelera la inferencia con una pérdida de precisión mínima — importante en la memoria compartida del Pi 5. - faster-whisper en Pi 5: instalable (
pip install faster-whisper, CPU int8) y competitivo para trabajos por lotes, pero el binario C más ligero de whisper.cpp es la opción embebida más común. - Térmica: la transcripción sostenida exige mucho a la CPU del Pi 5 — usa refrigeración activa para evitar el throttling térmico que degrada estas cifras.
Cuándo usar cuál
Mapeo directo de tu escenario a la herramienta adecuada:
📍 En una frase
Usa whisper.cpp en Apple Silicon y objetivos embebidos/multiplataforma; usa faster-whisper en GPUs NVIDIA y pipelines Python.
💬 En términos simples
Si tienes Mac, elige whisper.cpp — es 3× más rápido que faster-whisper en hardware Apple. Si tienes GPU NVIDIA y escribes Python, elige faster-whisper — es más rápido y necesita un 40% menos de memoria GPU.
Escenario | Mejor opción | Por qué |
|---|---|---|
| Mac con Apple Silicon (cualquier modelo) | whisper.cpp | Aceleración Metal / Core ML — 3× más rápido que faster-whisper (solo CPU en Mac) |
| Servidor GPU NVIDIA (Linux/Windows) | faster-whisper | CTranslate2 int8 — más rápido y menor VRAM que el camino CUDA de whisper.cpp |
| Pipeline de datos Python | faster-whisper | API Python nativa; sin wrapper de subproceso; VAD integrado |
| Raspberry Pi / Linux embebido | whisper.cpp | Binario C puro; sin overhead del runtime Python; optimizado con ARM NEON |
| Asistente de voz en tiempo real | whisper.cpp | Modo stream con bajo overhead; funciona sin Python en Pi / embebido |
| Transcripción por lotes (gran archivo de audio) | faster-whisper | Inferencia por lotes, utilización GPU, integración Python asíncrona |
| GPU AMD (Vulkan) | whisper.cpp | Soporte de backend Vulkan; faster-whisper es solo CUDA |
| Servidor Linux solo-CPU | faster-whisper | La cuantización int8 da ~30% de ventaja de velocidad en CPU x86 |
Más allá de whisper.cpp y faster-whisper
Dos herramientas adicionales extienden Whisper con capacidades que ninguna de las dos proporciona de serie: diarización de hablantes e inferencia GPU ultra-rápida en lotes.
- WhisperX: construido sobre faster-whisper, WhisperX añade marcas de tiempo a nivel de palabra y diarización de hablantes — identificando qué hablante dijo qué palabras. Mejor para: transcripción de reuniones con etiquetas de hablante, edición de podcasts y transcripción de entrevistas. Instala con
pip install whisperxy proporciona un token de Hugging Face para el modelo de diarización. - insanely-fast-whisper: un wrapper de pipeline Hugging Face Transformers que añade soporte de Flash Attention 2 para inferencia GPU significativamente más rápida que faster-whisper estándar en hardware NVIDIA. Mejor para: procesamiento por lotes de grandes archivos de audio en GPUs NVIDIA. Requiere una GPU compatible con Flash Attention 2 (Ampere o más reciente: RTX 3000+, A100, H100).
Problemas comunes y soluciones
Los problemas de configuración y runtime más frecuentes, con soluciones directas:
- Incompatibilidad de versión CUDA: las versiones actuales de faster-whisper requieren cuBLAS para CUDA 12 y cuDNN 9. Si estás atascado con bibliotecas antiguas, fija ctranslate2:
pip install --force-reinstall ctranslate2==4.4.0(CUDA 12 con cuDNN 8) o3.24.0(CUDA 11 con cuDNN 8). Verifica la versión de CUDA connvcc --version. - Falla la exportación del modelo Metal: asegúrate de tener instaladas las Xcode Command Line Tools — ejecuta
xcode-select --install. El script de exportación Core ML requiere el paquete Pythoncoremltools:pip install coremltools. - Alucinaciones en el silencio: ambas herramientas pueden producir tokens de relleno repetidos en segmentos de audio silencioso. Usa
--no-speech-threshold 0.6en el modo stream de whisper.cpp, ovad_filter=Trueenmodel.transcribe()de faster-whisper para omitir automáticamente los segmentos silenciosos. - Sin memoria con large-v3: cambia a cuantización int8 en faster-whisper (
compute_type="int8") — reduce el VRAM de ~5 GB (float16) a ~2,5 GB. En whisper.cpp, usa la variante GGML cuantizada (p. ej.,ggml-large-v3-q5_0.bin) que reduce la memoria a ~3–4 GB. - Salida ilegible en audio no inglés: no uses variantes
.endel modelo (tiny.en, base.en) para habla no inglesa — son solo inglés. Usa los modelos multilingüe (base, small, medium, large-v3) y especifica el idioma explícitamente:-l esen whisper.cpp olanguage="es"en faster-whisper. - Inferencia CPU lenta: verifica que tu CPU admita instrucciones AVX2 (necesarias para inferencia CPU optimizada). Comprueba con
grep avx2 /proc/cpuinfoen Linux osysctl machdep.cpu.featuresen Mac. Las CPUs sin AVX2 recurren a SIMD genérico y serán 2–3× más lentas.
Preguntas frecuentes
¿Existe un paquete Debian o apt para whisper.cpp?
Sí — whisper.cpp ahora tiene un paquete oficial de Debian (actualmente en sid), que proporciona el binario whisper.cpp además de libwhisper-dev y libwhisper1 para enlazarlo como biblioteca compartida. Todavía no ha llegado a las versiones estables de Debian ni a los repositorios predeterminados de Ubuntu, así que en la mayoría de sistemas hay que usar sid o compilar desde el código fuente. También existe un Snap no oficial (sudo snap install whisper-cpp) para Debian 9+ y Ubuntu.
¿Cómo compruebo qué versión de whisper.cpp tengo instalada?
Ejecuta el binario compilado sin argumentos o con --help — la versión aparece en la línea de cabecera. También puedes comprobar el commit exacto con git describe --tags dentro del repositorio clonado, o comparar tu fecha de compilación con las notas de versión en github.com/ggml-org/whisper.cpp/releases para ver si estás por detrás de la v1.9.5 actual.
¿La precisión de transcripción es la misma entre whisper.cpp y faster-whisper?
Sí. Ambas herramientas usan los mismos pesos del modelo OpenAI Whisper — el modelo en sí es idéntico. La diferencia está únicamente en el runtime de inferencia (C/C++ vs CTranslate2 Python). El WER en el mismo archivo de audio estará dentro de un 0,1% absoluto el uno del otro, lo cual está dentro de la variación normal por la aleatoriedad de beam search.
¿Puedo usar faster-whisper en un Mac con Apple Silicon?
Sí, pero funciona solo en CPU — faster-whisper no tiene soporte Metal. En un M5 Pro, faster-whisper large-v3 funciona a ~3× tiempo real (CPU int8), comparado con ~10× de whisper.cpp con Metal. Para la mayoría de usuarios Mac, whisper.cpp es 3× más rápido con el mismo modelo. La única razón para usar faster-whisper en Mac es si tu pipeline Python ya depende de él y la velocidad no es crítica.
¿Qué tamaño de modelo Whisper debo usar para un asistente de voz?
Para interfaces de voz en tiempo real, Whisper small es la recomendación estándar — 3,4% WER en inglés limpio, ~200 ms de latencia STT en una CPU o GPU moderna, y cabe en 2 GB de RAM. Usa tiny si estás en hardware muy restringido (Raspberry Pi Zero 2W, teléfonos antiguos) y puedes tolerar ~7,6% WER. Usa medium o large-v3 solo para transcripción por lotes donde la latencia no es una restricción.
¿whisper.cpp admite idiomas distintos al inglés?
Sí. Todos los modelos multilingüe de Whisper (base, small, medium, large-v3) admiten 99 idiomas. Añade `-l [código de idioma] al CLI: -l es para español, -l de para alemán, -l ja` para japonés, etc. Los modelos tiny.en y base.en son solo inglés y ligeramente más precisos para inglés que sus equivalentes multilingüe.
¿Cómo instalo faster-whisper con soporte CUDA?
Instala con pip install faster-whisper. Las versiones actuales requieren NVIDIA cuBLAS para CUDA 12 y cuDNN 9 en tu sistema (en Linux, pip install nvidia-cublas-cu12 "nvidia-cudnn-cu12==9.*" los proporciona). En configuraciones antiguas con CUDA 11 / cuDNN 8, fija ctranslate2==3.24.0 (o 4.4.0 para CUDA 12 con cuDNN 8). Luego especifica device="cuda" al cargar el modelo: WhisperModel("large-v3", device="cuda", compute_type="int8"). Usa device="auto" si quieres que recurra a la CPU cuando CUDA no esté disponible.
¿Cuál es más preciso — whisper.cpp o faster-whisper?
Idéntico. Ambas herramientas usan los mismos pesos del modelo OpenAI Whisper y producen el mismo WER en cualquier archivo de audio dado. La diferencia entre whisper.cpp y faster-whisper es la velocidad y el soporte de plataforma, no la precisión de transcripción. Cualquier diferencia de WER que midas entre ejecuciones está dentro de la variación normal de beam search, no proviene del runtime en sí.
¿Puedo ejecutar Whisper large-v3 con 8 GB de RAM?
Sí en GPU — large-v3 int8 en faster-whisper usa ~2,5 GB de VRAM y funciona en cualquier GPU de 8 GB. En hardware solo-CPU, 8 GB de RAM es ajustado para large-v3 (float32 usa ~10 GB). Usa medium (5 GB RAM) o small (2 GB RAM) en sistemas solo-CPU. whisper.cpp es más eficiente en memoria en CPU que faster-whisper debido al menor overhead del runtime.
¿Cuánto cuesta Whisper local vs STT en la nube?
Costo continuo cero. Los servicios STT en la nube cobran $0,006–$0,024 por minuto de audio — para un desarrollador que transcribe 8 horas de reuniones por semana, eso son $120–480/mes. Whisper local funciona en hardware que ya posees, sin tarifas por minuto, sin gestión de API keys y sin que los datos de audio salgan de tu equipo.
¿Funciona faster-whisper int8 en una GTX 970?
No, no como int8 real. La GTX 970 tiene compute capability 5.2, y CTranslate2 solo ejecuta int8 en GPU con compute capability 7.0 o superior (o exactamente 6.1); en tarjetas más antiguas convierte los pesos a float32 automáticamente. faster-whisper sigue funcionando en la GPU en float32, así que usa tiny, base o small para quedarte dentro de 4 GB, o int8 en CPU, que funciona en cualquier CPU x86 moderna. No hemos medido una GTX 970, así que aquí no hay cifra de velocidad medida.
¿Cuánto pesan los archivos de modelo de Whisper para whisper.cpp y faster-whisper?
El README de whisper.cpp indica archivos de modelo GGML de unos 75 MiB (tiny), 142 MiB (base), 466 MiB (small), 1,5 GiB (medium) y 2,9 GiB (large) en disco, que necesitan unos 273 MB, 388 MB, 852 MB, 2,1 GB y 3,9 GB de memoria. faster-whisper descarga los modelos CTranslate2 de Hugging Face en el primer uso; large-v3 pesa ahí unos 3 GB (1,55B de parámetros a 2 bytes en float16). La tabla de tamaños de modelo de arriba indica los parámetros de cada tamaño.
¿Es Whisper large-v3-turbo mejor que large-v3 para transcripción local?
Es más rápido, no más preciso. large-v3-turbo tiene 809M de parámetros porque OpenAI redujo el decoder de 32 a 4 capas, y su ficha de modelo lo describe como mucho más rápido que large-v3 a costa de una ligera degradación de calidad, con licencia MIT. La ficha también advierte de que puede alucinar o repetir texto y de que la precisión varía según el idioma: conserva large-v3 para el audio más difícil y usa turbo (o distil-large-v3 para inglés) cuando importe la velocidad. whisper.cpp y faster-whisper pueden ejecutarlo.
¿Puede whisper.cpp usar una GPU AMD o Intel en lugar de CUDA?
Sí. El backend Vulkan de whisper.cpp (-DGGML_VULKAN=1) funciona entre fabricantes siempre que tu controlador admita la API Vulkan, ROCm/HIP (-DGGML_HIP=1) apunta a GPU AMD y OpenVINO acelera el encoder en CPU y GPU Intel. La documentación de faster-whisper solo cubre NVIDIA CUDA; las notas de versión de CTranslate2 mencionan wheels de ROCm, pero no hemos probado esa vía.
¿Es mlx-whisper más rápido que whisper.cpp en un Mac?
Una prueba independiente dice que sí para large-v3-turbo: la repetición de Bill Mill en enero de 2026 midió unos 13,1 segundos para mlx_whisper frente a 26,7 segundos para whisper.cpp en la misma grabación larga, aproximadamente 2× más rápido. Una prueba de velocidad de la comunidad con un clip corto dejó a ambos cerca, con whisper.cpp usando Core ML y cuantización q5_0. Las cifras del M5 Pro de esta guía no se compararon con MLX, así que prueba tu propio audio antes de elegir.
Fuentes
- whisper.cpp en GitHub — Código fuente, instrucciones de compilación, scripts de descarga de modelos y guía de configuración Metal/Core ML.
- faster-whisper en GitHub — Código fuente, documentación de la API Python y resultados de benchmarks.
- distil-whisper/distil-large-v3 en Hugging Face — Ficha del modelo, resultados de benchmarks e instrucciones de uso de la variante destilada de Whisper.
- WhisperX en GitHub — Marcas de tiempo a nivel de palabra y diarización de hablantes construidas sobre faster-whisper.
- insanely-fast-whisper en GitHub — Pipeline Whisper Flash Attention 2 para máximo rendimiento en GPU NVIDIA.
- OpenAI Whisper en GitHub — Modelo Whisper original, paper y fichas de modelo para todos los tamaños.
- Paper de OpenAI Whisper (Radford et al., 2022) — "Robust Speech Recognition via Large-Scale Weak Supervision". Fuente de los valores WER.
- Documentación de CTranslate2 — Detalles de cuantización, soporte de hardware y fundamentos de optimización int8.
- Documentación de cuantización de CTranslate2 — Tipos de cómputo que admite cada compute capability de GPU (base de la sección sobre la GTX 970).
- Benchmarks del README de faster-whisper — Tiempos de GPU y CPU sobre 13 minutos usados en el benchmark de referencia, y los requisitos actuales de CUDA 12 / cuDNN 9.
- openai/whisper-large-v3-turbo en Hugging Face — Ficha del modelo: 809M de parámetros, 4 capas de decoder, licencia MIT.
- Bill Mill: benchmark actualizado de mlx_whisper vs. whisper.cpp — Comparación independiente de tiempos de large-v3-turbo en Apple Silicon.
- Versiones de whisper.cpp — Notas de versión de v1.9.4 y v1.9.5.