Principais conclusões
- whisper.cpp é a melhor opção de STT local para Apple Silicon. O port C/C++ aproveita Core ML e Apple Metal para aceleração por hardware — large-v3 a ~10× tempo real em M5 Pro, sem dependência de Python.
- faster-whisper é a melhor opção de STT local para GPUs NVIDIA e pipelines Python. A quantização int8 do CTranslate2 reduz a VRAM em ~40% e aumenta o throughput em ~4× em relação à implementação original da OpenAI — large-v3 a ~12× tempo real em RTX 4070, usando apenas ~2,5 GB de VRAM.
- Ambas as ferramentas usam os mesmos pesos do modelo Whisper da OpenAI. O WER (taxa de erro de palavras) é idêntico — a diferença está unicamente no desempenho do runtime e no caminho de integração, não na precisão de transcrição.
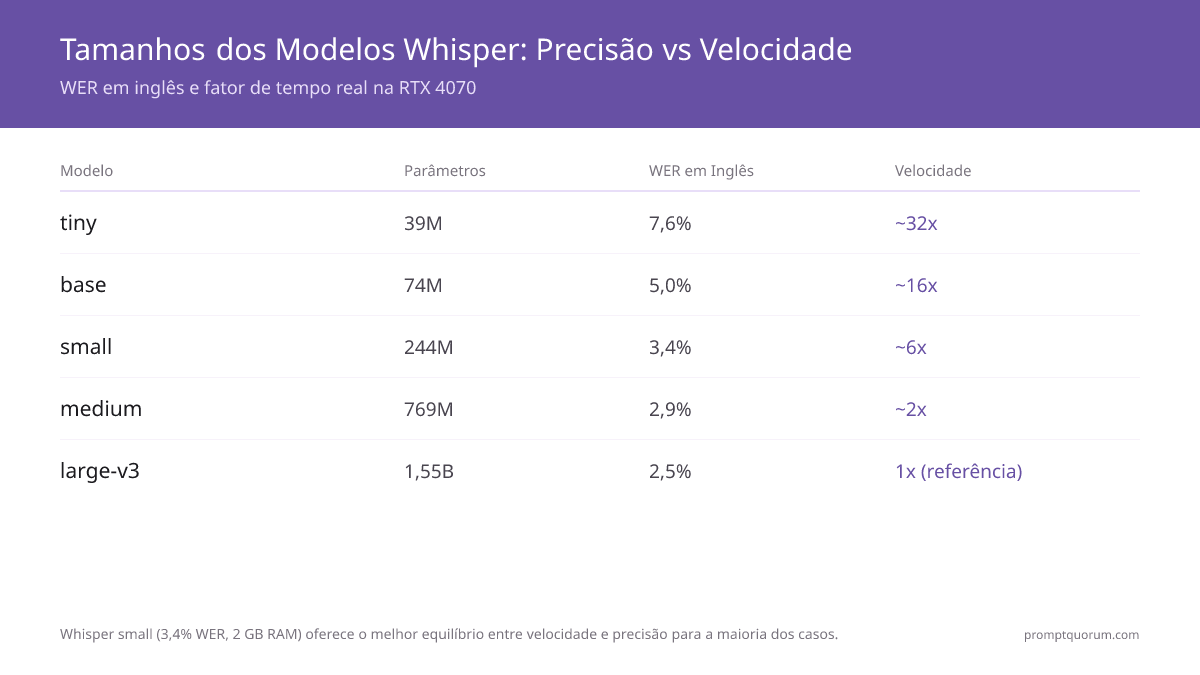
- Whisper large-v3 oferece a melhor precisão, com 2,5% de WER em inglês. Para a maioria dos casos de produção, Whisper small (3,4% WER, 2 GB RAM) ou medium (2,9% WER, 5 GB RAM) oferece um melhor equilíbrio entre velocidade e precisão.
- A transcrição em tempo real é alcançável com ambas as ferramentas — whisper.cpp por meio da flag
--stream, faster-whisper por meio de seu pipeline VAD (detecção de atividade de voz) integrado. A latência prática é de 0,5–2 segundos atrás da fala ao vivo, dependendo do tamanho do modelo. - whisper.cpp roda em CPU, Metal, CUDA e Vulkan — sendo a opção mais prática para uso embarcado multiplataforma (Raspberry Pi, configurações de GPU no Windows, servidores ARM). faster-whisper só suporta CPU e CUDA (sem Metal no Mac).
- Para Raspberry Pi 5 e Linux embarcado, whisper.cpp tiny e base em CPU são os modelos capazes de tempo real — tiny roda confortavelmente mais rápido que o tempo real, base em torno do tempo real com
-t 4. O modelo small (3,4% WER) roda abaixo do tempo real no Pi 5 e é melhor reservá-lo para trabalhos em lote. Toda a inferência é em CPU (ARM NEON) — o Pi não tem um caminho de GPU utilizável para o Whisper.
Fatos rápidos
- Ambas as ferramentas: baseadas no modelo Whisper de código aberto da OpenAI (licença MIT). Mesma precisão — runtimes diferentes.
- whisper.cpp: escrito em C/C++ por Georgi Gerganov. Suporta CPU (AVX2/NEON), CUDA, Metal (Apple), Vulkan. Não requer Python.
- faster-whisper: biblioteca Python usando CTranslate2. Suporta CPU (int8) e CUDA. Sem suporte a Apple Metal.
- Tamanhos do modelo Whisper: tiny (39M), base (74M), small (244M), medium (769M), large-v3 (1,55B). Todos no formato ggml / CTranslate2.
- Melhor modelo para a maioria dos casos: Whisper small — 3,4% WER, roda em 2 GB de RAM, 6× tempo real em CPU moderna.
- Benchmark RTX 4070 (large-v3): faster-whisper ~12× tempo real; whisper.cpp CUDA ~8× tempo real. faster-whisper vence em NVIDIA.
- Benchmark M5 Pro (large-v3): whisper.cpp Metal ~10× tempo real; faster-whisper somente CPU ~3× tempo real. whisper.cpp vence em Apple.
Por que reconhecimento de voz local?
Os serviços de STT na nuvem (Google Speech-to-Text, AWS Transcribe, Azure Speech) cobram por minuto de áudio — normalmente US$ 0,006–0,024/minuto — e enviam seu áudio para servidores remotos. Para aplicações sensíveis à privacidade (ditado médico, gravações jurídicas, entrevistas jornalísticas, reuniões corporativas), a transcrição local elimina completamente a exposição de dados.
- Privacidade: o áudio nunca sai da sua máquina, então nenhum provedor de nuvem participa da transcrição. As obrigações de proteção de dados, como base legal e armazenamento seguro, continuam sendo suas.
- Custo: sem tarifas por minuto. Um desenvolvedor que transcreve 8 horas de reuniões por semana economiza US$ 120–480/mês em relação aos preços de STT na nuvem.
- Offline: funciona em aviões, em instalações seguras e em áreas sem internet confiável. Sem gerenciamento de chaves de API.
- Latência: sem ida e volta de upload/download. Para interfaces de voz em tempo real, o processamento local reduz a latência de STT de 300–800 ms (nuvem) para 50–300 ms.
- Personalização: ajuste fino com vocabulário específico do domínio. Rode qualquer tamanho de modelo que caiba no seu hardware.
- Integração com Home Assistant: O Whisper rodando localmente significa que palavras de ativação e comandos de voz nunca saem da sua rede doméstica. Veja Whisper local no Home Assistant → para a configuração do complemento que substitui completamente o STT na nuvem.
Tamanhos do modelo Whisper — base de ambas as ferramentas
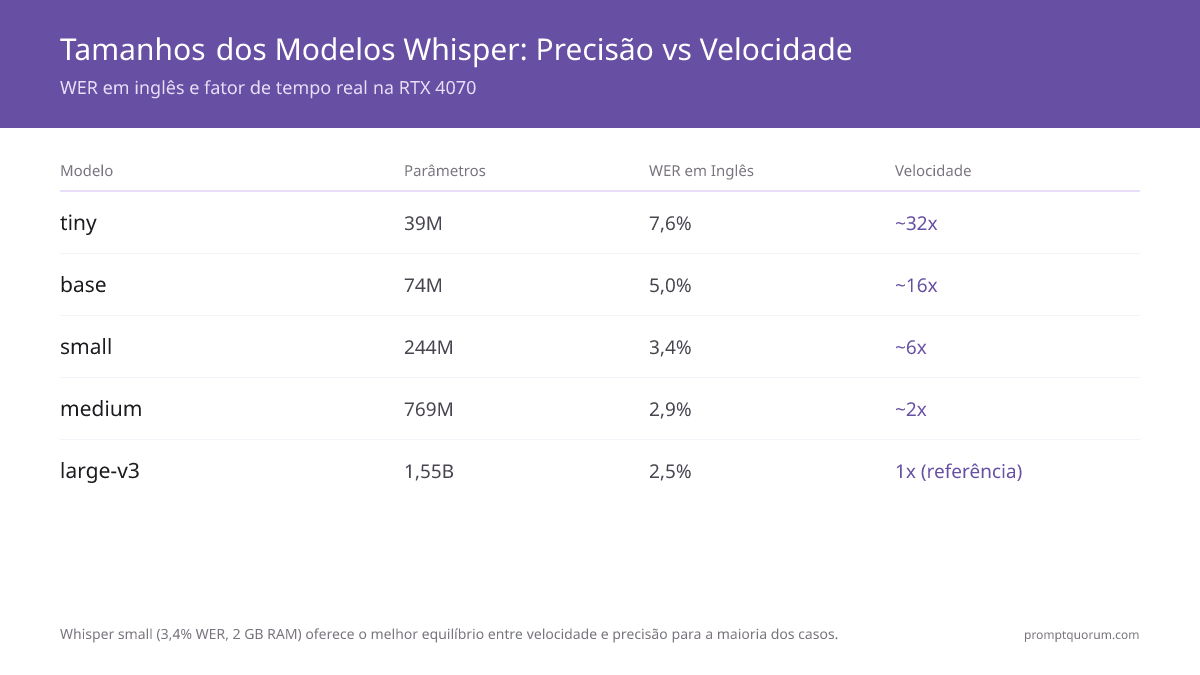
Tanto whisper.cpp quanto faster-whisper usam os mesmos pesos do modelo Whisper, convertidos para seus respectivos formatos (GGML para whisper.cpp, CTranslate2 para faster-whisper). Escolha o tamanho do modelo conforme seu orçamento de VRAM/RAM e seus requisitos de precisão.
Modelo | Parâmetros | VRAM / RAM | WER inglês | Fator vs tempo real (RTX 4070) |
|---|---|---|---|---|
| tiny | 39M | ~1 GB | 7,6% | ~32× |
| base | 74M | ~1 GB | 5,0% | ~16× |
| small | 244M | ~2 GB | 3,4% | ~6× |
| medium | 769M | ~5 GB | 2,9% | ~2× |
| large-v3 | 1,55B | ~10 GB | 2,5% | 1× (referência) |
| distil-large-v3 | ~756M | ~4 GB | ~2,6% | ~6× |
Valores de WER (taxa de erro de palavras) do paper do Whisper no conjunto de teste limpo do LibriSpeech. Menor é melhor. Fatores de velocidade para faster-whisper int8 em RTX 4070. Valores de distil-large-v3 do paper do Distil-Whisper.
Distil-Whisper: a alternativa mais rápida
distil-whisper/distil-large-v3 é uma variante destilada do large-v3 com ~50% menos parâmetros, que roda ~6× mais rápido mantendo o WER dentro de ~1% do original. É a escolha certa quando a velocidade de transcrição importa mais do que extrair a última fração de precisão. distil-large-v3 funciona com faster-whisper (suporte nativo a CTranslate2) e com whisper.cpp (por meio de conversão para o formato GGML), integrando-se ao runtime que você já usa.
- Parâmetros: ~756M — cerca de metade dos 1,55B do large-v3, cabendo em ~4 GB de VRAM em vez de ~10 GB.
- Velocidade: ~6× tempo real em RTX 4070 (vs. 1× de referência para large-v3) — comparável ao modelo medium em velocidade, com precisão próxima à do large-v3.
- WER: ~2,6% em inglês — apenas ~0,1% acima dos 2,5% do large-v3. Na prática, a diferença é imperceptível em fala típica.
- Compatibilidade: funciona com faster-whisper de forma nativa (
WhisperModel("distil-large-v3", device="cuda", compute_type="int8")). Para whisper.cpp, converta para o formato GGML usando o script de conversão GGML do distil-whisper. - Melhor para: trabalhos de transcrição em lote, implantações em servidor com VRAM limitada e qualquer caso de uso em que você queira qualidade de large-v3 na velocidade do modelo medium.
- Não recomendado para: transcrição multilíngue — distil-large-v3 é somente inglês. Para outros idiomas, use large-v3 ou medium.
whisper.cpp — o port C/C++
whisper.cpp (de Georgi Gerganov) é uma reimplementação pura em C/C++ do modelo Whisper da OpenAI, otimizada para inferência de baixo consumo de recursos e multiplataforma. Não requer Python, nem CUDA toolkit, e roda em praticamente qualquer hardware — do Raspberry Pi ao Apple M5 Pro ou configurações Windows CUDA.
- Suporte de plataformas: CPU (AVX2, AVX512, ARM NEON), Apple Metal (Core ML), CUDA (NVIDIA), Vulkan (GPU AMD/Intel), OpenCL.
- Vantagem em Apple Silicon: whisper.cpp exporta modelos para o formato Core ML, habilitando inferência no Apple Neural Engine. O large-v3 roda a ~10× tempo real em M5 Pro via Metal — mais rápido que qualquer ida e volta à nuvem.
- Instalação: clone o repositório, execute
make(oucmake). Binários pré-compilados disponíveis para plataformas comuns. Sem dependência de Python. - Download do modelo:
bash ./models/download-ggml-model.sh base.en— baixa o arquivo de modelo no formato GGML (~142 MB para base). - Exemplo de CLI:
./main -m models/ggml-base.bin -f audio.wav— transcreve um arquivo WAV para a saída padrão. Adicione-l ptpara português. - Modo stream em tempo real:
./stream -m models/ggml-base.bin --step 3000 --length 10000— transcreve do microfone em chunks de 3 segundos. - Wrapper Python: pywhispercpp fornece um binding Python para whisper.cpp, permitindo seu uso em pipelines Python sem sacrificar a aceleração Metal.
- Limitação: sem VAD (detecção de atividade de voz) nativo. O modo stream exige ajustar os parâmetros
--stepe--lengthconforme o caso de uso.
# Build from source (macOS / Linux)
git clone https://github.com/ggerganov/whisper.cpp
cd whisper.cpp
make -j4

# Download a model
bash ./models/download-ggml-model.sh large-v3

# Transcribe a file
./main -m models/ggml-large-v3.bin -f recording.wav

# Enable Metal on Apple Silicon (Core ML)
make -j4 WHISPER_COREML=1
./main -m models/ggml-large-v3-encoder.mlmodelc -f recording.wav
whisper.cpp: versão mais recente e novidades
A versão mais recente do whisper.cpp é a v1.9.5, publicada em 6 de outubro de 2026. Ela sincroniza a biblioteca ggml embutida com a v0.26.0 (trabalho nos backends CUDA, Vulkan, Metal, SYCL, OpenCL e nos kernels de CPU) e traz correções do Whisper, como um callback de aborto durante a detecção de idioma e uma correção de estouro de inteiros nos deslocamentos de chunks paralelos. O whisper.cpp também conta com pacote oficial para Debian (sid) (whisper.cpp, libwhisper-dev, libwhisper1), além do Snap não oficial. A versão marcada mais recente do faster-whisper continua sendo a v1.2.1 (31 de outubro de 2025), mas o repositório é mantido ativamente: houve commits tão recentes quanto 16 de outubro de 2026. Ambos os runtimes continuam carregando os mesmos pesos do OpenAI Whisper; nada mudou em 2026 quanto à precisão da transcrição.
- whisper.cpp v1.9.5 (6 de outubro de 2026): sincroniza o ggml com a v0.26.0 (atualizações dos kernels CUDA, Vulkan, Metal, SYCL, OpenCL, WebGPU e CPU), adiciona um callback de aborto durante a detecção de idioma, corrige um estouro de inteiros nos deslocamentos de chunks paralelos e faz a CLI retornar o código de erro correto quando um arquivo falha.
- whisper.cpp v1.9.4 (11 de setembro de 2026): o servidor agora retorna o idioma detectado, o callback do encoder roda antes da detecção automática de idioma e o Windows on ARM foi adicionado ao job de release.
- whisper.cpp v1.9.3 (20 de agosto de 2026): sincronização do ggml com a v0.20.2, melhorias de desempenho em todos os backends, quantização Metal TQ2_0, kernels CUDA/SYCL combinados e correções para ARM/WASI.
- whisper.cpp v1.9.0 a v1.9.2 (junho a agosto de 2026): versões intermediárias da mesma linha de sincronização do ggml antes da v1.9.3.
- whisper.cpp v1.8.6 (2 de junho de 2026): reimplementação do
ffmpeg-transcodepara uma decodificação opcional com FFmpeg mais clara de áudio comprimido (MP3, M4A), além de uma correção do caminho de exemplos no CI. - whisper.cpp v1.8.5 (maio de 2026): melhorias no VAD por streaming (detecção de atividade de voz), correções de vazamento de parâmetros do servidor e de carimbos de tempo de tokens, e correções de vazamentos de memória nos bindings de Ruby e VAD.
- whisper.cpp v1.8.4 (19 de março de 2026): sincronização mais recente do
ggmlcom amplos ganhos de desempenho, uma nova flag-g/--gpu-device(e seleção de dispositivoGGML_CUDA) para escolher uma GPU, e correções de quebra de segmentos UTF-8. - O VAD nativo agora vem integrado ao whisper.cpp. Versões recentes adicionaram um caminho nativo de detecção de atividade de voz, reduzindo uma vantagem de longa data do faster-whisper — embora a integração do Silero VAD do faster-whisper continue mais pronta para uso.
- faster-whisper v1.2.1 (31 de outubro de 2025): última versão marcada;
pip install faster-whispera instala. Não há versão marcada em 2026, mas a branch principal está ativa: commits de 16 de outubro de 2026 adicionam validações de entrada, como um erro para idiomas que um modelo não suporta. A v1.2.0 (agosto de 2025) adicionou suporte ao distil-large-v3.5. - CTranslate2 v4.8.3 (13 de outubro de 2026): o motor de inferência por baixo do faster-whisper continua sendo lançado. A série v4.8 trouxe correções de ROCm no Windows, reforço no carregamento de modelos e a correção de uma divisão por zero no Whisper
align()quando uma janela não tem quadros. - Nenhum modelo Whisper novo de classe superior em 2026. Os pesos multilíngues mais recentes da OpenAI continuam sendo o large-v3-turbo (outubro de 2024; 809M de parâmetros, decoder reduzido de 32 para 4 camadas, licença MIT), que troca uma pequena perda de qualidade por muito mais velocidade e roda nas duas ferramentas. O distil-large-v3 segue como a opção rápida só para inglês. As atualizações de ambos os runtimes são mudanças de runtime e de ferramentas, não de precisão.
faster-whisper — o port CTranslate2
faster-whisper (da SYSTRAN) é uma biblioteca Python que reimplementa a inferência do Whisper usando CTranslate2 — um motor de inferência C++ altamente otimizado com suporte a quantização int8, reduzindo o uso de VRAM e aumentando o throughput. Em GPUs NVIDIA, faster-whisper é a implementação local do Whisper mais rápida disponível.
- Suporte de plataformas: CPU (quantização int8) e GPU NVIDIA CUDA. Sem suporte a Apple Metal — roda somente em CPU no Mac.
- Vantagem do int8: a quantização int8 do CTranslate2 reduz a VRAM em ~40% e aumenta a velocidade de inferência em ~2× em relação ao float16, com impacto no WER negligível (< 0,1% absoluto).
- Instalação:
pip install faster-whisper— sem compilação necessária (Python 3.9+). O uso de GPU exige NVIDIA cuBLAS para CUDA 12 e cuDNN 9; configurações antigas com CUDA 11 / cuDNN 8 precisam fixar umctranslate2mais antigo (3.24.0). - VAD integrado: faster-whisper inclui integração com Silero VAD, que pula automaticamente segmentos de áudio silencioso — crítico para pipelines de transcrição em tempo real.
- Python nativo: a API Python direta facilita a integração com LLMs, bibliotecas de processamento de áudio e frameworks web.
- Velocidade: large-v3 int8 em RTX 4070 roda a ~12× tempo real usando ~2,5 GB de VRAM. CPU int8 atinge ~20× tempo real para o modelo tiny.
- Processamento em lote: faster-whisper suporta inferência em lote para processar grandes arquivos de áudio de forma eficiente.
- Limitação: sem suporte Metal no Mac — roda somente em CPU no Apple Silicon, atingindo ~3× tempo real com large-v3 vs. ~10× do whisper.cpp com Metal.
from faster_whisper import WhisperModel

# Load model (downloads automatically on first run)
model = WhisperModel("large-v3", device="cuda", compute_type="int8")

# Transcribe
segments, info = model.transcribe("audio.wav", beam_size=5)

print(f"Detected language: {info.language} (probability: {info.language_probability:.2f})")
for segment in segments:
    print(f"[{segment.start:.2f}s → {segment.end:.2f}s] {segment.text}")
Obtenha ggml-base.bin via pip (configuração Python)
Para usar ggml-base.bin a partir do Python via pip, instale o binding pywhispercpp — pip install pywhispercpp — e então carregue Model("base"), que baixa ggml-base.bin automaticamente na primeira execução. Não existe pip install whisper.cpp; pywhispercpp é o wrapper pip do motor C/C++ do whisper.cpp e mantém a aceleração Metal e CUDA. O arquivo do modelo GGML (ggml-base.bin, ~142 MB) é baixado separadamente do Hugging Face e armazenado em cache localmente — o pacote pip entrega o motor de inferência, não os pesos.
📍 Em uma frase
Execute pip install pywhispercpp, e então Model("base") no Python busca e armazena em cache o ggml-base.bin automaticamente no primeiro uso.
💬 Em termos simples
o pip instala o programa (pywhispercpp); o arquivo do modelo ggml-base.bin é um download separado de ~142 MB que ocorre na primeira vez que você carrega o modelo «base» — ou que você obtém manualmente com o script download-ggml-model.sh.
- Instale o binding:
pip install pywhispercpp. Para aceleração NVIDIA CUDA, compile comGGML_CUDA=1 pip install git+https://github.com/absadiki/pywhispercpp. - Download automático do ggml-base.bin:
from pywhispercpp.model import Modele entãomodel = Model("base")baixaggml-base.bindo Hugging Face (ggerganov/whisper.cpp) na primeira execução e o armazena em cache. Use"base.en"para a variante somente em inglês. - Download manual (via CLI, sem pip): a partir de um repositório whisper.cpp clonado,
bash ./models/download-ggml-model.sh basesalva o arquivo emmodels/ggml-base.bin— o mesmo arquivo que o pywhispercpp busca. - Download direto:
curl -L -o ggml-base.bin https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.binobtém o modelo sem script. Troquebaseportiny,small,mediumoularge-v3. - Não confunda os pacotes:
pip install openai-whisperinstala o Whisper PyTorch original da OpenAI (ele usa checkpoints.pt, nãoggml-base.bin).pip install faster-whisperusa o formato CTranslate2. Apenas opywhispercppconsome arquivos GGMLggml-*.bin. - Onde o arquivo fica: o pywhispercpp armazena os modelos GGML baixados no cache do seu módulo (ou em um caminho que você passe via
Model("base", models_dir="...")), de modo que o mesmoggml-base.biné reutilizado entre execuções — sem novo download.
# 1. Install the pip binding for whisper.cpp
pip install pywhispercpp

# 2. ggml-base.bin downloads automatically on first use
#    from pywhispercpp.model import Model
#    model = Model("base")          # fetches & caches ggml-base.bin (~142 MB)
#    for seg in model.transcribe("audio.wav"):
#        print(seg.text)

# --- Or get ggml-base.bin manually (no pip) ---
# From a cloned whisper.cpp checkout:
bash ./models/download-ggml-model.sh base       # -> models/ggml-base.bin

# Or download the file directly from Hugging Face:
curl -L -o ggml-base.bin \
  https://huggingface.co/ggerganov/whisper.cpp/resolve/main/ggml-base.bin
Comparação direta: tabela de benchmarks
Todos os benchmarks usam o modelo large-v3 salvo indicação em contrário. A velocidade é medida em múltiplos do tempo real (p. ex., 10× significa 60 minutos de áudio transcritos em 6 minutos). Valores de VRAM para execuções em GPU; valores de RAM para execuções em CPU.
📍 Em uma frase
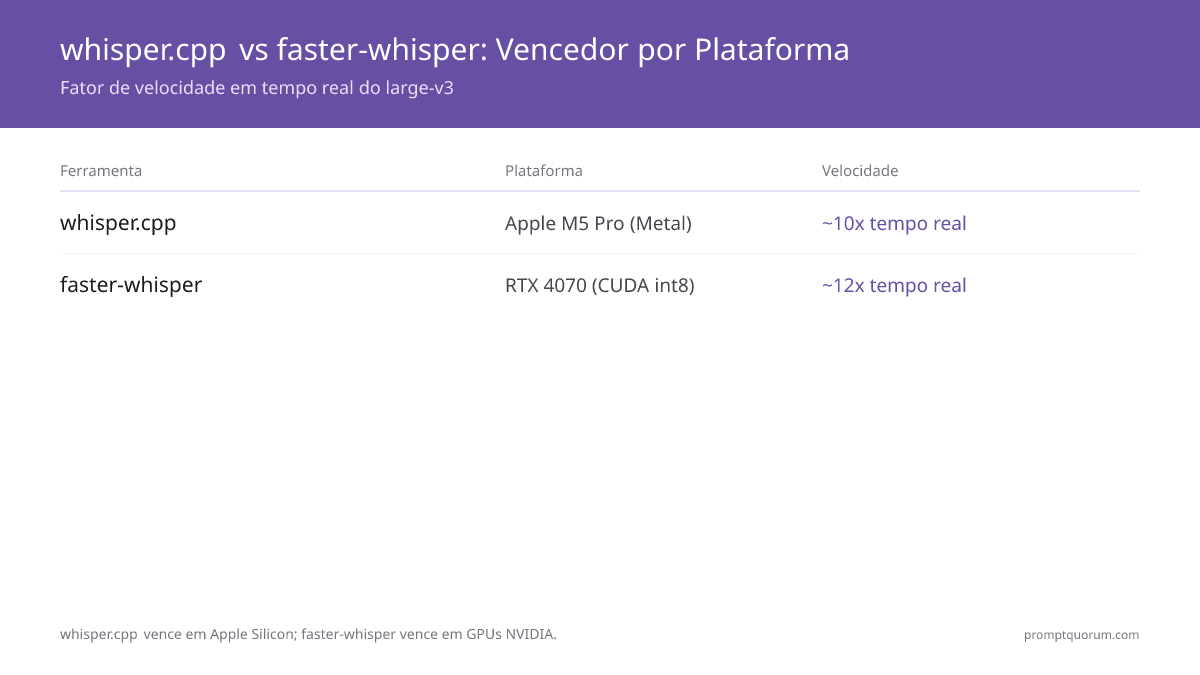
Em Apple Silicon, whisper.cpp com Metal roda large-v3 a ~10× tempo real; em GPUs NVIDIA, faster-whisper com int8 atinge ~12× tempo real — cada ferramenta vence de forma decisiva em sua plataforma-alvo.
💬 Em termos simples
No Mac escolha whisper.cpp (usa o Apple Neural Engine), e no Windows/Linux com GPU NVIDIA escolha faster-whisper (processa áudio 12× mais rápido que o tempo real usando 40% menos memória de GPU).
Métrica | whisper.cpp (large-v3) | faster-whisper (large-v3) |
|---|---|---|
| Plataforma / linguagem | C/C++ (multiplataforma) | Python (CTranslate2) |
| Suporte de GPU | CUDA, Metal, Vulkan | Apenas CUDA |
| Otimização de CPU | AVX2, ARM NEON | Quantização int8 |
| Velocidade — RTX 4070, large-v3 | ~8× tempo real | ~12× tempo real ✓ |
| Velocidade — M5 Pro, large-v3 | ~10× tempo real (Metal) ✓ | ~3× tempo real (somente CPU) |
| Velocidade — somente CPU (x86), base | ~15× tempo real | ~20× tempo real ✓ |
| VRAM — large-v3, GPU | ~3 GB | ~2,5 GB (int8) ✓ |
| Integração Python | Requer wrapper (pywhispercpp) | Nativo ✓ |
| VAD (detecção de silêncio) | Manual (ajuste de --step) | Integrado (Silero VAD) ✓ |
| Streaming em tempo real | Sim (flag --stream) ✓ | Sim (pipeline VAD) |
| Precisão WER (large-v3) | 2,5% (idêntico) | 2,5% (idêntico) |
| Dependência Python | Nenhuma ✓ | Python 3.9+ |
| Raspberry Pi / embarcado | Sim — binário C ✓ | Limitado — overhead de Python |
| Formatos de saída | SRT, VTT, JSON, CSV, txt | Objetos Python (start, end, text) |
whisper.cpp grava a saída diretamente em formatos padrão de legendas e transcrição (SRT, VTT, JSON, CSV, txt) — ideal para fluxos de trabalho de legendagem em que você precisa de um arquivo em disco sem código adicional. faster-whisper retorna um gerador Python de objetos de segmento com atributos start, end e text — ideal para encadeamento de pipelines LLM, em que você passa o texto do segmento diretamente para um modelo posterior sem gravar arquivos intermediários. Para geração de legendas, whisper.cpp é mais simples. Para pipelines que processam segmentos programaticamente, faster-whisper é mais simples.
Benchmark de referência: tempos de GPU vs CPU do faster-whisper
O projeto faster-whisper publica seus próprios tempos em um arquivo de áudio de 13 minutos: eles mostram o whisper.cpp com Flash Attention igualando o faster-whisper fp16 em GPU, enquanto batching e int8 são onde o faster-whisper se destaca. Os números abaixo vêm do README do faster-whisper (large-v2 em uma RTX 3070 Ti de 8 GB com CUDA 12.4 nas linhas de GPU; o modelo small em um Intel Core i7-12700K com 8 threads nas linhas de CPU; beam size 5). Não são medições nossas e usam hardware e modelos diferentes dos números do large-v3 acima.
📍 Em uma frase
No benchmark do README do faster-whisper, o whisper.cpp com Flash Attention (1m05s) e o faster-whisper fp16 (1m03s) ficam praticamente empatados em GPU; o faster-whisper int8 com batching termina o mesmo arquivo de 13 minutos em 16 segundos.
Configuração | Precisão | Tempo | VRAM / RAM |
|---|---|---|---|
| GPU · whisper.cpp (Flash Attn) | fp16 | 1m05s | 4127 MB |
| GPU · faster-whisper | fp16 | 1m03s | 4525 MB |
| GPU · faster-whisper | int8 | 59s | 2926 MB |
| GPU · faster-whisper, batch 8 | int8 | 16s | 4500 MB |
| CPU · whisper.cpp | fp32 | 2m05s | 1049 MB |
| CPU · faster-whisper | int8 | 1m42s | 1477 MB |
| CPU · faster-whisper, batch 8 | int8 | 51s | 3608 MB |
Leia junto com a tabela comparativa: com um único fluxo fp16, a velocidade em GPU das duas ferramentas é próxima nesta configuração. As vantagens duradouras do faster-whisper são a economia de memória do int8 (2,9 GB contra 4,1–4,5 GB em fp16) e a inferência em lote (16 s contra 59 s). Em CPU, whisper.cpp fp32 e faster-whisper int8 ficam a cerca de 25 % um do outro sem batching.
Configuração de transcrição em tempo real
A transcrição em tempo real processa o áudio em chunks à medida que ele chega do microfone, produzindo texto com um pequeno atraso em relação à fala. Ambas as ferramentas suportam isso, mas com diferentes compensações.
- Modo stream do whisper.cpp: execute
./stream -m models/ggml-small.bin --step 3000 --length 10000 -t 4. Processa chunks de 3 segundos; latência ~0,5–1,5 segundo com o modelo small. Sem Python necessário. - Pipeline VAD do faster-whisper: use
vad_filter=Trueemmodel.transcribe(). Silero VAD segmenta o áudio automaticamente nos limites de silêncio — chunks mais naturais do que janelas de comprimento fixo. - Latência prática: 0,5–2 segundos atrás da fala ao vivo com modelos small ou medium. Use tiny para a menor latência (< 0,5 segundo, mas WER maior).
- Seleção de modelo para tempo real: small ou base é o ponto ideal prático — rápido o suficiente para acompanhar a fala, preciso o suficiente para áudio limpo. Evite large-v3 em tempo real a menos que você tenha uma GPU dedicada.
- Entrada de microfone: whisper.cpp lê áudio raw via SDL2 ou portaudio. faster-whisper lê arrays de áudio de qualquer biblioteca Python de áudio (sounddevice, pyaudio, soundfile).
- Estabilidade: o modo stream do whisper.cpp pode produzir tokens repetidos ("alucinações" de preenchimentos curtos) no silêncio. Suprima com
--suppress-blanke--no-speech-threshold.
Apple Silicon: whisper.cpp vence
Em Macs com M1, M2, M3, M4 e M5, whisper.cpp com aceleração Core ML / Metal é a ferramenta correta — sem dúvida. faster-whisper não tem suporte Metal e roda somente em CPU no Mac, atingindo ~3× tempo real com large-v3. whisper.cpp com Metal atinge ~10× tempo real em M5 Pro — uma vantagem de velocidade de 3×.
- Exportação para Core ML: execute
./models/generate-coreml-model.sh large-v3para exportar o encoder para o formato Core ML. Isso descarrega a inferência do encoder no Apple Neural Engine. - Benchmark M5 Pro (large-v3, Metal): ~10× tempo real. 60 minutos de áudio transcritos em ~6 minutos. Observação: o M5 Pro foi lançado em março de 2026 — estes são benchmarks iniciais da comunidade. O desempenho pode melhorar com atualizações do whisper.cpp otimizando o M5 Neural Engine.
- Benchmark M3 MacBook Air (large-v3, Metal): ~7× tempo real. 60 minutos em ~8,5 minutos.
- Memória: a memória unificada significa que não há VRAM separada — um M5 Pro de 16 GB pode rodar large-v3 (~3 GB) confortavelmente junto a outros processos.
- faster-whisper no Mac: somente CPU, int8. Large-v3 a ~3× tempo real. Utilizável para transcrição em lote noturna, mas não para tempo real ou fluxos de trabalho sensíveis ao tempo.
- Recomendação: use whisper.cpp para todo o trabalho de STT no Mac. Adicione pywhispercpp se você precisar de integração Python mantendo a aceleração Metal.
GPU NVIDIA: faster-whisper vence
No Windows e no Linux com GPUs NVIDIA, faster-whisper é a opção superior. Seu backend CUDA do CTranslate2 é mais otimizado que o caminho CUDA do whisper.cpp — ~12× vs. ~8× tempo real com large-v3 em RTX 4070, com menor uso de VRAM.
- Benchmark RTX 4070 (12 GB) (large-v3 int8): ~12× tempo real, ~2,5 GB VRAM.
- Benchmark RTX 3060 (12 GB) (large-v3 int8): ~8× tempo real, ~2,5 GB VRAM.
- Benchmark RTX 4060 (8 GB) (large-v3 int8): ~7× tempo real, ~2,5 GB VRAM — cabe com folga.
- int8 vs float16: int8 é ~2× mais rápido e usa ~40% menos VRAM com perda de precisão negligível. Use sempre
compute_type="int8"em NVIDIA. - Processamento em lote: o parâmetro
batched=Truedo faster-whisper permite o processamento paralelo de múltiplos arquivos de áudio, maximizando a utilização da GPU em grandes trabalhos de transcrição. - Integração em pipeline Python: faster-whisper se integra diretamente ao LangChain, Haystack e pipelines Python personalizados. Sem overhead de subprocesso em comparação com envolver o whisper.cpp.
GPUs NVIDIA antigas (GTX 970): int8 recua para float32
Em uma GTX 970 (Maxwell, compute capability 5.2), o faster-whisper ainda roda em CUDA, mas compute_type="int8" não entrega int8 de verdade: o CTranslate2 converte os pesos para float32. A tabela de quantização dele mapeia toda GPU com compute capability 6.0 ou inferior para float32, qualquer que seja o tipo pedido; por isso a economia de ~40 % de VRAM e o ganho de velocidade do int8 citados para placas RTX não se aplicam.
📍 Em uma frase
Em uma GTX 970 (compute capability 5.2), o faster-whisper roda em CUDA apenas em float32: um tipo de computação int8 solicitado é convertido automaticamente.
💬 Em termos simples
A GTX 970 é antiga demais para int8 em GPU. Ela funciona, mas sem economia de memória, então fique com os modelos tiny, base ou small nos 4 GB dela.
- O que continua funcionando: os binários pré-compilados do CTranslate2 suportam GPUs NVIDIA com compute capability 3.5 ou superior, então uma GTX 970 (5.2) pode rodar o faster-whisper em CUDA, desde que as bibliotecas CUDA e cuDNN instaladas correspondam à versão (veja Problemas comuns).
- Onde o int8 em GPU funciona: o int8 exige compute capability 7.0 ou superior (Volta e série RTX 20 em diante) ou exatamente 6.1 (GTX 1050 a 1080 Ti, int8_float32). As compute capability 6.0, 6.2 e inferiores recuam para float32; o float16 exige 7.0 ou superior.
- Consequência na memória: o float32 usa 4 bytes por parâmetro contra 1 byte do int8; pela contagem de parâmetros, o large-v3 (1,55B) precisa de cerca de 6 GB só para os pesos, mais que os 4 GB da GTX 970. O small (244M, ~1 GB em float32) cabe com folga; o medium (769M, ~3 GB) fica no limite.
- Velocidade: não medimos uma GTX 970, então não há número medido aqui. Espere um desempenho em float32 bem abaixo dos números de RTX 4070 int8 deste guia e teste tiny, base e small com o seu próprio áudio.
- Veja o que a sua GPU suporta:
ctranslate2.get_supported_compute_types("cuda")lista os tipos de computação que o CTranslate2 aceita na sua placa. - Alternativas: int8 em CPU (
device="cpu", compute_type="int8") funciona em qualquer CPU x86 moderna, e os modelos GGML quantizados do whisper.cpp (por exemploggml-large-v3-q5_0.bin, cerca de 3–4 GB) são o caminho usual para encaixar modelos maiores em 4 GB; verifique o build CUDA ou Vulkan na sua placa.
import ctranslate2
from faster_whisper import WhisperModel

# Which compute types does this GPU accept?
print(ctranslate2.get_supported_compute_types("cuda"))

# On compute capability < 6.1 (e.g. GTX 970), request float32 explicitly so nothing is converted silently
model = WhisperModel("small", device="cuda", compute_type="float32")
Whisper no Raspberry Pi 5: tiny, base e small
Em um Raspberry Pi 5, o whisper.cpp roda os modelos tiny e base em tempo real para transcrição ao vivo, enquanto o modelo small roda abaixo do tempo real e é melhor reservá-lo para trabalhos em lote. O Cortex-A76 quad-core do Pi 5 não tem um caminho de GPU utilizável para o Whisper, então toda a inferência é em CPU (ARM NEON). Use os modelos GGML quantizados (ggml-*-q5_0.bin) para reduzir o uso de memória e acelerar a inferência.
📍 Em uma frase
Em um Raspberry Pi 5, o modelo small do whisper.cpp roda mais lento que o tempo real (~0,5×, apenas em lote); tiny e base são os modelos que acompanham a fala ao vivo.
💬 Em termos simples
Um Pi 5 consegue transcrever áudio ao vivo com os modelos Whisper tiny e base, mas o modelo small é pesado demais para acompanhar em tempo real — use o small para arquivos gravados que você processa em segundo plano, não para um microfone ao vivo.
- Whisper small no Pi 5: cerca de 0,4–0,6× tempo real em CPU (um clipe de 10 minutos leva ~17–25 minutos). Preciso com 3,4% WER, mas lento demais para legendagem ao vivo — use-o para transcrição noturna/em lote.
- Whisper base no Pi 5: em torno do tempo real até ~2× com multithreading (
-t 4). O ponto ideal prático para transcrição ao vivo no Pi, com WER aceitável de 5,0%. - Whisper tiny no Pi 5: a opção mais rápida, confortavelmente mais rápida que o tempo real para uso ao vivo, ao custo de um WER mais alto de 7,6%. Ideal para reconhecimento de palavra de ativação e comandos curtos.
- Use modelos quantizados:
bash ./models/download-ggml-model.sh small-q5_0reduz a RAM e acelera a inferência com perda mínima de precisão — importante na memória compartilhada do Pi 5. - faster-whisper no Pi 5: instalável (
pip install faster-whisper, CPU int8) e competitivo para trabalhos em lote, mas o binário C mais leve do whisper.cpp é a escolha embarcada mais comum. - Térmica: a transcrição sustentada exige muito da CPU do Pi 5 — use refrigeração ativa para evitar o throttling térmico que degrada esses números.
Quando usar cada um
Mapeamento direto do seu cenário para a ferramenta adequada:
📍 Em uma frase
Use whisper.cpp em Apple Silicon e alvos embarcados/multiplataforma; use faster-whisper em GPUs NVIDIA e pipelines Python.
💬 Em termos simples
Se você tem um Mac, escolha whisper.cpp — é 3× mais rápido que faster-whisper em hardware Apple. Se você tem GPU NVIDIA e escreve Python, escolha faster-whisper — é mais rápido e precisa de 40% menos memória de GPU.
Cenário | Melhor escolha | Por quê |
|---|---|---|
| Mac com Apple Silicon (qualquer modelo) | whisper.cpp | Aceleração Metal / Core ML — 3× mais rápido que faster-whisper (somente CPU no Mac) |
| Servidor com GPU NVIDIA (Linux/Windows) | faster-whisper | CTranslate2 int8 — mais rápido e menor VRAM que o caminho CUDA do whisper.cpp |
| Pipeline de dados Python | faster-whisper | API Python nativa; sem wrapper de subprocesso; VAD integrado |
| Raspberry Pi / Linux embarcado | whisper.cpp | Binário C puro; sem overhead do runtime Python; otimizado com ARM NEON |
| Assistente de voz em tempo real | whisper.cpp | Modo stream com baixo overhead; funciona sem Python no Pi / embarcado |
| Transcrição em lote (grande arquivo de áudio) | faster-whisper | Inferência em lote, utilização da GPU, integração Python assíncrona |
| GPU AMD (Vulkan) | whisper.cpp | Suporte de backend Vulkan; faster-whisper é apenas CUDA |
| Servidor Linux somente CPU | faster-whisper | A quantização int8 dá ~30% de vantagem de velocidade em CPU x86 |
Além do whisper.cpp e do faster-whisper
Duas ferramentas adicionais estendem o Whisper com capacidades que nenhuma das duas oferece de fábrica: diarização de falantes e inferência em lote ultrarrápida em GPU.
- WhisperX: construído sobre o faster-whisper, o WhisperX adiciona marcas de tempo em nível de palavra e diarização de falantes — identificando qual falante disse quais palavras. Melhor para: transcrição de reuniões com rótulos de falante, edição de podcasts e transcrição de entrevistas. Instale com
pip install whisperxe forneça um token do Hugging Face para o modelo de diarização. - insanely-fast-whisper: um wrapper de pipeline Hugging Face Transformers que adiciona suporte a Flash Attention 2 para inferência em GPU significativamente mais rápida que o faster-whisper padrão em hardware NVIDIA. Melhor para: processamento em lote de grandes arquivos de áudio em GPUs NVIDIA. Requer uma GPU compatível com Flash Attention 2 (Ampere ou mais recente: RTX 3000+, A100, H100).
Problemas comuns e soluções
Os problemas de configuração e runtime mais frequentes, com soluções diretas:
- Incompatibilidade de versão do CUDA: as versões atuais do faster-whisper exigem cuBLAS para CUDA 12 e cuDNN 9. Se você está preso a bibliotecas antigas, fixe o ctranslate2:
pip install --force-reinstall ctranslate2==4.4.0(CUDA 12 com cuDNN 8) ou3.24.0(CUDA 11 com cuDNN 8). Verifique a versão do CUDA comnvcc --version. - Falha na exportação do modelo Metal: garanta que as Xcode Command Line Tools estejam instaladas — execute
xcode-select --install. O script de exportação Core ML requer o pacote Pythoncoremltools:pip install coremltools. - Alucinações no silêncio: ambas as ferramentas podem produzir tokens de preenchimento repetidos em segmentos de áudio silencioso. Use
--no-speech-threshold 0.6no modo stream do whisper.cpp, ouvad_filter=Trueemmodel.transcribe()do faster-whisper para pular automaticamente os segmentos silenciosos. - Sem memória com large-v3: mude para quantização int8 no faster-whisper (
compute_type="int8") — reduz a VRAM de ~5 GB (float16) para ~2,5 GB. No whisper.cpp, use a variante GGML quantizada (p. ex.,ggml-large-v3-q5_0.bin) que reduz a memória para ~3–4 GB. - Saída ilegível em áudio não inglês: não use variantes
.endo modelo (tiny.en, base.en) para fala não inglesa — são somente inglês. Use os modelos multilíngues (base, small, medium, large-v3) e especifique o idioma explicitamente:-l ptno whisper.cpp oulanguage="pt"no faster-whisper. - Inferência lenta em CPU: verifique se a sua CPU suporta instruções AVX2 (necessárias para inferência otimizada em CPU). Confira com
grep avx2 /proc/cpuinfono Linux ousysctl machdep.cpu.featuresno Mac. CPUs sem AVX2 recorrem a SIMD genérico e serão 2–3× mais lentas.
Perguntas frequentes
Existe um pacote Debian ou apt para o whisper.cpp?
Sim — o whisper.cpp agora tem um pacote oficial para Debian (atualmente em sid), disponibilizando o binário whisper.cpp além de libwhisper-dev e libwhisper1 para vinculação como biblioteca compartilhada. Ainda não chegou às versões estáveis do Debian nem aos repositórios padrão do Ubuntu, então na maioria dos sistemas ainda é preciso usar sid ou compilar a partir do código-fonte. Também existe um Snap não oficial (sudo snap install whisper-cpp) para Debian 9+ e Ubuntu.
Como verifico qual versão do whisper.cpp está instalada?
Execute o binário compilado sem argumentos ou com --help — a versão aparece na linha de banner. Você também pode conferir o commit exato com git describe --tags dentro do repositório clonado, ou comparar a data do build com as notas de versão em github.com/ggml-org/whisper.cpp/releases para ver se está atrás da v1.9.5 atual.
A precisão de transcrição é a mesma entre whisper.cpp e faster-whisper?
Sim. Ambas as ferramentas usam os mesmos pesos do modelo OpenAI Whisper — o modelo em si é idêntico. A diferença está unicamente no runtime de inferência (C/C++ vs CTranslate2 Python). O WER no mesmo arquivo de áudio ficará dentro de 0,1% absoluto um do outro, o que está dentro da variação normal causada pela aleatoriedade do beam search.
Posso usar faster-whisper em um Mac com Apple Silicon?
Sim, mas ele roda somente em CPU — faster-whisper não tem suporte Metal. Em um M5 Pro, faster-whisper large-v3 roda a ~3× tempo real (CPU int8), comparado a ~10× do whisper.cpp com Metal. Para a maioria dos usuários de Mac, whisper.cpp é 3× mais rápido com o mesmo modelo. A única razão para usar faster-whisper no Mac é se o seu pipeline Python já depende dele e a velocidade não é crítica.
Que tamanho de modelo Whisper devo usar para um assistente de voz?
Para interfaces de voz em tempo real, Whisper small é a recomendação padrão — 3,4% WER em inglês limpo, ~200 ms de latência de STT em uma CPU ou GPU moderna, e cabe em 2 GB de RAM. Use tiny se você estiver em hardware muito restrito (Raspberry Pi Zero 2W, telefones antigos) e puder tolerar ~7,6% WER. Use medium ou large-v3 apenas para transcrição em lote em que a latência não é uma restrição.
whisper.cpp suporta idiomas além do inglês?
Sim. Todos os modelos multilíngues do Whisper (base, small, medium, large-v3) suportam 99 idiomas. Adicione `-l [código do idioma] ao CLI: -l pt para português, -l de para alemão, -l ja` para japonês, etc. Os modelos tiny.en e base.en são somente inglês e ligeiramente mais precisos para inglês que seus equivalentes multilíngues.
Como instalo faster-whisper com suporte CUDA?
Instale com pip install faster-whisper. As versões atuais exigem NVIDIA cuBLAS para CUDA 12 e cuDNN 9 no seu sistema (no Linux, pip install nvidia-cublas-cu12 "nvidia-cudnn-cu12==9.*" fornece os dois). Em configurações antigas com CUDA 11 / cuDNN 8, fixe ctranslate2==3.24.0 (ou 4.4.0 para CUDA 12 com cuDNN 8). Em seguida, especifique device="cuda" ao carregar o modelo: WhisperModel("large-v3", device="cuda", compute_type="int8"). Use device="auto" se quiser que ele recorra à CPU quando o CUDA não estiver disponível.
Qual é mais preciso — whisper.cpp ou faster-whisper?
Idêntico. Ambas as ferramentas usam os mesmos pesos do modelo OpenAI Whisper e produzem o mesmo WER em qualquer arquivo de áudio. A diferença entre whisper.cpp e faster-whisper é a velocidade e o suporte de plataforma, não a precisão de transcrição. Qualquer diferença de WER que você medir entre execuções está dentro da variação normal do beam search, não vem do runtime em si.
Posso rodar o Whisper large-v3 com 8 GB de RAM?
Sim em GPU — large-v3 int8 no faster-whisper usa ~2,5 GB de VRAM e roda em qualquer GPU de 8 GB. Em hardware somente CPU, 8 GB de RAM é apertado para large-v3 (float32 usa ~10 GB). Use medium (5 GB RAM) ou small (2 GB RAM) em sistemas somente CPU. whisper.cpp é mais eficiente em memória na CPU que faster-whisper devido ao menor overhead do runtime.
Quanto custa o Whisper local vs STT na nuvem?
Custo contínuo zero. Os serviços de STT na nuvem cobram US$ 0,006–0,024 por minuto de áudio — para um desenvolvedor que transcreve 8 horas de reuniões por semana, isso dá US$ 120–480/mês. O Whisper local roda em hardware que você já possui, sem tarifas por minuto, sem gerenciamento de chaves de API e sem que os dados de áudio saiam da sua máquina.
O faster-whisper int8 funciona em uma GTX 970?
Não, não como int8 de verdade. A GTX 970 tem compute capability 5.2, e o CTranslate2 só executa int8 em GPUs com compute capability 7.0 ou superior (ou exatamente 6.1); em placas mais antigas ele converte os pesos para float32 automaticamente. O faster-whisper continua rodando na GPU em float32, então use tiny, base ou small para ficar dentro de 4 GB, ou int8 em CPU, que funciona em qualquer CPU x86 moderna. Não medimos uma GTX 970, então não há número de velocidade medido aqui.
Qual o tamanho dos arquivos de modelo do Whisper para whisper.cpp e faster-whisper?
O README do whisper.cpp lista arquivos de modelo GGML de cerca de 75 MiB (tiny), 142 MiB (base), 466 MiB (small), 1,5 GiB (medium) e 2,9 GiB (large) em disco, que precisam de aproximadamente 273 MB, 388 MB, 852 MB, 2,1 GB e 3,9 GB de memória. O faster-whisper baixa os modelos CTranslate2 do Hugging Face no primeiro uso; o large-v3 tem cerca de 3 GB lá (1,55B de parâmetros a 2 bytes em float16). A tabela de tamanhos de modelo acima traz a contagem de parâmetros de cada tamanho.
O Whisper large-v3-turbo é melhor que o large-v3 para transcrição local?
Ele é mais rápido, não mais preciso. O large-v3-turbo tem 809M de parâmetros porque a OpenAI reduziu o decoder de 32 para 4 camadas, e o model card o descreve como muito mais rápido que o large-v3 ao custo de uma pequena degradação de qualidade, sob licença MIT. O card também alerta que ele pode alucinar ou repetir texto e que a precisão varia entre idiomas: mantenha o large-v3 para o áudio mais difícil e use o turbo (ou o distil-large-v3 para inglês) quando a velocidade importar. whisper.cpp e faster-whisper conseguem rodá-lo.
O whisper.cpp pode usar uma GPU AMD ou Intel em vez de CUDA?
Sim. O backend Vulkan do whisper.cpp (-DGGML_VULKAN=1) funciona entre fabricantes, desde que o seu driver suporte a API Vulkan; o ROCm/HIP (-DGGML_HIP=1) mira GPUs AMD, e o OpenVINO acelera o encoder em CPUs e GPUs Intel. A documentação do faster-whisper cobre apenas NVIDIA CUDA; as notas de versão do CTranslate2 mencionam wheels de ROCm, mas não testamos esse caminho.
O mlx-whisper é mais rápido que o whisper.cpp em um Mac?
Um teste independente diz que sim para o large-v3-turbo: a nova medição de Bill Mill em janeiro de 2026 registrou cerca de 13,1 segundos para o mlx_whisper contra 26,7 segundos para o whisper.cpp na mesma gravação longa, ou seja, cerca de 2× mais rápido. Um teste de velocidade da comunidade com um clipe curto deixou os dois próximos, com o whisper.cpp usando Core ML e quantização q5_0. Os números do M5 Pro deste guia não foram comparados com o MLX, então faça o benchmark com o seu próprio áudio antes de escolher.
Fontes
- whisper.cpp no GitHub — Código-fonte, instruções de compilação, scripts de download de modelos e guia de configuração Metal/Core ML.
- faster-whisper no GitHub — Código-fonte, documentação da API Python e resultados de benchmarks.
- distil-whisper/distil-large-v3 no Hugging Face — Ficha do modelo, resultados de benchmarks e instruções de uso da variante destilada do Whisper.
- WhisperX no GitHub — Marcas de tempo em nível de palavra e diarização de falantes construídas sobre o faster-whisper.
- insanely-fast-whisper no GitHub — Pipeline Whisper Flash Attention 2 para máximo throughput em GPU NVIDIA.
- OpenAI Whisper no GitHub — Modelo Whisper original, paper e fichas de modelo para todos os tamanhos.
- Paper do OpenAI Whisper (Radford et al., 2022) — "Robust Speech Recognition via Large-Scale Weak Supervision". Fonte dos valores de WER.
- Documentação do CTranslate2 — Detalhes de quantização, suporte de hardware e fundamentos da otimização int8.
- Documentação de quantização do CTranslate2 — Tipos de computação que cada compute capability de GPU suporta (base da seção sobre a GTX 970).
- Benchmarks do README do faster-whisper — Tempos de GPU e CPU em 13 minutos usados no benchmark de referência, e os requisitos atuais de CUDA 12 / cuDNN 9.
- openai/whisper-large-v3-turbo no Hugging Face — Model card: 809M de parâmetros, 4 camadas de decoder, licença MIT.
- Bill Mill: benchmark atualizado de mlx_whisper vs. whisper.cpp — Comparação independente de tempos do large-v3-turbo no Apple Silicon.
- Releases do whisper.cpp — Notas de versão da v1.9.4 e da v1.9.5.