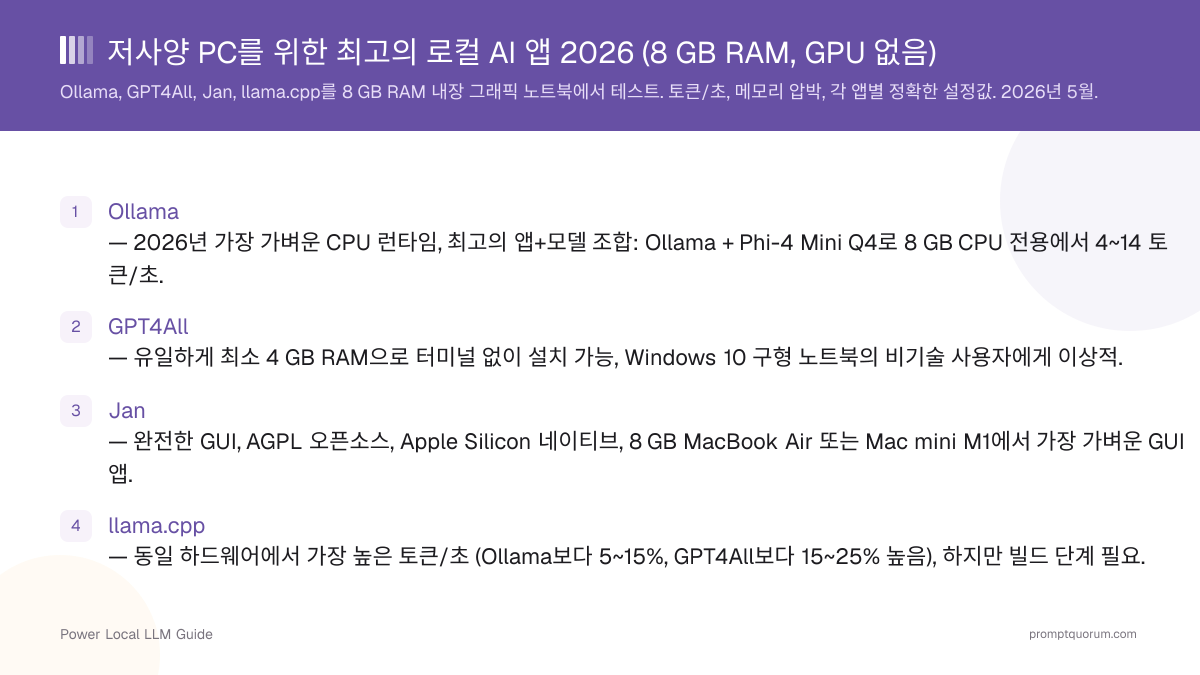
8 GB RAM, GPU 없음 조건에서 Ollama, Jan, llama.cpp, GPT4All 비교
아래 수치는 llama.cpp 기본 벤치마크 스레드, Hugging Face 모델 카드, r/LocalLLaMA의 8 GB RAM 내장 그래픽 테스트 보고서에서 수집한 것입니다. 확인한 버전(2026년 10월): Ollama v0.40.10, Jan v0.8.7, GPT4All v3.10.0(2025년 2월 릴리스, 마지막 코드 업데이트 2025년 5월 27일).
📍 한 문장으로
8 GB RAM, 전용 GPU 없는 PC에서 Ollama + Phi-4 Mini Q4_K_M 조합이 비코딩 용도의 로컬 AI에 가장 적합합니다 — 가장 빠른 생성 속도, 가장 낮은 발열, 가장 큰 모델 라이브러리.
💬 쉽게 말하면
저사양 8 GB RAM PC: Ollama를 설치하고 ollama pull phi4-mini와 ollama run phi4-mini를 실행하세요. CPU에 따라 4~14 토큰/초가 나옵니다. 터미널 없는 대안은 Jan을 일반 앱처럼 설치하고 8 GB에 맞는 모델로 필터링하세요.
앱 | 최소 RAM | 최적 모델 (8 GB 한도) | 토큰/초 (CPU 전용) | 발열 | 평가 |
|---|---|---|---|---|---|
| Ollama | 6 GB | Phi-4 Mini Q4_K_M | 4~14 토큰/초 | 낮음 | 최고 균형 — 1순위 선택 |
| Jan | 6 GB | Gemma 4 E2B Q4_K_M | 3~11 토큰/초 | 보통 | 최고의 GUI — 터미널 없는 선택 |
| llama.cpp | 4 GB | SmolLM 2 1.7B Q4_K_M | 5~18 토큰/초 | 낮음 | 빌드하면 가장 빠름 |
| GPT4All | 4 GB | Llama 3.2 1B Q4_0 | 3~10 토큰/초 | 낮음 | 대안 — 2025년 5월 이후 업데이트 없음 |
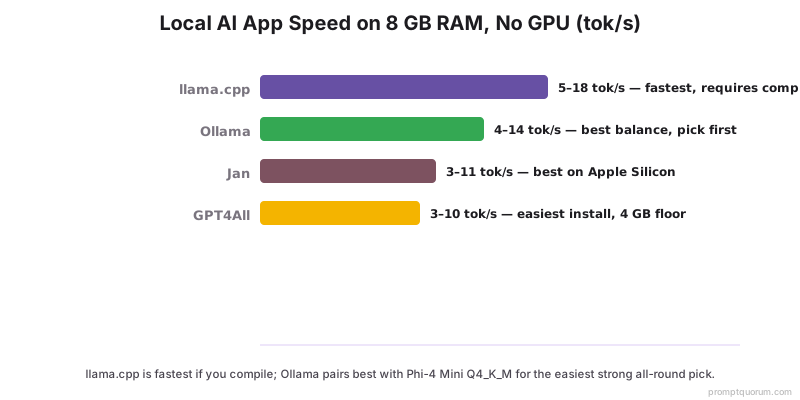
📌참고: Apple M1 8 GB는 통합 메모리 아키텍처 덕분에 모든 앱에서 x86 8 GB 노트북보다 일관되게 성능이 뛰어납니다.
어떤 앱을 선택해야 하나요?
올바른 앱은 터미널 사용 여부, Windows 또는 Mac 사용 여부, CPU 세대에 따라 달라집니다.
상황 | 선택 |
|---|---|
| Windows 10 노트북, 8 GB RAM, 터미널 경험 없음 | Jan |
| 최신 Ryzen / Intel 12세대, 8 GB, 터미널 가능 | Ollama |
| MacBook Air M1 / Mac mini M1 8 GB | Jan 또는 Ollama |
| Linux 노트북, 최대 토큰/초 원함 | llama.cpp |
| 4 GB RAM 장치 (최소 요건 미달) | GPT4All + Llama 3.2 1B Q4_0 |
| Intel Core i5-8250U / i7-7700U 구형 CPU | Ollama + SmolLM 2 1.7B |
| macOS 14 이상의 Intel Mac (2015~2020년형) | Ollama (CPU 전용) + SmolLM 2 1.7B |
| Linux 개발자 모드 Chromebook | llama.cpp + SmolLM 2 |
| 드라이버 설치 불가 업무용 노트북 | GPT4All (관리자 권한 불필요) |
💡팁: 확신이 없다면 Ollama로 시작하세요. 모든 OS에서 작동하며 나중에 OpenAI 호환 API로 다른 도구와 통합할 수 있습니다.
실제 저사양 하드웨어에서 각 앱은 얼마나 빠른가요?
8 GB RAM, 전용 GPU 없는 일반적인 하드웨어에서의 토큰/초, 2026년 10월.
하드웨어 | 모델 | Ollama | Jan | llama.cpp | GPT4All |
|---|---|---|---|---|---|
| Intel Core i5-8250U + UHD 620 (2018년 울트라북) | Phi-4 Mini Q4_K_M | 4~6 토큰/초 | 3~5 토큰/초 | 5~7 토큰/초 | 3~5 토큰/초 |
| AMD Ryzen 5 5500U + Vega 7 (2021년 저가형) | Phi-4 Mini Q4_K_M | 8~11 토큰/초 | 7~9 토큰/초 | 9~13 토큰/초 | 6~9 토큰/초 |
| Intel Core Ultra 5 125H + Arc iGPU (2024년 중급) | Gemma 4 E2B Q4_K_M | 10~14 토큰/초 | 9~12 토큰/초 | 12~18 토큰/초 | 8~11 토큰/초 |
| Apple M1 8 GB (MacBook Air 2020) | Llama 3.2 1B Q5_K_M | 28~40 토큰/초 | 26~38 토큰/초 | 32~48 토큰/초 | 20~30 토큰/초 |
| Apple M1 8 GB | Phi-4 Mini Q4_K_M | 12~18 토큰/초 | 11~17 토큰/초 | 14~20 토큰/초 | 9~14 토큰/초 |
| Intel Core i5-8250U | SmolLM 2 1.7B Q4_K_M | 10~14 토큰/초 | 9~13 토큰/초 | 12~16 토큰/초 | 8~12 토큰/초 |
📌참고: Apple Silicon이 이 표를 압도하는 이유는 통합 메모리 아키텍처 덕분에 GPU와 CPU가 동일한 RAM을 고대역폭으로 공유하기 때문입니다.
8 GB RAM이 왜 빡빡하게 느껴지고 언제 스로틀링이 시작되나요?
8 GB RAM에서 OS는 모델 로드 전에 2.5~3.5 GB를 차지하며, 모델과 KV 캐시에 4.5~5.5 GB가 남습니다.
- 작업 세트 대 시스템 RAM: Phi-4 Mini Q4_K_M은 디스크에서 ≈ 2.5 GB이지만 2048 컨텍스트에서 RAM에서 ≈ 3.0~3.5 GB입니다. 컨텍스트를 1024로 낮추면 ≈ 400 MB를 절약할 수 있습니다.
- 스왑으로 인한 사망: 작업 세트가 물리적 RAM을 초과하면 토큰/초가 5~10배 떨어집니다.
- 울트라북의 열 스로틀링: 팬 없는 장치는 지속적 추론 3~5분 만에 CPU 주파수를 20~35% 낮춥니다.
- 컨텍스트 길이는 메모리 세금: 기본 컨텍스트 4096은 4B 모델에서 600~900 MB KV 캐시를 예약합니다. 실제로 긴 입력이 필요하지 않다면 1024로 낮추세요.
- 배경 앱이 더 큰 영향: Chrome 탭 20개는 1~2 GB, Slack은 400~600 MB를 차지합니다.
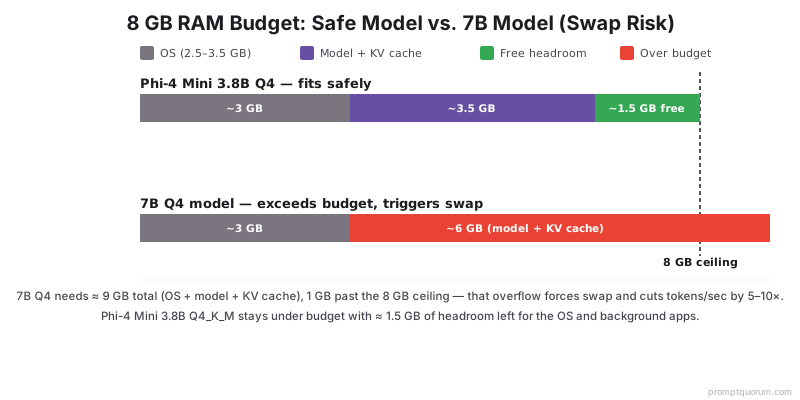
⚠️경고: 8 GB RAM에서는 Q2로도 7B 모델을 로드하지 마세요. 7B Q2는 2048 컨텍스트에서 ≈ 5.5 GB에 달해 8 GB 한도를 초과합니다.
각 앱에서 어떤 모델과 양자화를 다운로드해야 하나요?
8 GB RAM, 전용 GPU 없음에서는 Q4_K_M 이하의 4B 매개변수 이하로 유지하세요.
- Ollama:
ollama pull phi4-mini(Phi-4 Mini 3.8B Q4_K_M, ≈ 2.5 GB). 최고 속도는ollama pull smollm2:1.7b(≈ 1.0 GB). - GPT4All: 내장 모델 브라우저 → "Llama 3.2 1B Instruct Q4_0" (≈ 0.7 GB), RAM이 허용하면 "Phi-4 Mini Q4_K_M". 다만 카탈로그는 2025년 2월 v3.10.0 빌드 이후 갱신되지 않아 Gemma 4 E2B 같은 최신 모델은 포함되어 있지 않습니다.
- Jan: 큐레이션된 카탈로그 → Apple Silicon에서 "Gemma 4 E2B Instruct Q4_K_M" (≈ 2 GB), x86에서 "Phi-4 Mini Q4_K_M".
- llama.cpp: Hugging Face에서 직접 GGUF 다운로드.
./llama-cli -m model.gguf -p "..." -c 1024 -t 4로 실행. - 피할 것: 어떤 양자화도 7B 모델, Q5_K_M 이상, 기본 모델 — 항상
-instruct변형을 선택하세요.
💡팁: Q4_K_M은 Q4_0과 다릅니다. 같은 크기에서 ≈ 5~10% 더 높은 품질을 제공합니다.
저사양 하드웨어에서 30~60% 더 많은 토큰/초를 얻는 설정은?
기본값은 16 GB RAM과 전용 GPU에 맞게 설정되어 있습니다. CPU 전용 8 GB에서는 컨텍스트 길이, 배치 크기, 스레드 수가 중요합니다.
- 컨텍스트 길이 — 가장 큰 단일 향상. 기본값 4096에서 1024로 낮추세요. Ollama:
OLLAMA_NUM_CTX=1024 ollama run phi4-mini. llama.cpp:-c 1024. 토큰/초 향상: 10~20%. - 스레드 수 — 물리적 코어로 설정. llama.cpp:
-t 4. Ollama:OLLAMA_NUM_THREAD=4. - 프롬프트 배치 크기 — 8로 설정. llama.cpp:
--n-batch 8. 4B 모델에서 15~25% 향상. - KV 캐시 양자화 — q8_0으로 설정. llama.cpp:
--cache-type-k q8_0 --cache-type-v q8_0. RAM 절약: 150~400 MB. - 스왑 취약 시스템에서 mlock 비활성화. llama.cpp
--no-mlock. Windows 10/11 8 GB에서 일관되게 더 빠릅니다. - AVX2 빌드 사용. 직접 빌드 시
-DGGML_AVX2=ON. AVX-512 감지:cat /proc/cpuinfo | grep avx512.
💡팁: 다섯 가지 조정을 모두 적용하면 동일 모델, 동일 하드웨어에서 보통 35~55% 더 많은 토큰/초를 얻습니다.
로컬 AI에 내장 그래픽을 사용할 가치가 있나요?
8 GB RAM 대부분의 노트북에서 대답은 아니오입니다 — CPU에서 추론을 유지하세요. 세 가지 예외:
- Apple Silicon (M1/M2/M3/M4) — 항상 예. Ollama, Jan, llama.cpp는 Mac에서 Metal 가속을 자동으로 사용합니다. M1 8 GB가 대부분의 Windows 8 GB 노트북보다 2~3배 빠른 이유입니다.
- Intel Arc iGPU (Meteor Lake / Arrow Lake) — 가끔.
-DGGML_SYCL=ON으로 빌드한 llama.cpp는 30~60% 빠릅니다. - AMD Ryzen 7000/8000 iGPU — 실험적. ROCm 지원이 2026년 불안정합니다.
- 구형 Intel UHD / AMD Vega — 무시. CPU보다 느립니다.
💡팁: CPU 전용으로 10번, 내장 그래픽으로 10번 생성 후 토큰/초를 비교하세요.
흔한 실수
8 GB / GPU 없는 시스템에서 성능을 망치는 다섯 가지 실수:
- 실수 1: "Q4가 디스크에 맞으니까" 7B 모델 로드. 7B Q4는 RAM에서 ≈ 5.5~6.5 GB로 8 GB 한도를 초과합니다. 4B 이하로 유지하세요.
- 실수 2: 컨텍스트 창을 4096으로 둠.
OLLAMA_NUM_CTX=1024또는-c 1024로 설정하세요. - 실수 3: Chrome, Slack 열어둔 채 실행. 추론 전에 불필요한 앱을 닫으세요.
- 실수 4: "품질을 위해" Q8_0 선택. 품질 차이는 인식 불가지만 RAM은 두 배 필요합니다. Q4_K_M을 유지하세요.
- 실수 5: Raspberry Pi 4가 충분하다고 가정. 1~3 토큰/초는 채팅에 사용할 수 없습니다.
💡팁: 모든 기본값은 16~32 GB RAM과 전용 GPU를 위한 것입니다. 이 가이드의 설정 섹션을 "저사양 사전 설정"으로 생각하고 첫 실행 전에 모든 조정을 적용하세요.
자주 묻는 질문
4 GB RAM으로 로컬 AI를 실행할 수 있나요?
네, 하지만 Llama 3.2 1B Q4_0 또는 SmolLM 2 360M처럼 2B 미만 모델만 가능합니다. 네 앱 중 GUI 앱으로는 GPT4All만 공식 최소 요건으로 4 GB를 표시합니다. llama.cpp도 4 GB에서 실행되지만 설치 프로그램 최소 요건이 없는 명령줄 바이너리로 배포됩니다.
구형 Intel CPU로 로컬 AI를 실행할 수 있나요?
AVX2를 지원하는 CPU라면 (Haswell, 2013년 이상) 2026년에도 작동합니다. Intel Core i5-8250U에서 Phi-4 Mini Q4가 4~6 토큰/초로 실행됩니다.
로컬 AI가 노트북을 손상시킬 수 있나요?
아니요. 로컬 추론은 일반 사용자 프로세스입니다. 열 스로틀링이 발생해도 펌웨어가 자동으로 보호합니다.
내장 그래픽으로 충분한가요?
Apple Silicon (M1+)에서는 충분합니다. Intel Core Ultra에서는 SYCL 설정으로 30~60% 추가 속도 가능. 구형 Intel UHD에서는 CPU보다 느립니다.
CPU 전용에서 가장 빠른 모델은 무엇인가요?
Llama 3.2 1B Q4_0과 SmolLM 2 1.7B Q4_K_M. Apple M1에서 25~50 토큰/초, 최신 Ryzen/Intel에서 12~25 토큰/초.
RAM을 더 추가하는 것이 CPU 업그레이드보다 낫나요?
8 GB에서 16 GB로 업그레이드하면 7B~8B 모델이 가능해집니다. 하나만 해야 한다면 RAM을 추가하세요.
Chromebook에서 로컬 AI를 실행할 수 있나요?
Linux 개발자 모드 (Crostini)가 있으면 가능합니다. ARM Chromebook에서는 llama.cpp가 가장 안정적입니다.
Windows 10이 2026년 로컬 AI에서 작동하나요?
네. 네 앱 모두 Windows 10 22H2를 지원합니다. 보안 업데이트는 2025년 10월에 종료됐지만 앱 실행은 가능합니다.
가장 저렴하게 로컬 AI를 잘 실행하는 노트북은?
2021~2022년형 중고 ThinkPad T14 (16 GB RAM, Ryzen 5 5500U)는 350~450유로에 8~14 토큰/초. Apple M1 중고 MacBook Air도 좋은 선택입니다.
2026년에도 GPT4All을 설치해도 괜찮습니까?
설치와 실행은 정상적으로 됩니다. 다만 최신 릴리스가 2025년 2월 25일 v3.10.0으로, 2026년 10월 기준 약 20개월간 새 빌드가 없으며 마지막 코드 업데이트는 2025년 5월 27일입니다. 실질적으로는 기본 카탈로그에 새로운 모델 아키텍처가 추가되지 않고 앱 자체의 보안 패치도 제공되지 않는다는 뜻이며, 이는 개인용 기기보다 업무용 기기에서 더 큰 부담이 됩니다. 유지 관리가 중단되었을 수 있는 앱으로 간주하고, 남아 있는 두 가지 장점이 해당될 때만 사용하십시오 — 4 GB RAM 한계, 또는 관리자 권한이 없는 잠긴 노트북 — 그 외에는 Jan을 사용하십시오.
Intel Mac 8 GB RAM에서 로컬 AI를 실행할 수 있나요?
네, 다만 CPU로만 가능합니다. Ollama의 공식 macOS 요구 사항은 macOS Sonoma(14) 이상, Apple M 시리즈(CPU 및 GPU) 또는 x86(CPU 전용)을 명시하므로, macOS 13 이하에 머문 Intel Mac에서는 현재 Ollama 앱을 실행할 수 없습니다. Jan은 유니버설 macOS 빌드를 제공하며, llama.cpp는 모든 Intel Mac에서 컴파일할 수 있습니다. 속도는 Apple M1 행이 아니라 벤치마크 표의 Intel 노트북 행에 가깝게 나오므로, SmolLM 2 1.7B Q4_K_M이나 Phi-4 Mini Q4_K_M 같은 1.7B~3.8B 모델을 사용하십시오.
오래된 Core i3, Celeron, Pentium 노트북에서 로컬 AI를 실행할 수 있나요?
경우에 따라 가능합니다. 결정 요인은 브랜드명이 아니라 CPU 명령어 세트입니다. 2013년 이후(Haswell) Intel Core i3는 AVX2를 지원하지만, 1세대 Core i3, i3-3110M 같은 Ivy Bridge 모델, Atom 기반 Celeron / Pentium N 시리즈(Gemini Lake, N6000 같은 Jasper Lake)는 지원하지 않습니다. 설치 전에 Intel ARK에서 정확한 모델을 확인하십시오. AVX2가 있고 8 GB RAM이라면 SmolLM 2 1.7B Q4_K_M 또는 Llama 3.2 1B Q4_K_M이 현실적인 상한입니다. AVX2가 없으면 llama.cpp는 실행되지만 대화에 쓰기에는 대체로 너무 느립니다.
Raspberry Pi를 로컬 AI에 사용할 수 있나요?
Raspberry Pi 5 8 GB는 4~7 토큰/초로 가능하지만 채팅용으로는 중고 x86 노트북이 더 낫습니다.