2026년 LM Studio, Jan, GPT4All 비교
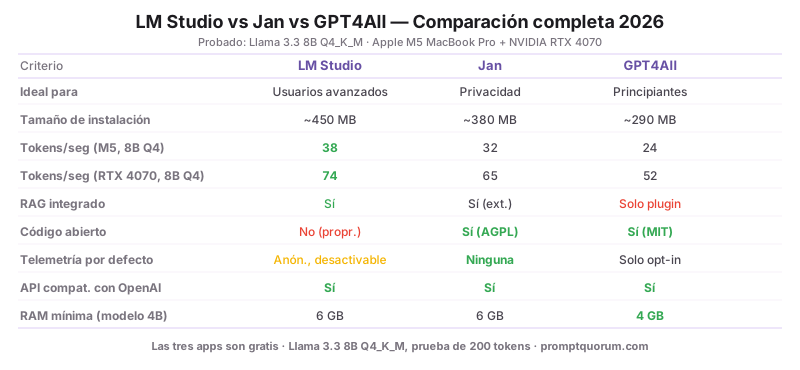
Apple M5 MacBook Pro(통합 메모리 16 GB)와 Windows 11이 설치된 NVIDIA RTX 4070 데스크톱(VRAM 12 GB, 시스템 RAM 32 GB)에서 테스트. 직접 비교를 위해 세 앱 모두 동일한 8B 클래스 모델(Llama 3.1 8B Q4_K_M)로 테스트했습니다.
기준 | |||
|---|---|---|---|
| 최적 대상 | 고급 사용자 | 개인정보 중시 사용자 | 초보자 |
| 설치 크기 | ~450 MB | ~380 MB | ~290 MB |
| tok/s(M5, 8B Q4) | 38 | 32 | 24 |
| tok/s(RTX 4070, 8B Q4) | 74 | 65 | 52 |
| 통합 RAG | 있음 | 있음(확장) | 플러그인만 |
| 오픈소스 | 아니요(독점) | 예(Apache 2.0) | 예(MIT) |
| 기본 텔레메트리 | 정책상 없음 | 기본값 없음 | opt-in만 |
| OpenAI 호환 API 서버 | 있음 | 있음 | 있음 |
| 최소 RAM(4B 모델) | 6 GB | 6 GB | 4 GB |
어떤 것을 선택해야 합니까?
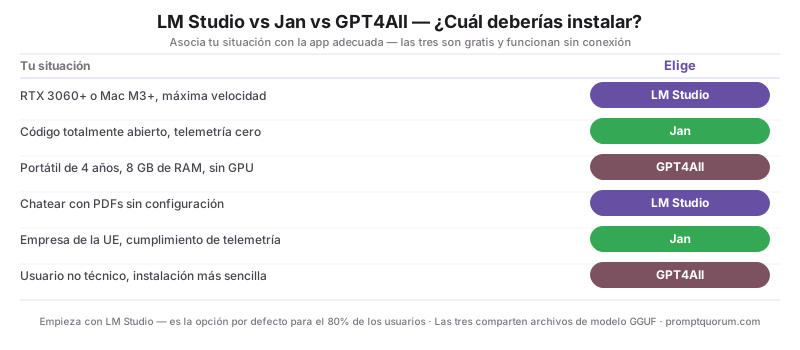
올바른 선택은 하드웨어, 개인정보 입장, 기술 수준에 따라 달라집니다. 이 결정 단축키를 사용하십시오:
상황 | 선택 |
|---|---|
| RTX 3060 이상 또는 Mac M3 이상이 있고 최대 속도를 원합니다 | LM Studio |
| 완전 오픈소스 코드와 텔레메트리 없음을 원합니다 | Jan |
| 4년 된 노트북, RAM 8 GB, GPU 없습니다 | GPT4All |
| 처음부터 PDF와 채팅하고 싶습니다 | LM Studio |
| 한국의 개인정보 보호 규정이 걱정됩니다 | Jan |
| 부모님이 혼자 설치할 수 있는 챗봇이 필요합니다 | GPT4All |
실제 하드웨어에서 각 앱은 얼마나 빠릅니까?
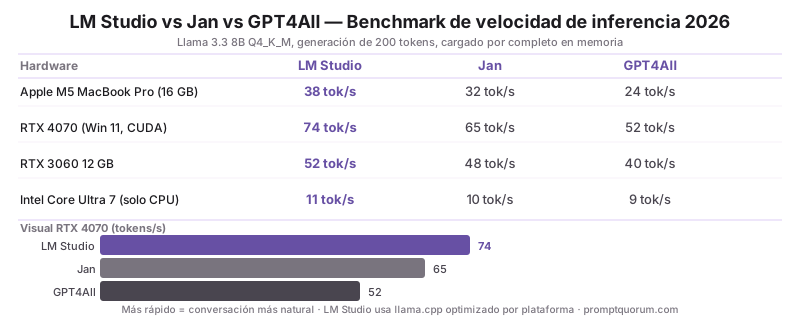
Llama 3.1 8B Q4_K_M을 메모리에 완전히 로드한 상태로 200 토큰 생성 중 측정한 초당 토큰 수. 가장 가까운 정수로 반올림.
하드웨어 | |||
|---|---|---|---|
| Apple M5 MacBook Pro(16 GB) | 38 tok/s | 32 tok/s | 24 tok/s |
| RTX 4070(Win 11, CUDA) | 74 tok/s | 65 tok/s | 52 tok/s |
| RTX 3060 12 GB(구형 드라이버) | 52 tok/s | 48 tok/s | 40 tok/s |
| Intel Core Ultra 7(CPU 전용) | 11 tok/s | 10 tok/s | 9 tok/s |
LM Studio가 왜 더 빠릅니까?
LM Studio는 각 플랫폼에 최적화된 맞춤형 llama.cpp 빌드를 포함합니다: Mac에서 Apple Silicon Metal 커널, NVIDIA에서 CUDA + cuBLAS, AMD에서 ROCm. Jan과 GPT4All은 플랫폼 특화 튜닝 없이 원본 소스에서 수정되지 않은 llama.cpp를 사용합니다. 차이는 M 칩 Mac에서 더 크고(15~30%), CPU 전용 시스템에서 더 작습니다(5~10%).
📌참고: 메모리 대역폭 한계에 도달하면 속도 차이가 사라집니다. 8B 모델이 완전히 포화된 상태에서 세 앱은 서로 ~5% 이내로 수렴합니다.
어떤 앱의 첫 사용 경험이 가장 쉽습니까?
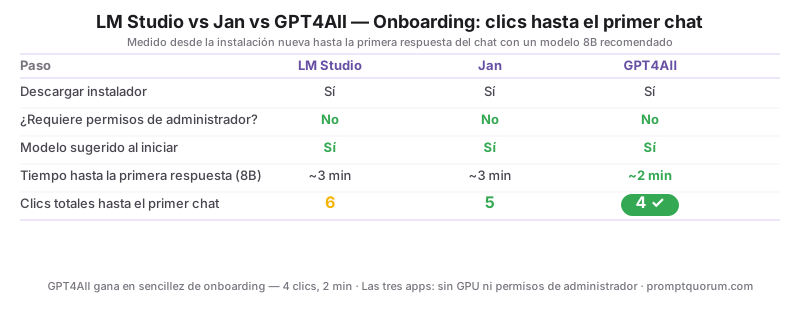
추천 모델과 함께 "새 설치"에서 "첫 번째 채팅 응답"까지의 클릭 수 측정.
단계 | |||
|---|---|---|---|
| 1. 설치 프로그램 다운로드 | 예 | 예 | 예 |
| 2. 설치 프로그램 실행(관리자 권한 필요?) | 아니요 | 아니요 | 아니요 |
| 3. 시작 시 모델 추천 | 예 | 예 | 예 |
| 4. 첫 번째 응답까지 시간(8B 모델) | ~3분 | ~3분 | ~2분 |
| 5. 첫 번째 채팅까지 총 클릭 수 | 6 | 5 | 4 |
각 앱의 모델 라이브러리 깊이
세 앱 모두 디스크에서 GGUF 파일을 로드할 수 있습니다. 차이는 내장 브라우저에서 표시하는 내용에 있습니다.
- LM Studio — 내장 브라우저가 HuggingFace에 실시간으로 연결됩니다. VRAM, 라이선스, 계열, 양자화로 필터링합니다. ~5,000개의 모델 변형을 표시합니다.
- Jan — ~150개 모델의 선별된 카탈로그, 나머지는 "HuggingFace URL" 가져오기. 초보자에게 덜 부담스럽습니다.
- GPT4All — ~30개의 인기 모델 큐레이션 카탈로그. 나머지는 수동 GGUF 가져오기. 가장 작은 브라우저.
- 세 앱 모두 드래그 앤 드롭 또는 "가져오기"를 통해 사용자 지정 GGUF 파일을 로드하므로 내장 브라우저가 작아도 어떤 모델이든 접근할 수 있습니다.
이 앱들은 데이터를 어디로 보냅니까?
개인정보 보호에서는 Jan이 선두입니다. 각 앱은 텔레메트리를 다르게 처리합니다:
- LM Studio — 개인정보 처리방침상 텔레메트리와 사용자별 추적이 없습니다. 업데이트 확인 시 앱 버전, OS, IP 주소가, 모델 검색·다운로드 시 익명화된 검색어가 전송됩니다. 채팅과 문서는 기기에 남습니다.
- Jan — 기본적으로 텔레메트리 없음. 분석 SDK 없음. GitHub에서 소스 코드 감사 가능(Apache 2.0).
- GPT4All — 텔레메트리는 opt-in(기본 비활성화). GitHub에서 소스 코드(MIT).
- 세 앱 모두 프롬프트, 대화, 로드된 모델 파일을 어디로도 보내지 않습니다 — 로컬 추론은 모든 경우에 로컬입니다.
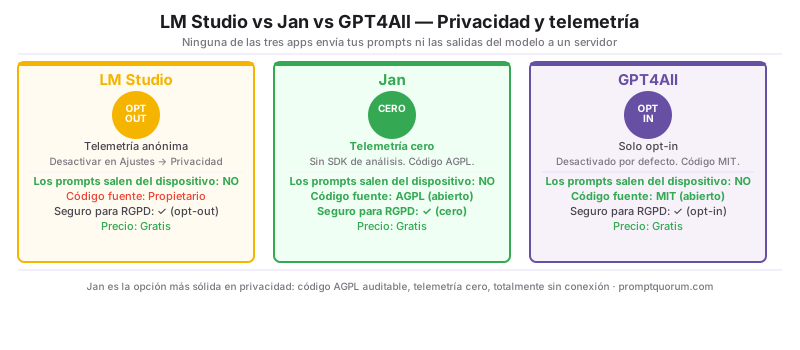
💡팁: 개인정보 보호법(PIPC) 민감 배포(기업, 의료/법률 분야)의 경우 Jan을 선택하고 Apache 2.0 코드를 검증하십시오. 인터넷 없는 기업 환경에서 세 앱 모두 설치 후 오프라인으로 작동합니다.
지원하는 운영 체제
2026년에 어떤 것을 먼저 설치합니까?
대부분의 사용자는 LM Studio로 시작해야 합니다. 첫 번째 시작 이후 가장 완만한 학습 곡선, 가장 큰 모델 라이브러리, 가장 일반적인 하드웨어(M 칩 Mac과 RTX GPU)에서 가장 빠른 추론을 제공합니다. 첫 번째 채팅까지 6번의 클릭은 GPT4All보다 하나 더 많지만 장기적인 경험이 눈에 띄게 풍부합니다.
- 특별한 이유가 없다면 LM Studio를 선택하십시오 — 80%의 사용자에게 기본 추천입니다.
- 오픈소스 코드, 텔레메트리 없음, 또는 일상 사용에 더 깔끔한 UI가 특별히 필요하다면 Jan을 선택하십시오.
- 하드웨어가 제한적이라면(RAM 8 GB, GPU 없음) GPT4All을 선택하십시오 — 저사양 시스템에 가장 관대합니다.
- 세 가지를 병렬로 설치할 수 있습니다. GGUF 모델 파일을 공유하므로 여러 앱을 시도하는 디스크 비용은 작습니다.
⚠️경고: 유지 관리 상태(2026년 8월): GPT4All의 최신 릴리스는 2025년 2월 25일의 v3.10.0으로, 약 18개월간 새 빌드가 없습니다. 설치도 되고 저사양 하드웨어에서 실행도 되므로 이 글에서는 자리를 유지하지만, 기본 제공 모델 카탈로그는 그 빌드 이후 갱신되지 않았고(Gemma 4 E2B 같은 최신 모델이 없습니다) 앱 자체도 보안 패치를 받지 못합니다. 유지 관리되는 GUI가 필요하면 Jan을 선택하고, GPT4All은 남은 장점이 해당될 때만 사용하십시오 — 4GB RAM 한계, 또는 관리자 권한이 없는 잠긴 기기.
자주 묻는 질문
LM Studio, Jan, GPT4All은 무료입니까?
세 앱 모두 개인 및 상업적 사용에 100% 무료입니다. Jan과 GPT4All은 오픈소스(각각 Apache 2.0, MIT)이고 LM Studio는 무료이지만 독점입니다.
이 앱들은 완전히 오프라인으로 작동합니까?
예. 앱을 설치하고 최소 하나의 모델을 다운로드한 후 세 앱 모두 인터넷 연결 없이 작동합니다. 모델은 완전히 기기에서 실행됩니다.
LM Studio, Jan, GPT4All 간에 GGUF 모델 파일을 공유할 수 있습니까?
예. 세 앱 모두 표준 GGUF 파일을 로드합니다. 각 앱은 기본적으로 자체 폴더에 모델을 저장하지만, 모두 공유 폴더를 가리키도록 설정하여 중복 다운로드를 방지할 수 있습니다.
PDF와 채팅하기에 가장 좋은 앱은 무엇입니까?
2026년에는 LM Studio에 가장 완전한 통합 문서 채팅 기능이 있습니다. Jan은 확장을 통해 제공합니다. GPT4All은 서드파티 플러그인이나 AnythingLLM 같은 별도 도구가 필요합니다.
이 앱들을 사용하려면 NVIDIA GPU가 필요합니까?
아닙니다. 세 앱 모두 CPU 전용, Apple Silicon Mac, AMD GPU, NVIDIA GPU에서 작동합니다. CPU 전용 추론은 더 느리지만(최신 프로세서에서 8~15 tok/s) Phi-4 Mini 같은 소형 모델로 채팅에 충분히 사용 가능합니다.
LM Studio가 오픈소스가 아닌데 안전합니까?
LM Studio는 비공개 소스라 코드로 검증할 수 없으며, 개인정보 처리방침상 텔레메트리와 사용자별 추적은 없습니다. 소스 코드의 완전한 투명성이 필수인 경우(일부 개인정보 보호법 관련 맥락) 대신 Jan을 선택하십시오.
이 앱들을 코드용 OpenAI 호환 API 서버로 사용할 수 있습니까?
예. 세 앱 모두 localhost에서 HTTP OpenAI 호환 API를 노출합니다. LM Studio와 Jan에는 원클릭 "서버 시작" 버튼이 있고 GPT4All에는 설정의 스위치가 있습니다. Continue.dev, Cline 또는 사용자 지정 Python 스크립트를 연결하는 데 유용합니다.
디스크 공간이 얼마나 필요합니까?
앱 자체는 290~450 MB입니다. 각 모델은 크기와 양자화에 따라 2~15 GB입니다. 실용적인 시작 설정은 20~30 GB의 여유 디스크 공간 — 앱과 비교할 2~3개 모델에 충분합니다.
2026년에 어떤 앱이 더 자주 업데이트됩니까?
LM Studio는 약 2~3주마다 업데이트를 출시합니다. Jan은 매월, GPT4All은 4~6주마다. 세 앱 모두 원본 llama.cpp 프로젝트에서 출시된 후 며칠 안에 새 모델 아키텍처를 추가합니다.
세 가지 모두 설치해야 합니까?
연구나 비교를 위해서라면 예 — GGUF 파일을 공유하므로 디스크 비용은 기본적으로 앱 바이너리로 제한됩니다. 일상적인 사용에서는 하나를 선택하고 유지하십시오. 워크플로 중간에 앱을 변경하면 프롬프트 기록과 채팅 스레드가 중단됩니다.