핵심 요점
- Qwen3 8B와 14B는 소비자용 GPU 목표 — VRAM 각각 약 6 GB, 16 GB, Docker에서 Ollama로 실행 가능
- Qwen3 32B는 RTX 4090 24 GB가 필요하며, 대부분의 팀에서 단일 카드 프로덕션 배포 최대 규모입니다
- Qwen2.5-72B는 RTX 4090 두 장, 대용량 RAM(128 GB 이상 DDR5)의 CPU 빌드, 또는 클라우드 대여가 필요합니다 — self-hosting 비용은 감가상각 기준 하루 약 $0.05~0.12
- Ollama + Open WebUI + Nginx로 구성된 Docker Compose 스택은 10분 이내에 OpenAI 호환 API를 노출합니다
- Qwen 상시 가동 서버: Minisforum UM890 Pro ($429, Qwen3 8B CPU 실행) 또는 AOOSTAR GEM12 Pro OCuLink + RTX 4060 Ti 16 GB (총 약 $800)
- 클라우드 대안: RunPod A40 48 GB ($0.44/시간)으로 Qwen2.5-72B 처리 가능 — RTX 4090 두 장 구매보다 비정기 사용 시 저렴
- 이 가이드는 프로덕션 배포를 다루며, Ollama 기초 설정은 Qwen 입문 가이드를 참조하십시오
📍 한 문장으로
Docker Compose 스택으로 Qwen을 프로덕션에 배포하면 Ollama가 추론 백엔드로 동작하며 OpenAI 호환 API 엔드포인트가 노출됩니다.
💬 쉽게 말하면
매번 수동으로 Qwen을 실행하는 대신, Docker를 사용하면 항상 켜져 있고 요청을 받을 수 있는 영구 서버를 구성할 수 있습니다 — ChatGPT API를 사용하는 것과 동일하지만 자신의 하드웨어에서 토큰 비용 없이 운영됩니다.
Qwen 모델별 하드웨어 성능
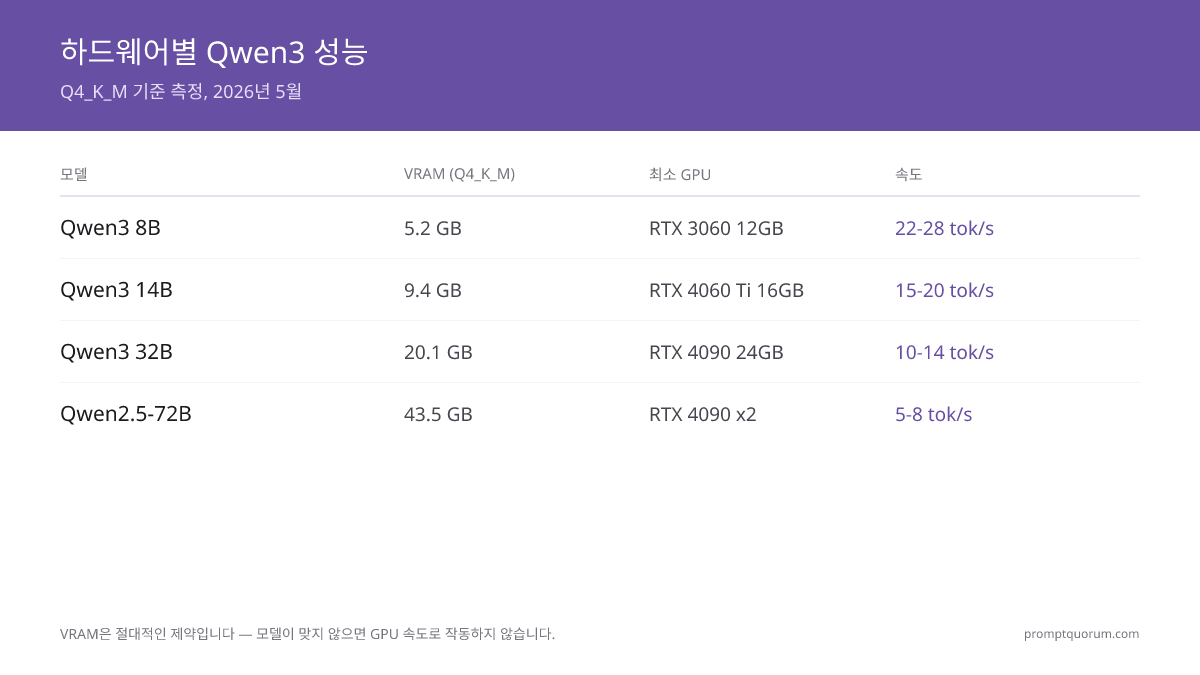
GPU 브랜드가 아니라 모델 크기에 맞는 하드웨어를 선택하십시오. VRAM이 주요 제약입니다. 모델이 맞지 않으면 GPU 속도로 실행되지 않습니다. 아래 표는 Ollama 배포에 최적 품질-크기 비율인 Q4_K_M 양자화로 측정한 추론 속도를 나타냅니다.
모델 | VRAM (Q4_K_M) | 최소 GPU | 속도 (tok/s) | CPU 대체 | 프로덕션 준비 |
|---|---|---|---|---|---|
| Qwen3 8B | 5.2 GB | RTX 3060 12 GB | 22–28 tok/s | 가능 (RAM 32 GB, 약 4 tok/s) | 가능 — 단일 GPU |
| Qwen3 14B | 9.4 GB | RTX 4060 Ti 16 GB | 15–20 tok/s | 가능 (RAM 64 GB, 약 2.5 tok/s) | 가능 — 단일 GPU |
| Qwen3 32B | 20.1 GB | RTX 4090 24 GB | 10–14 tok/s | 제한적 (RAM 128 GB, 약 1.2 tok/s) | 가능 — 단일 GPU |
| Qwen3-Coder 32B | 19.8 GB | RTX 4090 24 GB | 10–13 tok/s | 제한적 (RAM 128 GB) | 가능 — 단일 GPU |
| Qwen2.5-72B | 43.5 GB | RTX 4090 두 장 (합계 48 GB) | 5–8 tok/s | 느림 (RAM 128 GB, 약 0.6 tok/s) | Multi-GPU 또는 클라우드만 가능 |
PCIe Gen 4 시스템 측정 기준. NVLink는 지원 카드의 듀얼 GPU 구성에서 성능을 약 15% 향상시킵니다. RunPod A100 80 GB 단일 카드에서 Qwen2.5-72B Q4_K_M: 18–22 tok/s.

Docker API 서버 설정 — Ollama + Open WebUI + Nginx
가장 빠른 Qwen 프로덕션 스택은 세 가지 컨테이너로 구성됩니다: Ollama(추론), Open WebUI(UI), Nginx(리버스 프록시 + 인증). 이 설정은 10분 이내에 완료되며 `your-server:11434/v1`에 영구적인 OpenAI 호환 API를 노출합니다.
- 1Docker 및 Docker Compose를 설치합니다
Why it matters: 컨테이너는 Qwen을 운영 체제와 격리합니다 — Python 환경 충돌 없음, 업데이트 용이. - 2Ollama + Open WebUI 서비스가 포함된 docker-compose.yml을 생성합니다
Why it matters: Compose 파일은 GPU 패스스루, 포트 매핑, 재시작 정책을 한 곳에서 관리합니다. - 3Ollama 컨테이너 환경에서 OLLAMA_HOST=0.0.0.0을 설정합니다
Why it matters: 이 설정 없이는 Ollama가 localhost에서만 수신하며 다른 컨테이너나 호스트의 API 요청을 받지 않습니다. - 4Qwen 모델을 다운로드합니다: docker exec ollama ollama pull qwen3:8b
Why it matters: 모델은 Docker 볼륨에 저장되어 컨테이너 재시작 시에도 유지됩니다. - 5공개 배포를 위해 기본 인증이 포함된 Nginx를 API 게이트웨이로 추가합니다
Why it matters: 인증 없이 Ollama를 인터넷에 직접 노출하면 누구나 귀하의 GPU에서 추론을 실행할 수 있습니다. - 6컨테이너 재시작 정책을 unless-stopped로 설정합니다
Why it matters: 이를 통해 Qwen 서버가 시스템 재시작 후에도 유지됩니다 — 상시 가동 mini PC 배포에 필수적입니다.
version: "3.8"
services:
  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    restart: unless-stopped
    ports:
      - "11434:11434"
    environment:
      - OLLAMA_HOST=0.0.0.0
      - OLLAMA_KEEP_ALIVE=-1
    volumes:
      - ollama_data:/root/.ollama
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: open-webui
    restart: unless-stopped
    ports:
      - "3000:8080"
    environment:
      - OLLAMA_BASE_URL=http://ollama:11434
    volumes:
      - open_webui_data:/app/backend/data
    depends_on:
      - ollama

volumes:
  ollama_data:
  open_webui_data:
Qwen2.5-72B를 위한 Multi-GPU 구성
Q4_K_M의 Qwen2.5-72B는 VRAM 43.5 GB가 필요합니다 — RTX 4090(24 GB) 한 장으로는 부족합니다. RTX 4090 두 장(합계 48 GB) 또는 전문가용 카드(A100 80 GB, H100 80 GB)가 필요합니다. Ollama는 Multi-GPU 분산을 네이티브로 처리하며 코드 변경이 필요 없습니다.
- Ollama는 사용 가능한 모든 GPU에 자동으로 모델을 분산합니다 — compose 환경에서 CUDA_VISIBLE_DEVICES=0,1로 특정 카드를 지정하십시오
- RTX 4090 두 장의 경우, 두 카드 모두 동일한 PCIe 대역폭 레벨에 있어야 합니다 — PCIe Gen 4 x8 슬롯 두 개가 있는 B650 또는 Z790 메인보드가 최소 요구사항입니다
- RTX 4090 두 장 간의 NVLink는 소비자 카드에서 NVIDIA 공식 지원이 없지만, Founders Edition RTX 4090 쌍에서 서드파티 NVLink 브리지를 통해 작동합니다 — 약 15% 성능 향상
- vLLM은 텐서 병렬성을 사용하는 대체 추론 엔진으로, Multi-GPU 활용 효율이 더 높습니다 — 동시 요청 100개 이상의 지속 70B 추론 부하에서는 Ollama 대신 vLLM을 사용하십시오
- Qwen2.5-72B를 비정기적으로 사용하는 경우, RunPod A40 48 GB($0.44/시간)가 RTX 4090 두 장 빌드($3,800+)보다 저렴합니다
# vLLM multi-GPU alternative (better for high-traffic 72B)
docker run --gpus all   -p 8000:8000   -e VLLM_WORKER_MULTIPROC_METHOD=spawn   vllm/vllm-openai:latest   --model Qwen/Qwen2.5-72B-Instruct   --tensor-parallel-size 2   --max-model-len 32768   --quantization awq
프로덕션 API 설정
Ollama의 API는 /v1에서 OpenAI와 호환됩니다 — ChatGPT API를 호출하는 모든 애플리케이션은 기본 URL만 변경하면 로컬 Qwen 배포에서 바로 동작합니다. 프로덕션 동작에 영향을 미치는 주요 환경 변수:
- OLLAMA_KEEP_ALIVE=-1 — 비활성 후 모델이 언로드되지 않도록 합니다 (기본값은 5분으로, 서버 배포에서는 치명적)
- OLLAMA_NUM_PARALLEL=4 — 최대 4개의 동시 추론 요청을 허용합니다. VRAM 여유가 있다면 늘리십시오
- OLLAMA_MAX_LOADED_MODELS=1 — 소형 GPU 빌드에서 스래싱 방지를 위해 VRAM에 모델 하나만 유지합니다
- OLLAMA_FLASH_ATTENTION=1 — NVIDIA Ampere/Ada GPU(RTX 3060 이상)에서 flash attention을 활성화하여 20–30% 속도 향상
- OLLAMA_GPU_OVERHEAD=512 — OS 및 드라이버 오버헤드를 위해 VRAM 512 MB를 예약합니다. 정확히 8 GB 또는 16 GB 카드에서 OOM 크래시를 줄여줍니다
⚠️경고: OLLAMA_KEEP_ALIVE=0이거나 설정하지 않으면 각 요청 후 모델이 언로드됩니다. 일시 중지 후 첫 번째 요청은 모델 재로딩에 10–30초가 소요됩니다. API 서버 배포에서는 항상 OLLAMA_KEEP_ALIVE=-1을 설정하십시오.
비용 비교: self-hosted vs Alibaba Cloud vs RunPod
하루 4시간 이상의 지속적인 추론 부하에서는 self-hosting이 클라우드보다 유리합니다. 하루 4시간 미만에서는 하드웨어 감가상각 후 클라우드 GPU 대여가 더 저렴합니다. 아래 표는 self-hosted 빌드에 3년 하드웨어 감가상각을 적용합니다.
옵션 | Qwen3 8B 하루 비용 | Qwen2.5-72B 하루 비용 | 초기 비용 | 최적 용도 |
|---|---|---|---|---|
| Self-hosted: mini PC RTX 3060 12 GB | $0.03 (전기료만) | 해당 없음 (용량 부족) | 완전한 빌드 $600–900 | 상시 7B 추론, 가정/사무실 서버 |
| Self-hosted: 워크스테이션 RTX 4090 | $0.05 | 해당 없음 (단일 GPU) | 완전한 빌드 $2,500–4,000 | 최대 32B 추론, 워크스테이션 전용 사용 |
| Self-hosted: RTX 4090 두 장 | $0.08 | $0.12 | 완전한 빌드 $5,000–7,000 | 72B 상시 가동, 워크스테이션 병행 사용 |
| RunPod A40 48 GB ($0.44/시간) | $0.44 (1시간) | $0.44 (1시간) | 초기 비용 $0, 시간제 지불 | 비정기 72B 사용, 테스트, 하드웨어 투자 없음 |
| Alibaba Cloud PAI (GPU A10) | $0.50–0.80/시간 | $1.20–2.00/시간 (A100) | 초기 비용 $0 + 신규 계정 크레딧 $50 | Qwen 최적화 추론 환경, Alibaba Cloud 생태계 |
| Vast.ai RTX 4090 스팟 ($0.20–0.35/시간) | $0.20–0.35/시간 | 해당 없음 | 초기 비용 $0 | 저렴한 비정기 사용, 중단 위험 허용 가능 |
Qwen 상시 가동 서버 하드웨어 추천
API 서버로 Qwen3 8B를 24/7 실행하는 mini PC는 전기료가 월 $0.50–1.50 — 어떤 클라우드 대안보다 훨씬 저렴합니다. 두 가지 mini PC 빌드가 대부분의 Qwen 상시 가동 사용 사례를 커버합니다:
- 저렴한 옵션 (Qwen3 8B CPU 추론): Minisforum UM890 Pro — AMD Ryzen 9 8945HS, 32 GB DDR5, 512 GB NVMe. 신품 약 $429. Qwen3 8B는 Ollama CPU 백엔드로 3–5 tok/s 실행. 개인 어시스턴트 및 문서 요약에 적합. 유휴 시 12W, 부하 시 45W. 매우 조용함. 미국/EU 창고에서 배송 가능.
- 추천 옵션 (GPU Qwen3 14B): AOOSTAR GEM12 Pro OCuLink — OCuLink 포트를 통해 외부 GPU 지원. eGPU 인클로저의 RTX 4060 Ti 16 GB와 결합 (GPU 약 $340 + 인클로저 $100). 총 약 $800. Qwen3 14B를 16–18 tok/s로 실행. 인터랙티브 사용 시 CPU 대체보다 현저히 우수.
- 고급 사용자 (Qwen3 32B): RTX 4090이 장착된 컴팩트 ATX 데스크톱 PC — 예시: Fractal Node 804 케이스 ($90), RTX 4090 (현재 가격 약 $1,900), Ryzen 9 7950X (약 $600), DDR5 64 GB (약 $180). 총 약 $2,800. Qwen3 32B를 무기한 10–14 tok/s로 실행.
판정: 모델 크기별 배포 방법 선택
하드웨어의 인상적인 사양이 아니라 모델 크기와 하루 사용 시간에 따라 Qwen 배포 방식을 선택하십시오.
Qwen 배포 결정
다음의 경우 로컬 LLM을 사용하십시오:
- •Qwen3 8B 또는 14B를 하루 4시간 이상 사용 → mini PC 또는 GPU 구매 권장; 클라우드가 더 비쌈
- •인터랙티브 코드 또는 문서 워크플로에서 지연 시간 80ms 미만 필요
- •네트워크 외부로 나가서는 안 되는 개인 데이터 처리
- •이미 12 GB 이상 VRAM의 데스크톱 GPU를 유휴 상태로 보유
다음의 경우 클라우드 모델을 사용하십시오:
- •Qwen2.5-72B 비정기 사용 (하루 4시간 미만) — RunPod A40 48 GB $0.44/시간이 듀얼 GPU 빌드보다 훨씬 저렴
- •하드웨어 구매 전 Qwen2.5-72B를 테스트해야 하는 경우
- •사용 패턴이 불규칙하고 예측 불가능 — 클라우드는 미사용 시 비용이 0으로 줄어듦
- •미국/EU 외 지역에 있고 배송비 또는 수입 관세로 하드웨어 비용이 증가하는 경우
빠른 결정:
- →매일 Qwen3 8B: Minisforum UM890 Pro ($429)
- →매일 Qwen3 14B: AOOSTAR + RTX 4060 Ti (약 $800)
- →매일 Qwen3 32B: 컴팩트 ATX + RTX 4090 (약 $2,800)
- →비정기 Qwen2.5-72B: RunPod A40 48 GB ($0.44/시간)

관련 가이드
- Ollama 기초 Qwen 설정 (입문): /ko/power-local-llm/run-qwen-locally-guide-2026
- 로컬 LLM용 GPU 구매 가이드: /ko/power-local-llm/best-gpu-buying-guide-local-llm-2026
- 모델 파일용 NAS 스토리지: /ko/power-local-llm/best-nas-storage-local-ai-models-2026
- 클라우드 GPU 비교 (서구 공급업체): /ko/power-local-llm/cloud-gpu-rental-guide-2026
자주 묻는 질문
Qwen 3.8 모델이 있습니까?
아니요 — "Qwen 3.8"은 실제 출시된 버전이 아닙니다. Qwen3-8B(ollama pull qwen3:8b, 80억 파라미터) 또는 Qwen 3.6(ollama pull qwen3.6:27b, Qwen3 32B와 동일한 VRAM 등급이며 코딩 성능이 더 강화된 알리바바의 최신 릴리스)을 찾으시는 것일 가능성이 높습니다. 알리바바의 버전 체계는 Qwen3(0.6B~32B의 dense 크기)와 별도의 Qwen 3.6 포인트 릴리스로 구성되며, 두 라인 어디에도 "3.8"은 존재하지 않습니다.
Qwen3 8B 모델이 있습니까?
없습니다. Qwen3 dense 라인업은 0.6B, 1.7B, 4B, 8B, 14B, 32B이며 7B는 없습니다. "Qwen3 8B"를 검색했다면 가장 가까운 모델은 Qwen3-8B(ollama pull qwen3:8b)이며, Q4_K_M에서 VRAM 약 5~6 GB에 맞고 RTX 3060 12 GB에서 약 25 tok/s로 동작합니다. 72B급 모델이 필요하면 Qwen2.5-72B를 사용하세요.
RTX 4090 한 장으로 Qwen2.5-72B를 실행할 수 있습니까?
아니요. Q4_K_M 양자화의 Qwen2.5-72B는 VRAM 43.5 GB가 필요합니다. RTX 4090은 24 GB입니다. RTX 4090 두 장(합계 48 GB), A100 80 GB, 또는 클라우드 GPU 대여가 필요합니다. RTX 4090 한 장으로는 Q4_K_M의 Qwen3 32B(20.1 GB)를 여유 있게 실행할 수 있습니다.
프로덕션 Qwen 배포에서 Ollama와 vLLM의 차이점은 무엇입니까?
Ollama는 설정이 쉽고 Multi-GPU 분산을 자동으로 처리합니다 — 개인 서버 및 동시 사용자 20명 미만의 팀에 최적입니다. vLLM은 텐서 병렬성과 연속 배칭을 사용하여 동시 부하에서 2–4배 효율적 — 시간당 100개 이상의 요청이나 다수 사용자를 위한 프로덕션 API에 최적입니다.
Ollama는 Qwen의 Multi-GPU 추론을 네이티브로 지원합니까?
예, Ollama 0.3.0(2025)부터 지원합니다. CUDA_VISIBLE_DEVICES=0,1로 사용할 GPU를 지정하십시오. Ollama가 자동으로 모델을 분산합니다. RTX 4090 두 장의 Qwen2.5-72B에서 5–8 tok/s를 예상하십시오 — 소비자 구성에서는 NVLink 대신 PCIe를 통해 모델이 분산되므로 A100 80 GB 단일 카드보다 느립니다.
Qwen 추론에서 Alibaba Cloud가 RunPod보다 저렴합니까?
Alibaba Cloud PAI는 GPU 등급 및 지역에 따라 시간당 $0.50–2.00입니다. RunPod A40 48 GB는 시간당 $0.44입니다. Alibaba Cloud는 일반 Ollama보다 20–30% 빠를 수 있는 Qwen 사전 구성 추론 환경을 제공합니다 — 이미 Alibaba Cloud 생태계를 사용하고 있다면 시도해볼 만합니다. 순수 비용 측면에서는 RunPod 스팟 인스턴스가 더 저렴합니다.
상시 가동 Qwen 서버는 전기를 얼마나 사용합니까?
CPU로 Qwen3 8B를 실행하는 Minisforum UM890 Pro는 유휴 시 12W, 부하 시 45W를 소비합니다. 미국 평균 전기요금($0.16/kWh)으로 24/7 운영 비용은 월 약 $0.70–1.80입니다. RTX 4060 Ti 16 GB는 부하 시 165W — 여기에 mini PC 유휴 소비량(약 25W)을 합치면 총 약 190W로, 24/7 최대 부하 기준 월 약 $7–8입니다.
Self-hosted Qwen API를 ChatGPT 호환 애플리케이션과 함께 사용할 수 있습니까?
예. Ollama는 http://your-server:11434/v1에서 OpenAI 호환 API를 노출합니다. 애플리케이션에서 OPENAI_API_BASE=http://your-server:11434/v1 및 OPENAI_API_KEY=any-value를 설정하십시오. OpenAI Chat Completions API를 호출하는 모든 도구 — Continue.dev, Cursor(로컬 모드), LangChain, AutoGen — 는 수정 없이 동작합니다.
업데이트 기록
- 2026-05-26: 최초 게시. 2026년 5월 하드웨어 벤치마크 데이터. Newegg, Amazon 및 GPU 시장 추적기에서 가격 검증.
- 다음 검토 예정: 2026-11-26