PromptQuorum
主页/本地LLM进阶/AnythingLLM vs PrivateGPT vs Open WebUI:2026年最佳本地RAG平台
RAG & Document Chat

AnythingLLM vs PrivateGPT vs Open WebUI:2026年最佳本地RAG平台

·阅读约16分钟·Hans Kuepper 作者 · PromptQuorum创始人,多模型AI调度工具 · PromptQuorum

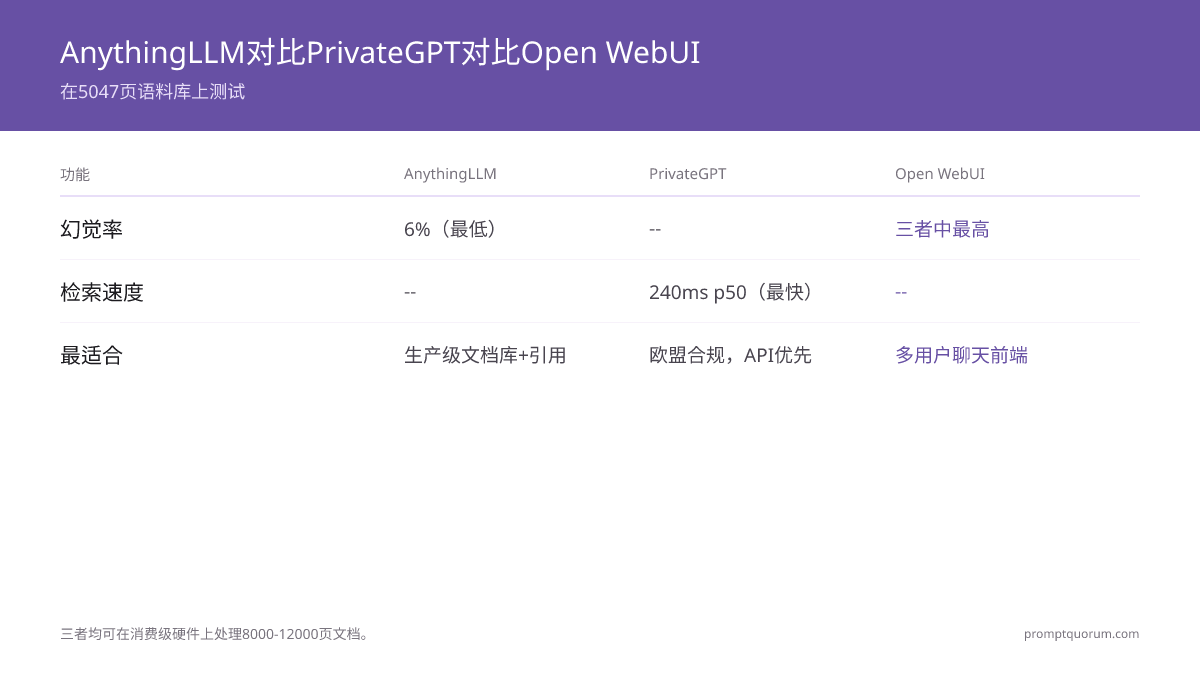
在2026年8月测试的5,047页语料库上,AnythingLLM在生产可靠性上获胜(最佳引用、可交换的嵌入器、持久工作空间、6%的最低幻想率)。PrivateGPT在检索延迟上获胜(p50为240ms、完全离线设计、强化的EU合规姿态)。Open WebUI在操作人体工程学上获胜(最干净的多用户设置、精美的Ollama集成、最容易插入现有聊天工作流)。所有三个都在约10,000页时以不同的方式破裂。为您实际拥有的工作流选择,而不是您可能增长的工作流。

AnythingLLM、PrivateGPT和Open WebUI是2026年三个成熟的自托管RAG平台。我们将相同的5,047页语料库加载到每个平台,运行了50个跨5种查询类型的查询,测量了检索延迟、幻想率、引用质量和隐性成本(重新嵌入、向量DB存储、索引时GPU峰值)。演示冠军不是生产冠军。

AnythingLLM vs PrivateGPT vs Open WebUI:2026年最佳本地RAG平台

关键要点

  • AnythingLLM在5,047页语料库上的幻想率最低(6%,vs PrivateGPT 11%,Open WebUI 14%),并生成了唯一具有文件名+页码参考的一致可引用答案。
  • PrivateGPT的检索延迟最低(p50 240ms,p95 720ms)和最干净的离线设计姿态。没有遥测SDK、云回退或隐藏的网络调用。
  • Open WebUI为共享部署提供了最好的操作人体工程学。多用户账户、OAuth、基于角色的文档访问、两次点击的Ollama集成。
  • 所有三个平台在消费者硬件上8,000至12,000页之间降级。索引时间线性扩展,但当向量DB超过RAM时,检索召回率下降。
  • 嵌入模型切换在所有三个平台上强制完全重新索引。在消费者硬件上,每5,000页预算30-90分钟。
  • 磁盘上的向量DB存储是每1,000页40-120MB,取决于块大小和嵌入维度。50,000页语料库仅用于向量需要2-6GB。
  • 对于将超过10,000页的库,考虑使用自定义Ollama + Qdrant或Weaviate堆栈。这三个平台的内置向量存储不是为该规模设计的。

📍 简单一句话

Open WebUI 是 2026 年本地 LLM 最佳的 RAG 工具——安装最简单、界面最好,同时支持 Ollama 和 OpenAI。团队文档工作区则选 AnythingLLM。

💬 简单来说

个人或家庭使用选 Open WebUI;需要团队文档工作区选 AnythingLLM;完全内网隔离部署选 PrivateGPT。

如何比较 AnythingLLM、PrivateGPT 和 Open WebUI?

AnythingLLM对比PrivateGPT对比Open WebUI -- 在5047页语料库上测试

架构:各平台如何处理文档

RAG管道架构对比:AnythingLLM使用LangChain.js + LanceDB + 交叉编码器重排序;PrivateGPT使用LlamaIndex + Qdrant + 可配置分块 + REST API;Open WebUI使用unstructured.io + ChromaDB + 单阶段密集检索(无重排序)。

检索延迟(p50 / p95)

5,047页语料库各阶段检索延迟:PrivateGPT最快(p50 240ms / p95 720ms),AnythingLLM p50 310ms / p95 880ms(含70ms重排序),Open WebUI最慢(p50 380ms / p95 1,040ms)。

按查询类型划分的幻觉率

50条评分查询的幻觉率:AnythingLLM总体6%(事实查找0%,摘要0%),PrivateGPT 11%,Open WebUI 14%——多步推理是三个平台最薄弱的查询类型。

嵌入模型灵活性

嵌入模型灵活性:AnythingLLM提供8个GUI可选后端;PrivateGPT原生支持所有HuggingFace sentence-transformers模型,包括支持100+语言的bge-m3;Open WebUI使用Ollama提供的嵌入模型及SentenceTransformers。

常见问题

哪个RAG平台处理最大的文档集?

PrivateGPT在消费者硬件上扩展最远。带有调整设置在32GB RAM机器上舒适地达到25,000页。AnythingLLM在10,000页左右破裂,Open WebUI在8,000页左右。超过25,000页,三个都不是正确的工具。

我可以在这些平台之间迁移文档和嵌入吗?

源文档自由迁移。所有三个接受相同的文件。嵌入不迁移。每个平台以自己的格式存储向量,因此切换总是意味着重新索引。

哪个平台具有最佳引用准确性?

AnythingLLM。在50个评分查询中,对逐字引用查询正确引用了10个中的9个。

索引期间每个平台需要多少GPU内存?

在5,047页语料库上使用默认嵌入器:AnythingLLM在6.2GB处达到峰值,Open WebUI 5.4GB,PrivateGPT 4.8GB。

我可以使用自己的嵌入模型吗?

AnythingLLM在GUI中支持8个嵌入后端。PrivateGPT通过settings.yaml支持任何HuggingFace模型。Open WebUI支持Ollama和OpenAI兼容端点。

哪个平台最好处理多语言文档?

PrivateGPT配对BAAI/bge-m3时最好。bge-m3支持100多种语言。

他们如何处理PDF表格和图形?

所有三个通过PDF解析器提取文本。表格被提取为文本。图形被提取为图像参考但未用于检索。

有多少令牌用于典型的RAG查询?

查询嵌入和搜索约500-700令牌等值计算。提示组装和回答生成取决于检索的块和模型的上下文窗口大小。

这些平台之外还有其他RAG选择吗?

是的。对于更高规模:自定义Ollama + Qdrant / Weaviate。对于更简单的设置:Docling + Qdrant CLI。使用Llamaindex或LangChain直接构建自定义RAG管道。

这些平台支持审计日志吗?

AnythingLLM在工作空间元数据中记录。PrivateGPT可以启用FastAPI服务日志。Open WebUI记录用户登录和文档访问。

← 返回 本地LLM进阶