2026年模型加载最快的SSD是?
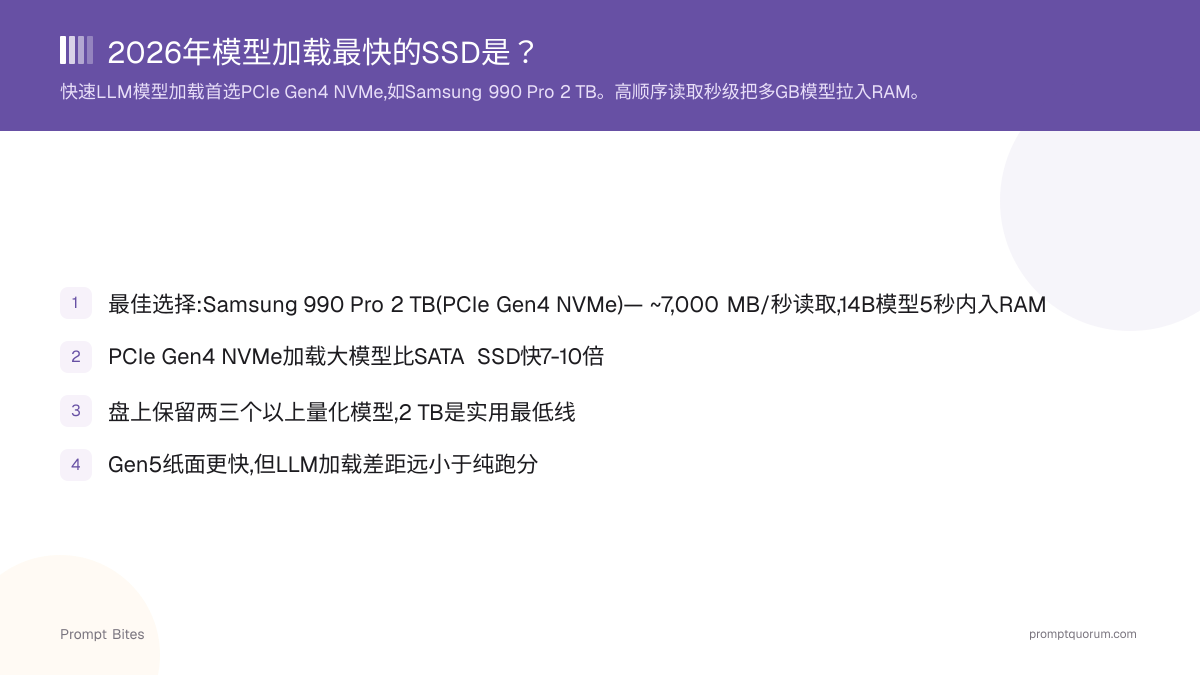
2 TB的PCIe Gen4 NVMe SSD是本地LLM快速加载的最佳选择——Samsung 990 Pro 2TB是首选,WD Black SN850X 2TB是性能几乎相同的替代品。快速NVMe能把启动或切换模型的等待时间从几十秒缩短到几秒。但模型运行后,SSD对每秒生成的token数没有任何影响——这取决于GPU和内存带宽,与硬盘无关。
本页包含指向第三方产品的参考链接。PromptQuorum 未加入任何联盟计划——这些是不产生佣金的普通链接。点击链接和后续步骤由您自行承担责任。这些链接不代表 PromptQuorum 的任何认可或验证。
快速回答
像Samsung 990 Pro这样的2TB PCIe Gen4 NVMe,凭借约7,450 MB/s的额定顺序读取速度,可在约1秒内加载7B模型。WD Black SN850X 2TB性能几乎相同——2026年SSD价格波动很大,选靠谱商家里更便宜的那款即可。
- ▸2TB的Gen4 NVMe加载7B模型约1秒,14B模型仅需数秒 — 比SATA SSD快7-10倍。
- ▸SSD速度只影响加载和切换模型的时间。模型运行后对每秒token数没有影响,那取决于GPU/VRAM。
- ▸将Ollama或LM Studio的模型文件夹放在NVMe上而非系统盘,才能获得完整的加速效果。
关键要点
- ✓最佳选择:Samsung 990 Pro 2 TB(PCIe Gen4 NVMe)。最佳替代:WD Black SN850X 2 TB — 在靠谱商家中选更便宜的那款
- ✓本页最重要的一点:更快的SSD加速的是模型加载和切换,不是文本生成 — 每秒token数取决于GPU和内存带宽,与存储无关
- ✓盘上保留两三个以上量化模型,2 TB是实用最低线
- ✓不要仅为了LLM加载而买Gen5硬盘 — 相比Gen4的实际收益比参数表数字暗示的要小,除非价格已经和Gen4持平
最佳选择:Samsung 990 Pro 2 TB(PCIe Gen4 NVMe)
Samsung 990 Pro 2 TB是LLM快速模型加载的最佳SSD:其额定顺序读取约7,450 MB/秒,可把14B Q4模型(~9 GB)在数秒内拉入RAM。相比之下,SATA SSD(~550 MB/秒)同样模型需要15秒以上,机械硬盘则超过1分钟。
如果比价时Samsung明显更贵,改买WD Black SN850X 2 TB即可——两者都是PCIe Gen4硬盘,在这项任务上实际性能几乎相同。PCIe Gen4 NVMe是大多数装机的甜点。如果主板有PCIe 5.0 M.2插槽(Intel 700系列、AMD X670E/B650E或更新平台),且Samsung 9100 Pro这类Gen5硬盘价格与Gen4持平或更低——2026年SSD价格剧烈波动,这种情况反复出现——那么选Gen5也没问题。但不要仅为了LLM加载换主板去上Gen5:相比Gen4的实际加载时间收益,比顺序读取参数暗示的要小。
买2 TB或更大。攒一组量化模型(7B、8B、13B、14B多档量化)后,1 TB很快就满。2 TB留出OS、框架与十几个模型的空间,不用反复删除重下。如果你维护更大的模型库,请参见下方NAS与存储指南,了解4TB以上和网络存储方案。
SSD速度与推理速度的区别:实际改变的是什么
模型一旦加载进RAM或VRAM,SSD基本上就和每秒token数无关了。更快的SSD能加速三件事:模型首次启动、模型之间切换、以及模型文件的复制或下载。
它不会加速文本生成、GPU推理或每秒token数——这些取决于GPU、VRAM和内存带宽。买更快的SSD却期待生成变快,是这个话题上最常见的误解。如果你追求的是更高的每秒token数,该买的是GPU,而不是存储设备。
📍 简单一句话
更快的SSD能加速本地LLM的加载与切换,但模型一旦加载进RAM或VRAM,它对每秒token数没有任何影响。
💬 简单来说
SSD就像把模型送到电脑工作内存的运输车——一旦送达,车速就不再重要了。之后模型"思考"的快慢,取决于GPU和内存带宽。
LLM加载SSD类型对比
对模型加载而言,唯一重要的参数是顺序读取速度。下表是根据各硬盘额定顺序读取速度计算出的、14B Q4模型(~9 GB)从盘到RAM的大致加载时间——并非实验室实测,实际时间会因系统开销而变化,但排名关系成立。
| 类型 | 顺序读取 | 9 GB模型加载 | 评价 |
|---|---|---|---|
| PCIe Gen5 NVMe (如Samsung 9100 Pro) | ~13,000-14,700 MB/秒 | ~1-2秒 | 主板支持Gen5且价格接近Gen4时值得选 |
| PCIe Gen4 NVMe (如Samsung 990 Pro) | ~7,000 MB/秒 | ~2-4秒 | 多数装机的最佳选择 |
| PCIe Gen3 NVMe | ~3,500 MB/秒 | ~3-7秒 | 可接受 |
| SATA SSD | ~550 MB/秒 | ~15-25秒 | 明显偏慢 — 建议升级 |
| HDD (7200 RPM) | ~150 MB/秒 | ~60-90秒 | LLM避用 |
延伸阅读
- ▸600美元以下本地LLM最佳GPU — 高速SSD与对的GPU搭配
- ▸本地LLM最佳迷你PC — 许多迷你PC附带较慢的SSD
- ▸7B模型需要多少RAM? — 推理速度RAM比SSD更重要
- ▸本地AI模型最佳NAS与存储方案 — 适合4TB以上及多模型库
本地LLM SSD问答
更快的SSD能让推理更快吗?▾
LLM场景PCIe Gen5比Gen4值吗?▾
为什么2026年SSD价格变动这么频繁?▾
本地LLM需要多大SSD?▾
系统盘必须是同一SSD吗?▾
想了解完整详情?
阅读完整指南 →相关 Prompt Bites