النقاط الرئيسية
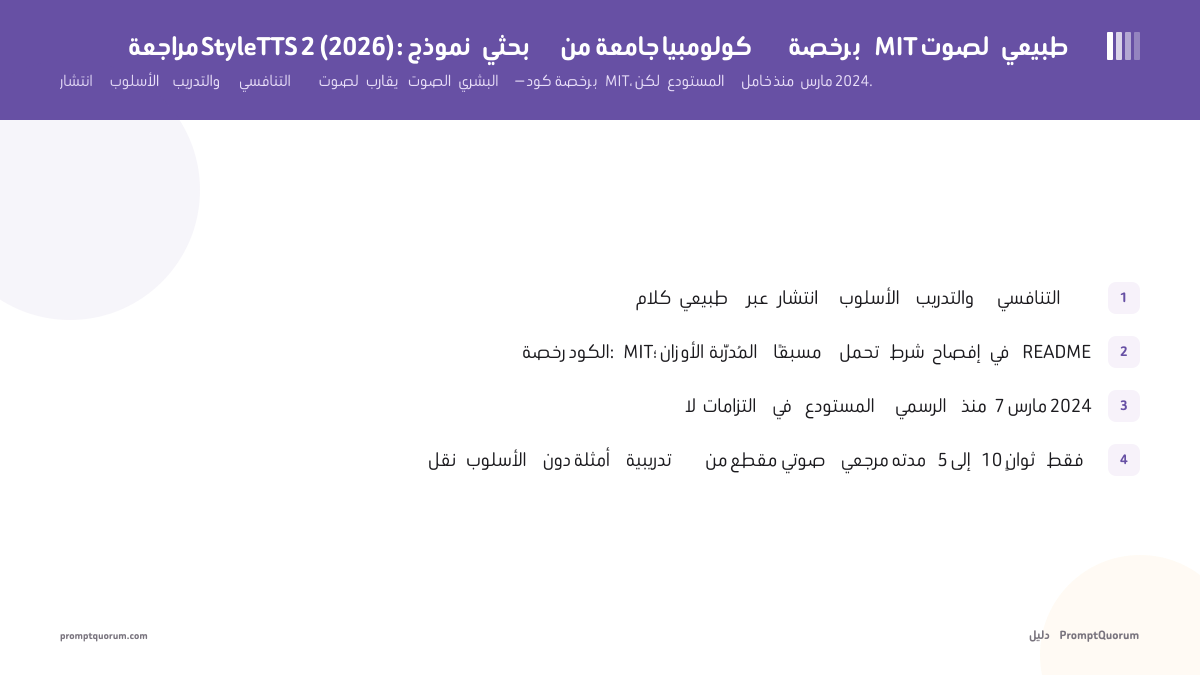
- يُولّد كلامًا يبدو طبيعيًا عبر انتشار الأسلوب والتدريب التنافسي، معادلًا أو متفوقًا على التسجيلات البشرية في معايير قياسية لمتحدث واحد وفقًا لورقته البحثية في NeurIPS.
- رخصة الكود: MIT. تحمل أوزان النموذج المُدرَّب مسبقًا شرط إفصاح منفصلًا في README، وغير مُدوَّن في نص رخصة MIT.
- نقل أسلوب بدون أمثلة سابقة من مقطع مرجعي مدته 5 إلى 10 ثوانٍ عبر نقطة التحقق متعددة المتحدثين من LibriTTS (يُنصح بـ15 إلى 30 ثانية).
- يحتاج الاستدلال الرسمي إلى espeak-ng المرخّصة بموجب GPL-3.0؛ تتجنب حزمة pip من المجتمع ذلك لكن أحدث إصدار لها في 11 يناير 2024.
- لا توجد التزامات في المستودع الرسمي منذ 7 مارس 2024؛ غير مؤرشف، وله أكثر من 6,300 نجمة على GitHub.
- نقاط التحقق المُدرَّبة مسبقًا هي بالإنجليزية بشكل أساسي؛ كما جرى تدريب محاذي النص على مجموعات بيانات يابانية وصينية ويُقال إنه يعمم بشكل معقول على لغات أخرى دون ضبط دقيق.
📍 في جملة واحدة
StyleTTS 2 هو نموذج بحثي من جامعة كولومبيا برخصة MIT لتحويل النص إلى كلام، يُنتج كلامًا يبدو طبيعيًا عبر انتشار الأسلوب والتدريب التنافسي، مع شرط إفصاح على مستوى التوثيق يخص أوزانه المُدرَّبة مسبقًا، ودون أي التزامات على GitHub منذ 7 مارس 2024.
💬 بعبارات بسيطة
إنه نموذج ذكاء اصطناعي مجاني وقابل للتنزيل يحوّل النص إلى كلام يبدو طبيعيًا جدًا، أنشأه باحثون جامعيون وليس شركة — استخدامه التجاري مجاني بحسب رخصة الكود، لكن تعليماته الخاصة تطلب منك إخبار المستمعين بأن الكلام مُصنَّع، ولا يبدو أن أحدًا يُصلح الأخطاء فيه بنشاط بعد الآن.
📌ملاحظة: أشارت مشكلة (issue) على GitHub تخص المشروع (#37) إلى أن متطلب الإفصاح في README الخاص بالنماذج المُدرَّبة مسبقًا يقع خارج ملف رخصة MIT نفسه، وهو ما يجده بعض القراء مربكًا. اقرأ ملف LICENSE وقسم استخدام النموذج في README بنفسك قبل النشر — راجع قسم الترخيص والتكلفة أدناه.
التاريخ: مشروع بحثي من كولومبيا
أنشأ StyleTTS 2 باحثون في قسم الهندسة الكهربائية بجامعة كولومبيا — Yinghao Aaron Li وCong Han وVinay S. Raghavan وGavin Mischler وNima Mesgarani — ونُشر كورقة بحثية في مؤتمر NeurIPS 2023 بعنوان "StyleTTS 2: Towards Human-Level Text-to-Speech through Style Diffusion and Adversarial Training with Large Speech Language Models".
الادعاء المركزي للورقة البحثية هو أن الجمع بين انتشار الأسلوب (نمذجة أسلوب الكلام كتوزيع احتمالي كامن بدلًا من متجه ثابت واحد) والتدريب التنافسي ضد نماذج لغوية صوتية كبيرة مُدرَّبة مسبقًا يتيح نمذجة التباين في الكلام البشري بدقة أكبر من الأساليب السابقة. في معيار LJSpeech لمتحدث واحد، تفيد الورقة بأن StyleTTS 2 يعادل أو يتفوق على تسجيلات كلام بشري حقيقي في تقييمات المستمعين؛ وفي مجموعة بيانات LibriTTS متعددة المتحدثين، تفيد بأنه يتفوق على النماذج العامة المتاحة سابقًا في التكيف مع المتحدث بدون أمثلة سابقة.
جمع مستودع GitHub العام yl4579/StyleTTS2 أكثر من 6,300 نجمة، وهو غير مُصنَّف كمؤرشف — لكن PromptQuorum لم تجد أي التزامات في الفرع الرئيسي للمستودع منذ 7 مارس 2024، استنادًا إلى سجل الالتزامات العام للمشروع. يتوافق هذا مع إصدار بحثي جامعي أكثر من كونه منتجًا مفتوح المصدر يخضع لصيانة تجارية: نُشرت الشيفرة والورقة البحثية ونقاط التحقق المُدرَّبة مسبقًا مصاحبةً للبحث، دون التزام مستمر بتطوير الميزات أو إصدارات إصلاح الأخطاء.
تُغلِّف حزمة pip يديرها المجتمع، styletts2 من المطور Sidharth Rajaram، الشيفرة البحثية الأصلية في حزمة قابلة للتثبيت (pip install styletts2) تستبدل مُحوِّل الأصوات espeak-ng المرخّص بموجب GPL-3.0 بمكتبة gruut المرخّصة بموجب MIT، للحفاظ على سلسلة التثبيت بأكملها تحت ترخيص متساهل. أحدث إصدار لها على PyPI هو الإصدار 0.1.6، الصادر في 11 يناير 2024 — وهو أيضًا أقدم من عامين ونصف عند كتابة هذه المراجعة، ومشروع طرف ثالث منفصل عن الشيفرة البحثية الأصلية من كولومبيا.
من أنشأ StyleTTS 2؟
أنشأ StyleTTS 2 كل من Yinghao Aaron Li وCong Han وVinay S. Raghavan وGavin Mischler وNima Mesgarani، وهم باحثون في قسم الهندسة الكهربائية بجامعة كولومبيا، ونُشر كورقة بحثية في مؤتمر NeurIPS 2023.
ما الذي يفعله StyleTTS 2 فعليًا
StyleTTS 2 هو نموذج لتحويل النص إلى كلام يُولّد مخططًا طيفيًا من نوع Mel (وفي إعداده من طرف إلى طرف، شكل موجة خام) من نص الإدخال، باستخدام نموذج انتشار لأخذ عينة من متجه "أسلوب" كامن بدلًا من التنبؤ به بشكل حتمي — تُنسب هذه الآلية في الورقة البحثية إلى إنتاج تنغيم (بروسودي) أكثر طبيعية وشبهًا بالبشر.
- انتشار الأسلوب لتنغيم طبيعي. بدلًا من التنبؤ بتمثيل أسلوب ثابت واحد من النص، يأخذ StyleTTS 2 عينة، عبر الانتشار، من توزيع احتمالي مُتعلَّم للأساليب، وهو ما يُنتج، وفقًا للورقة البحثية، تباينًا أكثر طبيعية في النبرة والإيقاع والتشديد مقارنة بالأساليب الحتمية.
- التدريب التنافسي ضد نماذج لغوية صوتية. تضع عملية التدريب نموذج TTS في مواجهة نماذج لغوية صوتية كبيرة مُدرَّبة مسبقًا تعمل كمُميِّزات، وهي تقنية تُنسب إليها الورقة البحثية سد الفجوة المتبقية مع جودة التسجيل البشري في معيار LJSpeech.
- نقطتا تحقق مُدرَّبتان مسبقًا صادرتان رسميًا. StyleTTS2-LJSpeech (متحدث إنجليزي واحد، 24 كيلوهرتز) وStyleTTS2-LibriTTS (متعدد المتحدثين بالإنجليزية) كلاهما مُستضاف على Hugging Face.
- نقل أسلوب بدون أمثلة سابقة من صوت مرجعي. يمكن لنقطة التحقق متعددة المتحدثين من LibriTTS تركيب نص جديد بأسلوب مُلتقَط من مقطع صوتي مرجعي — يصف توثيق المشروع نفسه وأدلة طرف ثالث حدًا أدنى من 5 إلى 10 ثوانٍ، مع التوصية بـ15 إلى 30 ثانية من صوت مرجعي نظيف لمتحدث واحد للحصول على جرس صوت وتنغيم ونطق دقيق.
- نقاط تحقق مُدرَّبة مسبقًا بالإنجليزية بشكل أساسي، مع بعض العمل التأسيسي متعدد اللغات. تُدرَّب نقاط التحقق الصادرة رسميًا على مجموعات بيانات إنجليزية (LJSpeech وLibriTTS). تُشير الورقة البحثية إلى أن مكوّن محاذاة النص دُرِّب مسبقًا أيضًا على مجموعات بيانات يابانية (JVS) وصينية (AiShell) و"يعمل بشكل جيد لمعظم اللغات الأخرى دون ضبط دقيق"، وتشير إلى نموذج PL-BERT متعدد اللغات يغطي 14 لغة كنقطة انطلاق لتدريب نموذج StyleTTS 2 غير إنجليزي بنفسك — لكن لا توجد نقطة تحقق غير إنجليزية صادرة رسميًا وجاهزة للاستخدام.
تثبيت وتشغيل StyleTTS 2: خطوة بخطوة
يتبع هذا الدليل الإعداد الموثَّق من المشروع نفسه لتشغيل الاستدلال باستخدام نقطة تحقق مُدرَّبة مسبقًا.
- 1استنساخ المستودع وتثبيت التبعيات.
Why it matters: نفّذ `git clone https://github.com/yl4579/StyleTTS2.git && cd StyleTTS2 && pip install -r requirements.txt`. يؤدي هذا إلى تثبيت تبعيات Python الأساسية المُدرجة في ملف المتطلبات الخاص بالمشروع. - 2تثبيت مُحوِّل الأصوات وespeak-ng.
Why it matters: نفّذ `pip install phonemizer`، وعلى Linux `sudo apt-get install espeak-ng` (أو ما يعادله لنظام تشغيلك). لاحظ أن espeak-ng نفسها مرخّصة بموجب GPL-3.0 — راجع قسم الترخيص والتكلفة لمعرفة سبب أهمية ذلك لمسار الاستدلال، وليس فقط لشيفرة StyleTTS 2 نفسها. - 3تنزيل نقطة تحقق مُدرَّبة مسبقًا.
Why it matters: نزِّل [StyleTTS2-LJSpeech](https://huggingface.co/yl4579/StyleTTS2-LJSpeech/tree/main) (متحدث واحد) أو [StyleTTS2-LibriTTS](https://huggingface.co/yl4579/StyleTTS2-LibriTTS/tree/main) (متعدد المتحدثين، يدعم نقل الأسلوب) من Hugging Face إلى مجلد المشروع. - 4تشغيل الاستدلال عبر دفاتر Jupyter المُوفَّرة.
Why it matters: يأتي المشروع مع `Demo/Inference_LJSpeech.ipynb` و`Demo/Inference_LibriTTS.ipynb` — افتح الدفتر المطابق لنقطة التحقق التي نزّلتها في Jupyter لتحميل النموذج وتركيب أول عيّنة لك. - 5(بديل) استخدام حزمة pip المجتمعية لسلسلة تثبيت أبسط ومقتصرة على MIT.
Why it matters: نفّذ `pip install styletts2`، ثم `from styletts2 import tts; my_tts = tts.StyleTTS2(); my_tts.inference("مرحبًا.", output_wav_file="test.wav")`. تستخدم هذه الحزمة من طرف ثالث (آخر إصدار في 11 يناير 2024) مكتبة gruut المرخّصة بموجب MIT بدلًا من espeak-ng، متجنبةً تبعية GPL-3.0 — على حساب الاعتماد على غلاف غير رسمي خامل هو الآخر. - 6(اختياري) توفير مقطع مرجعي لنقل الأسلوب.
Why it matters: مع نقطة تحقق LibriTTS، مرّر وسيطًا `target_voice_path` (الحزمة المجتمعية) أو المعامل المكافئ للصوت المرجعي (الدفتر الرسمي) يشير إلى ملف WAV نظيف لمتحدث واحد مدته 15 إلى 30 ثانية، لتركيب نص جديد بذلك الأسلوب المُلتقَط.
أمثلة استخدام حقيقية
توضح هذه الأمثلة كلًا من واجهة برمجة التطبيقات المُبسَّطة لحزمة pip المجتمعية والنمط المستخدم في دفاتر الاستدلال الخاصة بالمشروع الرسمي.
- جودة الصوت المرجعي مهمة لنقل الأسلوب. ينتج مقطع نظيف لمتحدث واحد مدته 15 إلى 30 ثانية نقل أسلوب أفضل بشكل ملحوظ من مرجع قصير أو صاخب أو متعدد المتحدثين.
- توجد سلسلتا تبعيات منفصلتان. يجلب مسار الدفاتر الخاص بالمستودع الرسمي espeak-ng المرخّصة بموجب GPL-3.0؛ وتتجنب حزمة pip المجتمعية ذلك باستخدام gruut بدلًا منها — اختر السلسلة التي تناسب متطلبات الترخيص لديك قبل بناء أدوات حول أي منهما.
# المسار الأبسط: حزمة pip مجتمعية (سلسلة تبعيات مقتصرة على MIT،
# آخر إصدار 2024-01-11 — تحقق من أنها لا تزال تعمل قبل الاعتماد عليها)
pip install styletts2

from styletts2 import tts

my_tts = tts.StyleTTS2()
my_tts.inference(
    "Hello there, this is a natural-sounding synthesized sentence.",
    output_wav_file="test.wav",
)

# نقل أسلوب بدون أمثلة سابقة من مقطع مرجعي (نقطة تحقق من نوع LibriTTS)
my_tts.inference(
    "The same text, now spoken in a captured reference style.",
    target_voice_path="reference_voice.wav",
    output_wav_file="styled_test.wav",
)

# مسار نقطة تحقق وإعدادات مخصص
custom_tts = tts.StyleTTS2(
    model_checkpoint_path="/path/to/epochs_2nd_00020.pth",
    config_path="/path/to/config.yml",
)

# --- مسار المستودع الرسمي (يتطلب espeak-ng، GPL-3.0) ---
# git clone https://github.com/yl4579/StyleTTS2.git
# cd StyleTTS2 && pip install -r requirements.txt
# pip install phonemizer && sudo apt-get install espeak-ng
# ثم افتح Demo/Inference_LJSpeech.ipynb أو Demo/Inference_LibriTTS.ipynb
# في Jupyter وشغّل الخلايا المُوفَّرة مع نقطة التحقق التي نزّلتها.
الترخيص والتكلفة
شيفرة StyleTTS 2 مرخّصة بموجب رخصة MIT، وهو ما تأكد من خلال ملف LICENSE في المستودع الرسمي. رخصة MIT متساهلة: يمكنك استخدام الشيفرة وتعديلها وإعادة توزيعها، بما في ذلك تجاريًا، بقيود ضئيلة.
تحمل أوزان النموذج المُدرَّب مسبقًا شرطًا منفصلًا خارج نطاق الرخصة، مذكورًا في README وليس في ملف LICENSE نفسه. يطلب README المشروع من المستخدمين "إخبار المستمعين بأن عيّنات الصوت مُصنَّعة بواسطة نماذج StyleTTS 2، ما لم يكن لديك إذن باستخدام الصوت الذي تُصنّعه". هذا طلب على مستوى التوثيق، وليس بندًا رسميًا في الرخصة — أشارت مشكلة على GitHub تخص المشروع (#37) صراحةً إلى أن هذا قد يكون مربكًا، لأن شارة الرخصة وملف LICENSE في المستودع توحيان لقارئ لا يقرأ أيضًا قسم استخدام النموذج في README بأن شروط MIT فقط هي المطبَّقة. لم تجد PromptQuorum ردًا من القائمين على الصيانة يحل هذا الغموض في خيط المناقشة العام. تعامل مع شرط الإفصاح كطلب حقيقي وموثَّق من المؤلفين، والتزم به — لكن افهم أنه يقع خارج منح MIT الرسمي على الشيفرة نفسها، وهو هيكل غير معتاد فعليًا يستحق الإشارة إليه قبل الاستخدام التجاري.
يجلب تشغيل الاستدلال الرسمي تبعية مرخّصة بموجب GPL-3.0: espeak-ng. تطلب تعليمات التثبيت الخاصة بالمشروع نفسه pip install phonemizer بالإضافة إلى تثبيت espeak-ng على مستوى النظام، وespeak-ng مرخّصة بموجب GPL-3.0. رخصة GPL-3.0 هي رخصة copyleft ذات التزامات توزيع مختلفة عن MIT؛ يُعامَل استخدام espeak-ng كتبعية نظام خارجية غير مُعدَّلة عادةً بشكل مختلف عن الربط الثابت بشيفرتها المصدرية المُعدَّلة أو إعادة توزيعها، لكن الحد الفاصل الدقيق يعتمد على طريقة نشرك. تتجنب حزمة pip المجتمعية styletts2 هذه المشكلة تحديدًا باستخدام مكتبة gruut المرخّصة بموجب MIT بدلًا من espeak-ng — فرق عملي حقيقي إن أردت سلسلة تبعيات متساهلة بالكامل، على حساب الاعتماد على حزمة طرف ثالث بتاريخ إصدار أخير (11 يناير 2024) أقدم حتى من المستودع الرسمي.
لا شيء من هذا يُعد استشارة قانونية. اقرأ ملف LICENSE، وقسم استخدام النموذج في README، واستشر محاميًا بشأن نشرك المحدد قبل شحن StyleTTS 2 في منتج تجاري.
ما الرخصة التي يستخدمها StyleTTS 2؟
شيفرة StyleTTS 2 مرخّصة بموجب MIT. تحمل أوزان نموذجه المُدرَّب مسبقًا شرطًا منفصلًا خارج نطاق الرخصة في README المشروع (الإفصاح عن الكلام المُصنَّع ما لم يكن لديك إذن من المتحدث)، وهو ليس جزءًا من النص الرسمي لرخصة MIT — وهو تمييز أشارت إليه مشكلة على GitHub تخص المشروع بأنه قد يكون مربكًا. هذا ليس استشارة قانونية؛ اقرأ ملف LICENSE وREADME بنفسك قبل الاستخدام التجاري.
ما لا يصلح له StyleTTS 2
StyleTTS 2 نموذج على مستوى بحثي بجودة إخراج قوية فعليًا، وليس منتجًا استهلاكيًا مُصقَّلًا وتحت صيانة نشطة. إنه الأداة الخاطئة للحالات التالية:
- القراء الذين يريدون تجربة بسيطة من نوع التثبيت عبر pip والانطلاق مباشرة. على عكس Piper، الذي لا يبعد سوى
pip install piper-ttsوأمر CLI واحد عن الحصول على صوت يعمل، يتضمن المسار الرسمي لـStyleTTS 2 استنساخ مستودع بحثي، وتثبيت مُحوِّل أصوات، وتبعية espeak-ng على مستوى النظام، وتشغيل دفاتر Jupyter — حاجز إعداد أعلى بشكل ملحوظ. - النشر في بيئة الإنتاج دون جهد هندسي في تعلم الآلة. لا يوجد وضع خادم ويب تحت صيانة، ولا صورة Docker رسمية، ولا شركة تدعم استمرارية الدعم. يجب على أي شخص ينشر StyleTTS 2 في بيئة الإنتاج أن يتوقع كتابة طبقة تقديم خاصة به وصيانتها حول الشيفرة البحثية.
- ضمان إصلاح الأخطاء أو تحديثات الميزات المستمرة. بدون التزامات في المستودع الرسمي منذ 7 مارس 2024، وبآخر إصدار لحزمة pip المجتمعية بتاريخ 11 يناير 2024، لا تفترض صيانة نشطة لأي من سلسلتي التبعيات — ضع في حسبانك احتمال أن تكون وحدك في مواجهة أي مشكلة تصادفها.
- كلام جاهز للاستخدام بلغة غير الإنجليزية. نقاط التحقق المُدرَّبة مسبقًا الصادرة رسميًا هي بالإنجليزية فقط (LJSpeech وLibriTTS). تدريب نموذج غير إنجليزي بنفسك ممكن معماريًا وفقًا لملاحظات الورقة البحثية حول محاذي النص متعدد اللغات وPL-BERT، لكنه يتطلب تدريبًا خاصًا بك — لا توجد نقطة تحقق غير إنجليزية قابلة للتنزيل من المشروع.
- منح ترخيص واحد لا لبس فيه لكل ما تُنزّله. لأن الشيفرة (MIT) والأوزان المُدرَّبة مسبقًا (MIT مع شرط إفصاح في README) تخضعان لأحكام مختلفة قليلًا، ولأن مسار الاستدلال الرسمي يجلب تبعية GPL-3.0، لا يقدم StyleTTS 2 قصة الترخيص الواحدة البسيطة التي يمتلكها مشروع مثل Bark (MIT بالكامل، دون شروط إضافية).
بدائل StyleTTS 2
Piper
- الأنسب لـ:
- إعداد بسيط بالتثبيت عبر pip والانطلاق، أسرع تركيب على CPU فقط، وقت حقيقي على Raspberry Pi
- الترخيص:
- GPL-3.0-or-later
XTTS v2
- الأنسب لـ:
- استنساخ صوت مُغلَّف من 6 ثوانٍ من الصوت المرجعي، 17 لغة
- الترخيص:
- CPML (غير تجاري)
Coqui TTS
- الأنسب لـ:
- مجموعة أدوات مرنة متعددة الواجهات الخلفية مع دعم لغوي واسع وفرع تحت صيانة
- الترخيص:
- MPL-2.0
Bark
- الأنسب لـ:
- صوت تعبيري غير كلامي — ضحك، تنهدات، صوت محيطي، رخصة MIT واحدة لا لبس فيها
- الترخيص:
- MIT
ElevenLabs
- الأنسب لـ:
- واجهة برمجة تطبيقات سحابية مُدارة مع استنساخ صوت تجاري ودعم نشط، دون جهد استضافة ذاتية
- الترخيص:
- مملوكة (واجهة برمجة تطبيقات سحابية مدفوعة)
الأسئلة الشائعة
ما هو StyleTTS 2؟
StyleTTS 2 هو نموذج مفتوح المصدر لتحويل النص إلى كلام من باحثين في جامعة كولومبيا، يُولّد كلامًا يبدو طبيعيًا عبر انتشار الأسلوب والتدريب التنافسي مع نماذج لغوية صوتية كبيرة، ونُشر كورقة بحثية في مؤتمر NeurIPS 2023.
هل StyleTTS 2 مجاني للاستخدام التجاري؟
شيفرته مرخّصة بموجب MIT، والتي تسمح بالاستخدام التجاري. تحمل أوزان نموذجه المُدرَّب مسبقًا شرطًا منفصلًا خارج نطاق الرخصة في README يطلب الإفصاح عن الكلام المُصنَّع ما لم يكن لديك إذن من المتحدث. هذا ليس استشارة قانونية؛ اقرأ ملف LICENSE وREADME بنفسك قبل أي نشر تجاري.
هل يمكن لـStyleTTS 2 استنساخ صوت؟
تدعم نقطة التحقق متعددة المتحدثين من LibriTTS نقل الأسلوب بدون أمثلة سابقة من مقطع صوتي مرجعي (5 إلى 10 ثوانٍ كحد أدنى، ويُنصح بـ15 إلى 30 ثانية)، وهو ما يشبه استنساخ الصوت من حيث الروح. لا يُغلَّف كميزة استنساخ بسيطة بسطر واحد مثل XTTS v2 — استخدامه يتطلب سير العمل الرسمي القائم على الدفاتر أو حزمة pip المجتمعية.
هل ما زال StyleTTS 2 تحت الصيانة؟
مستودع GitHub الرسمي غير مُصنَّف كمؤرشف، لكن PromptQuorum لم تجد أي التزامات منذ 7 مارس 2024. صدر آخر إصدار من حزمة pip المجتمعية التي تُبسّط التثبيت في 11 يناير 2024. تعامل مع كليهما كأثرين بحثيين خاملين وليسا برمجيات قيد التطوير النشط.
هل يدعم StyleTTS 2 لغات غير الإنجليزية؟
نقاط التحقق المُدرَّبة مسبقًا الصادرة رسميًا (LJSpeech وLibriTTS) هي بالإنجليزية فقط. تُشير الورقة البحثية إلى أن مكوّن محاذاة النص دُرِّب أيضًا على مجموعات بيانات يابانية وصينية ويُعمَّم بشكل معقول على لغات أخرى دون ضبط دقيق، وتشير إلى نموذج PL-BERT متعدد اللغات لـ14 لغة كنقطة انطلاق لتدريب نموذجك الخاص غير الإنجليزي — لكن لا توجد نقطة تحقق غير إنجليزية جاهزة للاستخدام صادرة رسميًا.
لماذا يحتاج التثبيت الرسمي لـStyleTTS 2 إلى espeak-ng، ولماذا يهم ذلك؟
يستخدم مسار الاستدلال الرسمي مكتبة phonemizer مع espeak-ng كواجهة خلفية لتحويل النص إلى وحدات صوتية. espeak-ng مرخّصة بموجب GPL-3.0، وهي رخصة copyleft ذات التزامات توزيع مختلفة عن MIT. تتجنب حزمة pip مجتمعية (styletts2) ذلك باستخدام مكتبة gruut المرخّصة بموجب MIT بدلًا من ذلك، على حساب الاعتماد على إصدار غير رسمي أقدم (آخر تحديث في 11 يناير 2024).
كيف يُقارَن StyleTTS 2 بـXTTS v2؟
شيفرة StyleTTS 2 مرخّصة بموجب MIT ومجانية للاستخدام التجاري (مع شرط الإفصاح في README بشأن الأوزان)؛ بينما XTTS v2 مرخّص بموجب رخصة Coqui Public Model License غير التجارية. إعداد StyleTTS 2 الرسمي أكثر توجهًا بحثيًا ويتطلب مزيدًا من العمل اليدوي؛ بينما يوفر XTTS v2 واجهة برمجة تطبيقات أبسط ومُغلَّفة لاستنساخ الصوت عبر مجموعة أدوات Coqui TTS. اختر بناءً على احتياجاتك من الترخيص وتحملك لتعقيد الإعداد.
الخلاصة
يظل StyleTTS 2 مثيرًا للإعجاب فعليًا من حيث جودة الإخراج: يُنسَب لأسلوبه في انتشار الأسلوب والتدريب التنافسي، في ورقته البحثية الخاصة في NeurIPS، معادلة أو تجاوز جودة التسجيل البشري في معيار LJSpeech، تحت رخصة كود (MIT) متساهلة قدر الإمكان. ما يمنعه من أن يكون توصية سهلة لمعظم القراء هو كل ما يحيط بهذا النموذج الأساسي: شرط إفصاح على مستوى التوثيق يخص الأوزان المُدرَّبة مسبقًا يقع خارج منح MIT الرسمي، ومسار استدلال رسمي يجلب تبعية GPL-3.0، وحزمة pip مجتمعية تتجنب تلك التبعية لكنها هي نفسها أقدم من عامين ونصف، وعدم وجود أي التزامات في المستودع الرسمي منذ 7 مارس 2024. إذا كنت تريد أفضل جودة سرد صوتي إنجليزي طبيعي متاحة محليًا وترتاح لإعداد على مستوى بحثي وسلسلة تبعيات غير مُصانة، فإن StyleTTS 2 يفي بذلك. إذا كنت تريد تثبيتًا أبسط، أو صيانة نشطة، أو استنساخ صوت مُغلَّف، اجمع بين هذه المراجعة وتغطية PromptQuorum لـPiper للتركيب السريع على CPU فقط، أو XTTS v2 لاستنساخ الصوت المُغلَّف، أو مقارنة ElevenLabs كبديل مُدار بالكامل. تُعد هذه المراجعة الأخيرة من بين ست محركات محلية للتعرف على الكلام وتركيبه راجعتها PromptQuorum بعمق، إلى جانب Whisper.cpp وFaster Whisper وPiper وCoqui TTS وXTTS v2 وBark.
المصادر
- StyleTTS 2 على GitHub — المستودع الرسمي: README، وLICENSE، وتعليمات التثبيت، وسجل الالتزامات.
- ورقة StyleTTS 2 البحثية (arXiv) — "Towards Human-Level Text-to-Speech through Style Diffusion and Adversarial Training with Large Speech Language Models"، ورقة NeurIPS 2023.
- مشكلة GitHub رقم 37: Possibly misleading license info — التناقض الذي أشار إليه المجتمع بين ملف رخصة MIT وشرط الإفصاح عن استخدام النموذج في README.
- styletts2 على PyPI — حزمة pip يديرها المجتمع (Sidharth Rajaram)، الإصدار 0.1.6، الصادر في 11 يناير 2024.
- StyleTTS2-LJSpeech وStyleTTS2-LibriTTS على Hugging Face — نقاط التحقق المُدرَّبة مسبقًا الرسمية.
- تراخيص TTS المحلية واستنساخ الصوت — مقارنة كاملة للتراخيص بين محركات TTS المحلية.