النقاط الرئيسية
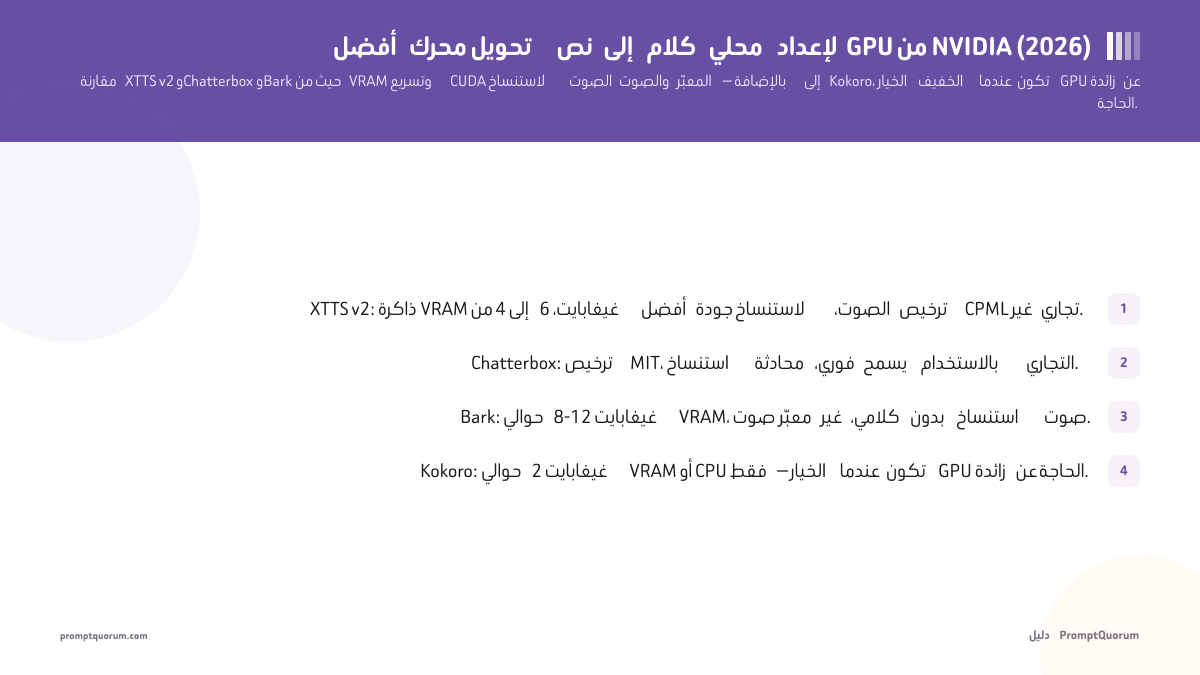
- XTTS v2: أفضل جودة استنساخ (مقطع مرجعي 6 ثوانٍ، 17 لغة)، يُنصح بـ4-6 جيجابايت VRAM، ترخيص CPML غير تجاري.
- Chatterbox: استنساخ حواري فوري، نموذج صغير بحوالي 0.5 مليار معامل، ترخيص MIT (الاستخدام التجاري مسموح).
- Bark: أصوات تعبيرية غير كلامية، بلا استنساخ صوت، أعلى استهلاك VRAM بين الأربعة، ترخيص MIT، صيانة غير مؤكدة.
- Kokoro: 82 مليون معامل، Apache 2.0، يعمل جيدًا على CPU وحدها — النقيض الذي لا يتطلب GPU.
- المحركات الثلاثة الموجهة نحو GPU تعمل على CPU، لكن بتكلفة سرعة حقيقية — هذه الفجوة هي السبب الفعلي لامتلاك GPU لهذا الاستخدام.
- يتطلب استنساخ الصوت موافقة الشخص المستنسخ صوته، بغض النظر عن المحرك أو الترخيص المستخدم.
📍 في جملة واحدة
على GPU من NVIDIA، يمنح XTTS v2 أفضل جودة لاستنساخ الصوت، ويمنح Chatterbox أفضل استنساخ حواري فوري بموجب ترخيص MIT مناسب تجاريًا، ويمنح Bark أكثر صوت غير كلامي تعبيرية، بينما يبقى Kokoro الخيار الصحيح عندما لا تكون GPU مطلوبة فعليًا.
💬 بعبارات بسيطة
إذا كنت تملك بطاقة رسومية قادرة على تشغيل أعباء عمل الذكاء الاصطناعي، فإن ثلاثة محركات لتحويل النص إلى كلام (XTTS v2 وChatterbox وBark) تصبح فعليًا أسرع وأفضل بفضلها، بينما يكاد الرابع (Kokoro) لا يحتاج إلى GPU على الإطلاق — يعتمد اختيار المحرك على ما إذا كنت بحاجة إلى استنساخ الصوت، وكمية ذاكرة الفيديو المتوفرة لديك، وما إذا كنت تخطط لاستخدامه تجاريًا.
📌ملاحظة: يفترض هذا الدليل أنك تمتلك بالفعل GPU من NVIDIA وتقرر ما ستشغّله عليها. بالنسبة لإعداد يعتمد فقط على CPU (مثل Raspberry Pi بدون GPU مخصصة)، فإن Piper هو الخيار القياسي — راجع مقارنة PromptQuorum الكاملة للتراخيص وVRAM عبر جميع محركات TTS المحلية، المرتبطة في قراءات ذات صلة.
ما المحركات التي تحتاج فعليًا إلى GPU؟
تعمل XTTS v2 وChatterbox وBark جميعها على CPU، لكن GPU هي ما يجعلها عملية للاستخدام الفوري أو الدُفعي — أما Kokoro فهو الاستثناء، إذ تجعله معاملاته البالغة 82 مليونًا سريعًا على CPU وحدها. تشترك المحركات الثلاثة الأثقل في سمة واحدة: إنها نماذج تُعطي الأولوية لجودة الاستنساخ أو التوليد، حيث تستبدل بنيتها القدرة الحسابية بالتعبيرية، لذا فإن تسريع CUDA يزيل عنق الزجاجة بدلًا من تقديم تحسن هامشي فقط.
استخدم محركًا موجهًا نحو GPU (XTTS v2 أو Chatterbox أو Bark) إذا كانت حالة استخدامك هي استنساخ الصوت، أو الصوت التعبيري غير الكلامي، أو أي عبء عمل تهم فيه سرعة التوليد — كعملية سرد دُفعية، أو تطبيق صوتي تفاعلي، أو خط أنابيب يولّد عددًا كبيرًا من المقاطع. تجنب إنفاق VRAM الخاصة بـGPU على TTS إذا كانت حاجتك الوحيدة هي سرد نص عادي مباشر دون استنساخ: يغطي Kokoro أو Piper هذه الحالة على CPU وحدها، مما يحرر VRAM لديك لنموذج لغوي كبير أو عبء عمل آخر يعمل بجانبه.
- XTTS v2 يعمل على CPU لكنه موثّق بأنه أبطأ بشكل ملحوظ عليها — فزمن الاستجابة البثّي دون 200 ميلي ثانية رقم مسرّع بواسطة GPU، وليس رقمًا خاصًا بـCPU.
- Chatterbox يقدم نسخة Nano متوافقة مع CPU (110 مليون معامل) تصفها وثائق Resemble AI نفسها بأنها تعمل بسرعة أعلى من الوقت الفعلي على 8 أنوية CPU، لكن النسخ الأكبر الموجهة نحو الاستنساخ تستفيد من CUDA للاستخدام الحواري الفوري.
- Bark يذكر صراحةً في وثائقه الخاصة أن الاستدلال على CPU أو وحدات GPU الأقدم قد يكون أبطأ بشكل ملحوظ من السرعة القريبة من الوقت الفعلي التي يصل إليها على وحدات GPU من فئة المؤسسات.
- Kokoro هو الاستثناء: بمعاملاته البالغة 82 مليونًا، يعمل بسرعة الوقت الفعلي أو أسرع على CPU وحدها، وفقًا لبطاقة نموذجه على Hugging Face، ولا يحتاج إلى GPU إلا للحصول على هامش إضافي في التوليد الدُفعي عالي الحجم.
XTTS v2: أفضل جودة لاستنساخ الصوت
XTTS v2، الذي أصدرته Coqui ويُشغَّل عبر مجموعة أدوات Coqui TTS، هو أفضل خيار محلي لاستنساخ الصوت لمالكي GPU الذين يحتاجون إلى أعلى جودة يمكن تحقيقها من مقطع مرجعي قصير. يستنسخ صوتًا من 6 ثوانٍ فقط من الصوت المرجعي وينطقه بـ17 لغة، بما في ذلك الاستنساخ عبر اللغات — استنساخ صوت من صوت إنجليزي وجعله يتحدث بالإسبانية أو اليابانية.
من حيث VRAM، تبلغ أوزان نموذج XTTS v2 حوالي 2 جيجابايت، لكن 4 جيجابايت هو الحد الأدنى العملي لتشغيله، ويُنصح بـ4-6 جيجابايت للاستدلال الفوري، وفقًا لـمراجعة XTTS v2 المخصصة من PromptQuorum. الترخيص هو العامل الحاسم لمعظم القراء: Coqui Public Model License (CPML) غير تجاري صراحةً، وبما أن Coqui AI، الشركة، أوقفت خدماتها المدفوعة في ديسمبر 2023، فلا يوجد حاليًا مسار مؤكد نحو ترخيص تجاري.
- استخدم XTTS v2 إذا: كان مشروعك شخصيًا أو أكاديميًا أو نموذجًا أوليًا غير تجاري وتريد أفضل جودة استنساخ متاحة محليًا.
- تجنّب XTTS v2 إذا: كنت بحاجة إلى ترخيص تجاري — فشروط CPML الخاصة به غير تجارية، بلا مسار ترخيص نشط مؤكد منذ إغلاق Coqui AI عام 2023.
- VRAM: حوالي 2 جيجابايت لأوزان النموذج، 4 جيجابايت كحد أدنى، ويُنصح بـ4-6 جيجابايت للاستدلال الفوري.
- الأنسب لـ: استنساخ الصوت المحلي الأعلى دقة، دعم عبر اللغات لـ17 لغة، الاستخدام غير التجاري أو البحثي.
Chatterbox: أفضل استنساخ فوري
Chatterbox، الذي أصدرته Resemble AI على GitHub، هو الخيار الأفضل لمالكي GPU الذين يريدون استنساخ صوت حواري فوري بموجب ترخيص متساهل تمامًا ومناسب تجاريًا. إنه مرخّص بموجب ترخيص MIT، الذي — على عكس CPML غير التجاري الخاص بـXTTS v2 — يسمح بالاستخدام التجاري دون اتفاقية منفصلة.
يأتي Chatterbox بعدة أحجام: نسخة Nano (110 مليون معامل) تصفها وثائق Resemble AI نفسها بأنها تعمل بسرعة أعلى من الوقت الفعلي على 8 أنوية CPU، ونسخة Turbo (350 مليون معامل) مصممة لزمن استجابة منخفض، ونسخة متعددة اللغات (حوالي 500 مليون معامل، على بنية تنسب في تصميمها إلى Llama 3) تدعم أكثر من 20 لغة. يعمل استنساخ الصوت بدون أمثلة مسبقة (zero-shot) انطلاقًا من مقطع صوتي مرجعي — يستخدم المثال الرسمي لـResemble AI مقطعًا مدته 10 ثوانٍ، رغم أن ملف README لا يذكر مدة دنيا رسمية كما يفعل ملف XTTS v2.
لا ينشر ملف README العام لـResemble AI رقمًا دقيقًا لـVRAM، لذا تعامل مع أي رقم محدد بالجيجابايت تراه في مكان آخر على أنه غير مؤكد حتى تختبره على بطاقتك الخاصة. ما هو موثّق هو: تعمل نسخة Nano بشكل مقبول على CPU وحدها، بينما صُممت نسختا Turbo وMultilingual الأكبر للتوليد المسرَّع بواسطة GPU وبزمن استجابة منخفض — وكلاهما يدعم CUDA وApple Silicon (MPS).
- استخدم Chatterbox إذا: كنت بحاجة إلى استنساخ صوت مناسب تجاريًا بزمن استجابة فوري أو شبه فوري، مثل تطبيق صوتي تفاعلي.
- تجنّب Chatterbox إذا: كنت بحاجة إلى رقم أدنى موثّق ومضمون لـVRAM قبل شراء الأجهزة — لم تنشر Resemble AI رقمًا كهذا.
- VRAM: غير منشور رسميًا؛ نسخة Nano الأصغر متوافقة مع CPU، بينما تستهدف نسختا Turbo وMultilingual التسريع بواسطة GPU لسرعة الوقت الفعلي.
- الأنسب لـ: المنتجات التجارية التي تحتاج إلى استنساخ صوت حواري بدون أمثلة مسبقة بموجب ترخيص متساهل.
- يحمل كل ناتج من Chatterbox علامة مائية خاصة بـResemble AI تُدعى Perth، وتصفها وثائقه بأنها علامة مائية عصبية غير مُدركة تبقى بعد ضغط MP3 — وهي إشارة أصل مدمجة، وليست بديلًا عن الموافقة (راجع قسم استنساخ الصوت والموافقة أدناه).
Bark: أفضل صوت تعبيري غير كلامي
Bark، الذي أصدرته Suno على GitHub، هو الخيار الصحيح إذا أردت أكثر من الكلام — ضحك، تنهدات، لهاث، وموسيقى بسيطة تُولَّد فقط من مطالبات نصية — وهو المحرك في هذه المقارنة الذي يستفيد أكثر من GPU، لأن بنيته التوليدية القائمة على الرموز واحدًا تلو الآخر هي الأبطأ بين الأربعة دون تسريع CUDA. لا يدعم استنساخ الصوت المخصص؛ فوفقًا لوثائق Suno نفسها، فهو "لا يدعم حاليًا استنساخ الصوت المخصص".
من حيث VRAM، توثّق مراجعة Bark المخصصة من PromptQuorum أن النموذج الكامل يحتاج إلى حوالي 12 جيجابايت، مع علامة بيئية لنموذج صغير (SUNO_USE_SMALL_MODELS) تخفض ذلك إلى حوالي 8 جيجابايت — أكثر بشكل ملحوظ من 4-6 جيجابايت لـXTTS v2. إنه مرخّص بموجب MIT، وأصبح مناسبًا تجاريًا بالكامل في 1 مايو 2023، لكن حالة صيانته سؤال حقيقي مفتوح: لا يُظهر مستودع GitHub العام أي تعديلات (commits) منذ 5 أبريل 2024.
- استخدم Bark إذا: كنت بحاجة إلى صوت غير كلامي (ضحك، تنهدات، صوت محيطي) إلى جانب الكلام ولديك 8-12 جيجابايت من VRAM متاحة.
- تجنّب Bark إذا: كنت بحاجة إلى ناتج موثوق وحتمي لخط أنابيب إنتاجي، أو كنت بحاجة إلى استنساخ صوت — فـBark لا يدعمه.
- VRAM: حوالي 12 جيجابايت للنموذج الكامل، وحوالي 8 جيجابايت مع علامة النموذج الصغير — الأثقل بين المحركات الأربعة المقارنة هنا.
- الأنسب لـ: توليد صوت تعبيري، مؤثرات صوتية مدمجة مع الكلام، النمذجة الأولية والاستخدام البحثي.
Kokoro: عندما تكون GPU مبالغة
يُدرج Kokoro هنا كنقيض: امتلاك GPU من NVIDIA لا يعني أن كل عبء عمل لـTTS يحتاج إليها، وKokoro دليل على ذلك. بمعاملاته البالغة 82 مليونًا، هو أصغر بشكل كبير من XTTS v2 وChatterbox وBark، وتوثّق بطاقة نموذجه الخاصة على Hugging Face تركيبًا بسرعة الوقت الفعلي أو أسرع على CPU وحدها، مع إضافة استخدام GPU هامشًا إضافيًا لا شرطًا لازمًا.
Kokoro مرخّص بموجب Apache 2.0، الذي — مثل ترخيص MIT الخاص بـChatterbox — يسمح بالاستخدام التجاري دون قيود. لا يدعم استنساخ الصوت، لذا فهو ليس بديلًا عن XTTS v2 أو Chatterbox إذا كان الاستنساخ هو المطلوب، لكن بالنسبة للسرد البسيط، أو قراءة النص بصوت عالٍ، أو طبقة صوتية في تطبيق لا يحتاج إلى استنساخ، فهو خيار أخف وأبسط.
- استخدم Kokoro إذا: كان عبء عملك سردًا بسيطًا أو قراءة نص بصوت عالٍ، وتريد إبقاء VRAM الخاصة بـGPU لديك متاحة لنموذج لغوي كبير أو مهمة أخرى، أو كنت بحاجة إلى نشر يعتمد فقط على CPU.
- تجنّب Kokoro إذا: كنت بحاجة إلى استنساخ صوت — فهو لا يدعمه، استخدم XTTS v2 أو Chatterbox بدلًا من ذلك.
- VRAM: حوالي 2 جيجابايت عند التشغيل على GPU؛ يعمل بسرعة الوقت الفعلي على CPU وحدها، وفقًا لبطاقة نموذجه الخاصة.
- الأنسب لـ: حالات السرد البسيط وقراءة النص بصوت عالٍ حيث ستكون محركات الاستنساخ الأثقل مبالغة فعلًا.
جدول مقارنة الملاءمة مع GPU
يقيّم هذا الجدول المحركات الأربعة تحديدًا وفق معايير الملاءمة مع GPU — متطلبات VRAM، ومدى استفادة كل منها من تسريع CUDA، والقدرة على استنساخ الصوت، والترخيص — وليس وفق جودة الصوت الخام.
📍 في جملة واحدة
XTTS v2 أفضل لأعلى جودة استنساخ صوت؛ وChatterbox أفضل للاستنساخ الحواري الفوري التجاري؛ وBark أفضل للصوت التعبيري غير الكلامي؛ وKokoro أفضل عندما لا يكون الاستنساخ مطلوبًا وستُهدر GPU على هذه المهمة.
المحرك | VRAM (GPU) | فائدة سرعة GPU | استنساخ الصوت | الترخيص |
|---|---|---|---|---|
| XTTS v2 | 4-6 جيجابايت موصى بها | كبيرة — CPU غير عملي | نعم، مقطع 6 ثوانٍ / 17 لغة | CPML (غير تجاري) |
| Chatterbox | غير منشور رسميًا | كبيرة للاستخدام الفوري | نعم، بدون أمثلة مسبقة | MIT |
| Bark | حوالي 8-12 جيجابايت (صغير/كامل) | الأكبر بين الأربعة | لا | MIT |
| Kokoro | حوالي 2 جيجابايت، GPU اختيارية | صغيرة — سريع حتى على CPU | لا | Apache 2.0 |
كم من VRAM تحتاج فعليًا؟
تغطي GPU بذاكرة VRAM تبلغ 6 جيجابايت أو أكثر بارتياح كل المحركات في هذه المقارنة باستثناء النموذج الكامل لـBark، الذي يحتاج إلى حوالي 12 جيجابايت (أو حوالي 8 جيجابايت مع علامة النموذج الصغير). اختر بطاقتك بناءً على المحرك الذي تحتاجه فعليًا بدلًا من الشراء افتراضيًا للخيار الأثقل.
للحصول على إرشادات عامة حول اختيار GPU حسب مستوى VRAM لأعباء عمل الذكاء الاصطناعي المحلية (غير مخصصة لـTTS)، راجع دليل شراء GPU للنماذج اللغوية الكبيرة المحلية من PromptQuorum — نفس منطق الشراء القائم على أولوية VRAM ينطبق على TTS، وإذا كنت تشغّل بالفعل نموذجًا لغويًا كبيرًا محليًا إلى جانب TTS، فإن عبئي العمل يتنافسان على نفس مجمع VRAM.
- GPU للمبتدئين (6-8 جيجابايت VRAM): تغطي XTTS v2 بارتياح، وتغطي Bark فقط مع علامة النموذج الصغير، وتغطي Kokoro ونسخ Chatterbox الأصغر بسهولة.
- GPU متوسطة (12 جيجابايت VRAM أو أكثر): تغطي المحركات الأربعة، بما في ذلك النموذج الكامل لـBark، مع هامش لأعباء عمل أخرى.
- تشغيل TTS إلى جانب نموذج لغوي كبير محلي: خصّص VRAM للاثنين معًا — يحتاج نموذج 7B بتكميم Q4 وحده إلى حوالي 4-5 جيجابايت، لذا اجمعه مع XTTS v2 أو Kokoro بدلًا من النموذج الكامل لـBark، إلا إذا كانت بطاقتك تحتوي على 16 جيجابايت أو أكثر.
- إذا لم تكن متأكدًا، ابدأ بـKokoro أو XTTS v2 — كلاهما يتسع بارتياح ضمن 6 جيجابايت من VRAM، تاركًا مجالًا لإضافة محرك أثقل لاحقًا إذا نمت حالة استخدامك.
استنساخ الصوت والموافقة
استنساخ صوت شخص حقيقي دون علمه أو موافقته الصريحة مشكلة منفصلة عن الترخيص، وتنطبق بغض النظر عن المحرك أو الترخيص أو الوضع التجاري الذي تعمل بموجبه. XTTS v2 وChatterbox كلاهما أداتان قادرتان وعامّتا الاستخدام لاستنساخ الصوت؛ ولا تتحقق أي منهما من أن الصوت المرجعي الذي تقدّمه يعود إلى شخص وافق على استنساخ صوته.
قد يثير استنساخ صوت دون موافقة مسائل متعلقة بالموافقة، وحق نشر الصورة/الصوت، وفي بعض الولايات القضائية الاحتيال أو انتحال الشخصية، بغض النظر عمّا إذا كان مشروعك تجاريًا أو شخصيًا، وبغض النظر عن شروط ترخيص النموذج. هذه ملاحظة واقعية، وليست استشارة قانونية — استشر محاميًا إذا كنت تبني منتجًا يستنسخ أصوات أشخاص حقيقيين، واحصل دائمًا على موافقة واضحة وموثّقة من أي شخص تستنسخ صوته.
- احصل دائمًا على موافقة صريحة وموثّقة قبل استنساخ صوت شخص حقيقي، سواء للاستخدام الشخصي أو التجاري.
- تساعد العلامة المائية Perth المدمجة في Chatterbox في تتبع الصوت المُولَّد إلى الأداة، لكنها ليست بديلًا عن الموافقة ولا تتحقق بذاتها من التفويض.
- لا يُجري أي من XTTS v2 أو Chatterbox تحققًا من الموافقة — تقع هذه المسؤولية بالكامل على عاتق من يُشغّل الأداة.
الأسئلة الشائعة
هل أحتاج إلى GPU من NVIDIA لتشغيل محركات TTS المحلية؟
لا. يعمل Kokoro بسرعة الوقت الفعلي على CPU وحدها، وتعمل XTTS v2 وChatterbox وBark أيضًا على CPU — فقط بشكل أبطأ ملحوظ. الـGPU هي ما يجعل هذه الثلاثة عملية للاستخدام الفوري أو الدُفعي، وليست شرطًا صارمًا لتشغيلها أصلًا.
ما محرك TTS المحلي الذي يتمتع بأفضل استنساخ صوت؟
XTTS v2، الذي أصدرته Coqui، هو خيار استنساخ الصوت الأعلى جودة الذي تناولناه هنا — يستنسخ صوتًا من 6 ثوانٍ فقط من صوت مرجعي عبر 17 لغة. ترخيصه، Coqui Public Model License (CPML)، غير تجاري. أما Chatterbox، الذي أصدرته Resemble AI بموجب ترخيص MIT، فهو الخيار الأفضل إذا كنت بحاجة إلى استنساخ مناسب تجاريًا بزمن استجابة حواري فوري.
كم من VRAM يحتاج XTTS v2؟
تبلغ أوزان نموذج XTTS v2 حوالي 2 جيجابايت؛ و4 جيجابايت هي الحد الأدنى العملي لتشغيله، ويُنصح بـ4-6 جيجابايت للاستدلال الفوري، وفقًا لمراجعة XTTS v2 المخصصة من PromptQuorum.
كم من VRAM يحتاج Bark؟
يحتاج النموذج الكامل لـBark إلى حوالي 12 جيجابايت من VRAM؛ وضبط العلامة البيئية SUNO_USE_SMALL_MODELS يخفض ذلك إلى حوالي 8 جيجابايت. إنه الأثقل بين المحركات الأربعة المقارنة في هذا الدليل.
هل يمكنني استخدام Chatterbox تجاريًا؟
نعم. Chatterbox، الذي أصدرته Resemble AI، مرخّص بموجب MIT، الذي يسمح بالاستخدام التجاري دون اتفاقية منفصلة — على عكس ترخيص CPML غير التجاري الخاص بـXTTS v2.
هل GPU مبالغ فيها لـTTS المحلي؟
يعتمد ذلك على حالة استخدامك. إذا كنت تحتاج فقط إلى سرد بسيط أو قراءة نص بصوت عالٍ دون استنساخ صوت، فإن Kokoro (82 مليون معامل، Apache 2.0) يعمل بسرعة الوقت الفعلي على CPU وحدها، وشراء أو تخصيص GPU لهذه المهمة غير ضروري. إذا كنت بحاجة إلى استنساخ صوت أو صوت تعبيري غير كلامي، فإن GPU تحسّن بشكل ملموس XTTS v2 وChatterbox وBark.
ما الفرق بين XTTS v2 وChatterbox؟
ينتج XTTS v2 عمومًا استنساخات أعلى دقة ويدعم 17 لغة مع الاستنساخ عبر اللغات، لكن ترخيصه CPML غير تجاري. أما Chatterbox فهو نموذج أصغر (حوالي 0.5 مليار معامل في نسخته متعددة اللغات) مصمم لزمن استجابة حواري فوري، ويسمح ترخيصه MIT بالاستخدام التجاري.
هل يدعم Bark استنساخ الصوت؟
لا. وفقًا لوثائق Suno نفسها، لا يدعم Bark "حاليًا استنساخ الصوت المخصص". يمكنه توليد صوت تعبيري — ضحك، تنهدات، موسيقى بسيطة — مع إعدادات مسبقة قابلة للاختيار للمتحدث، لكنه لا يستطيع استنساخ صوت شخص عشوائي من تسجيل مرجعي كما يفعل XTTS v2 أو Chatterbox.
هل يمكنني تشغيل TTS ونموذج لغوي كبير محلي على نفس GPU؟
نعم، إذا خصّصت VRAM للاثنين. يحتاج نموذج 7B بتكميم Q4 وحده إلى حوالي 4-5 جيجابايت، لذا فإن دمجه مع XTTS v2 (4-6 جيجابايت) أو Kokoro (حوالي 2 جيجابايت) يتسع بارتياح على بطاقة بـ12 جيجابايت؛ أما دمج نموذج لغوي كبير مع النموذج الكامل لـBark (حوالي 12 جيجابايت) فيحتاج عمومًا إلى 16 جيجابايت أو أكثر من إجمالي VRAM.
هل أحتاج إلى موافقة لاستنساخ صوت شخص ما، حتى في مشروع شخصي؟
نعم. استنساخ صوت شخص حقيقي دون موافقته الصريحة والموثّقة يثير مسائل تتعلق بالموافقة وحق نشر الصورة/الصوت، بغض النظر عمّا إذا كان المشروع شخصيًا أو تجاريًا، وبغض النظر عن ترخيص المحرك المستخدم. هذه ملاحظة واقعية، وليست استشارة قانونية.
الحكم النهائي
بالنسبة للقراء الذين يمتلكون بالفعل GPU من NVIDIA ويريدون استخدامها لتحويل النص إلى كلام، يعتمد الاختيار على ما يحتاجه الصوت. XTTS v2 هو الخيار لأعلى جودة استنساخ صوت يمكن تحقيقها في سياق غير تجاري أو بحثي، نظرًا لترخيصه CPML غير التجاري. Chatterbox هو الخيار عندما يجب أن تُشحن قدرة الاستنساخ نفسها في منتج تجاري، بفضل ترخيصه MIT وأحجام نماذجه الأصغر الموجهة نحو الوقت الفعلي. Bark هو الخيار تحديدًا عندما يحتاج المشروع إلى صوت تعبيري غير كلامي — ضحك، تنهدات، موسيقى بسيطة — ويمكنه إنفاق 8-12 جيجابايت من VRAM للحصول عليه، مع التحفظ بأن حالة صيانته غير مؤكدة. يبقى Kokoro الخيار الصحيح كلما لم يكن الاستنساخ مطلوبًا: فهو يعمل بارتياح على CPU وحدها، لذا نادرًا ما يستحق تخصيص VRAM من GPU له. إذا لم تكن متأكدًا، ابدأ بـKokoro للسرد البسيط وانتقل إلى XTTS v2 أو Chatterbox فقط عندما تظهر حاجة استنساخ حقيقية — وهذا يبقي VRAM الخاصة بـGPU لديك متاحة لكل ما تشغّله بجانبها، بما في ذلك نموذج لغوي كبير محلي. للاطلاع على تفاصيل الترخيص لكل محرك مذكور هنا، راجع دليل تراخيص TTS واستنساخ الصوت المحلية من PromptQuorum.
المصادر
- XTTS v2 على Hugging Face — بطاقة النموذج: متطلبات الاستنساخ، اللغات، ومرجع الترخيص.
- Resemble AI: Chatterbox — نظرة عامة رسمية على النموذج، الترخيص، وعدد المعاملات.
- resemble-ai/chatterbox على GitHub — README: التثبيت، ترخيص MIT، العلامة المائية، ودعم CPU/GPU.
- suno-ai/bark على GitHub — README: الترخيص، علامة VRAM/النموذج الصغير، وسجل الصيانة/التعديلات.
- Kokoro-82M على Hugging Face — بطاقة النموذج: عدد المعاملات، ترخيص Apache 2.0، وأداء CPU/GPU.
- مراجعة XTTS v2 — مراجعة PromptQuorum المخصصة مع أوامر استخدام كاملة وتفاصيل الترخيص.
- مراجعة Bark TTS — مراجعة PromptQuorum المخصصة مع أرقام VRAM وحالة الصيانة.
- تراخيص TTS واستنساخ الصوت المحلية — مقارنة كاملة للتراخيص وVRAM عبر محركات TTS المحلية.