Conclusiones clave
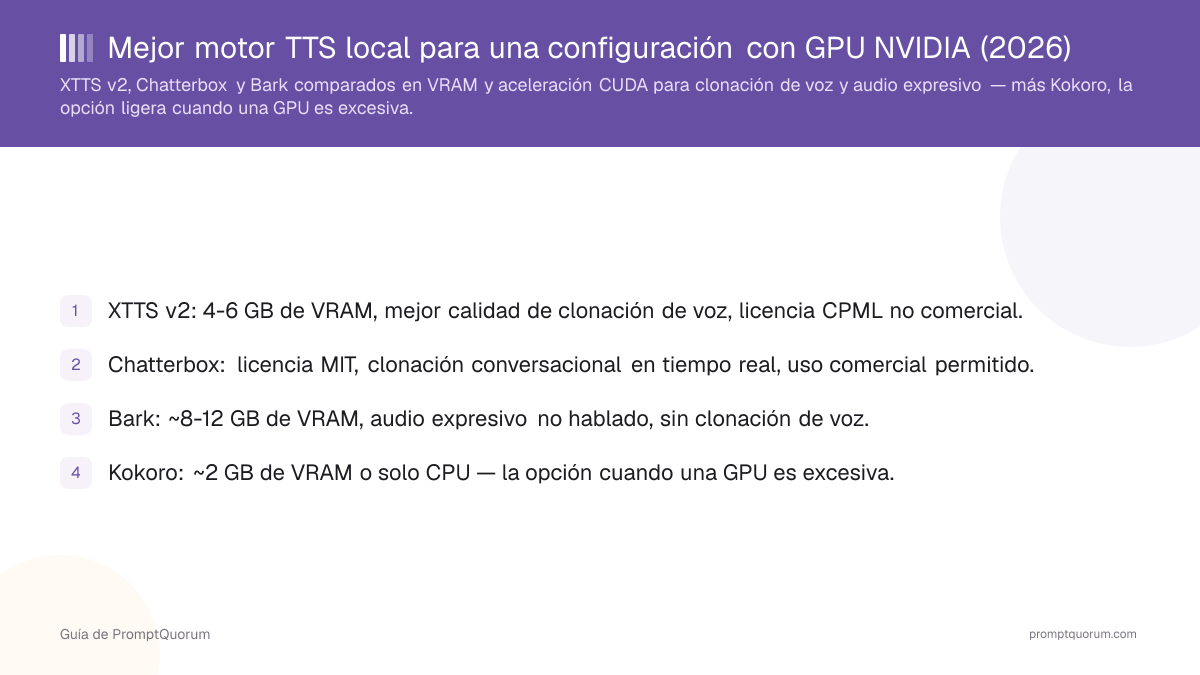
- XTTS v2: mejor calidad de clonación (clip de referencia de 6 segundos, 17 idiomas), 4-6 GB de VRAM recomendados, licencia CPML no comercial.
- Chatterbox: clonación conversacional en tiempo real, modelo pequeño de ~0,5B de parámetros, licencia MIT (uso comercial permitido).
- Bark: sonidos expresivos no vocales, sin clonación de voz, mayor consumo de VRAM de los cuatro, licencia MIT, mantenimiento incierto.
- Kokoro: 82M de parámetros, Apache 2.0, funciona bien solo con CPU — el contraejemplo que no exige GPU.
- Los tres motores orientados a GPU funcionan en CPU, pero con un coste de velocidad real — esa diferencia es la razón principal para tener una GPU en este caso de uso.
- La clonación de voz requiere el consentimiento de la persona clonada, sin importar el motor o la licencia que uses.
📍 En una frase
En una GPU NVIDIA, XTTS v2 ofrece la mejor calidad de clonación de voz, Chatterbox la mejor clonación conversacional en tiempo real bajo una licencia MIT apta para uso comercial, Bark el audio no vocal más expresivo, y Kokoro sigue siendo la opción correcta cuando una GPU no es realmente necesaria.
💬 En términos simples
Si tienes una tarjeta gráfica capaz de ejecutar cargas de trabajo de IA, tres motores de texto a voz (XTTS v2, Chatterbox, Bark) realmente se vuelven más rápidos y mejores gracias a ella, mientras que un cuarto (Kokoro) apenas necesita la GPU — cuál instalar depende de si necesitas clonación de voz, cuánta memoria de vídeo tienes y si planeas usarlo comercialmente.
📌Nota: Esta guía asume que ya tienes una GPU NVIDIA y estás decidiendo qué ejecutar en ella. Para una configuración solo con CPU (Raspberry Pi, sin GPU dedicada), Piper es la opción estándar — consulta la comparativa completa de licencias y VRAM de PromptQuorum para todos los motores TTS locales, enlazada en Lecturas relacionadas.
¿Qué motores realmente necesitan una GPU?
XTTS v2, Chatterbox y Bark funcionan todos en CPU, pero una GPU es lo que los hace prácticos para uso en tiempo real o por lotes — Kokoro es la excepción, ya que sus 82 millones de parámetros lo hacen rápido solo con CPU. Los tres motores más pesados comparten una característica: son modelos centrados en la calidad de clonación o generación, cuya arquitectura intercambia cómputo por expresividad, por lo que la aceleración CUDA elimina el cuello de botella en lugar de aportar solo una mejora marginal.
Usa un motor orientado a GPU (XTTS v2, Chatterbox o Bark) si tu caso de uso es clonación de voz, audio expresivo no vocal, o cualquier tarea donde importe la velocidad de generación — un trabajo de narración por lotes, una aplicación de voz interactiva, o una canalización que genera muchos clips. Evita gastar VRAM de GPU en TTS si solo necesitas narración simple de texto plano sin clonación: Kokoro o Piper cubren ese caso solo con CPU, dejando tu VRAM libre para un LLM u otra tarea en paralelo.
- XTTS v2 funciona en CPU pero está documentado como notablemente más lento allí — su latencia de streaming inferior a 200 ms es una cifra con aceleración GPU, no de CPU.
- Chatterbox incluye una variante Nano compatible con CPU (110M de parámetros) que la propia documentación de Resemble AI describe como más rápida que tiempo real en 8 núcleos de CPU, pero las variantes más grandes centradas en clonación se benefician de CUDA para uso conversacional en tiempo real.
- Bark afirma explícitamente en su propia documentación que la inferencia en CPU o GPU antiguas puede ser significativamente más lenta que la velocidad casi en tiempo real que alcanza en GPU de nivel empresarial.
- Kokoro es la excepción: con 82 millones de parámetros, funciona a velocidad de tiempo real o superior solo con CPU, según su propia ficha de modelo en Hugging Face, y solo necesita una GPU para margen adicional en generación por lotes de alto volumen.
XTTS v2: mejor calidad de clonación de voz
XTTS v2, publicado por Coqui y ejecutado a través del conjunto de herramientas Coqui TTS, es la mejor opción de clonación de voz local para propietarios de GPU que necesitan la mayor calidad alcanzable a partir de un clip de referencia corto. Clona una voz a partir de tan solo 6 segundos de audio de referencia y la reproduce en 17 idiomas, incluyendo clonación entre idiomas — clonar una voz a partir de audio en inglés y hablar el resultado en español o japonés.
En cuanto a VRAM, los pesos del modelo de XTTS v2 rondan los 2 GB, pero 4 GB es el mínimo práctico para ejecutarlo, y se recomiendan 4-6 GB para inferencia en tiempo real, según la reseña de XTTS v2 dedicada de PromptQuorum. La licencia es el factor decisivo para la mayoría de lectores: la Coqui Public Model License (CPML) es explícitamente no comercial, y como Coqui AI, la empresa, cerró sus servicios de pago en diciembre de 2023, actualmente no hay una vía confirmada hacia una licencia comercial.
- Usa XTTS v2 si: tu proyecto es personal, académico o un prototipo no comercial y quieres la mejor calidad de clonación disponible localmente.
- Evita XTTS v2 si: necesitas una licencia comercial — sus términos CPML son no comerciales, sin una vía de licencia activa confirmada desde el cierre de Coqui AI en 2023.
- VRAM: ~2 GB de pesos del modelo, 4 GB mínimo, 4-6 GB recomendados para inferencia en tiempo real.
- Ideal para: clonación de voz local de la más alta fidelidad, soporte translingüe de 17 idiomas, uso no comercial o de investigación.
Chatterbox: mejor clonación en tiempo real
Chatterbox, publicado por Resemble AI en GitHub, es la mejor opción para propietarios de GPU que quieren clonación de voz conversacional en tiempo real bajo una licencia totalmente permisiva y apta para uso comercial. Está bajo la licencia MIT, que — a diferencia de la CPML no comercial de XTTS v2 — permite el uso comercial sin un acuerdo aparte.
Chatterbox viene en varios tamaños: una variante Nano (110 millones de parámetros) que la propia documentación de Resemble AI describe como más rápida que tiempo real en 8 núcleos de CPU, una variante Turbo (350 millones de parámetros) diseñada para baja latencia, y una variante multilingüe (unos 500 millones de parámetros, sobre una arquitectura que atribuye a Llama 3) que admite más de 20 idiomas. La clonación de voz zero-shot funciona a partir de un clip de audio de referencia — el ejemplo oficial de Resemble AI usa un clip de 10 segundos, aunque el README no indica una duración mínima oficial como sí hace el de XTTS v2.
El README público de Resemble AI no publica una cifra exacta de VRAM, así que trata cualquier número específico en GB que veas en otro lugar como no verificado hasta que lo pruebes en tu propia tarjeta. Lo documentado es: la variante Nano funciona aceptablemente solo con CPU, mientras que las variantes más grandes Turbo y Multilingual están diseñadas para generación acelerada por GPU y baja latencia — se admiten tanto CUDA como Apple Silicon (MPS).
- Usa Chatterbox si: necesitas clonación de voz apta para uso comercial con latencia en tiempo real o casi en tiempo real, como una aplicación de voz interactiva.
- Evita Chatterbox si: necesitas una cifra de VRAM mínima documentada y garantizada antes de comprar hardware — Resemble AI no ha publicado una.
- VRAM: no publicada oficialmente; la variante Nano, más pequeña, es compatible con CPU, mientras que las variantes Turbo y Multilingual apuntan a aceleración GPU para velocidad de tiempo real.
- Ideal para: productos comerciales que necesiten clonación de voz conversacional zero-shot bajo una licencia permisiva.
- Cada salida de Chatterbox lleva la marca de agua Perth propia de Resemble AI, descrita en su documentación como una marca de agua neuronal imperceptible que sobrevive a la compresión MP3 — una señal de procedencia integrada, no un sustituto del consentimiento (ver la sección Clonación de voz y consentimiento más abajo).
Bark: mejor audio expresivo no vocal
Bark, publicado por Suno en GitHub, es la opción adecuada si quieres más que voz — risas, suspiros, jadeos y música simple generados solo a partir de instrucciones de texto — y es el motor de esta comparativa que más se beneficia de una GPU, ya que su arquitectura generativa, token por token, es la más lenta de los cuatro sin aceleración CUDA. No admite clonación de voz personalizada; según la propia documentación de Suno, "actualmente no admite clonación de voz personalizada".
En cuanto a VRAM, la reseña de Bark dedicada de PromptQuorum documenta que el modelo completo necesita unos 12 GB, con una variable de entorno para modelo pequeño (SUNO_USE_SMALL_MODELS) que lo reduce a unos 8 GB — notablemente más que los 4-6 GB de XTTS v2. Está bajo licencia MIT, plenamente apta para uso comercial desde el 1 de mayo de 2023, pero su estado de mantenimiento es una pregunta abierta real: el repositorio público de GitHub no muestra confirmaciones (commits) desde el 5 de abril de 2024.
- Usa Bark si: necesitas audio no vocal (risas, suspiros, sonido ambiental) junto con voz y dispones de 8-12 GB de VRAM.
- Evita Bark si: necesitas una salida fiable y determinista para una canalización de producción, o necesitas clonación de voz — Bark no la admite.
- VRAM: ~12 GB para el modelo completo, ~8 GB con la variable de modelo pequeño — el más exigente de los cuatro motores comparados aquí.
- Ideal para: generación de audio expresivo, efectos de sonido combinados con voz, prototipado y uso en investigación.
Kokoro: cuando una GPU es excesiva
Kokoro aparece aquí como contraejemplo: tener una GPU NVIDIA no significa que toda carga de TTS necesite una, y Kokoro lo demuestra. Con 82 millones de parámetros, es drásticamente más pequeño que XTTS v2, Chatterbox o Bark, y su propia ficha de modelo en Hugging Face documenta síntesis en tiempo real o más rápida solo con CPU, con el uso de GPU añadiendo margen en lugar de ser un requisito.
Kokoro tiene licencia Apache 2.0, que — como la licencia MIT de Chatterbox — permite uso comercial sin restricciones. No admite clonación de voz, por lo que no sustituye a XTTS v2 o Chatterbox si la clonación es el requisito, pero para narración simple, lectura de texto en voz alta, o una capa de voz en una aplicación donde no se necesita clonación, es una opción más ligera y sencilla.
- Usa Kokoro si: tu carga de trabajo es narración simple o lectura de texto, quieres mantener libre la VRAM de tu GPU para un LLM u otra tarea, o necesitas un despliegue solo con CPU.
- Evita Kokoro si: necesitas clonación de voz — no la admite, usa XTTS v2 o Chatterbox en su lugar.
- VRAM: aproximadamente 2 GB si se ejecuta en GPU; funciona a velocidad de tiempo real solo con CPU, según su propia ficha de modelo.
- Ideal para: narración simple y casos de lectura de texto en voz alta donde los motores de clonación más pesados serían realmente excesivos.
Tabla comparativa de idoneidad GPU
Esta tabla puntúa a los cuatro motores específicamente en criterios de idoneidad para GPU — requisito de VRAM, cuánto se beneficia cada uno de la aceleración CUDA, capacidad de clonación de voz y licencia — no en calidad de audio en bruto.
📍 En una frase
XTTS v2 es mejor para la clonación de voz de mayor calidad; Chatterbox es mejor para clonación conversacional comercial en tiempo real; Bark es mejor para audio expresivo no vocal; Kokoro es mejor cuando no se necesita clonación y una GPU se desperdiciaría en la tarea.
Motor | VRAM (GPU) | Beneficio de velocidad GPU | Clonación de voz | Licencia |
|---|---|---|---|---|
| XTTS v2 | 4-6 GB recomendados | Grande — CPU poco práctico | Sí, clip 6s / 17 idiomas | CPML (no comercial) |
| Chatterbox | No publicado oficialmente | Grande para uso en tiempo real | Sí, zero-shot | MIT |
| Bark | ~8-12 GB (pequeño/completo) | El mayor de los cuatro | No | MIT |
| Kokoro | ~2 GB, GPU opcional | Pequeño — rápido también en CPU | No | Apache 2.0 |
¿Cuánta VRAM necesitas realmente?
Una GPU con 6 GB de VRAM o más cubre cómodamente todos los motores de esta comparativa excepto el modelo completo de Bark, que necesita unos 12 GB (o unos 8 GB con su variable de modelo pequeño). Ajusta tu tarjeta al motor que realmente necesitas en lugar de comprar por defecto para la opción más pesada.
Para orientación general sobre cómo elegir una GPU por nivel de VRAM para cargas de IA local (no específicas de TTS), consulta la guía de compra de GPU para LLM locales de PromptQuorum — la misma lógica de compra centrada en VRAM se aplica al TTS, y si ya ejecutas un LLM local junto al TTS, ambas cargas compiten por el mismo grupo de VRAM.
- GPU de entrada (6-8 GB de VRAM): cubre XTTS v2 cómodamente, cubre Bark solo con la variable de modelo pequeño, cubre Kokoro y las variantes más pequeñas de Chatterbox sin problema.
- GPU de gama media (12+ GB de VRAM): cubre los cuatro motores, incluido el modelo completo de Bark, con margen para otras tareas.
- Ejecutar TTS junto a un LLM local: presupuesta VRAM para ambos — un LLM de 7B con cuantización Q4 necesita por sí solo unos 4-5 GB, así que combínalo con XTTS v2 o Kokoro en lugar del modelo completo de Bark, a menos que tu tarjeta tenga 16 GB o más.
- Si tienes dudas, empieza con Kokoro o XTTS v2 — ambos caben cómodamente en 6 GB de VRAM, dejando espacio para añadir un motor más pesado más adelante si tu caso de uso crece.
Clonación de voz y consentimiento
Clonar la voz de una persona real sin su conocimiento o consentimiento explícito es un problema distinto de la licencia, y se aplica sin importar el motor, la licencia o el estado comercial bajo el que operes. XTTS v2 y Chatterbox son ambos herramientas de clonación de voz capaces y de uso general; ninguno de los dos verifica que el audio de referencia que proporcionas pertenezca a alguien que haya aceptado ser clonado.
Clonar una voz sin consentimiento puede plantear problemas de consentimiento, derecho de imagen y, en algunas jurisdicciones, fraude o suplantación de identidad, independientemente de si tu proyecto es comercial o personal, y de las condiciones de licencia del modelo. Esta es una nota factual, no asesoría legal — consulta a un abogado si estás construyendo un producto que clona voces de personas reales, y obtén siempre un consentimiento claro y documentado de cualquier persona cuya voz clones.
- Obtén siempre consentimiento explícito y documentado antes de clonar la voz de una persona real, tanto para uso personal como comercial.
- La marca de agua Perth integrada de Chatterbox ayuda a rastrear el audio generado hasta la herramienta, pero no sustituye al consentimiento ni verifica por sí misma la autorización.
- Ni XTTS v2 ni Chatterbox realizan verificación de consentimiento — esa responsabilidad recae por completo en quien opera la herramienta.
Preguntas frecuentes
¿Necesito una GPU NVIDIA para ejecutar motores TTS locales?
No. Kokoro funciona a velocidad de tiempo real solo con CPU, y XTTS v2, Chatterbox y Bark también funcionan en CPU — solo que notablemente más lento. Una GPU es lo que hace prácticos a estos tres para uso en tiempo real o por lotes, no un requisito estricto para ejecutarlos en absoluto.
¿Qué motor TTS local tiene la mejor clonación de voz?
XTTS v2, publicado por Coqui, es la opción de clonación de voz de mayor calidad tratada aquí — clona una voz a partir de tan solo 6 segundos de audio de referencia en 17 idiomas. Su licencia, la Coqui Public Model License (CPML), es no comercial. Chatterbox, publicado por Resemble AI bajo licencia MIT, es la mejor opción si necesitas clonación apta para uso comercial con latencia conversacional en tiempo real.
¿Cuánta VRAM necesita XTTS v2?
Los pesos del modelo de XTTS v2 rondan los 2 GB; 4 GB es el mínimo práctico para ejecutarlo, y se recomiendan 4-6 GB para inferencia en tiempo real, según la reseña de XTTS v2 dedicada de PromptQuorum.
¿Cuánta VRAM necesita Bark?
El modelo completo de Bark necesita unos 12 GB de VRAM; definir la variable de entorno SUNO_USE_SMALL_MODELS reduce eso a unos 8 GB. Es el más exigente de los cuatro motores comparados en esta guía.
¿Puedo usar Chatterbox comercialmente?
Sí. Chatterbox, publicado por Resemble AI, tiene licencia MIT, que permite uso comercial sin un acuerdo aparte — a diferencia de la licencia CPML no comercial de XTTS v2.
¿Es excesiva una GPU para TTS local?
Depende de tu caso de uso. Si solo necesitas narración simple o lectura de texto sin clonación de voz, Kokoro (82M de parámetros, Apache 2.0) funciona a velocidad de tiempo real solo con CPU, y comprar o dedicar una GPU para esa tarea es innecesario. Si necesitas clonación de voz o audio expresivo no vocal, una GPU mejora notablemente XTTS v2, Chatterbox y Bark.
¿Cuál es la diferencia entre XTTS v2 y Chatterbox?
XTTS v2 generalmente produce clones de mayor fidelidad y admite 17 idiomas con clonación translingüe, pero su licencia CPML es no comercial. Chatterbox es un modelo más pequeño (unos 0,5 mil millones de parámetros en su variante Multilingual) diseñado para latencia conversacional en tiempo real, y su licencia MIT permite uso comercial.
¿Bark admite clonación de voz?
No. Según la propia documentación de Suno, Bark "actualmente no admite clonación de voz personalizada". Puede generar audio expresivo — risas, suspiros, música simple — con preajustes de voz seleccionables, pero no puede clonar la voz de una persona arbitraria a partir de una grabación de referencia como sí hacen XTTS v2 o Chatterbox.
¿Puedo ejecutar TTS y un LLM local en la misma GPU?
Sí, si presupuestas VRAM para ambos. Un LLM de 7B con cuantización Q4 necesita por sí solo unos 4-5 GB, por lo que combinarlo con XTTS v2 (4-6 GB) o Kokoro (~2 GB) cabe cómodamente en una tarjeta de 12 GB; combinar un LLM con el modelo completo de Bark (~12 GB) generalmente necesita 16 GB o más de VRAM total.
¿Necesito consentimiento para clonar la voz de alguien, incluso para un proyecto personal?
Sí. Clonar la voz de una persona real sin su consentimiento explícito y documentado plantea problemas de consentimiento y derecho de imagen, sin importar si el proyecto es personal o comercial, y sin importar la licencia del motor que uses. Esta es una nota factual, no asesoría legal.
Veredicto
Para lectores que ya tienen una GPU NVIDIA y quieren usarla para texto a voz, la elección depende de lo que el audio necesite hacer. XTTS v2 es la opción para la mayor calidad de clonación de voz alcanzable en un contexto no comercial o de investigación, dada su licencia CPML no comercial. Chatterbox es la opción cuando esa misma capacidad de clonación necesita llevarse a un producto comercial, gracias a su licencia MIT y sus tamaños de modelo más pequeños orientados al tiempo real. Bark es la opción específicamente cuando el proyecto necesita audio expresivo no vocal — risas, suspiros, música simple — y puede permitirse gastar 8-12 GB de VRAM para conseguirlo, con la salvedad de que su estado de mantenimiento es incierto. Kokoro sigue siendo la opción correcta siempre que la clonación no sea el requisito: funciona cómodamente solo con CPU, así que reservar VRAM de GPU para él rara vez merece la pena. Si tienes dudas, empieza con Kokoro para narración simple y sube a XTTS v2 o Chatterbox solo cuando aparezca un requisito real de clonación — eso mantiene la VRAM de tu GPU disponible para lo que sea que ejecutes junto a ello, incluido un LLM local. Para los detalles de licencia de cada motor mencionado aquí, consulta la guía de licencias de TTS y clonación de voz locales de PromptQuorum.
Fuentes
- XTTS v2 en Hugging Face — ficha de modelo: requisitos de clonación, idiomas y referencia de licencia.
- Resemble AI: Chatterbox — presentación oficial del modelo, licencia y número de parámetros.
- resemble-ai/chatterbox en GitHub — README: instalación, licencia MIT, marca de agua y soporte CPU/GPU.
- suno-ai/bark en GitHub — README: licencia, variable de VRAM/modelo pequeño e historial de mantenimiento/commits.
- Kokoro-82M en Hugging Face — ficha de modelo: número de parámetros, licencia Apache 2.0 y rendimiento CPU/GPU.
- Reseña de XTTS v2 — la reseña dedicada de PromptQuorum con comandos de uso completos y detalles de licencia.
- Reseña de Bark TTS — la reseña dedicada de PromptQuorum con cifras de VRAM y estado de mantenimiento.
- Licencias de TTS y clonación de voz locales — comparativa completa de licencias y VRAM entre motores TTS locales.