Wichtigste Erkenntnisse
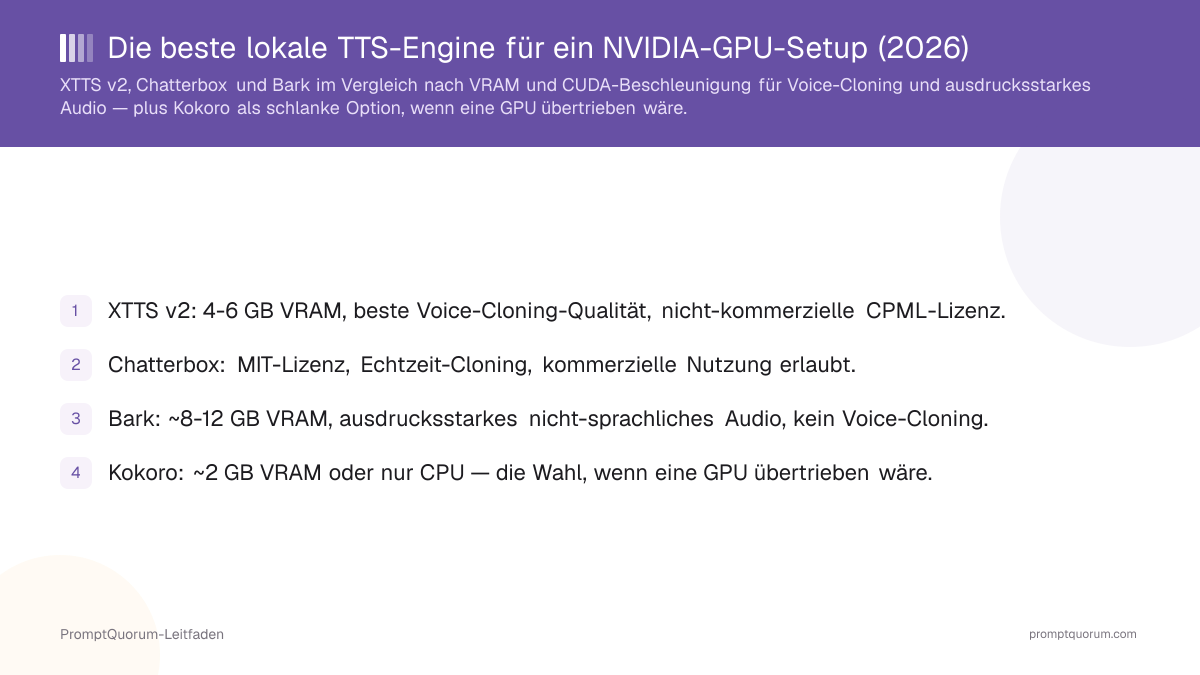
- XTTS v2: beste Cloning-Qualität (6-Sekunden-Referenzclip, 17 Sprachen), 4-6 GB VRAM empfohlen, nicht-kommerzielle CPML-Lizenz.
- Chatterbox: Echtzeit-Konversations-Cloning, kleines ~0,5B-Parameter-Modell, MIT-Lizenz (kommerzielle Nutzung möglich).
- Bark: ausdrucksstarke, nicht-sprachliche Töne, kein Voice-Cloning, größter VRAM-Bedarf der vier Engines, MIT-Lizenz, ungewisse Wartung.
- Kokoro: 82M Parameter, Apache-2.0, läuft gut allein auf der CPU — das GPU-optionale Gegenbeispiel.
- Alle drei GPU-orientierten Engines laufen auf der CPU, aber mit echtem Geschwindigkeitsverlust — dieser Unterschied ist der eigentliche Grund, für diesen Zweck eine GPU zu besitzen.
- Voice-Cloning erfordert die Zustimmung der geklonten Person, unabhängig von Engine oder Lizenz.
📍 In einem Satz
Auf einer NVIDIA-GPU liefert XTTS v2 die beste Voice-Cloning-Qualität, Chatterbox das beste Echtzeit-Konversations-Cloning unter einer kommerzialisierbaren MIT-Lizenz, Bark das ausdrucksstärkste nicht-sprachliche Audio, und Kokoro bleibt die richtige Wahl, wenn eine GPU eigentlich gar nicht nötig ist.
💬 In einfachen Worten
Wenn Sie eine Grafikkarte besitzen, die KI-Workloads ausführen kann, werden drei Text-zu-Sprache-Engines (XTTS v2, Chatterbox, Bark) dadurch tatsächlich schneller und besser, während eine vierte (Kokoro) die GPU kaum benötigt — welche Sie installieren sollten, hängt davon ab, ob Sie Voice-Cloning brauchen, wie viel Videospeicher Sie haben und ob Sie es kommerziell einsetzen wollen.
📌Hinweis: Dieser Leitfaden geht davon aus, dass Sie bereits eine NVIDIA-GPU besitzen und entscheiden, was darauf laufen soll. Für ein reines CPU-Setup (Raspberry Pi, keine dedizierte GPU) ist Piper die Standardwahl — siehe PromptQuorums vollständigen Lizenz- und VRAM-Vergleich über alle lokalen TTS-Engines hinweg, verlinkt unter Weiterführende Artikel.
Welche Engines brauchen tatsächlich eine GPU?
XTTS v2, Chatterbox und Bark laufen alle auf der CPU, doch erst eine GPU macht sie für Echtzeit- oder Batch-Nutzung praktikabel — Kokoro ist die Ausnahme, da seine 82 Millionen Parameter es auch allein auf der CPU schnell machen. Die drei schwereren Engines teilen eine gemeinsame Eigenschaft: Es sind Cloning- oder generierungsqualitätsorientierte Modelle, deren Architektur Rechenleistung gegen Ausdrucksstärke eintauscht — CUDA-Beschleunigung beseitigt hier den Engpass, statt nur einen marginalen Geschwindigkeitsgewinn zu bringen.
Nutzen Sie eine GPU-orientierte Engine (XTTS v2, Chatterbox oder Bark), wenn Ihr Anwendungsfall Voice-Cloning, ausdrucksstarkes nicht-sprachliches Audio oder jede Aufgabe ist, bei der die Generierungsgeschwindigkeit zählt — ein Batch-Vertonungsjob, eine interaktive Sprachanwendung oder eine Pipeline, die viele Clips erzeugt. Verschwenden Sie keinen GPU-VRAM auf TTS, wenn Sie nur einfache Vertonung von reinem Text ohne Cloning benötigen: Kokoro oder Piper decken diesen Fall allein auf der CPU ab und geben Ihren VRAM für ein LLM oder eine andere parallel laufende Aufgabe frei.
- XTTS v2 läuft auf der CPU, ist dort aber dokumentiert merklich langsamer — seine Streaming-Latenz unter 200 ms ist ein GPU-beschleunigter Wert, kein CPU-Wert.
- Chatterbox liefert eine CPU-fähige Nano-Variante (110M Parameter), die laut Resemble AIs eigener Dokumentation auf 8 CPU-Kernen schneller als Echtzeit läuft, doch die größeren, auf Cloning ausgelegten Varianten profitieren für Echtzeit-Konversationsnutzung von CUDA.
- Bark erklärt in seiner eigenen Dokumentation ausdrücklich, dass Inferenz auf CPU oder älteren GPUs deutlich langsamer sein kann als die annähernde Echtzeitgeschwindigkeit, die es auf Enterprise-GPUs erreicht.
- Kokoro ist der Ausreißer: Mit 82 Millionen Parametern läuft es laut seiner Hugging-Face-Model-Card allein auf der CPU in Echtzeit oder schneller und braucht eine GPU nur für zusätzlichen Spielraum bei hochvolumiger Batch-Generierung.
XTTS v2: beste Voice-Cloning-Qualität
XTTS v2, veröffentlicht von Coqui und ausgeführt über das Coqui-TTS-Toolkit, ist die beste lokale Voice-Cloning-Option für GPU-Besitzer, die die höchste aus einem kurzen Referenzclip erreichbare Qualität benötigen. Es klont eine Stimme aus nur 6 Sekunden Referenzaudio und spricht sie in 17 Sprachen zurück, einschließlich sprachübergreifendem Cloning — eine Stimme aus englischem Audio klonen und auf Spanisch oder Japanisch sprechen lassen.
Beim VRAM betragen XTTS v2s Modellgewichte etwa 2 GB, doch 4 GB sind das praktische Minimum zum Ausführen, und 4-6 GB werden für Echtzeit-Inferenz empfohlen, laut PromptQuorums dediziertem XTTS-v2-Test. Die Lizenz ist für die meisten Leser der entscheidende Faktor: Die Coqui Public Model License (CPML) ist ausdrücklich nicht-kommerziell, und da Coqui AI, das Unternehmen, seine kostenpflichtigen Dienste im Dezember 2023 einstellte, gibt es derzeit keinen bestätigten aktiven Weg zu einer kommerziellen Lizenz.
- Nutzen Sie XTTS v2, wenn: Ihr Projekt privat, akademisch oder ein nicht-kommerzieller Prototyp ist und Sie die beste lokal verfügbare Cloning-Qualität wollen.
- Vermeiden Sie XTTS v2, wenn: Sie eine kommerzielle Lizenz benötigen — seine CPML-Bedingungen sind nicht-kommerziell, ohne bestätigten aktiven Lizenzweg seit Coqui AIs Schließung 2023.
- VRAM: ~2 GB Modellgewichte, 4 GB Minimum, 4-6 GB empfohlen für Echtzeit-Inferenz.
- Am besten für: höchste Treue beim lokalen Voice-Cloning, sprachübergreifende Unterstützung für 17 Sprachen, nicht-kommerzielle oder Forschungsnutzung.
Chatterbox: bestes Echtzeit-Cloning
Chatterbox, veröffentlicht von Resemble AI auf GitHub, ist die beste Wahl für GPU-Besitzer, die Echtzeit-Konversations-Voice-Cloning unter einer vollständig freizügigen, kommerzialisierbaren Lizenz wollen. Es steht unter der MIT-Lizenz, die — anders als XTTS v2s nicht-kommerzielle CPML — kommerzielle Nutzung ohne separate Vereinbarung erlaubt.
Chatterbox erscheint in mehreren Größen: eine Nano-Variante (110 Millionen Parameter), die laut Resemble AIs eigener Dokumentation auf 8 CPU-Kernen schneller als Echtzeit läuft, eine Turbo-Variante (350 Millionen Parameter) für niedrige Latenz, und eine mehrsprachige Variante (rund 500 Millionen Parameter, auf einem Backbone, das Llama 3 in seiner Architektur nennt), die über 20 Sprachen unterstützt. Zero-Shot-Voice-Cloning funktioniert aus einem Referenzaudioclip — Resemble AIs eigenes Beispiel nutzt einen 10-Sekunden-Clip, wobei das README keine offizielle Mindestdauer wie bei XTTS v2 angibt.
Resemble AIs öffentliches README veröffentlicht keinen exakten VRAM-Wert — behandeln Sie jede spezifische GB-Zahl, die Sie anderswo sehen, als unbestätigt, bis Sie sie auf Ihrer eigenen Karte testen. Dokumentiert ist: Die Nano-Variante läuft akzeptabel allein auf der CPU, während die größeren Turbo- und Multilingual-Varianten für GPU-beschleunigte, latenzarme Generierung ausgelegt sind — sowohl CUDA als auch Apple Silicon (MPS) werden unterstützt.
- Nutzen Sie Chatterbox, wenn: Sie kommerziell nutzbares Voice-Cloning mit Echtzeit- oder Nahe-Echtzeit-Latenz benötigen, etwa für eine interaktive Sprachanwendung.
- Vermeiden Sie Chatterbox, wenn: Sie vor dem Hardwarekauf eine dokumentierte, garantierte VRAM-Mindestangabe benötigen — Resemble AI hat keine veröffentlicht.
- VRAM: nicht offiziell veröffentlicht; die kleinere Nano-Variante ist CPU-fähig, während Turbo- und Multilingual-Varianten auf GPU-Beschleunigung für Echtzeitgeschwindigkeit zielen.
- Am besten für: kommerzielle Produkte, die Zero-Shot-Konversations-Voice-Cloning unter einer freizügigen Lizenz benötigen.
- Jede Chatterbox-Ausgabe trägt Resemble AIs eigenes Perth-Wasserzeichen, laut Dokumentation ein nicht wahrnehmbares neuronales Wasserzeichen, das MP3-Kompression übersteht — ein eingebautes Herkunftssignal, kein Ersatz für Einwilligung (siehe Abschnitt Voice-Cloning und Einwilligung unten).
Bark: bestes ausdrucksstarkes, nicht-sprachliches Audio
Bark, veröffentlicht von Suno auf GitHub, ist die richtige Wahl, wenn Sie mehr als Sprache wollen — Lachen, Seufzer, Keuchen und einfache Musik, erzeugt allein aus Textprompts — und es ist die Engine in diesem Vergleich, die am meisten von einer GPU profitiert, da seine generative, Token-für-Token-Architektur ohne CUDA-Beschleunigung die langsamste der vier ist. Es unterstützt kein individuelles Voice-Cloning; laut Sunos eigener Dokumentation „unterstützt es derzeit kein individuelles Voice-Cloning".
Beim VRAM dokumentiert PromptQuorums dedizierter Bark-Test, dass das volle Modell etwa 12 GB benötigt, wobei eine Umgebungsvariable für ein kleines Modell (SUNO_USE_SMALL_MODELS) das auf etwa 8 GB reduziert — merklich mehr als XTTS v2s 4-6 GB. Es steht unter der MIT-Lizenz, seit dem 1. Mai 2023 vollständig kommerziell nutzbar, doch sein Wartungsstatus ist eine echte offene Frage: Das öffentliche GitHub-Repository zeigt keine Commits seit dem 5. April 2024.
- Nutzen Sie Bark, wenn: Sie neben Sprache nicht-sprachliches Audio (Lachen, Seufzer, Umgebungsgeräusche) benötigen und 8-12 GB VRAM übrig haben.
- Vermeiden Sie Bark, wenn: Sie zuverlässige, deterministische Ausgaben für eine Produktionspipeline benötigen, oder Sie Voice-Cloning brauchen — das unterstützt Bark nicht.
- VRAM: ~12 GB für das volle Modell, ~8 GB mit der Small-Model-Variable — der höchste Bedarf der vier hier verglichenen Engines.
- Am besten für: ausdrucksstarke Audiogenerierung, Soundeffekte kombiniert mit Sprache, Prototyping und Forschungsnutzung.
Kokoro: wenn eine GPU überdimensioniert ist
Kokoro ist hier als Gegenbeispiel aufgeführt: Der Besitz einer NVIDIA-GPU bedeutet nicht, dass jede TTS-Aufgabe eine braucht, und Kokoro ist der Beweis. Mit 82 Millionen Parametern ist es deutlich kleiner als XTTS v2, Chatterbox oder Bark, und seine eigene Hugging-Face-Model-Card dokumentiert Echtzeit- oder schnellere Synthese allein auf der CPU, wobei GPU-Nutzung nur zusätzlichen Spielraum bringt, aber keine Voraussetzung ist.
Kokoro steht unter der Apache-2.0-Lizenz, die — wie Chatterboxs MIT-Lizenz — kommerzielle Nutzung ohne Einschränkung erlaubt. Es unterstützt kein Voice-Cloning und ist daher kein Ersatz für XTTS v2 oder Chatterbox, wenn Cloning die Anforderung ist, doch für einfache Vertonung, Vorlesetext oder eine Sprachebene in einer App, in der Cloning nicht benötigt wird, ist es eine leichtere und einfachere Wahl.
- Nutzen Sie Kokoro, wenn: Ihre Aufgabe reine Vertonung oder Vorlesetext ist, Sie den VRAM Ihrer GPU für ein LLM oder eine andere Aufgabe freihalten wollen, oder Sie eine reine CPU-Bereitstellung benötigen.
- Vermeiden Sie Kokoro, wenn: Sie Voice-Cloning benötigen — das unterstützt es nicht, nutzen Sie stattdessen XTTS v2 oder Chatterbox.
- VRAM: rund 2 GB bei GPU-Betrieb; läuft laut eigener Model-Card allein auf der CPU in Echtzeitgeschwindigkeit.
- Am besten für: einfache Vertonung und Vorlesetext-Anwendungsfälle, bei denen die schwereren Cloning-Engines wirklich überdimensioniert wären.
GPU-Eignungs-Vergleichstabelle
Diese Tabelle bewertet die vier Engines speziell nach GPU-Eignungskriterien — VRAM-Bedarf, wie stark jede von CUDA-Beschleunigung profitiert, Voice-Cloning-Fähigkeit und Lizenz — nicht nach roher Audioqualität.
📍 In einem Satz
XTTS v2 ist besser für höchste Voice-Cloning-Qualität; Chatterbox ist besser für kommerzielles, Echtzeit-Konversations-Cloning; Bark ist besser für ausdrucksstarkes, nicht-sprachliches Audio; Kokoro ist besser, wenn kein Cloning benötigt wird und eine GPU für die Aufgabe verschwendet wäre.
Engine | VRAM (GPU) | GPU-Geschwindigkeitsvorteil | Voice-Cloning | Lizenz |
|---|---|---|---|---|
| XTTS v2 | 4-6 GB empfohlen | Groß — CPU ist unpraktikabel | Ja, 6s-Clip / 17 Sprachen | CPML (nicht-kommerziell) |
| Chatterbox | Nicht offiziell veröffentlicht | Groß für Echtzeitnutzung | Ja, Zero-Shot | MIT |
| Bark | ~8-12 GB (klein/voll) | Größter der vier | Nein | MIT |
| Kokoro | ~2 GB, GPU optional | Klein — auch auf CPU schnell | Nein | Apache-2.0 |
Wie viel VRAM brauchen Sie tatsächlich?
Eine GPU mit 6 GB VRAM oder mehr deckt jede Engine in diesem Vergleich problemlos ab, außer Barks vollem Modell, das etwa 12 GB benötigt (oder rund 8 GB mit der Small-Model-Variable). Wählen Sie Ihre Karte nach der tatsächlich benötigten Engine, statt standardmäßig für die schwerste Option zu kaufen.
Allgemeine Hinweise zur GPU-Wahl nach VRAM-Stufe für lokale KI-Workloads (nicht TTS-spezifisch) finden Sie in PromptQuorums GPU-Kaufratgeber für lokale LLMs — dieselbe VRAM-first-Kauflogik gilt auch für TTS, und wenn Sie bereits ein lokales LLM neben TTS betreiben, konkurrieren beide Workloads um denselben VRAM-Pool.
- Einsteiger-GPU (6-8 GB VRAM): deckt XTTS v2 problemlos ab, deckt Bark nur mit der Small-Model-Variable ab, deckt Kokoro und Chatterboxs kleinere Varianten mühelos ab.
- Mittelklasse-GPU (12+ GB VRAM): deckt alle vier Engines ab, einschließlich Barks vollem Modell, mit Spielraum für weitere Aufgaben.
- TTS neben einem lokalen LLM betreiben: budgetieren Sie VRAM für beides — ein 7B-LLM bei Q4-Quantisierung benötigt allein rund 4-5 GB, kombinieren Sie es daher mit XTTS v2 oder Kokoro statt mit Barks vollem Modell, es sei denn, Ihre Karte hat 16 GB oder mehr.
- Im Zweifel starten Sie mit Kokoro oder XTTS v2 — beide passen problemlos in 6 GB VRAM und lassen Raum, später bei Bedarf eine schwerere Engine hinzuzufügen.
Voice-Cloning und Einwilligung
Das Klonen der Stimme einer echten Person ohne deren Wissen oder ausdrückliche Einwilligung ist ein eigenständiges Problem, unabhängig von Lizenzierung, und gilt unabhängig davon, welche Engine, Lizenz oder welchen kommerziellen Status Sie nutzen. XTTS v2 und Chatterbox sind beide leistungsfähige, universelle Voice-Cloning-Werkzeuge; keines der beiden prüft, ob das bereitgestellte Referenzaudio einer Person gehört, die dem Cloning zugestimmt hat.
Das Klonen einer Stimme ohne Einwilligung kann Fragen zu Einwilligung, Persönlichkeitsrechten und in manchen Rechtsordnungen Betrug oder Identitätsdiebstahl aufwerfen, unabhängig davon, ob Ihr Projekt kommerziell oder privat ist, und unabhängig von den Lizenzbedingungen des Modells. Dies ist ein sachlicher Hinweis, keine Rechtsberatung — konsultieren Sie einen Anwalt, wenn Sie ein Produkt entwickeln, das Stimmen echter Personen klont, und holen Sie stets eine klare, dokumentierte Einwilligung von jeder Person ein, deren Stimme Sie klonen.
- Holen Sie stets eine ausdrückliche, dokumentierte Einwilligung ein, bevor Sie die Stimme einer echten Person klonen — sowohl für private als auch für kommerzielle Nutzung.
- Chatterboxs eingebautes Perth-Wasserzeichen hilft, generiertes Audio auf das Werkzeug zurückzuführen, ist aber kein Ersatz für Einwilligung und prüft selbst keine Autorisierung.
- Weder XTTS v2 noch Chatterbox führen eine Einwilligungsprüfung durch — diese Verantwortung liegt vollständig bei der Person, die das Werkzeug betreibt.
Häufig gestellte Fragen
Brauche ich eine NVIDIA-GPU, um lokale TTS-Engines auszuführen?
Nein. Kokoro läuft allein auf der CPU in Echtzeitgeschwindigkeit, und auch XTTS v2, Chatterbox und Bark laufen auf der CPU — nur merklich langsamer. Eine GPU macht diese drei erst für Echtzeit- oder Batch-Nutzung praktikabel, ist aber keine zwingende Voraussetzung, sie überhaupt auszuführen.
Welche lokale TTS-Engine hat das beste Voice-Cloning?
XTTS v2, veröffentlicht von Coqui, ist die hier behandelte qualitativ hochwertigste Voice-Cloning-Option — es klont eine Stimme aus nur 6 Sekunden Referenzaudio über 17 Sprachen hinweg. Seine Lizenz, die Coqui Public Model License (CPML), ist nicht-kommerziell. Chatterbox, veröffentlicht von Resemble AI unter der MIT-Lizenz, ist die beste Wahl, wenn Sie kommerziell nutzbares Cloning mit Echtzeit-Konversationslatenz benötigen.
Wie viel VRAM benötigt XTTS v2?
XTTS v2s Modellgewichte betragen etwa 2 GB; 4 GB sind das praktische Minimum, und 4-6 GB werden für Echtzeit-Inferenz empfohlen, laut PromptQuorums dediziertem XTTS-v2-Test.
Wie viel VRAM benötigt Bark?
Barks volles Modell benötigt etwa 12 GB VRAM; das Setzen der Umgebungsvariable SUNO_USE_SMALL_MODELS reduziert das auf etwa 8 GB. Es hat den höchsten VRAM-Bedarf der vier in diesem Leitfaden verglichenen Engines.
Darf ich Chatterbox kommerziell nutzen?
Ja. Chatterbox, veröffentlicht von Resemble AI, steht unter der MIT-Lizenz, die kommerzielle Nutzung ohne separate Vereinbarung erlaubt — anders als XTTS v2s nicht-kommerzielle CPML-Lizenz.
Ist eine GPU für lokales TTS überdimensioniert?
Das hängt vom Anwendungsfall ab. Wenn Sie nur einfache Vertonung oder Vorlesetext ohne Voice-Cloning benötigen, läuft Kokoro (82M Parameter, Apache-2.0) allein auf der CPU in Echtzeitgeschwindigkeit, und eine GPU dafür zu kaufen oder zu reservieren ist unnötig. Wenn Sie Voice-Cloning oder ausdrucksstarkes, nicht-sprachliches Audio benötigen, verbessert eine GPU XTTS v2, Chatterbox und Bark spürbar.
Was ist der Unterschied zwischen XTTS v2 und Chatterbox?
XTTS v2 erzeugt in der Regel höherwertige Klone und unterstützt 17 Sprachen mit sprachübergreifendem Cloning, doch seine CPML-Lizenz ist nicht-kommerziell. Chatterbox ist ein kleineres Modell (rund 0,5 Milliarden Parameter bei seiner Multilingual-Variante), ausgelegt auf Echtzeit-Konversationslatenz, und seine MIT-Lizenz erlaubt kommerzielle Nutzung.
Unterstützt Bark Voice-Cloning?
Nein. Laut Sunos eigener Dokumentation „unterstützt Bark derzeit kein individuelles Voice-Cloning". Es kann ausdrucksstarkes Audio erzeugen — Lachen, Seufzer, einfache Musik — mit wählbaren Sprecher-Presets, kann aber nicht die Stimme einer beliebigen Person aus einer Referenzaufnahme klonen, wie es XTTS v2 oder Chatterbox können.
Kann ich TTS und ein lokales LLM auf derselben GPU betreiben?
Ja, wenn Sie VRAM für beides budgetieren. Ein 7B-LLM bei Q4-Quantisierung benötigt allein rund 4-5 GB, sodass es zusammen mit XTTS v2 (4-6 GB) oder Kokoro (~2 GB) problemlos auf eine 12-GB-Karte passt; ein LLM zusammen mit Barks vollem Modell (~12 GB) benötigt in der Regel 16 GB oder mehr Gesamt-VRAM.
Brauche ich eine Einwilligung, um die Stimme einer Person zu klonen, selbst für ein privates Projekt?
Ja. Das Klonen der Stimme einer echten Person ohne deren ausdrückliche, dokumentierte Einwilligung wirft Fragen zu Einwilligung und Persönlichkeitsrechten auf, unabhängig davon, ob das Projekt privat oder kommerziell ist, und unabhängig davon, welche Lizenz der genutzten Engine gilt. Dies ist ein sachlicher Hinweis, keine Rechtsberatung.
Fazit
Für Leser, die bereits eine NVIDIA-GPU besitzen und sie für Text-zu-Sprache nutzen möchten, hängt die Wahl davon ab, was das Audio leisten muss. XTTS v2 ist die Wahl für die höchste erreichbare Voice-Cloning-Qualität in einem nicht-kommerziellen oder Forschungskontext, aufgrund seiner nicht-kommerziellen CPML-Lizenz. Chatterbox ist die Wahl, wenn dieselbe Cloning-Fähigkeit in einem kommerziellen Produkt eingesetzt werden muss, dank seiner MIT-Lizenz und der auf Echtzeit ausgelegten kleineren Modellgrößen. Bark ist speziell die Wahl, wenn das Projekt ausdrucksstarkes, nicht-sprachliches Audio benötigt — Lachen, Seufzer, einfache Musik — und dafür 8-12 GB VRAM investieren kann, mit dem Vorbehalt, dass sein Wartungsstatus ungewiss ist. Kokoro bleibt die richtige Wahl, wann immer Cloning nicht die Anforderung ist: Es läuft problemlos allein auf der CPU, sodass das Reservieren von GPU-VRAM dafür selten lohnt. Im Zweifel starten Sie mit Kokoro für einfache Vertonung und steigen erst auf XTTS v2 oder Chatterbox um, sobald eine echte Cloning-Anforderung entsteht — so bleibt der VRAM Ihrer GPU für alles andere verfügbar, was Sie parallel betreiben, einschließlich eines lokalen LLM. Die Lizenzdetails zu jeder hier genannten Engine finden Sie in PromptQuorums Leitfaden zu lokalen TTS- und Voice-Cloning-Lizenzen.
Quellen
- XTTS v2 auf Hugging Face — Model-Card: Cloning-Anforderungen, Sprachen und Lizenzverweis.
- Resemble AI: Chatterbox — offizielle Modellübersicht, Lizenz und Parameterzahlen.
- resemble-ai/chatterbox auf GitHub — README: Installation, MIT-Lizenz, Wasserzeichen und CPU-/GPU-Unterstützung.
- suno-ai/bark auf GitHub — README: Lizenz, VRAM-/Small-Model-Variable und Wartungs-/Commit-Historie.
- Kokoro-82M auf Hugging Face — Model-Card: Parameterzahl, Apache-2.0-Lizenz und CPU-/GPU-Performance.
- XTTS-v2-Test — PromptQuorums dedizierter Test mit vollständigen Nutzungsbefehlen und Lizenzdetails.
- Bark-TTS-Test — PromptQuorums dedizierter Test mit VRAM-Werten und Wartungsstatus.
- Lokale TTS- und Voice-Cloning-Lizenzen — vollständiger Lizenz- und VRAM-Vergleich über lokale TTS-Engines hinweg.