关键要点
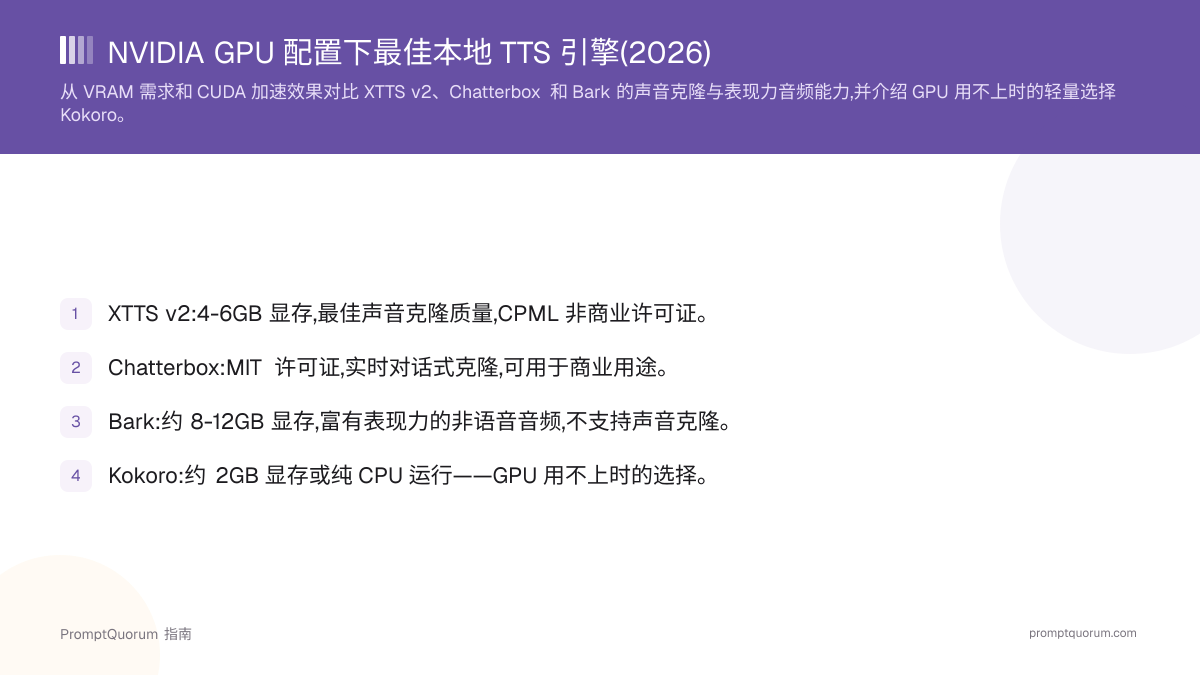
- XTTS v2:最佳克隆质量(6 秒参考片段,17 种语言),建议 4-6 GB VRAM,非商业 CPML 许可证。
- Chatterbox:实时对话式克隆,小型模型约 5 亿参数,MIT 许可证(可用于商业)。
- Bark:非语音表现力音效,不支持声音克隆,四款中 VRAM 占用最高,MIT 许可证,维护状态不确定。
- Kokoro:8200 万参数,Apache 2.0,单靠 CPU 也能运行良好——GPU 非必需的反例。
- 三款面向 GPU 的引擎都能在 CPU 上运行,但会有实实在在的速度代价——这一差距正是为此用途配备 GPU 的根本原因。
- 无论使用哪款引擎或许可证,声音克隆都需要被克隆者的同意。
📍 简单一句话
在 NVIDIA GPU 上,XTTS v2 提供最佳声音克隆质量,Chatterbox 在可商用的 MIT 许可证下提供最佳实时对话式克隆,Bark 提供最具表现力的非语音音频,而在实际不需要 GPU 时,Kokoro 仍是正确选择。
💬 简单来说
如果你拥有一块能运行 AI 工作负载的显卡,三款文本转语音引擎(XTTS v2、Chatterbox、Bark)会因此真正变得更快、更好,而第四款(Kokoro)几乎不需要 GPU——该安装哪一款,取决于你是否需要声音克隆、有多少显存,以及是否打算用于商业用途。
📌注: 本指南假设你已经拥有 NVIDIA GPU,正在决定在其上运行什么。对于纯 CPU 配置(如树莓派,没有独立 GPU),Piper 是标准选择——PromptQuorum 关于所有本地 TTS 引擎的完整许可证与 VRAM 对比已链接在下方的相关阅读中。
哪些引擎真正需要 GPU?
XTTS v2、Chatterbox 和 Bark 都能在 CPU 上运行,但正是 GPU 让它们在实时或批量场景下变得实用——Kokoro 是例外,其 8200 万参数使它单靠 CPU 也能快速运行。 三款较重的引擎有一个共同特征:它们都是以克隆或生成质量为优先的模型,其架构用算力换取表现力,因此 CUDA 加速消除的是瓶颈本身,而不仅仅是带来些许提速。
如果你的使用场景是声音克隆、非语音表现力音频,或任何对生成速度有要求的工作负载——批量旁白任务、交互式语音应用,或生成大量片段的流水线——请使用面向 GPU 的引擎(XTTS v2、Chatterbox 或 Bark)。如果你只需要对纯文本进行简单旁白、不涉及克隆,就不要把 GPU 显存花在 TTS 上:Kokoro 或 Piper 单靠 CPU 即可覆盖这类场景,把显存留给同时运行的 LLM 或其他工作负载。
- XTTS v2 可以在 CPU 上运行,但官方文档记录其在 CPU 上明显更慢——其低于 200 毫秒的流式延迟是 GPU 加速下的数值,而非 CPU 数值。
- Chatterbox 提供支持 CPU 的 Nano 变体(1.1 亿参数),Resemble AI 自己的文档称其在 8 核 CPU 上运行速度快于实时,但更大的、以克隆为重点的变体在实时对话场景下会受益于 CUDA。
- Bark 在自己的文档中明确说明,在 CPU 或较旧的 GPU 上推理可能明显慢于它在企业级 GPU 上达到的接近实时的速度。
- Kokoro 是个例外:凭借 8200 万参数,根据其 Hugging Face 模型卡,它单靠 CPU 即可达到实时或更快的速度,只有在需要为大批量生成留出额外余量时才需要 GPU。
XTTS v2:最佳声音克隆质量
XTTS v2 由 Coqui 发布,通过 Coqui TTS 工具包运行,是需要从短参考片段中获得最高可达质量的 GPU 用户的最佳本地声音克隆选择。 它仅需 6 秒参考音频即可克隆一个声音,并支持用该声音输出 17 种语言,包括跨语言克隆——用英语音频克隆声音,再用西班牙语或日语说出来。
在 VRAM 方面,XTTS v2 的模型权重约为 2 GB,但实用的最低运行门槛是 4 GB,实时推理建议 4-6 GB,详见 PromptQuorum 的 XTTS v2 测评。对大多数读者而言,许可证才是决定性因素:Coqui Public Model License(CPML)明确为非商业许可,而由于该公司 Coqui AI 已于 2023 年 12 月关闭其付费服务,目前没有确认可行的商业许可途径。
- 适合使用 XTTS v2 的情况:项目属于个人、学术或非商业原型,你想要本地可获得的最佳克隆质量。
- 不适合使用 XTTS v2 的情况:你需要商业许可证——其 CPML 条款为非商业性质,自 2023 年 Coqui AI 关闭以来,没有确认的有效商业许可途径。
- VRAM: 模型权重约 2 GB,最低 4 GB,实时推理建议 4-6 GB。
- 最适合: 本地可实现的最高保真度声音克隆,支持 17 种语言的跨语言能力,非商业或研究用途。
Chatterbox:最佳实时克隆
Chatterbox 由 Resemble AI 发布于 GitHub,是希望在完全宽松、可商用的许可证下实现实时对话式声音克隆的 GPU 用户的最佳选择。 它采用 MIT 许可证,与 XTTS v2 的非商业 CPML 不同,无需单独协议即可商用。
Chatterbox 提供多种规格:Nano 变体(1.1 亿参数),Resemble AI 自己的文档称其在 8 核 CPU 上运行速度快于实时;为低延迟设计的 Turbo 变体(3.5 亿参数);以及支持 20 多种语言的多语言变体(约 5 亿参数,其骨干网络在架构中提及借鉴了 Llama 3)。零样本声音克隆通过参考音频片段实现——Resemble AI 自己的示例使用了一个 10 秒的片段,但 README 并未像 XTTS v2 那样给出官方最短时长。
Resemble AI 的公开 README 没有公布确切的 VRAM 数值,因此你在其他地方看到的任何具体 GB 数字,在你自己用显卡实测之前都应视为未经证实。已有文档记录的是:Nano 变体单靠 CPU 即可正常运行,而更大的 Turbo 和多语言变体则是为 GPU 加速的低延迟生成而设计——同时支持 CUDA 和 Apple Silicon(MPS)。
- 适合使用 Chatterbox 的情况:你需要可用于商业的声音克隆,并具备实时或接近实时的延迟,例如交互式语音应用。
- 不适合使用 Chatterbox 的情况:你在购买硬件前需要有据可查、有保证的最低 VRAM 数值——Resemble AI 尚未公布。
- VRAM: 官方未公布;较小的 Nano 变体支持 CPU,而 Turbo 和多语言变体则面向 GPU 加速以获得实时速度。
- 最适合: 需要在宽松许可证下实现零样本对话式声音克隆的商业产品。
- 每个 Chatterbox 输出都带有 Resemble AI 自有的 Perth 水印,其文档将其描述为一种经过 MP3 压缩后依然存在的、不可感知的神经网络水印——这是一种内置的溯源信号,而非同意的替代品(见下文声音克隆与同意部分)。
Bark:最佳非语音表现力音频
Bark 由 Suno 发布于 GitHub,如果你想要的不只是语音——笑声、叹息、喘息以及仅凭文本提示生成的简单音乐——它是正确选择,也是这次对比中从 GPU 中受益最多的引擎,因为其逐 token 生成的架构在没有 CUDA 加速时是四款中最慢的。 它不支持自定义声音克隆;据 Suno 自己的文档所述,它"目前不支持自定义声音克隆"。
在 VRAM 方面,PromptQuorum 的 Bark 测评记录完整模型大约需要 12 GB,通过小模型环境变量标志(SUNO_USE_SMALL_MODELS)可降至约 8 GB——明显高于 XTTS v2 的 4-6 GB。它采用 MIT 许可证,自 2023 年 5 月 1 日起完全可用于商业用途,但其维护状态确实是一个悬而未决的问题:公开的 GitHub 仓库自 2024 年 4 月 5 日以来没有新的提交。
- 适合使用 Bark 的情况:你需要在语音之外还有非语音音频(笑声、叹息、环境声),并有 8-12 GB VRAM 可用。
- 不适合使用 Bark 的情况:你需要生产流水线中可靠、确定性的输出,或者你需要声音克隆——Bark 不支持。
- VRAM: 完整模型约 12 GB,启用小模型标志约 8 GB——这里对比的四款引擎中占用最高的一款。
- 最适合: 富有表现力的音频生成、与语音结合的音效、原型开发与研究用途。
Kokoro:GPU 属于过度配置的场景
这里把 Kokoro 列为反例:拥有 NVIDIA GPU 并不意味着每个 TTS 工作负载都需要用到它,Kokoro 就是证明。 凭借 8200 万参数,它比 XTTS v2、Chatterbox 或 Bark 都小得多,其自身的 Hugging Face 模型卡记录了单靠 CPU 即可实现的实时或更快合成速度,使用 GPU 只是增加余量,而不是必要条件。
Kokoro 采用 Apache 2.0 许可证,与 Chatterbox 的 MIT 许可证一样,允许不受限制的商业使用。它不支持声音克隆,因此如果克隆是硬性需求,它无法替代 XTTS v2 或 Chatterbox;但对于简单旁白、朗读文本,或不需要克隆的应用语音层,它是一个更轻量、更简单的选择。
- 适合使用 Kokoro 的情况:你的工作负载是纯旁白或朗读文本,你想为 LLM 或其他任务保留 GPU 显存,或者你需要纯 CPU 部署。
- 不适合使用 Kokoro 的情况:你需要声音克隆——它不支持,请改用 XTTS v2 或 Chatterbox。
- VRAM: 在 GPU 上运行约 2 GB;据其自身模型卡,单靠 CPU 也能达到实时速度。
- 最适合: 更重的克隆引擎确实属于过度配置的简单旁白和朗读文本场景。
GPU 适配性对比表
此表专门根据 GPU 适配性标准——VRAM 需求、各引擎从 CUDA 加速中获益的程度、声音克隆能力和许可证——对四款引擎打分,而非根据原始音频质量。
📍 简单一句话
XTTS v2 更适合追求最高声音克隆质量;Chatterbox 更适合商业化的实时对话式克隆;Bark 更适合富有表现力的非语音音频;而当不需要克隆、GPU 用在这项任务上属于浪费时,Kokoro 更合适。
你实际需要多少 VRAM?
一块拥有 6 GB 以上 VRAM 的 GPU 足以轻松覆盖本对比中的所有引擎,唯独 Bark 的完整模型需要约 12 GB(或使用小模型标志时约 8 GB)。 按你实际需要的引擎来匹配显卡,而不是默认购买最重的选项。
关于按 VRAM 档位为本地 AI 工作负载(非 TTS 专用)选择 GPU 的一般性建议,参见 PromptQuorum 的本地 LLM GPU 购买指南——同样以 VRAM 优先的购买逻辑同样适用于 TTS,如果你已经在同时运行本地 LLM 和 TTS,这两项工作负载会争抢同一块 VRAM。
- 入门级 GPU(6-8 GB VRAM):轻松覆盖 XTTS v2,仅在使用小模型标志时覆盖 Bark,轻松覆盖 Kokoro 及 Chatterbox 的较小变体。
- 中端 GPU(12 GB 以上 VRAM):覆盖全部四款引擎,包括 Bark 的完整模型,并为其他工作负载留有余量。
- TTS 与本地 LLM 同时运行时:为两者都预留 VRAM——一个 Q4 量化的 7B LLM 本身就需要约 4-5 GB,因此除非你的显卡有 16 GB 以上,否则应将其与 XTTS v2 或 Kokoro 搭配,而非 Bark 的完整模型。
- 如果拿不准,从 Kokoro 或 XTTS v2 开始——两者都能轻松容纳在 6 GB VRAM 内,为将来需求增长时添加更重的引擎留出空间。
声音克隆与同意
在未经本人知情或明确同意的情况下克隆真实人物的声音,是一个与许可证无关的独立问题,无论你使用哪款引擎、哪种许可证或何种商业状态,都同样适用。 XTTS v2 和 Chatterbox 都是能力强大的通用声音克隆工具;两者都不会验证你提供的参考音频是否来自已同意被克隆的本人。
未经同意克隆声音,可能引发同意、公开权,以及在某些司法辖区涉及欺诈或冒充身份的问题,无论你的项目是商业还是个人性质,也无论模型的许可条款如何。这是一条事实性说明,而非法律建议——如果你正在开发克隆真实人物声音的产品,请咨询律师,并始终从声音将被克隆的每个人那里获得清晰、有据可查的同意。
- 在克隆真实人物的声音之前,无论个人用途还是商业用途,都要始终获得明确、有据可查的同意。
- Chatterbox 内置的 Perth 水印有助于将生成的音频追溯到该工具,但它不能替代同意,本身也不验证授权。
- XTTS v2 和 Chatterbox 都不执行同意验证——这一责任完全由操作该工具的人承担。
常见问题
运行本地 TTS 引擎需要 NVIDIA GPU 吗?
不需要。Kokoro 单靠 CPU 就能达到实时速度,XTTS v2、Chatterbox 和 Bark 也都能在 CPU 上运行——只是明显更慢。GPU 让这三款引擎在实时或批量场景下变得实用,而不是运行它们的硬性前提。
哪款本地 TTS 引擎的声音克隆效果最好?
Coqui 发布的 XTTS v2 是本文中质量最高的声音克隆选项——仅需 6 秒参考音频即可克隆一个声音,并覆盖 17 种语言。其许可证 Coqui Public Model License(CPML)为非商业性质。若你需要可商用、且具备实时对话延迟的克隆能力,Resemble AI 在 MIT 许可证下发布的 Chatterbox 是最佳选择。
XTTS v2 需要多少 VRAM?
XTTS v2 的模型权重约为 2 GB;4 GB 是实用的最低运行门槛,实时推理建议 4-6 GB,详见 PromptQuorum 的 XTTS v2 专项测评。
Bark 需要多少 VRAM?
Bark 的完整模型大约需要 12 GB VRAM;设置 SUNO_USE_SMALL_MODELS 环境变量标志可将其降至约 8 GB。这是本指南对比的四款引擎中占用最高的一款。
我可以将 Chatterbox 用于商业用途吗?
可以。Resemble AI 发布的 Chatterbox 采用 MIT 许可证,无需单独协议即可商用——这与 XTTS v2 的非商业 CPML 许可证不同。
本地 TTS 使用 GPU 是不是过度配置?
这取决于你的使用场景。如果你只需要不涉及声音克隆的简单旁白或朗读文本,Kokoro(8200 万参数,Apache 2.0)单靠 CPU 就能实现实时速度,为此专门购买或占用一块 GPU 并无必要。如果你需要声音克隆或富有表现力的非语音音频,GPU 会明显改善 XTTS v2、Chatterbox 和 Bark 的表现。
XTTS v2 和 Chatterbox 有什么区别?
XTTS v2 通常能生成保真度更高的克隆效果,并支持 17 种语言的跨语言克隆,但其 CPML 许可证为非商业性质。Chatterbox 是一个为实时对话延迟而构建的更小模型(其多语言变体约有 5 亿参数),其 MIT 许可证允许商业使用。
Bark 支持声音克隆吗?
不支持。据 Suno 自己的文档所述,Bark"目前不支持自定义声音克隆"。它可以通过可选的说话人预设生成富有表现力的音频——笑声、叹息、简单音乐——但无法像 XTTS v2 或 Chatterbox 那样,从一段参考录音中克隆任意某个人的声音。
我能在同一块 GPU 上同时运行 TTS 和本地 LLM 吗?
可以,只要你为两者都预留了足够的 VRAM。一个 Q4 量化的 7B LLM 本身就需要约 4-5 GB,因此将其与 XTTS v2(4-6 GB)或 Kokoro(约 2 GB)搭配,能轻松容纳在一块 12 GB 的显卡上;若将 LLM 与 Bark 的完整模型(约 12 GB)搭配,通常需要总共 16 GB 以上的 VRAM。
即使是个人项目,克隆某人的声音也需要同意吗?
是的。在未经本人明确、有据可查的同意下克隆真实人物的声音,无论项目是个人还是商业性质,也无论所用引擎的许可证如何,都会引发同意和公开权方面的问题。这是一条事实性说明,而非法律建议。
结论
对于已经拥有 NVIDIA GPU、想将其用于文本转语音的读者来说,选择取决于音频需要实现什么效果。鉴于其非商业 CPML 许可证,在非商业或研究场景下追求可达到的最高声音克隆质量,XTTS v2 是首选。当同样的克隆能力需要投入商业产品时,凭借 MIT 许可证及面向实时场景的较小模型规格,Chatterbox 是首选。当项目特别需要富有表现力的非语音音频——笑声、叹息、简单音乐——并能为此花费 8-12 GB VRAM 时,Bark 是首选,但需注意其维护状态不确定。只要克隆不是硬性需求,Kokoro 始终是正确选择:它单靠 CPU 就能运行良好,因此为它预留 GPU 显存很少值得。如果拿不准,可以从 Kokoro 用于简单旁白开始,只有在出现真正的克隆需求时才升级到 XTTS v2 或 Chatterbox——这样能让你 GPU 的显存留给同时运行的其他任务,包括本地 LLM。关于本文提到的每款引擎的许可证详情,参见 PromptQuorum 的本地 TTS 与声音克隆许可证指南。
来源
- Hugging Face 上的 XTTS v2 — 模型卡:克隆要求、支持语言与许可证说明。
- Resemble AI:Chatterbox — 官方模型概览、许可证与参数量。
- GitHub 上的 resemble-ai/chatterbox — README:安装、MIT 许可证、水印以及 CPU/GPU 支持。
- GitHub 上的 suno-ai/bark — README:许可证、VRAM/小模型标志以及维护/提交历史。
- Hugging Face 上的 Kokoro-82M — 模型卡:参数量、Apache 2.0 许可证以及 CPU/GPU 性能。
- XTTS v2 测评 — PromptQuorum 的专项测评,含完整使用命令和许可证细节。
- Bark TTS 测评 — PromptQuorum 的专项测评,含 VRAM 数据和维护状态。
- 本地 TTS 与声音克隆许可证 — 各本地 TTS 引擎的完整许可证与 VRAM 对比。