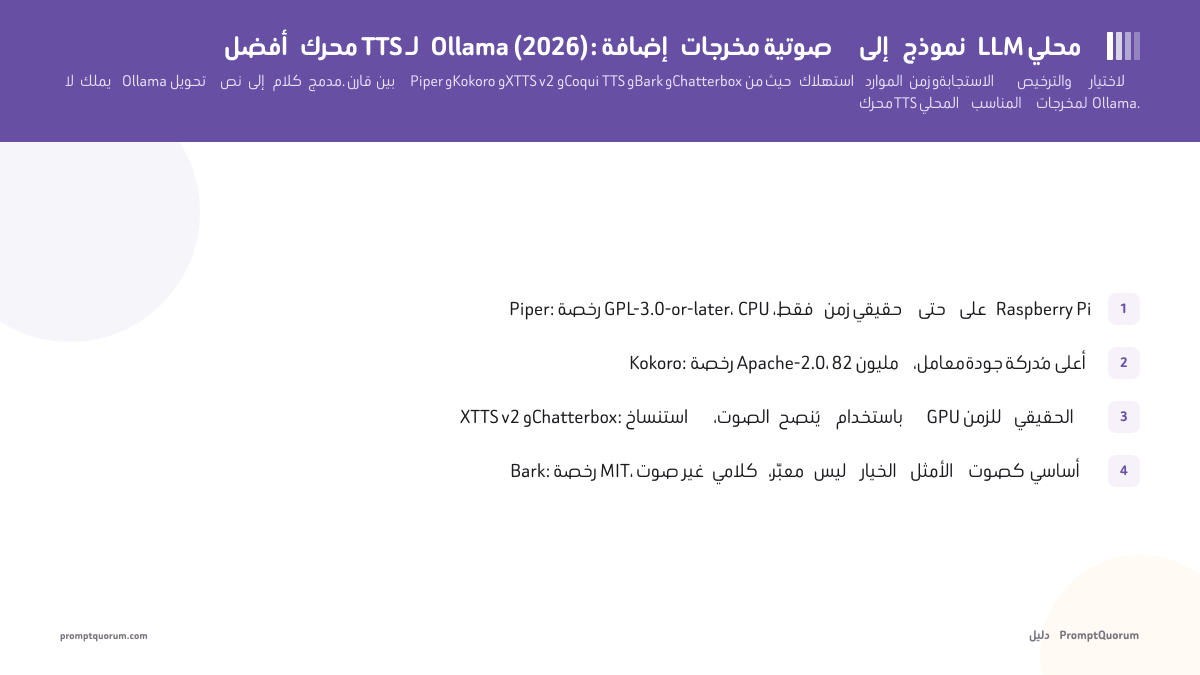
النقاط الرئيسية
- يولّد Ollama نصًا فقط؛ طلب TTS أصلي (GitHub issue #11021) لا يزال دون حل حتى وقت كتابة هذا المقال.
- Piper هو الاقتران الأقل تكلفة من حيث الموارد: CPU فقط، زمن حقيقي حتى على Raspberry Pi، رخصة GPL-3.0-or-later.
- يستبدل Kokoro (82 مليون معامل، Apache-2.0) بعض السرعة بجودة صوت مُدركة أفضل بشكل ملحوظ.
- يستنسخ كل من XTTS v2 وChatterbox صوتًا من مقطع مرجعي قصير، لكن ترخيص XTTS v2 غير تجاري بينما Chatterbox مرخّص بموجب MIT.
- يضيف Bark الضحك والتنهد وأصواتًا غير كلامية أخرى، لكن مستودعه على GitHub لم يتلقَّ أي تعديلات منذ 5 أبريل 2024.
- يتبع خط الأنابيب دائمًا الشكل نفسه: تُعيد واجهة REST API الخاصة بـ Ollama نصًا بصيغة JSON، يستخرجه الكود، ثم يُمرَّر هذا النص إلى واجهة سطر الأوامر أو واجهة Python لمحرك TTS.
📍 في جملة واحدة
لا يملك Ollama تحويل نص إلى كلام مدمجًا، لذا فإن إضافة مخرجات صوتية تعني توجيه رده النصي إلى محرك TTS محلي منفصل — Piper لأقل تكلفة موارد، وKokoro لجودة أعلى بحجم مماثل، وXTTS v2 أو Chatterbox لاستنساخ الصوت، وBark فقط للصوت غير الكلامي المعبّر.
💬 بعبارات بسيطة
Ollama هو الجزء الذي يفكّر ويكتب الرد؛ ومحرك TTS برنامج منفصل يحوّل هذا الرد المكتوب إلى صوت منطوق. أنت من يربط الاثنين بنفسك بضعة أسطر من الكود — لا يوجد زر واحد يؤدي المهمتين معًا.
📌ملاحظة: يغطي هذا المقال نصف TTS فقط من خط أنابيب الصوت. للحصول على بناء كامل يضيف أيضًا التعرف على الكلام (Whisper) في جانب الإدخال، راجع دليل المساعد الصوتي المحلي من PromptQuorum.
هل يملك Ollama تحويل نص إلى كلام مدمج؟
لا — لا يملك Ollama تحويل نص إلى كلام أو مخرجات صوتية مدمجة. Ollama هو بيئة تشغيل محلية لنماذج اللغة الكبيرة: يحمّل نموذجًا، ويعرضه عبر واجهة REST API محلية وواجهة سطر أوامر، ويعيد نصًا. إنه لا يولّد كلامًا، ولا يشتمل على أي نموذج TTS.
اقترحت issue على GitHub تطلب دعم TTS أصلي، #11021، تحميل نماذج توليد الصوت مباشرة وإضافة نقطة نهاية متوافقة مع OpenAI، POST /v1/audio/speech. أُغلقت باعتبارها نسخة مكررة من طلب أقدم لا يزال مفتوحًا (issue #5424) — حتى وقت كتابة هذا المقال، لم يُطلق Ollama محرك TTS أصلي، ولا يوجد جدول زمني ملتزم به لذلك.
لهذا السبب، يربط كل إعداد صوت محلي مبني على Ollama — مساعد صوتي، أو راوٍ لكتاب صوتي لمخرجات نموذج LLM، أو أداة قراءة بصوت عالٍ لإمكانية الوصول — نموذج Ollama بمحرك TTS منفصل بدلاً من الاعتماد على أي "وضع TTS خاص بـ Ollama". توجد بالفعل مشاريع مجتمعية للربط بهذا الغرض: maudoin/ollama-voice، بـ378 نجمة على GitHub وقت كتابة هذا المقال، يربط Whisper للنسخ الصوتي، وOllama للرد، وpyttsx3 — وهو غلاف حول الأصوات المدمجة في نظام التشغيل لديك، وليس نموذج TTS عصبيًا — للمخرجات. يوضّح هذا المشروع النمط؛ وهو ليس بحد ذاته توصية بجودة صوت pyttsx3، التي تتخلف عن كل محرك عصبي جرت مقارنته في هذا الدليل.
هل توجد ميزة تحويل نص إلى كلام رسمية في Ollama؟
لا. يولّد Ollama نصًا فقط. طلب ميزة مجتمعي لإضافة دعم TTS أصلي (GitHub issue #11021) لا يزال دون حل حتى وقت كتابة هذا المقال، وقد أُغلق باعتباره نسخة مكررة من طلب أقدم لا يزال مفتوحًا. تتطلب المخرجات الصوتية توجيه رد Ollama النصي إلى محرك TTS منفصل.
كيفية توجيه مخرجات Ollama إلى محرك TTS محلي
يتبع كل خط أنابيب يجمع Ollama وTTS الخطوات الأربع نفسها: طلب نص من Ollama، واستخراج ذلك النص من استجابة JSON، وتمريره إلى محرك TTS، وتشغيل الصوت الناتج أو حفظه. لا يوجد تكامل رسمي بين Ollama وأي محرك TTS — هذا كود ربط تكتبه بنفسك، عادةً أقل من 20 سطرًا.
- لا تعرف واجهة API الخاصة بـ Ollama، ولا تهتم، بما يحدث لمخرجاتها النصية. لا يوجد callback أو webhook أو نظام إضافات (plugin) يربط Ollama بمحرك TTS — الكود الخاص بك هو الشيء الوحيد الذي يربط بينهما.
- يقلّل وضع البث (
"stream": true) زمن الاستجابة المُدرك عبر إعادة الرموز (tokens) أثناء توليدها، مما يتيح لك البدء بتوليد صوت الجملة الأولى قبل أن ينهي النموذج ردّه الكامل — مفيد للمساعدات الصوتية التفاعلية، وأكثر تعقيدًا في التنفيذ من المثال غير المُبثّ أعلاه.
- 1شغّل Ollama واسحب نموذجًا
Why it matters: يجب أن يكون Ollama يعمل بالفعل (`ollama serve`، أو تطبيق سطح المكتب) مع نموذج واحد على الأقل تم سحبه (`ollama pull llama3.1`) قبل أن يتمكن من الرد على الطلبات عبر واجهة REST API الخاصة به. - 2أرسل موجّهًا (prompt) إلى واجهة REST API الخاصة بـ Ollama
Why it matters: يعيد طلب POST إلى `http://localhost:11434/api/generate` مع `"stream": false` كائن JSON واحد يحتوي على الرد الكامل في حقل `response` الخاص به — الأبسط لتحليله في خط أنابيب TTS، رغم أن وضع البث متاح لتقليل الوقت حتى أول مقطع صوتي. - 3استخرج النص ومرّره إلى محرك TTS الخاص بك
Why it matters: سلسلة `response` نص عادي — مرّرها مباشرة إلى واجهة سطر أوامر محرك TTS عبر stdin (Piper) أو إلى واجهة Python الخاصة به (Kokoro أو XTTS v2 أو Chatterbox أو Bark أو مجموعة أدوات Coqui TTS). - 4شغّل الصوت الناتج أو احفظه
Why it matters: تكتب معظم واجهات سطر الأوامر وواجهات API الخاصة بـ TTS ملف `.wav` مباشرة؛ للتشغيل المباشر، مرّر الصوت الخام إلى مشغّل مثل `aplay` (على Linux) أو استخدم مكتبة صوت بلغة Python.
# 1. طلب رد نصي من Ollama (دون بث، لتبسيط الأمر)
RESPONSE=$(curl -s http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Explain quantum entanglement in two sentences.",
  "stream": false
}' | python3 -c "import sys, json; print(json.load(sys.stdin)['response'])")

# 2. تمرير هذا النص إلى واجهة سطر أوامر Piper لتوليد الصوت (الخيار الأقل تكلفة من حيث الموارد)
echo "$RESPONSE" | piper --model en_US-lessac-medium --output_file response.wav

# --- نسخة Python مكافئة، باستخدام Kokoro بدلاً من Piper ---
import json
import requests
import soundfile as sf
from kokoro_onnx import Kokoro

reply = requests.post(
    "http://localhost:11434/api/generate",
    json={"model": "llama3.1", "prompt": "Explain quantum entanglement in two sentences.", "stream": False},
).json()["response"]

kokoro = Kokoro("kokoro-v1.0.onnx", "voices-v1.0.bin")
samples, sample_rate = kokoro.create(reply, voice="af_heart")
sf.write("response.wav", samples, sample_rate)
أي محرك TTS يقترن بشكل أفضل مع Ollama؟
Piper هو الخيار الأفضل لمعظم اقترانات Ollama لأنه يضيف أقل تنافس على الموارد بجانب نموذج LLM يستهلك بالفعل CPU أو ذاكرة GPU. يقيّم الجدول أدناه كل مرشح تحديدًا بحسب مدى نجاحه في مشاركة الجهاز مع Ollama — استهلاك الموارد، وزمن الاستجابة، وكمية الكود اللازمة للربط، والترخيص — وليس فقط بجودة الصوت الخام.
Piper
- الترخيص:
- GPL-3.0-or-later
- استهلاك الموارد:
- CPU فقط، خفيف جدًا
- زمن الاستجابة:
- زمن حقيقي، حتى على Raspberry Pi
- سهولة الربط:
- استدعاء واحد لسطر الأوامر، نص عبر stdin
Kokoro
- الترخيص:
- Apache-2.0
- استهلاك الموارد:
- متوافق مع CPU، خفيف (82 مليون معامل)
- زمن الاستجابة:
- سريع؛ لا بيانات عامة للزمن الحقيقي مقابل GPU
- سهولة الربط:
- واجهة Python (kokoro-onnx)، أسطر قليلة
XTTS v2
- الترخيص:
- CPML (غير تجاري)
- استهلاك الموارد:
- مرتفع؛ يُنصح باستخدام GPU
- زمن الاستجابة:
- بث بأقل من 200 مللي ثانية، على GPU، وفق وثائق Coqui
- سهولة الربط:
- واجهة Python، إعداد أكثر (موافقة الترخيص)
مجموعة أدوات Coqui TTS
- الترخيص:
- MPL-2.0 (المجموعة فقط)
- استهلاك الموارد:
- يختلف حسب النموذج المُحمَّل
- زمن الاستجابة:
- يختلف حسب النموذج المُحمَّل
- سهولة الربط:
- واجهة Python واحدة لعدة نماذج
Bark
- الترخيص:
- MIT
- استهلاك الموارد:
- مرتفع؛ يُنصح باستخدام GPU، بطيء على CPU
- زمن الاستجابة:
- غير مصمَّم للبث بزمن حقيقي
- سهولة الربط:
- واجهة Python، بسيطة لكن أبطأ
Chatterbox
- الترخيص:
- MIT
- استهلاك الموارد:
- متوسط؛ يُنصح باستخدام GPU للزمن الحقيقي
- زمن الاستجابة:
- لا بيانات عامة مؤكدة للزمن الحقيقي
- سهولة الربط:
- واجهة Python (حزمة pip باسم chatterbox-tts)
أي محرك TTS يستهلك أقل موارد بجانب Ollama؟
Piper. يعمل على CPU فقط، ويعمل بزمن حقيقي حتى على Raspberry Pi، ولا يحتاج إلى مشاركة ذاكرة GPU مع نموذج Ollama — الخيار الأقل تكلفة من حيث الموارد في هذه المقارنة.
من يجب أن يستخدم أي محرك؟
اختر المحرك بما يناسب جهازك ومتطلبات الصوت لديك، لا بحسب أعلى جودة صوت خام بمفردها.
- 🏆 أفضل خيار شامل لاقترانه مع Ollama: Piper — أقل تكلفة موارد، زمن حقيقي على CPU، الأسهل ربطًا بسكربت shell أو استدعاء عملية فرعية بلغة Python.
- أفضل خيار لجودة صوت أعلى بحجم مماثل: Kokoro — لا يزال مضغوطًا بما يكفي للعمل دون GPU، بجودة صوت مُدركة أفضل بشكل ملحوظ من Piper وفق معايير الإصدار الخاصة به.
- أفضل خيار لاستنساخ الصوت مع السماح بالاستخدام التجاري: Chatterbox — مرخّص بموجب MIT، يستنسخ صوتًا من نحو 5 ثوانٍ من الصوت المرجعي، ويحتاج إلى GPU بجانب Ollama للاستخدام بزمن حقيقي.
- أفضل خيار لاستنساخ الصوت غير التجاري أو البحثي: XTTS v2 — يستنسخ صوتًا من 6 ثوانٍ من الصوت عبر 17 لغة، لكن رخصته CPML تمنع الاستخدام التجاري دون اتفاق منفصل — راجع تحليل ترخيص XTTS v2 من PromptQuorum.
- أفضل خيار للصوت غير الكلامي المعبّر، وليس كصوت أساسي: Bark — الضحك والتنهد وصوت محيطي بسيط من موجّهات نصية فقط، لكن مستودعه لم يتلقَّ أي تعديلات منذ 5 أبريل 2024، لذا لا تعتمد عليه لخط أنابيب إنتاج يُصان باستمرار.
- 🧭 Raspberry Pi أو أي جهاز آخر يعتمد على CPU فقط، يشغّل Ollama بنموذج صغير → Piper. لا يوجد محرك آخر في هذا الدليل مؤكَّد عمله بزمن حقيقي دون GPU.
- 🧭 جهاز مكتبي أو خادم مع GPU متاحة بجانب Ollama، ورغبة بصوت مستنسخ، وحاجة إلى حقوق استخدام تجاري → Chatterbox.
- 🧭 جهاز مكتبي أو خادم مع GPU متاحة، مشروع بحثي أو شخصي، ورغبة بأعلى جودة استنساخ → XTTS v2.
- 🧭 رغبة في مجموعة أدوات واحدة قادرة على تحميل نماذج مختلفة عدة بمرور الوقت (بما فيها XTTS v2) → مجموعة أدوات Coqui TTS بدلاً من تثبيت تبعيات كل نموذج على حدة.
متى لا تستخدم أيًا من هذه المحركات
التحويل الصوتي المحلي المقترن بـ Ollama ليس النهج الصحيح لكل حاجة مخرجات صوتية — بعض الحالات تتطلب واجهة سحابية أو أداة مختلفة تمامًا.
- ❌ إذا كنت بحاجة إلى عشرات الأصوات المصقولة والمعبّرة عاطفيًا جاهزة للاستخدام مباشرة — تقدّم واجهة سحابية مُدارة مثل ElevenLabs مكتبة أصوات منسّقة أوسع وأدوات تحكم أكثر تعبيرًا من أي من النماذج هنا؛ راجع مقارنة ElevenLabs مقابل TTS المحلي من PromptQuorum للاطلاع على المفاضلات.
- ❌ إذا لم يكن جهازك يملك فائضًا من ذاكرة RAM أو VRAM يتجاوز ما يستخدمه Ollama بالفعل — قد يؤدي تشغيل Ollama ومحرك TTS الشره لموارد GPU مثل XTTS v2 أو Bark على نفس وحدة GPU المتواضعة إلى تقييد كليهما؛ انتقل إلى Piper أو Kokoro، أو انقل TTS إلى جهاز ثانٍ.
- ❌ إذا كنت بحاجة إلى إطلاق منتج تجاري ولم تتحقق من الترخيص بشكل مستقل — رخصة XTTS v2 (CPML) غير تجارية صراحةً، وقد أوقفت شركة Coqui AI، الشركة القائمة عليها، خدمات الترخيص المدفوعة في ديسمبر 2023؛ تحقّق بنفسك من شروط الترخيص قبل إطلاق أي من هذه المحركات في منتج مدفوع.
- ❌ إذا كنت تستنسخ صوت شخص حقيقي دون موافقته — يثير هذا مسائل موافقة وانتحال هوية مستقلة عن ترخيص أي محرك، في الاستخدام الشخصي والتجاري على حد سواء.
الأسئلة الشائعة
هل يملك Ollama تحويل نص إلى كلام مدمج؟
لا. يولّد Ollama نصًا فقط ولا يملك مخرجات صوتية أصلية. طلب ميزة على GitHub لدعم TTS أصلي (issue #11021) لا يزال دون حل حتى وقت كتابة هذا المقال. تتطلب المخرجات الصوتية توجيه رد Ollama النصي إلى محرك TTS محلي منفصل.
ما هو أفضل محرك TTS لاقترانه بـ Ollama؟
Piper، لمعظم الإعدادات — يعمل على CPU فقط، ومرخّص بموجب GPL-3.0-or-later، ويعمل بزمن حقيقي حتى على Raspberry Pi، فهو لا ينافس Ollama على ذاكرة GPU. اختر Kokoro لجودة صوت مُدركة أعلى مع استهلاك موارد مماثل، أو XTTS v2 / Chatterbox إذا كنت بحاجة تحديدًا إلى استنساخ الصوت.
كيف أوجّه مخرجات Ollama إلى محرك TTS؟
أرسل طلب POST إلى واجهة REST API الخاصة بـ Ollama على http://localhost:11434/api/generate مع "stream": false، واستخرج حقل response من استجابة JSON الناتجة، ومرّر هذا النص إلى واجهة سطر أوامر محرك TTS المختار (يقبل Piper النص عبر stdin) أو واجهة Python الخاصة به (يعرض كل من Kokoro وXTTS v2 وChatterbox وBark ومجموعة أدوات Coqui TTS واجهة كهذه). راجع شرح خط الأنابيب أعلاه للحصول على أوامر فعلية.
هل أحتاج إلى GPU لتشغيل محرك TTS بجانب Ollama؟
ليس بالضرورة. Piper وKokoro متوافقان مع CPU ولا يتطلبان GPU. يستفيد كل من XTTS v2 وBark وChatterbox من GPU أو يحتاجه للأداء بزمن حقيقي، ما يعني أنها تتنافس مع Ollama على ذاكرة GPU على جهاز بوحدة GPU واحدة.
هل يمكنني استخدام XTTS v2 تجاريًا في منتج قائم على Ollama؟
ليس دون اتفاق منفصل. XTTS v2 مرخّص بموجب Coqui Public Model License (CPML)، وهي رخصة غير تجارية. أوقفت شركة Coqui AI، التي أصدرته، خدماتها المدفوعة في ديسمبر 2023، ولم تستطع PromptQuorum تأكيد وجود مسار ترخيص تجاري نشط اليوم. راجع التحليل الكامل لترخيص XTTS v2 قبل إطلاق منتج مدفوع.
أي محرك TTS يجب أن أستخدمه لمساعد صوتي على Raspberry Pi يشغّل Ollama؟
Piper. إنه المحرك الوحيد في هذه المقارنة المؤكَّد عمله بزمن حقيقي على جهاز يعتمد على CPU فقط مثل Raspberry Pi، وهو بالضبط القيد الذي يفرضه جهاز Pi عندما يشغّل Ollama أو يتواصل معه أيضًا.
هل يوجد تكامل رسمي بين Ollama وأي محرك TTS؟
لا. لا يوجد إضافة (plugin) رسمية أو callback أو جسر مدمج يربط Ollama بأي محرك TTS. كل اقتران موصوف في هذا الدليل هو كود ربط تكتبه بنفسك — عادةً أقل من 20 سطرًا يستدعي واجهة REST API الخاصة بـ Ollama ثم واجهة سطر الأوامر أو واجهة Python الخاصة بمحرك TTS.
ما الفرق بين Kokoro وPiper لخط أنابيب مع Ollama؟
كلاهما متوافق مع CPU ومجاني للاستخدام التجاري (Kokoro بموجب رخصة Apache-2.0، وPiper بموجب رخصة GPL-3.0-or-later). Kokoro نموذج أكبر (82 مليون معامل) يقدّم جودة صوت مُدركة أعلى بشكل ملحوظ وفق معايير الإصدار الخاصة به، بينما Piper أخف وله سجل أطول في العمل بزمن حقيقي على أجهزة متواضعة جدًا مثل Raspberry Pi.
هل يمكنني استنساخ صوتي الخاص لسرد مخرجات Ollama؟
نعم، باستخدام XTTS v2 (6 ثوانٍ من الصوت المرجعي، رخصة CPML غير تجارية) أو Chatterbox (نحو 5 ثوانٍ من الصوت المرجعي، رخصة MIT، الاستخدام التجاري مسموح). لا يدعم Piper ولا Kokoro استنساخ الصوت — يستخدم كلاهما أصواتًا ثابتة مُدرَّبة مسبقًا.
الخلاصة
غياب تحويل النص إلى كلام الأصلي في Ollama ليس ثغرة يجب التحايل عليها بإضافة — إنه قرار تصميمي يبقي Ollama مركّزًا على استدلال نماذج اللغة، وكل خط أنابيب صوتي مبني عليه يربط محركًا منفصلًا. لمعظم القراء، ينبغي أن يكون هذا المحرك Piper: يكلّف موارد شبه معدومة بجانب نموذج LLM يعمل بالفعل، ويُربط بسطر واحد في سكربت shell أو عملية فرعية بلغة Python، ويعمل بزمن حقيقي على أجهزة متواضعة مثل Raspberry Pi. إذا لم تكن جودة صوت Piper كافية، فإن Kokoro هو الخطوة التالية باستهلاك موارد مماثل. لا تلجأ إلى XTTS v2 أو Chatterbox إلا عندما يكون استنساخ الصوت حاجة حقيقية، وخصص GPU لذلك، وتأكد — خصوصًا بالنسبة لـXTTS v2 — من أن رخصة CPML غير التجارية تناسب حالة استخدامك قبل البناء عليها. عند الشك، ثبّت Piper أولاً: إنه أسرع طريقة لسماع نموذج Ollama يتحدث، والانتقال لاحقًا إلى محرك أثقل تغيير أصغر من البدء به مباشرة.
المصادر
- GitHub issue #11021 الخاص بـ Ollama — طلب الميزة لدعم TTS أصلي، أُغلق باعتباره نسخة مكررة من issue أقدم لا يزال مفتوحًا.
- توثيق واجهة REST API الخاصة بـ Ollama — نقطة النهاية
/api/generateالمستخدمة في أمثلة خط الأنابيب في هذا الدليل. - maudoin/ollama-voice على GitHub — مشروع مجتمعي يربط Whisper وOllama وpyttsx3؛ 378 نجمة وقت كتابة هذا المقال.
- بطاقة نموذج Kokoro-82M على Hugging Face — عدد المعاملات، والترخيص، والبنية.
- XTTS v2 على Hugging Face — متطلبات الاستنساخ ومرجع الترخيص.
- Chatterbox على GitHub — نموذج استنساخ الصوت مفتوح المصدر من Resemble AI، وترخيصه، وأمثلة استخدامه.
- Bark على GitHub — نموذج الصوت التوليدي من Suno، وترخيصه، وسجل التعديلات (commits) الخاص به.