핵심 요점
- Ollama는 텍스트만 생성하며, 네이티브 TTS 요청(GitHub 이슈 #11021)은 본 글 작성 시점까지 해결되지 않았습니다.
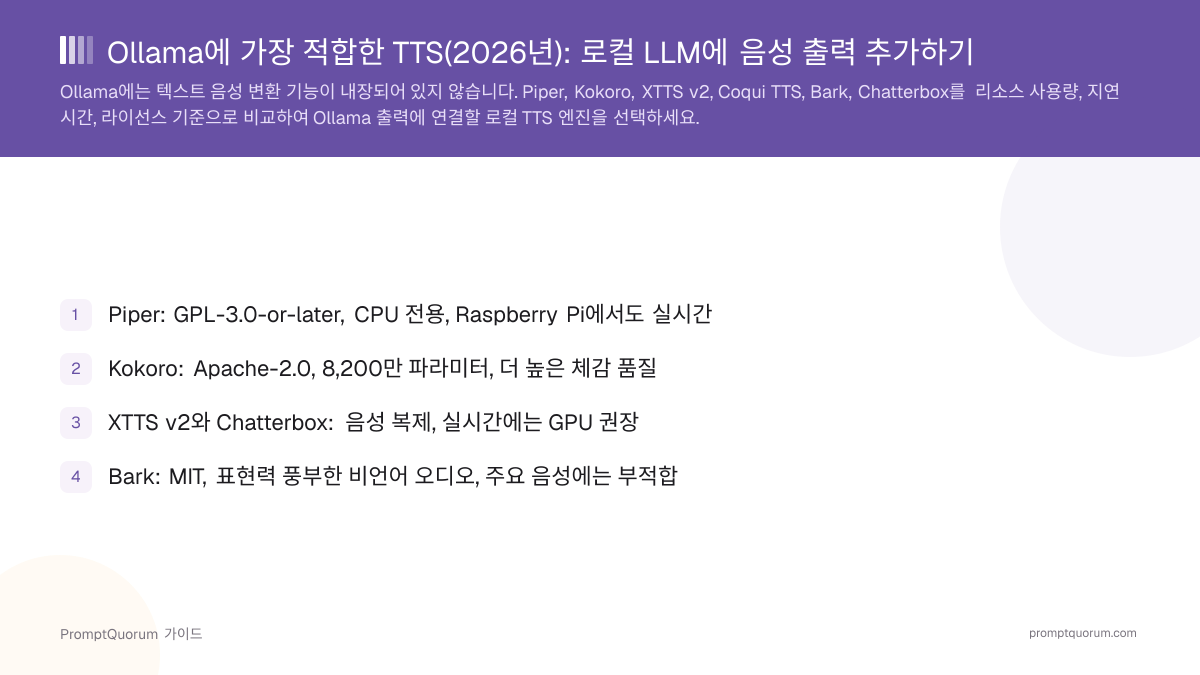
- Piper는 리소스 비용이 가장 낮은 조합입니다. CPU 전용이며, Raspberry Pi에서도 실시간으로 동작하고, GPL-3.0-or-later 라이선스입니다.
- Kokoro(8,200만 파라미터, Apache-2.0)는 약간의 속도를 희생하는 대신 눈에 띄게 더 나은 체감 음성 품질을 제공합니다.
- XTTS v2와 Chatterbox는 모두 짧은 참조 클립으로부터 음성을 복제하지만, XTTS v2의 라이선스는 비상업용인 반면 Chatterbox는 MIT 라이선스입니다.
- Bark는 웃음소리, 한숨 등 비언어 오디오를 추가할 수 있지만, GitHub 저장소는 2024년 4월 5일 이후 커밋이 없습니다.
- 파이프라인 구조는 어느 경우든 동일합니다. Ollama의 REST API가 JSON 텍스트를 반환하면 코드가 이를 추출하고, 이 텍스트를 TTS 엔진의 CLI나 Python API로 전달합니다.
📍 한 문장으로
Ollama에는 텍스트 음성 변환 기능이 내장되어 있지 않으므로, 음성 출력을 추가한다는 것은 텍스트 응답을 별도의 로컬 TTS 엔진으로 전달한다는 의미입니다. 리소스 비용이 가장 낮은 Piper, 비슷한 규모에서 더 높은 품질을 제공하는 Kokoro, 음성 복제를 위한 XTTS v2나 Chatterbox, 표현력이 풍부한 비언어 오디오만을 위한 Bark 중에서 선택할 수 있습니다.
💬 쉽게 말하면
Ollama는 생각하고 응답을 작성하는 부분이고, TTS 엔진은 그 작성된 응답을 발화 오디오로 바꾸는 별도의 프로그램입니다. 두 가지를 코드 몇 줄로 직접 연결해야 하며, 두 가지를 모두 처리하는 단일 버튼은 존재하지 않습니다.
📌참고: 이 글은 음성 파이프라인 중 TTS 부분만 다룹니다. 입력 측 음성 인식(Whisper)까지 추가한 전체 구축 방법은 PromptQuorum의 로컬 음성 어시스턴트 가이드를 참고하십시오.
Ollama에 텍스트 음성 변환이 내장되어 있습니까?
아니요—Ollama에는 텍스트 음성 변환이나 오디오 출력 기능이 내장되어 있지 않습니다. Ollama는 대규모 언어 모델을 위한 로컬 실행 환경입니다. 모델을 로드하고, 로컬 REST API와 CLI로 이를 노출하며, 텍스트를 반환합니다. 음성을 합성하지 않으며, 어떤 TTS 모델도 함께 제공하지 않습니다.
네이티브 TTS 지원을 요청하는 GitHub 이슈 #11021은 오디오 생성 모델을 직접 로드하고 OpenAI 호환 엔드포인트 POST /v1/audio/speech를 추가하는 방안을 제안했습니다. 이는 여전히 열려 있는 더 오래된 요청(이슈 #5424)의 중복으로 종료되었습니다. 본 글 작성 시점까지 Ollama는 네이티브 TTS를 출시하지 않았으며, 확정된 일정도 없습니다.
이런 이유로 Ollama를 기반으로 한 모든 로컬 음성 환경—음성 어시스턴트, LLM 출력용 오디오북 내레이터, 접근성을 위한 소리 내어 읽기 도구—은 단일한 "Ollama TTS 모드"에 의존하는 대신 Ollama를 별도의 TTS 엔진에 연결합니다. 이를 위한 커뮤니티 연결 프로젝트는 이미 존재합니다. 본 글 작성 시점 기준 GitHub 스타 378개를 보유한 maudoin/ollama-voice는 텍스트 변환에는 Whisper를, 응답에는 Ollama를, 출력에는 신경망 TTS 모델이 아니라 운영체제에 내장된 음성을 감싸는 래퍼인 pyttsx3를 연결합니다. 이 프로젝트는 연결 패턴을 보여줄 뿐, pyttsx3의 음질을 추천하는 것은 아닙니다. 이 가이드에서 비교한 모든 신경망 엔진보다 음질이 떨어집니다.
Ollama에 공식적인 텍스트 음성 변환 기능이 있습니까?
없습니다. Ollama는 텍스트만 생성합니다. 네이티브 TTS 지원을 추가해달라는 커뮤니티 기능 요청(GitHub 이슈 #11021)은 본 글 작성 시점까지 해결되지 않았으며, 여전히 열려 있는 더 오래된 요청의 중복으로 종료되었습니다. 음성 출력을 위해서는 Ollama의 텍스트 응답을 별도의 TTS 엔진으로 전달해야 합니다.
Ollama 출력을 로컬 TTS 엔진으로 전달하는 방법
Ollama와 TTS를 결합하는 모든 파이프라인은 동일한 네 단계를 따릅니다. Ollama에 텍스트를 요청하고, JSON 응답에서 그 텍스트를 추출하고, TTS 엔진에 전달하고, 생성된 오디오를 재생하거나 저장합니다. Ollama와 어떤 TTS 엔진 사이에도 공식적인 통합은 존재하지 않습니다. 이는 직접 작성하는 연결 코드로, 보통 20줄 미만입니다.
- Ollama의 API는 자신의 텍스트 출력이 이후 어떻게 쓰이는지 알지도, 관여하지도 않습니다. Ollama를 TTS 엔진에 연결하는 콜백, 웹훅, 플러그인 시스템은 존재하지 않으며, 둘을 연결하는 것은 오직 직접 작성한 코드뿐입니다.
- 스트리밍 모드(
"stream": true)는 토큰이 생성되는 대로 반환함으로써 체감 지연 시간을 줄여줍니다. 모델이 전체 응답을 완료하기 전에 첫 문장의 오디오 합성을 시작할 수 있어 대화형 음성 어시스턴트에 유용하지만, 위의 비스트리밍 예제보다 구현이 더 복잡합니다.
- 1Ollama를 시작하고 모델을 내려받는다
Why it matters: REST API를 통해 요청에 응답할 수 있으려면 Ollama가 이미 실행 중이어야 하고(`ollama serve` 또는 데스크톱 앱), 최소한 하나의 모델이 내려받아져 있어야 합니다(`ollama pull llama3.1`). - 2Ollama의 REST API에 프롬프트를 전송한다
Why it matters: `"stream": false`를 붙여 `http://localhost:11434/api/generate`에 POST 요청을 보내면, 전체 응답이 `response` 필드에 담긴 단일 JSON 객체가 반환됩니다. TTS 파이프라인에서 가장 파싱하기 쉬운 방식이지만, 첫 오디오까지의 시간을 줄이는 스트리밍 모드도 사용할 수 있습니다. - 3텍스트를 추출해 TTS 엔진으로 전달한다
Why it matters: `response` 문자열은 일반 텍스트입니다. 표준 입력을 통해 TTS 엔진의 CLI(Piper)로 직접 전달하거나, 해당 엔진의 Python API(Kokoro, XTTS v2, Chatterbox, Bark 또는 Coqui TTS 툴킷)로 전달합니다. - 4생성된 오디오를 재생하거나 저장한다
Why it matters: 대부분의 TTS CLI와 API는 `.wav` 파일을 직접 기록합니다. 실시간 재생을 위해서는 원시 오디오를 `aplay`(Linux) 같은 플레이어로 전달하거나 Python 오디오 라이브러리를 사용합니다.
# 1. Ollama에 텍스트 응답을 요청한다(단순화를 위해 스트리밍 사용 안 함)
RESPONSE=$(curl -s http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Explain quantum entanglement in two sentences.",
  "stream": false
}' | python3 -c "import sys, json; print(json.load(sys.stdin)['response'])")

# 2. 이 텍스트를 Piper의 CLI로 전달해 오디오를 합성한다(리소스 비용이 가장 낮은 옵션)
echo "$RESPONSE" | piper --model en_US-lessac-medium --output_file response.wav

# --- Piper 대신 Kokoro를 사용하는 동등한 Python 버전 ---
import json
import requests
import soundfile as sf
from kokoro_onnx import Kokoro

reply = requests.post(
    "http://localhost:11434/api/generate",
    json={"model": "llama3.1", "prompt": "Explain quantum entanglement in two sentences.", "stream": False},
).json()["response"]

kokoro = Kokoro("kokoro-v1.0.onnx", "voices-v1.0.bin")
samples, sample_rate = kokoro.create(reply, voice="af_heart")
sf.write("response.wav", samples, sample_rate)
어떤 TTS 엔진이 Ollama와 가장 잘 맞습니까?
Piper는 이미 CPU나 GPU 메모리를 사용 중인 LLM 옆에서 리소스 경쟁을 가장 적게 일으키므로 대부분의 Ollama 조합에 가장 적합합니다. 아래 표는 각 후보를 단순한 원음질이 아니라 리소스 사용량, 지연 시간, 연동에 필요한 코드량, 라이선스 등 Ollama와 머신을 얼마나 잘 공유하는지를 기준으로 평가합니다.
Piper
- 라이선스:
- GPL-3.0-or-later
- 리소스 사용량:
- CPU 전용, 매우 가벼움
- 지연 시간:
- Raspberry Pi에서도 실시간
- 연동 용이성:
- CLI 호출 한 번, 표준 입력으로 텍스트 전달
Kokoro
- 라이선스:
- Apache-2.0
- 리소스 사용량:
- CPU 지원, 가벼움(8,200만 파라미터)
- 지연 시간:
- 빠름; GPU 엔진 대비 공개된 실시간 수치 없음
- 연동 용이성:
- Python API(kokoro-onnx), 몇 줄이면 충분
XTTS v2
- 라이선스:
- CPML(비상업용)
- 리소스 사용량:
- 높음; GPU 권장
- 지연 시간:
- Coqui 문서 기준 GPU에서 200ms 미만 스트리밍
- 연동 용이성:
- Python API, 설정이 더 필요함(라이선스 동의)
Coqui TTS 툴킷
- 라이선스:
- MPL-2.0(툴킷만 해당)
- 리소스 사용량:
- 로드하는 모델에 따라 다름
- 지연 시간:
- 로드하는 모델에 따라 다름
- 연동 용이성:
- 여러 모델을 하나의 Python API로
Bark
- 라이선스:
- MIT
- 리소스 사용량:
- 높음; GPU 권장, CPU에서는 느림
- 지연 시간:
- 실시간 스트리밍용으로 설계되지 않음
- 연동 용이성:
- Python API, 단순하지만 더 느림
Chatterbox
- 라이선스:
- MIT
- 리소스 사용량:
- 중간; 실시간에는 GPU 권장
- 지연 시간:
- 공개적으로 확인된 실시간 수치 없음
- 연동 용이성:
- Python API(chatterbox-tts pip 패키지)
Ollama와 나란히 실행할 때 가장 적은 리소스를 사용하는 TTS 엔진은 무엇입니까?
Piper입니다. CPU만으로 동작하고, Raspberry Pi에서도 실시간으로 작동하며, Ollama 모델과 GPU 메모리를 공유할 필요가 없습니다—이 비교에서 리소스 비용이 가장 낮은 옵션입니다.
누가 어떤 엔진을 사용해야 합니까?
단순히 원음질이 가장 높은 엔진이 아니라, 하드웨어와 음성 요구사항에 맞는 엔진을 선택하십시오.
- 🏆 Ollama 조합 전반에 가장 적합한 선택: Piper — 리소스 비용이 가장 낮고, CPU에서 실시간으로 동작하며, 셸 스크립트나 Python 서브프로세스 호출에 가장 쉽게 연동됩니다.
- 비슷한 규모에서 더 높은 음질을 원할 때 가장 적합한 선택: Kokoro — 여전히 GPU 없이 동작할 만큼 작으면서도, 자체 출시 벤치마크 기준 Piper보다 눈에 띄게 나은 체감 음성 품질을 제공합니다.
- 상업적 사용이 허용된 음성 복제에 가장 적합한 선택: Chatterbox — MIT 라이선스이며, 약 5초의 참조 오디오로부터 음성을 복제하고, 실시간 사용에는 Ollama 외에 GPU가 필요합니다.
- 비상업용 또는 연구용 음성 복제에 가장 적합한 선택: XTTS v2 — 6초의 오디오로부터 17개 언어에 걸쳐 음성을 복제하지만, CPML 라이선스로 인해 별도 계약 없이는 상업적으로 사용할 수 없습니다—자세한 내용은 PromptQuorum의 XTTS v2 라이선스 해설을 참고하십시오.
- 주요 음성이 아니라 표현력이 풍부한 비언어 오디오에 가장 적합한 선택: Bark — 텍스트 프롬프트만으로 웃음소리, 한숨, 간단한 주변음을 생성할 수 있지만, 저장소가 2024년 4월 5일 이후 커밋이 없으므로 유지 관리되는 프로덕션 파이프라인에는 의존하지 마십시오.
- 🧭 Raspberry Pi 등 CPU 전용 하드웨어에서 소형 모델로 Ollama를 실행하는 경우 → Piper. 이 가이드의 다른 어떤 엔진도 GPU 없이 실시간으로 동작한다고 확인되지 않았습니다.
- 🧭 Ollama 외에 여유 GPU가 있는 데스크톱이나 서버에서 복제된 음성을 원하고 상업적 권리가 필요한 경우 → Chatterbox.
- 🧭 여유 GPU가 있는 데스크톱이나 서버에서 연구용 또는 개인 프로젝트로 최고의 복제 품질을 원하는 경우 → XTTS v2.
- 🧭 시간이 지나며 여러 다른 모델(XTTS v2 포함)을 로드할 수 있는 단일 툴킷을 원하는 경우 → 각 모델의 의존성을 개별적으로 설치하는 대신 Coqui TTS 툴킷.
이 엔진들을 사용하지 말아야 할 때
Ollama와 결합한 로컬 TTS가 모든 음성 출력 요구에 적합한 접근 방식은 아닙니다. 일부 상황에서는 클라우드 API나 완전히 다른 도구가 필요합니다.
- ❌ 바로 쓸 수 있는 세련되고 감정 표현이 풍부한 수십 가지 음성이 필요한 경우 — ElevenLabs 같은 관리형 클라우드 API는 이 가이드의 어떤 모델보다도 더 폭넓은 엄선된 음성 라이브러리와 더 풍부한 표현 제어를 제공합니다. 트레이드오프에 대해서는 PromptQuorum의 ElevenLabs 대 로컬 TTS 비교를 참고하십시오.
- ❌ 하드웨어에 Ollama가 이미 사용 중인 것 이상의 RAM이나 VRAM 여유가 없는 경우 — 동일한 보급형 GPU에서 Ollama와 XTTS v2나 Bark처럼 GPU를 많이 필요로 하는 TTS 엔진을 함께 실행하면 둘 다 리소스가 부족해질 수 있습니다. Piper나 Kokoro로 낮추거나, TTS를 별도 머신으로 옮기십시오.
- ❌ 상업용 제품을 출시해야 하는데 라이선스를 독립적으로 확인하지 않은 경우 — XTTS v2의 CPML은 명시적으로 비상업용이며, 이를 배포한 회사 Coqui AI는 2023년 12월에 유료 라이선스 서비스를 중단했습니다. 이 엔진들 중 어느 것이든 유료 제품에 출시하기 전에 라이선스 조건을 직접 확인하십시오.
- ❌ 실제 인물의 목소리를 동의 없이 복제하는 경우 — 이는 어떤 엔진의 라이선스와도 무관하게 동의와 사칭 문제를 야기하며, 개인적 사용과 상업적 사용 모두에 동일하게 적용됩니다.
자주 묻는 질문
Ollama에 텍스트 음성 변환이 내장되어 있습니까?
아니요. Ollama는 텍스트만 생성하며 네이티브 오디오 출력이 없습니다. 네이티브 TTS를 요청하는 GitHub 기능 요청(이슈 #11021)은 본 글 작성 시점까지 해결되지 않았습니다. 음성 출력을 위해서는 Ollama의 텍스트 응답을 별도의 로컬 TTS 엔진으로 전달해야 합니다.
Ollama와 조합하기에 가장 적합한 TTS 엔진은 무엇입니까?
대부분의 환경에서는 Piper입니다. CPU만으로 동작하고, GPL-3.0-or-later 라이선스이며, Raspberry Pi에서도 실시간으로 동작해 GPU 메모리를 두고 Ollama와 경쟁하지 않습니다. 비슷한 리소스 사용량에서 더 높은 체감 음질을 원하면 Kokoro를, 음성 복제가 특별히 필요하면 XTTS v2나 Chatterbox를 선택하십시오.
Ollama의 출력을 TTS 엔진으로 어떻게 전달합니까?
"stream": false를 붙여 Ollama의 REST API(http://localhost:11434/api/generate)에 POST 요청을 보내고, 반환된 JSON에서 response 필드를 추출한 뒤, 이 텍스트를 선택한 TTS 엔진의 CLI(Piper는 표준 입력으로 텍스트를 받습니다)나 Python API(Kokoro, XTTS v2, Chatterbox, Bark, Coqui TTS 툴킷 모두 제공)로 전달하십시오. 실제 작동하는 명령은 위의 파이프라인 설명을 참고하십시오.
Ollama와 나란히 TTS 엔진을 실행하려면 GPU가 필요합니까?
반드시 그런 것은 아닙니다. Piper와 Kokoro는 모두 CPU를 지원하며 GPU가 필요하지 않습니다. XTTS v2, Bark, Chatterbox는 모두 실시간 성능을 위해 GPU의 이점을 얻거나 GPU가 필요하며, 이는 GPU가 하나뿐인 머신에서 Ollama와 GPU 메모리를 두고 경쟁하게 됨을 의미합니다.
Ollama 기반 제품에서 XTTS v2를 상업적으로 사용할 수 있습니까?
별도 계약 없이는 사용할 수 없습니다. XTTS v2는 Coqui Public Model License(CPML)로 라이선스되어 있으며, 이는 비상업용입니다. 이를 배포한 회사 Coqui AI는 2023년 12월에 유료 서비스를 중단했으며, PromptQuorum은 오늘날 활성화된 상업 라이선스 경로가 존재하는지 확인할 수 없었습니다. 유료 제품을 출시하기 전에 전체 XTTS v2 라이선스 해설을 참고하십시오.
Ollama를 실행하는 Raspberry Pi 음성 어시스턴트에는 어떤 TTS 엔진을 사용해야 합니까?
Piper입니다. Raspberry Pi 같은 CPU 전용 하드웨어에서 실시간으로 동작한다고 확인된 이 비교에서 유일한 엔진이며, 이는 Pi가 Ollama를 동시에 실행하거나 통신할 때 부과되는 바로 그 제약 조건입니다.
Ollama와 어떤 TTS 엔진 사이에 공식적인 통합이 있습니까?
없습니다. Ollama를 어떤 TTS 엔진에든 연결하는 공식 플러그인, 콜백, 내장 브리지는 존재하지 않습니다. 이 가이드에서 설명한 모든 조합은 직접 작성하는 연결 코드이며, 일반적으로 Ollama의 REST API를 호출한 뒤 TTS 엔진 자체의 CLI나 Python API를 호출하는 20줄 미만의 코드입니다.
Ollama 파이프라인에서 Kokoro와 Piper의 차이는 무엇입니까?
둘 다 CPU를 지원하며 상업적으로 무료로 사용할 수 있습니다(Kokoro는 Apache-2.0 라이선스, Piper는 GPL-3.0-or-later 라이선스). Kokoro는 더 큰 모델(8,200만 파라미터)로, 자체 출시 벤치마크 기준 눈에 띄게 더 높은 체감 음성 품질을 제공하는 반면, Piper는 더 가볍고 Raspberry Pi 같은 매우 보급형 하드웨어에서 실시간으로 동작해 온 실적이 더 깁니다.
Ollama의 출력을 낭독하기 위해 제 목소리를 복제할 수 있습니까?
네, XTTS v2(6초의 참조 오디오, 비상업용 CPML 라이선스) 또는 Chatterbox(약 5초의 참조 오디오, MIT 라이선스, 상업적 사용 가능)로 가능합니다. Piper와 Kokoro는 모두 음성 복제를 지원하지 않으며, 둘 다 고정된 사전 학습된 음성을 사용합니다.
결론
Ollama에 네이티브 텍스트 음성 변환 기능이 없는 것은 플러그인으로 우회해야 할 결함이 아닙니다. 이는 Ollama를 언어 모델 추론에 집중시키는 설계상의 선택이며, 그 위에 구축되는 모든 음성 파이프라인은 별도의 엔진을 연결합니다. 대부분의 독자에게는 그 엔진이 Piper여야 합니다. 이미 실행 중인 LLM 옆에서 거의 리소스를 소비하지 않고, 셸 스크립트나 Python 서브프로세스에 한 줄로 연동되며, Raspberry Pi만큼 보급형인 하드웨어에서도 실시간으로 동작합니다. Piper의 음질로 충분하지 않다면 Kokoro가 비슷한 리소스 사용량에서 다음 단계가 됩니다. XTTS v2나 Chatterbox는 음성 복제가 실제로 필요한 경우에만 사용하고, 이를 위한 GPU 예산을 확보하며, 특히 XTTS v2의 경우 구축을 시작하기 전에 비상업용 CPML 라이선스가 자신의 사용 사례에 맞는지 확인하십시오. 확신이 서지 않는다면 우선 Piper를 설치하십시오. Ollama 모델이 말하는 것을 가장 빨리 들을 수 있는 방법이며, 나중에 더 무거운 엔진으로 전환하는 것이 처음부터 그것으로 시작하는 것보다 더 작은 변경입니다.
출처
- Ollama GitHub 이슈 #11021 — 네이티브 TTS 지원 기능 요청. 여전히 열려 있는 더 오래된 이슈의 중복으로 종료됨.
- Ollama REST API 문서 — 이 가이드의 파이프라인 예제에서 사용한
/api/generate엔드포인트. - GitHub의 maudoin/ollama-voice — Whisper, Ollama, pyttsx3를 연결하는 커뮤니티 프로젝트. 본 글 작성 시점 기준 스타 378개.
- Hugging Face의 Kokoro-82M 모델 카드 — 파라미터 수, 라이선스, 아키텍처.
- Hugging Face의 XTTS v2 — 복제 요구사항 및 라이선스 참조.
- GitHub의 Chatterbox — Resemble AI의 오픈소스 음성 복제 모델, 라이선스, 사용 예제.
- GitHub의 Bark — Suno의 생성형 오디오 모델, 라이선스, 커밋 이력.