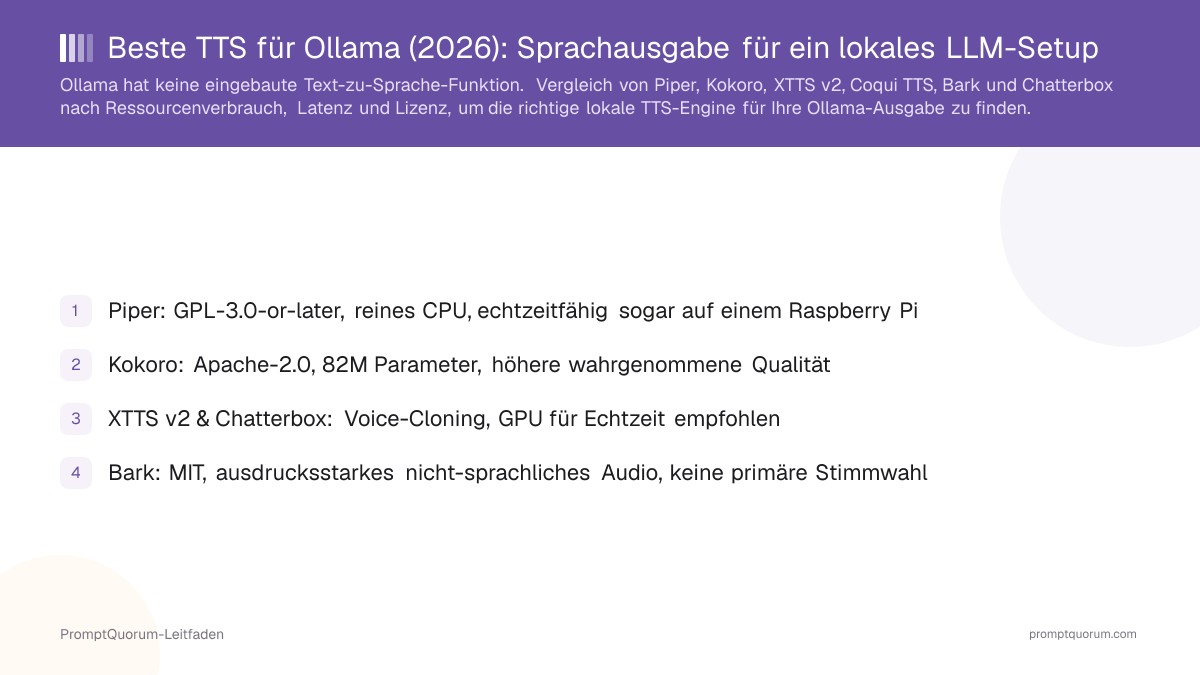
Wichtigste Erkenntnisse
- Ollama erzeugt nur Text; eine Anfrage für natives TTS (GitHub-Issue #11021) ist zum Zeitpunkt der Erstellung ungelöst.
- Piper ist die ressourcenschonendste Kombination: reines CPU, echtzeitfähig sogar auf einem Raspberry Pi, GPL-3.0-or-later-Lizenz.
- Kokoro (82M Parameter, Apache-2.0) tauscht etwas Geschwindigkeit gegen merklich bessere wahrgenommene Sprachqualität.
- XTTS v2 und Chatterbox klonen beide eine Stimme aus einem kurzen Referenzclip, doch die Lizenz von XTTS v2 ist nicht-kommerziell, während Chatterbox MIT-lizenziert ist.
- Bark ergänzt Lachen, Seufzer und andere nicht-sprachliche Audioeffekte, doch sein GitHub-Repository hat seit dem 5. April 2024 keine Commits mehr erhalten.
- Die Pipeline hat in jedem Fall dieselbe Form: Die REST-API von Ollama liefert JSON-Text, Ihr Code extrahiert ihn, und dieser Text wird an die CLI oder Python-API der TTS-Engine übergeben.
📍 In einem Satz
Ollama hat keine eingebaute Text-zu-Sprache-Funktion. Sprachausgabe bedeutet, die Textantwort an eine separate lokale TTS-Engine weiterzuleiten — Piper für die geringsten Ressourcenkosten, Kokoro für höhere Qualität bei ähnlichem Fußabdruck, XTTS v2 oder Chatterbox für Voice-Cloning und Bark nur für ausdrucksstarkes, nicht-sprachliches Audio.
💬 In einfachen Worten
Ollama ist der Teil, der denkt und die Antwort schreibt; eine TTS-Engine ist ein separates Programm, das diese geschriebene Antwort in gesprochenes Audio verwandelt. Sie verbinden beide selbst mit ein paar Zeilen Code — es gibt keinen einzelnen Knopf, der beides erledigt.
📌Hinweis: Dieser Artikel deckt nur die TTS-Hälfte einer Sprachpipeline ab. Für einen vollständigen Aufbau, der auch Spracherkennung (Whisper) auf der Eingabeseite ergänzt, siehe PromptQuorums Leitfaden zum lokalen Sprachassistenten.
Hat Ollama eine eingebaute Text-zu-Sprache-Funktion?
Nein — Ollama hat keine eingebaute Text-zu-Sprache- oder Audioausgabefunktion. Ollama ist eine lokale Laufzeitumgebung für große Sprachmodelle: Es lädt ein Modell, stellt es über eine lokale REST-API und CLI bereit und liefert Text. Es synthetisiert keine Sprache und liefert kein TTS-Modell mit.
Ein GitHub-Issue, das native TTS-Unterstützung anfragt, #11021, schlug vor, Audio-Generierungsmodelle direkt zu laden und einen OpenAI-kompatiblen Endpunkt POST /v1/audio/speech zu ergänzen. Es wurde als Duplikat einer früheren, weiterhin offenen Anfrage (Issue #5424) geschlossen — zum Zeitpunkt der Erstellung dieses Artikels hat Ollama kein natives TTS ausgeliefert, und es gibt keinen zugesagten Zeitplan dafür.
Deshalb bindet jedes lokale Sprach-Setup auf Ollama-Basis — ein Sprachassistent, ein Hörbuch-Vorleser für LLM-Ausgaben oder ein Barrierefreiheits-Vorlesewerkzeug — Ollama an eine separate TTS-Engine an, statt sich auf einen „Ollama-TTS-Modus" zu verlassen. Community-Verbindungsprojekte existieren dafür bereits: maudoin/ollama-voice, mit 378 GitHub-Sternen zum Zeitpunkt der Erstellung, verbindet Whisper für die Transkription, Ollama für die Antwort und pyttsx3 — einen Wrapper um die eingebauten Stimmen Ihres Betriebssystems, kein neuronales TTS-Modell — für die Ausgabe. Dieses Projekt zeigt das Muster; es ist keine Empfehlung für die Audioqualität von pyttsx3, die hinter jeder in diesem Leitfaden verglichenen neuronalen Engine zurückbleibt.
Gibt es eine offizielle Text-zu-Sprache-Funktion für Ollama?
Nein. Ollama erzeugt nur Text. Eine Community-Funktionsanfrage zur Ergänzung nativer TTS-Unterstützung (GitHub-Issue #11021) ist zum Zeitpunkt der Erstellung ungelöst und wurde als Duplikat einer früheren, weiterhin offenen Anfrage geschlossen. Sprachausgabe erfordert das Weiterleiten der Textantwort von Ollama an eine separate TTS-Engine.
Ollama-Ausgabe an eine lokale TTS-Engine weiterleiten
Jede Ollama-plus-TTS-Pipeline folgt denselben vier Schritten: Ollama um Text bitten, diesen Text aus der JSON-Antwort extrahieren, ihn an eine TTS-Engine übergeben und das resultierende Audio abspielen oder speichern. Es gibt keine offizielle Integration zwischen Ollama und einer TTS-Engine — das ist Verbindungscode, den Sie selbst schreiben, typischerweise unter 20 Zeilen.
- Die API von Ollama kennt und kümmert sich nicht darum, was mit ihrer Textausgabe geschieht. Es gibt keinen Callback, Webhook oder Plugin-System, das Ollama mit einer TTS-Engine verbindet — Ihr Code ist das Einzige, das beide verbindet.
- Streaming-Modus (
"stream": true) senkt die wahrgenommene Latenz, indem Token bei der Generierung zurückgegeben werden, sodass Sie mit der Synthese des ersten Satzes beginnen können, bevor das Modell die vollständige Antwort abgeschlossen hat — nützlich für interaktive Sprachassistenten, komplexer umzusetzen als das nicht-streamende Beispiel oben.
- 1Ollama starten und ein Modell laden
Why it matters: Ollama muss bereits laufen (`ollama serve` oder die Desktop-App) mit mindestens einem geladenen Modell (`ollama pull llama3.1`), bevor es Anfragen über seine REST-API beantworten kann. - 2Einen Prompt an die REST-API von Ollama senden
Why it matters: Eine POST-Anfrage an `http://localhost:11434/api/generate` mit `"stream": false` liefert ein einziges JSON-Objekt mit der vollständigen Antwort im Feld `response` — am einfachsten für eine TTS-Pipeline zu verarbeiten, obwohl Streaming-Modus für geringere Zeit bis zum ersten Audio verfügbar ist. - 3Den Text extrahieren und an Ihre TTS-Engine übergeben
Why it matters: Die Zeichenkette `response` ist reiner Text — übergeben Sie sie direkt an die CLI einer TTS-Engine über stdin (Piper) oder deren Python-API (Kokoro, XTTS v2, Chatterbox, Bark oder das Coqui-TTS-Toolkit). - 4Das resultierende Audio abspielen oder speichern
Why it matters: Die meisten TTS-CLIs und -APIs schreiben direkt eine `.wav`-Datei; für Live-Wiedergabe leiten Sie rohes Audio an einen Player wie `aplay` (Linux) weiter oder nutzen eine Python-Audiobibliothek.
# 1. Ollama um eine Textantwort bitten (nicht-streamend, der Einfachheit halber)
RESPONSE=$(curl -s http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Explain quantum entanglement in two sentences.",
  "stream": false
}' | python3 -c "import sys, json; print(json.load(sys.stdin)['response'])")

# 2. Diesen Text an Pipers CLI weiterleiten, um Audio zu synthetisieren (ressourcenschonendste Option)
echo "$RESPONSE" | piper --model en_US-lessac-medium --output_file response.wav

# --- Äquivalente Python-Version, Kokoro statt Piper eingesetzt ---
import json
import requests
import soundfile as sf
from kokoro_onnx import Kokoro

reply = requests.post(
    "http://localhost:11434/api/generate",
    json={"model": "llama3.1", "prompt": "Explain quantum entanglement in two sentences.", "stream": False},
).json()["response"]

kokoro = Kokoro("kokoro-v1.0.onnx", "voices-v1.0.bin")
samples, sample_rate = kokoro.create(reply, voice="af_heart")
sf.write("response.wav", samples, sample_rate)
Welche TTS-Engine passt am besten zu Ollama?
Piper passt für die meisten Ollama-Kombinationen am besten, weil es die geringste Ressourcenkonkurrenz neben einem bereits CPU- oder GPU-Speicher nutzenden LLM verursacht. Die Tabelle unten bewertet jeden Kandidaten speziell danach, wie gut er sich einen Rechner mit Ollama teilt — Ressourcenverbrauch, Latenz, wie viel Code die Anbindung erfordert, und Lizenz — nicht allein nach roher Audioqualität.
Piper
- Lizenz:
- GPL-3.0-or-later
- Ressourcenverbrauch:
- Reines CPU, sehr gering
- Latenz:
- Echtzeit, sogar auf einem Raspberry Pi
- Anbindungsaufwand:
- Einzelner CLI-Aufruf, Text über stdin
Kokoro
- Lizenz:
- Apache-2.0
- Ressourcenverbrauch:
- CPU-fähig, gering (82M Parameter)
- Latenz:
- Schnell; keine öffentliche Echtzeit-Angabe vs. GPU-Engines
- Anbindungsaufwand:
- Python-API (kokoro-onnx), wenige Zeilen
XTTS v2
- Lizenz:
- CPML (nicht-kommerziell)
- Ressourcenverbrauch:
- Hoch; GPU empfohlen
- Latenz:
- Unter 200ms Streaming, auf GPU, laut Coqui-Dokumentation
- Anbindungsaufwand:
- Python-API, mehr Einrichtung (Lizenzabfrage)
Coqui-TTS-Toolkit
- Lizenz:
- MPL-2.0 (nur Toolkit)
- Ressourcenverbrauch:
- Variiert je geladenem Modell
- Latenz:
- Variiert je geladenem Modell
- Anbindungsaufwand:
- Eine Python-API für mehrere Modelle
Bark
- Lizenz:
- MIT
- Ressourcenverbrauch:
- Hoch; GPU empfohlen, langsam auf CPU
- Latenz:
- Nicht für Echtzeit-Streaming konzipiert
- Anbindungsaufwand:
- Python-API, einfach, aber langsamer
Chatterbox
- Lizenz:
- MIT
- Ressourcenverbrauch:
- Moderat; GPU für Echtzeit empfohlen
- Latenz:
- Keine öffentliche Echtzeit-Angabe bestätigt
- Anbindungsaufwand:
- Python-API (chatterbox-tts pip-Paket)
Welche TTS-Engine verbraucht neben Ollama die wenigsten Ressourcen?
Piper. Es ist reines CPU, läuft in Echtzeit sogar auf einem Raspberry Pi und muss sich keinen GPU-Speicher mit einem Ollama-Modell teilen — die ressourcenschonendste Option in diesem Vergleich.
Wer sollte welche Engine nutzen?
Wählen Sie die Engine passend zu Ihrer Hardware und Ihren Stimmanforderungen, nicht nach der höchsten rohen Audioqualität allein.
- 🏆 Beste Gesamtwahl für eine Ollama-Kombination: Piper — geringste Ressourcenkosten, Echtzeit auf CPU, am einfachsten in ein Shell-Skript oder einen Python-Subprocess-Aufruf einzubinden.
- Beste Wahl für höhere Audioqualität bei ähnlichem Fußabdruck: Kokoro — noch klein genug, um ohne GPU zu laufen, mit laut eigenen Release-Benchmarks merklich besserer wahrgenommener Sprachqualität als Piper.
- Beste Wahl für Voice-Cloning mit erlaubter kommerzieller Nutzung: Chatterbox — MIT-lizenziert, klont eine Stimme aus etwa 5 Sekunden Referenzaudio, benötigt eine GPU neben Ollama für Echtzeitnutzung.
- Beste Wahl für Voice-Cloning bei nicht-kommerzieller Nutzung oder Forschung: XTTS v2 — klont eine Stimme aus 6 Sekunden Audio über 17 Sprachen hinweg, doch die CPML-Lizenz blockiert kommerzielle Nutzung ohne separate Vereinbarung — siehe PromptQuorums XTTS-v2-Lizenzübersicht.
- Beste Wahl für ausdrucksstarkes, nicht-sprachliches Audio, nicht als primäre Stimme: Bark — Lachen, Seufzer und einfache Umgebungsgeräusche allein aus Textprompts, doch sein Repository hat seit dem 5. April 2024 keine Commits mehr erhalten, verlassen Sie sich also nicht auf es für eine gepflegte Produktionspipeline.
- 🧭 Raspberry Pi oder andere reine CPU-Hardware, auf der Ollama mit einem kleinen Modell läuft → Piper. Nichts anderes in diesem Leitfaden ist bestätigt echtzeitfähig ohne GPU.
- 🧭 Desktop oder Server mit freier GPU neben Ollama, gewünschte geklonte Stimme und kommerzielle Rechte nötig → Chatterbox.
- 🧭 Desktop oder Server mit freier GPU, Forschungs- oder privates Projekt, höchste Klon-Qualität gewünscht → XTTS v2.
- 🧭 Wunsch nach einem einzigen Toolkit, das im Zeitverlauf mehrere verschiedene Modelle laden kann (einschließlich XTTS v2) → Coqui-TTS-Toolkit statt die Abhängigkeiten jedes Modells separat zu installieren.
Wann keine dieser Engines nutzen
Lokales TTS in Kombination mit Ollama ist nicht für jeden Sprachausgabebedarf der richtige Ansatz — manche Situationen erfordern eine Cloud-API oder ein völlig anderes Werkzeug.
- ❌ Wenn Sie Dutzende hochwertig ausgearbeitete, emotional ausdrucksstarke Stimmen von der Stange benötigen — eine verwaltete Cloud-API wie ElevenLabs bietet eine größere kuratierte Stimmenbibliothek und ausdrucksstärkere Steuerungen als jedes hier genannte Modell; siehe PromptQuorums ElevenLabs-vs.-lokale-TTS-Vergleich für die Abwägungen.
- ❌ Wenn Ihre Hardware über das von Ollama bereits genutzte RAM oder VRAM hinaus keinen Spielraum hat — Ollama und eine GPU-hungrige TTS-Engine wie XTTS v2 oder Bark auf derselben bescheidenen GPU laufen zu lassen, kann beide ausbremsen; weichen Sie auf Piper oder Kokoro aus, oder verlagern Sie TTS auf eine zweite Maschine.
- ❌ Wenn Sie ein kommerzielles Produkt ausliefern müssen und die Lizenz nicht unabhängig bestätigt haben — die CPML von XTTS v2 ist ausdrücklich nicht-kommerziell, und Coqui AI, das dahinterstehende Unternehmen, stellte seine kostenpflichtigen Lizenzierungsdienste im Dezember 2023 ein; bestätigen Sie die Lizenzbedingungen selbst, bevor Sie eine dieser Engines in einem bezahlten Produkt ausliefern.
- ❌ Wenn Sie die Stimme einer echten Person ohne deren Zustimmung klonen — dies wirft Fragen zu Einwilligung und Identitätsdiebstahl auf, unabhängig von der Lizenz einer Engine, sowohl bei privater als auch bei kommerzieller Nutzung.
Häufig gestellte Fragen
Hat Ollama eine eingebaute Text-zu-Sprache-Funktion?
Nein. Ollama erzeugt nur Text und hat keine native Audioausgabe. Eine GitHub-Funktionsanfrage für natives TTS (Issue #11021) ist zum Zeitpunkt der Erstellung ungelöst. Sprachausgabe erfordert das Weiterleiten der Textantwort von Ollama an eine separate lokale TTS-Engine.
Was ist die beste TTS-Engine für Ollama?
Piper, für die meisten Setups — reines CPU, GPL-3.0-or-later-lizenziert und läuft in Echtzeit sogar auf einem Raspberry Pi, konkurriert also nicht mit Ollama um GPU-Speicher. Wählen Sie Kokoro für höhere wahrgenommene Audioqualität bei ähnlichem Ressourcenbedarf oder XTTS v2 / Chatterbox, wenn Sie speziell Voice-Cloning benötigen.
Wie leite ich die Ausgabe von Ollama an eine TTS-Engine weiter?
Senden Sie eine POST-Anfrage an die REST-API von Ollama unter http://localhost:11434/api/generate mit "stream": false, extrahieren Sie das Feld response aus der zurückgegebenen JSON-Antwort und übergeben Sie diesen Text an die CLI Ihrer gewählten TTS-Engine (Piper akzeptiert Text über stdin) oder deren Python-API (Kokoro, XTTS v2, Chatterbox, Bark und das Coqui-TTS-Toolkit stellen alle eine bereit). Funktionierende Befehle finden Sie im Pipeline-Leitfaden oben.
Brauche ich eine GPU, um eine TTS-Engine neben Ollama auszuführen?
Nicht zwingend. Piper und Kokoro sind beide CPU-fähig und benötigen keine GPU. XTTS v2, Bark und Chatterbox profitieren von einer GPU oder benötigen sie für Echtzeitleistung, was bedeutet, dass sie auf einem Rechner mit nur einer GPU mit Ollama um GPU-Speicher konkurrieren.
Kann ich XTTS v2 kommerziell in einem Ollama-basierten Produkt nutzen?
Nicht ohne separate Vereinbarung. XTTS v2 steht unter der Coqui Public Model License (CPML), die nicht-kommerziell ist. Coqui AI, das Unternehmen, das es veröffentlichte, stellte seine kostenpflichtigen Dienste im Dezember 2023 ein, und PromptQuorum konnte nicht bestätigen, dass heute ein aktiver kommerzieller Lizenzweg existiert. Siehe die vollständige XTTS-v2-Lizenzübersicht, bevor Sie ein bezahltes Produkt ausliefern.
Welche TTS-Engine sollte ich für einen Raspberry-Pi-Sprachassistenten mit Ollama verwenden?
Piper. Es ist die einzige Engine in diesem Vergleich, die bestätigt in Echtzeit auf reiner CPU-Hardware wie einem Raspberry Pi läuft — genau die Einschränkung, die ein Pi auferlegt, wenn er zusätzlich Ollama ausführt oder mit ihm kommuniziert.
Gibt es eine offizielle Integration zwischen Ollama und einer TTS-Engine?
Nein. Es gibt kein offizielles Plugin, keinen Callback und keine eingebaute Brücke, die Ollama mit einer TTS-Engine verbindet. Jede in diesem Leitfaden beschriebene Kombination ist Verbindungscode, den Sie selbst schreiben — typischerweise unter 20 Zeilen, die die REST-API von Ollama und anschließend die eigene CLI oder Python-API einer TTS-Engine aufrufen.
Was ist der Unterschied zwischen Kokoro und Piper für eine Ollama-Pipeline?
Beide sind CPU-fähig und kostenlos kommerziell nutzbar (Kokoro unter Apache-2.0, Piper unter GPL-3.0-or-later). Kokoro ist ein größeres Modell (82 Millionen Parameter), das laut eigenen Release-Benchmarks merklich höhere wahrgenommene Sprachqualität liefert, während Piper leichter ist und eine längere Erfolgsbilanz beim Echtzeitbetrieb auf sehr bescheidener Hardware wie einem Raspberry Pi hat.
Kann ich meine eigene Stimme klonen, um die Ausgabe von Ollama vorzulesen?
Ja, mit XTTS v2 (6 Sekunden Referenzaudio, nicht-kommerzielle CPML-Lizenz) oder Chatterbox (etwa 5 Sekunden Referenzaudio, MIT-Lizenz, kommerzielle Nutzung erlaubt). Weder Piper noch Kokoro unterstützt Voice-Cloning — beide nutzen feste, vortrainierte Stimmen.
Fazit
Das Fehlen nativer Text-zu-Sprache-Funktion bei Ollama ist keine Lücke, die man mit einem Plugin umgeht — es ist eine Designentscheidung, die Ollama auf Sprachmodell-Inferenz beschränkt, und jede darauf aufgebaute Sprachpipeline bindet eine separate Engine an. Für die meisten Leser sollte diese Engine Piper sein: Es kostet fast keine Ressourcen neben einem bereits laufenden LLM, lässt sich mit einer Zeile in ein Shell-Skript oder einen Python-Subprocess einbinden und läuft in Echtzeit auf Hardware so bescheiden wie einem Raspberry Pi. Reicht die Audioqualität von Piper nicht aus, ist Kokoro die nächste Stufe bei ähnlichem Ressourcenbedarf. Greifen Sie nur dann zu XTTS v2 oder Chatterbox, wenn Voice-Cloning eine echte Anforderung ist, planen Sie dafür eine GPU ein, und bestätigen Sie — speziell bei XTTS v2 — dass die nicht-kommerzielle CPML-Lizenz zu Ihrem Anwendungsfall passt, bevor Sie darauf aufbauen. Im Zweifel installieren Sie zuerst Piper: Es ist der schnellste Weg, ein Ollama-Modell sprechen zu hören, und der spätere Wechsel zu einer schwereren Engine ist eine kleinere Änderung, als gleich damit zu beginnen.
Quellen
- Ollama GitHub-Issue #11021 — die Funktionsanfrage für natives TTS, als Duplikat einer früheren, weiterhin offenen Anfrage geschlossen.
- Ollama-REST-API-Dokumentation — der in den Pipeline-Beispielen dieses Leitfadens verwendete Endpunkt
/api/generate. - maudoin/ollama-voice auf GitHub — ein Community-Projekt, das Whisper, Ollama und pyttsx3 verbindet; 378 Sterne zum Zeitpunkt der Erstellung.
- Kokoro-82M-Modellkarte auf Hugging Face — Parameteranzahl, Lizenz und Architektur.
- XTTS v2 auf Hugging Face — Cloning-Anforderungen und Lizenzverweis.
- Chatterbox auf GitHub — Resemble AIs Open-Source-Voice-Cloning-Modell, Lizenz und Nutzungsbeispiele.
- Bark auf GitHub — Sunos generatives Audiomodell, Lizenz und Commit-Historie.