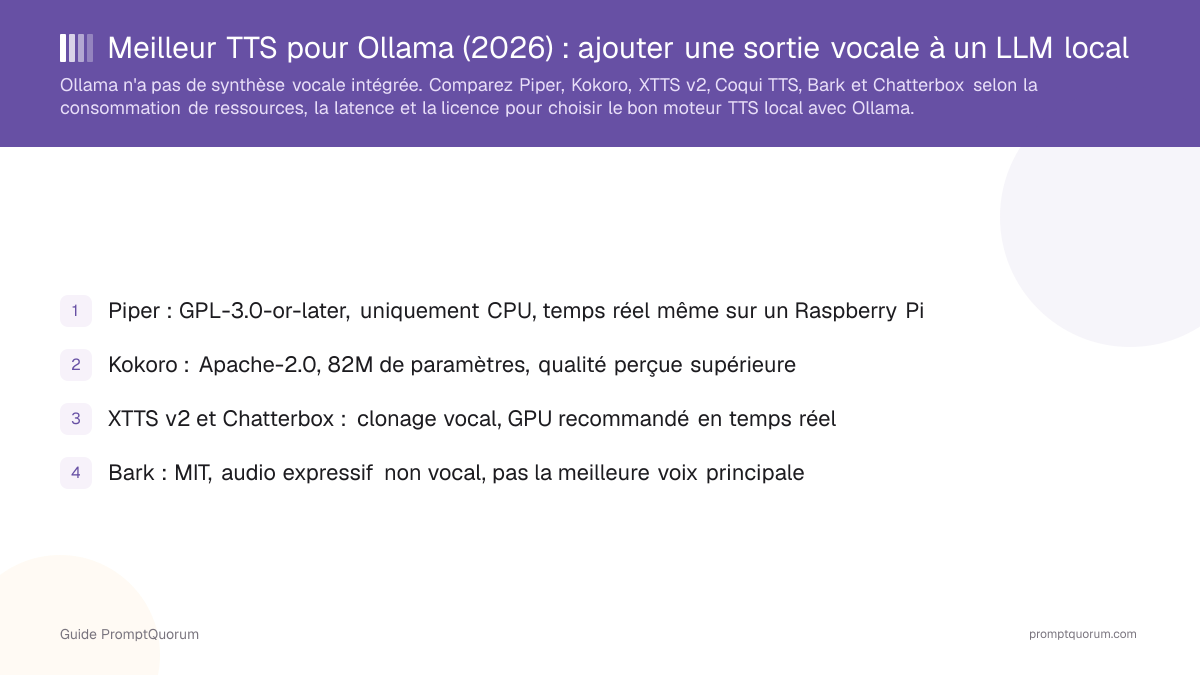
Points clés
- Ollama génère uniquement du texte ; une demande de TTS natif (issue GitHub #11021) reste non résolue à l'heure où ces lignes sont écrites.
- Piper est l'association la moins coûteuse en ressources : uniquement CPU, temps réel même sur un Raspberry Pi, licence GPL-3.0-or-later.
- Kokoro (82M de paramètres, Apache-2.0) échange un peu de vitesse contre une qualité vocale perçue nettement meilleure.
- XTTS v2 et Chatterbox clonent tous deux une voix à partir d'un court extrait de référence, mais la licence de XTTS v2 est non commerciale alors que Chatterbox est sous licence MIT.
- Bark ajoute des rires, soupirs et autres sons non vocaux, mais son dépôt GitHub n'a reçu aucun commit depuis le 5 avril 2024.
- Le pipeline suit toujours la même logique : l'API REST d'Ollama renvoie du texte JSON, votre code l'extrait, et ce texte est transmis à la CLI ou à l'API Python du moteur TTS.
📍 En une phrase
Ollama n'a pas de synthèse vocale intégrée : ajouter une sortie vocale signifie transmettre sa réponse texte à un moteur TTS local distinct — Piper pour le coût en ressources le plus bas, Kokoro pour une qualité supérieure à empreinte similaire, XTTS v2 ou Chatterbox pour le clonage vocal, et Bark uniquement pour de l'audio expressif non vocal.
💬 En termes simples
Ollama est la partie qui réfléchit et rédige la réponse ; un moteur TTS est un programme distinct qui transforme cette réponse écrite en audio parlé. Vous connectez les deux vous-même avec quelques lignes de code — il n'existe pas de bouton unique qui fait les deux.
📌Remarque: Cet article couvre uniquement le volet TTS d'un pipeline vocal. Pour une configuration complète ajoutant aussi la reconnaissance vocale (Whisper) côté entrée, consultez le guide de l'assistant vocal local de PromptQuorum.
Ollama dispose-t-il d'une synthèse vocale intégrée ?
Non — Ollama n'a pas de synthèse vocale ni de sortie audio intégrée. Ollama est un environnement d'exécution local pour grands modèles de langage : il charge un modèle, l'expose via une API REST locale et une CLI, et renvoie du texte. Il ne synthétise pas la parole et ne fournit aucun modèle TTS.
Une issue GitHub demandant un support TTS natif, #11021, proposait de charger directement des modèles de génération audio et d'ajouter un point de terminaison compatible OpenAI POST /v1/audio/speech. Elle a été fermée comme doublon d'une demande antérieure toujours ouverte (issue #5424) — à l'heure où ces lignes sont écrites, Ollama n'a pas livré de TTS natif, et aucun calendrier n'est engagé.
C'est pourquoi toute configuration vocale locale bâtie sur Ollama — assistant vocal, narrateur de livre audio pour la sortie d'un LLM, ou outil de lecture à voix haute pour l'accessibilité — associe Ollama à un moteur TTS distinct plutôt que de s'appuyer sur un quelconque « mode TTS Ollama ». Des projets communautaires de liaison existent déjà : maudoin/ollama-voice, avec 378 étoiles GitHub au moment de la rédaction, enchaîne Whisper pour la transcription, Ollama pour la réponse, et pyttsx3 — un enrobage des voix intégrées de votre système d'exploitation, pas un modèle TTS neuronal — pour la sortie. Ce projet illustre le schéma ; il ne constitue pas une recommandation pour la qualité audio de pyttsx3, qui reste en retrait sur chaque moteur neuronal comparé dans ce guide.
Existe-t-il une fonctionnalité de synthèse vocale officielle pour Ollama ?
Non. Ollama ne génère que du texte. Une demande de fonctionnalité communautaire visant à ajouter un support TTS natif (issue GitHub #11021) reste non résolue à l'heure où ces lignes sont écrites, fermée comme doublon d'une demande antérieure toujours ouverte. La sortie vocale nécessite de transmettre la réponse texte d'Ollama à un moteur TTS distinct.
Transmettre la sortie d'Ollama à un moteur TTS local
Chaque pipeline Ollama-plus-TTS suit les quatre mêmes étapes : demander du texte à Ollama, extraire ce texte de la réponse JSON, le transmettre à un moteur TTS, puis lire ou enregistrer l'audio obtenu. Il n'existe aucune intégration officielle entre Ollama et un moteur TTS — c'est du code de liaison que vous écrivez vous-même, généralement moins de 20 lignes.
- L'API d'Ollama ne sait pas, et ne se soucie pas, de ce qu'il advient de sa sortie texte. Il n'existe ni callback, ni webhook, ni système de plugin reliant Ollama à un moteur TTS — votre code est la seule chose qui les relie.
- Le mode streaming (
"stream": true) réduit la latence perçue en renvoyant les tokens au fur et à mesure de leur génération, ce qui permet de commencer à synthétiser l'audio de la première phrase avant que le modèle n'ait terminé sa réponse complète — utile pour les assistants vocaux interactifs, plus complexe à mettre en œuvre que l'exemple sans streaming ci-dessus.
- 1Démarrer Ollama et charger un modèle
Why it matters: Ollama doit déjà être en cours d'exécution (`ollama serve`, ou l'application de bureau) avec au moins un modèle chargé (`ollama pull llama3.1`) avant de pouvoir répondre aux requêtes via son API REST. - 2Envoyer un prompt à l'API REST d'Ollama
Why it matters: Une requête POST vers `http://localhost:11434/api/generate` avec `"stream": false` renvoie un seul objet JSON contenant la réponse complète dans son champ `response` — le plus simple à analyser pour un pipeline TTS, même si le mode streaming est disponible pour réduire le délai avant le premier audio. - 3Extraire le texte et le transmettre à votre moteur TTS
Why it matters: La chaîne `response` est du texte brut — transmettez-la directement à la CLI d'un moteur TTS via stdin (Piper) ou à son API Python (Kokoro, XTTS v2, Chatterbox, Bark ou le toolkit Coqui TTS). - 4Lire ou enregistrer l'audio obtenu
Why it matters: La plupart des CLI et API TTS écrivent directement un fichier `.wav` ; pour une lecture en direct, transmettez l'audio brut à un lecteur comme `aplay` (Linux) ou utilisez une bibliothèque audio Python.
# 1. Demander une réponse texte à Ollama (sans streaming, pour la simplicité)
RESPONSE=$(curl -s http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Explain quantum entanglement in two sentences.",
  "stream": false
}' | python3 -c "import sys, json; print(json.load(sys.stdin)['response'])")

# 2. Transmettre ce texte à la CLI de Piper pour synthétiser l'audio (option la moins coûteuse en ressources)
echo "$RESPONSE" | piper --model en_US-lessac-medium --output_file response.wav

# --- Version Python équivalente, avec Kokoro à la place de Piper ---
import json
import requests
import soundfile as sf
from kokoro_onnx import Kokoro

reply = requests.post(
    "http://localhost:11434/api/generate",
    json={"model": "llama3.1", "prompt": "Explain quantum entanglement in two sentences.", "stream": False},
).json()["response"]

kokoro = Kokoro("kokoro-v1.0.onnx", "voices-v1.0.bin")
samples, sample_rate = kokoro.create(reply, voice="af_heart")
sf.write("response.wav", samples, sample_rate)
Quel moteur TTS s'associe le mieux à Ollama ?
Piper est le meilleur choix pour la plupart des associations avec Ollama car il ajoute le moins de concurrence en ressources aux côtés d'un LLM déjà consommateur de CPU ou de mémoire GPU. Le tableau ci-dessous note chaque candidat spécifiquement sur sa capacité à partager une machine avec Ollama — consommation de ressources, latence, quantité de code nécessaire pour l'intégrer, et licence — pas uniquement sur la qualité audio brute.
Piper
- Licence:
- GPL-3.0-or-later
- Ressources:
- Uniquement CPU, très légère
- Latence:
- Temps réel, même sur un Raspberry Pi
- Facilité d'intégration:
- Un seul appel CLI, texte via stdin
Kokoro
- Licence:
- Apache-2.0
- Ressources:
- Compatible CPU, légère (82M paramètres)
- Latence:
- Rapide ; pas de spec temps réel publique vs GPU
- Facilité d'intégration:
- API Python (kokoro-onnx), quelques lignes
XTTS v2
- Licence:
- CPML (non commerciale)
- Ressources:
- Élevées ; GPU recommandé
- Latence:
- Streaming sous 200ms, sur GPU, selon Coqui
- Facilité d'intégration:
- API Python, plus de configuration (licence)
Toolkit Coqui TTS
- Licence:
- MPL-2.0 (toolkit seul)
- Ressources:
- Variable selon le modèle chargé
- Latence:
- Variable selon le modèle chargé
- Facilité d'intégration:
- Une API Python pour plusieurs modèles
Bark
- Licence:
- MIT
- Ressources:
- Élevées ; GPU recommandé, lent sur CPU
- Latence:
- Non conçu pour le streaming temps réel
- Facilité d'intégration:
- API Python, simple mais plus lente
Chatterbox
- Licence:
- MIT
- Ressources:
- Modérées ; GPU recommandé en temps réel
- Latence:
- Aucune spec temps réel publique confirmée
- Facilité d'intégration:
- API Python (paquet pip chatterbox-tts)
Quel moteur TTS consomme le moins de ressources aux côtés d'Ollama ?
Piper. Il est uniquement CPU, fonctionne en temps réel même sur un Raspberry Pi, et n'a pas besoin de partager la mémoire GPU avec un modèle Ollama — l'option la moins coûteuse en ressources de ce comparatif.
Qui devrait utiliser quel moteur ?
Associez le moteur à votre matériel et à vos besoins vocaux, pas à celui qui affiche la meilleure qualité audio brute isolément.
- 🏆 Meilleur choix global pour une association avec Ollama : Piper — coût en ressources le plus bas, temps réel sur CPU, le plus simple à intégrer dans un script shell ou un appel Python subprocess.
- Meilleur choix pour une qualité audio supérieure à empreinte similaire : Kokoro — encore assez compact pour fonctionner sans GPU, avec une qualité vocale perçue nettement meilleure que Piper selon ses propres benchmarks de sortie.
- Meilleur choix pour le clonage vocal avec usage commercial autorisé : Chatterbox — sous licence MIT, clone une voix à partir d'environ 5 secondes d'audio de référence, nécessite un GPU aux côtés d'Ollama pour un usage en temps réel.
- Meilleur choix pour le clonage vocal non commercial ou pour la recherche : XTTS v2 — clone une voix à partir de 6 secondes d'audio dans 17 langues, mais sa licence CPML bloque l'usage commercial sans accord séparé — voir l'analyse de la licence XTTS v2 de PromptQuorum.
- Meilleur choix pour l'audio expressif non vocal, pas comme voix principale : Bark — rires, soupirs et sons d'ambiance simples à partir de simples prompts texte, mais son dépôt n'a reçu aucun commit depuis le 5 avril 2024 ; ne comptez pas dessus pour un pipeline de production maintenu.
- 🧭 Raspberry Pi ou autre matériel uniquement CPU, exécutant Ollama avec un petit modèle → Piper. Aucun autre moteur de ce guide n'est confirmé en temps réel sans GPU.
- 🧭 Ordinateur de bureau ou serveur avec un GPU disponible aux côtés d'Ollama, voix clonée souhaitée, et droits commerciaux nécessaires → Chatterbox.
- 🧭 Ordinateur de bureau ou serveur avec un GPU disponible, projet de recherche ou personnel, qualité de clonage maximale souhaitée → XTTS v2.
- 🧭 Envie d'un seul toolkit capable de charger plusieurs modèles différents au fil du temps (y compris XTTS v2) → toolkit Coqui TTS plutôt que d'installer les dépendances de chaque modèle séparément.
Quand ne pas utiliser ces moteurs
Le TTS local associé à Ollama n'est pas la bonne approche pour tous les besoins de sortie vocale — certaines situations appellent une API cloud ou un outil totalement différent.
- ❌ Si vous avez besoin de dizaines de voix très abouties et émotionnellement expressives prêtes à l'emploi — une API cloud gérée comme ElevenLabs propose une bibliothèque de voix curée plus large et des contrôles plus expressifs que tous les modèles présentés ici ; voir le comparatif ElevenLabs vs TTS local de PromptQuorum pour les compromis.
- ❌ Si votre matériel ne peut pas libérer de RAM ou de VRAM au-delà de ce qu'Ollama utilise déjà — exécuter Ollama et un moteur TTS gourmand en GPU comme XTTS v2 ou Bark sur le même GPU modeste peut affamer les deux ; passez à Piper ou Kokoro, ou déplacez le TTS sur une seconde machine.
- ❌ Si vous devez livrer un produit commercial et n'avez pas confirmé la licence de manière indépendante — la licence CPML de XTTS v2 est explicitement non commerciale, et Coqui AI, l'entreprise à l'origine du modèle, a cessé ses services de licence payants en décembre 2023 ; vérifiez vous-même les conditions de licence avant de livrer l'un de ces moteurs dans un produit payant.
- ❌ Si vous clonez la voix d'une personne réelle sans son consentement — cela soulève des questions de consentement et d'usurpation d'identité indépendantes de la licence de tout moteur, en usage personnel comme commercial.
Questions fréquemment posées
Ollama dispose-t-il d'une synthèse vocale intégrée ?
Non. Ollama ne génère que du texte et n'a pas de sortie audio native. Une demande de fonctionnalité GitHub pour un TTS natif (issue #11021) reste non résolue à l'heure où ces lignes sont écrites. La sortie vocale nécessite de transmettre la réponse texte d'Ollama à un moteur TTS local distinct.
Quel est le meilleur moteur TTS à associer à Ollama ?
Piper, pour la plupart des configurations — uniquement CPU, sous licence GPL-3.0-or-later, et fonctionne en temps réel même sur un Raspberry Pi, il ne concurrence donc pas Ollama pour la mémoire GPU. Choisissez Kokoro pour une qualité audio perçue supérieure à empreinte de ressources similaire, ou XTTS v2 / Chatterbox si vous avez spécifiquement besoin de clonage vocal.
Comment transmettre la sortie d'Ollama à un moteur TTS ?
Envoyez une requête POST à l'API REST d'Ollama à l'adresse http://localhost:11434/api/generate avec "stream": false, extrayez le champ response de la réponse JSON obtenue, et transmettez ce texte à la CLI de votre moteur TTS choisi (Piper accepte le texte via stdin) ou à son API Python (Kokoro, XTTS v2, Chatterbox, Bark et le toolkit Coqui TTS en exposent tous une). Voir le guide du pipeline ci-dessus pour des commandes fonctionnelles.
Ai-je besoin d'un GPU pour exécuter un moteur TTS aux côtés d'Ollama ?
Pas nécessairement. Piper et Kokoro sont tous deux compatibles CPU et ne nécessitent pas de GPU. XTTS v2, Bark et Chatterbox bénéficient tous d'un GPU ou en ont besoin pour des performances en temps réel, ce qui signifie qu'ils concurrencent Ollama pour la mémoire GPU sur une machine à GPU unique.
Puis-je utiliser XTTS v2 commercialement dans un produit basé sur Ollama ?
Pas sans accord séparé. XTTS v2 est sous licence Coqui Public Model License (CPML), qui est non commerciale. Coqui AI, l'entreprise qui l'a publié, a cessé ses services payants en décembre 2023, et PromptQuorum n'a pas pu confirmer qu'une voie de licence commerciale active existe aujourd'hui. Consultez l'analyse complète de la licence XTTS v2 avant de livrer un produit payant.
Quel moteur TTS utiliser pour un assistant vocal Raspberry Pi exécutant Ollama ?
Piper. C'est le seul moteur de ce comparatif confirmé fonctionner en temps réel sur du matériel uniquement CPU comme un Raspberry Pi, exactement la contrainte qu'impose un Pi lorsqu'il exécute aussi Ollama ou communique avec lui.
Existe-t-il une intégration officielle entre Ollama et un moteur TTS ?
Non. Il n'existe aucun plugin officiel, callback ou pont intégré reliant Ollama à un moteur TTS. Chaque association décrite dans ce guide est du code de liaison que vous écrivez vous-même — généralement moins de 20 lignes appelant l'API REST d'Ollama puis la CLI ou l'API Python propre au moteur TTS.
Quelle est la différence entre Kokoro et Piper pour un pipeline Ollama ?
Les deux sont compatibles CPU et libres d'usage commercial (Kokoro sous licence Apache-2.0, Piper sous licence GPL-3.0-or-later). Kokoro est un modèle plus grand (82 millions de paramètres) qui offre une qualité vocale perçue nettement supérieure selon ses propres benchmarks de sortie, tandis que Piper est plus léger et dispose d'un historique plus long de fonctionnement en temps réel sur du matériel très modeste comme un Raspberry Pi.
Puis-je cloner ma propre voix pour narrer la sortie d'Ollama ?
Oui, avec XTTS v2 (6 secondes d'audio de référence, licence CPML non commerciale) ou Chatterbox (environ 5 secondes d'audio de référence, licence MIT, usage commercial autorisé). Ni Piper ni Kokoro ne prennent en charge le clonage vocal — les deux utilisent des voix fixes, préentraînées.
Verdict
L'absence de synthèse vocale native chez Ollama n'est pas une lacune à contourner avec un plugin — c'est un choix de conception qui recentre Ollama sur l'inférence de modèle de langage, et chaque pipeline vocal bâti dessus y associe un moteur distinct. Pour la plupart des lecteurs, ce moteur devrait être Piper : il coûte presque rien en ressources aux côtés d'un LLM déjà en cours d'exécution, s'intègre en une ligne dans un script shell ou un subprocess Python, et fonctionne en temps réel sur du matériel aussi modeste qu'un Raspberry Pi. Si la qualité audio de Piper ne suffit pas, Kokoro constitue l'étape suivante à empreinte de ressources similaire. Réservez XTTS v2 ou Chatterbox aux cas où le clonage vocal est un besoin réel, budgétez un GPU pour cela, et — pour XTTS v2 en particulier — confirmez que la licence CPML non commerciale correspond à votre usage avant de construire dessus. En cas de doute, installez d'abord Piper : c'est le moyen le plus rapide d'entendre un modèle Ollama parler, et passer plus tard à un moteur plus lourd est un changement plus simple que de commencer par lui.
Sources
- Issue GitHub #11021 d'Ollama — la demande de fonctionnalité pour un support TTS natif, fermée comme doublon d'une issue antérieure toujours ouverte.
- Documentation de l'API REST d'Ollama — le point de terminaison
/api/generateutilisé dans les exemples de pipeline de ce guide. - maudoin/ollama-voice sur GitHub — un projet communautaire enchaînant Whisper, Ollama et pyttsx3 ; 378 étoiles au moment de la rédaction.
- Fiche modèle Kokoro-82M sur Hugging Face — nombre de paramètres, licence et architecture.
- XTTS v2 sur Hugging Face — exigences de clonage et référence de licence.
- Chatterbox sur GitHub — le modèle open source de clonage vocal de Resemble AI, sa licence et des exemples d'usage.
- Bark sur GitHub — le modèle audio génératif de Suno, sa licence et son historique de commits.