重要なポイント
- Ollamaはテキストしか生成せず、ネイティブTTSの要望(GitHub issue #11021)は本記事執筆時点で未解決です。
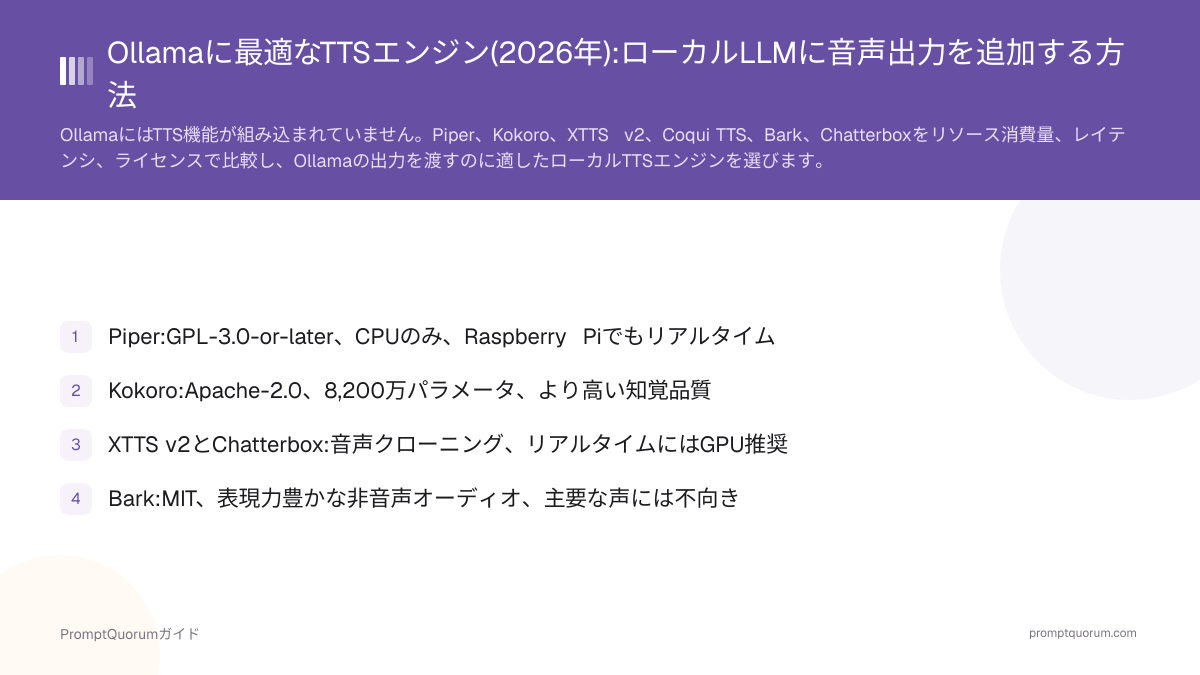
- Piperはリソースコストが最も低い組み合わせです。CPUのみ、Raspberry Piでもリアルタイム、GPL-3.0-or-laterライセンスです。
- Kokoro(8,200万パラメータ、Apache-2.0)は多少の速度と引き換えに明らかに知覚音質が向上します。
- XTTS v2とChatterboxはどちらも短い参照クリップから声をクローンしますが、XTTS v2のライセンスは非商用で、Chatterboxは MITライセンスです。
- Barkは笑い声やため息などの非音声オーディオを追加できますが、GitHubリポジトリは2024年4月5日以降コミットがありません。
- パイプラインの構造はどのケースでも同じです。OllamaのREST APIがJSON形式のテキストを返し、コード側で抽出し、そのテキストをTTSエンジンのCLIまたはPython APIに渡します。
📍 一文で説明
Ollamaにはテキスト読み上げ機能が組み込まれていないため、音声出力を追加するにはテキスト応答を別のローカルTTSエンジンに渡す必要があります—リソースコストが最も低いPiper、同程度の規模で音質が高いKokoro、音声クローニング向けのXTTS v2やChatterbox、表現力豊かな非音声オーディオのみのBarkです。
💬 簡潔に説明
Ollamaは考えて応答を書く部分で、TTSエンジンはその書かれた応答を発話音声に変換する別のプログラムです。両者は自分で数行のコードをつないで接続する必要があり、両方をこなす単一のボタンは存在しません。
📌補足: 本記事は音声パイプラインのTTS側のみを扱います。入力側の音声認識(Whisper)も加えた完全な構築については、PromptQuorumのローカル音声アシスタントガイドを参照してください。
Ollamaにテキスト読み上げは組み込まれているか?
いいえ—Ollamaにはテキスト読み上げや音声出力の機能は組み込まれていません。 Ollamaは大規模言語モデル向けのローカル実行環境で、モデルを読み込み、ローカルのREST APIとCLIを通じて公開し、テキストを返します。音声を合成せず、TTSモデルも同梱していません。
ネイティブTTS対応を求めるGitHub issue、#11021は、音声生成モデルを直接読み込み、OpenAI互換のPOST /v1/audio/speechエンドポイントを追加することを提案していました。より古い未解決のissue(#5424)への重複としてクローズされました—本記事執筆時点で、Ollamaはネイティブ TTSをリリースしておらず、確定したスケジュールもありません。
そのため、Ollamaを基盤とするあらゆるローカル音声環境—音声アシスタント、LLM出力のオーディオブック読み上げ、アクセシビリティ向けの読み上げツール—は、単一の「Ollama TTSモード」に頼るのではなく、Ollamaを別のTTSエンジンにつなぎます。この用途向けのコミュニティ製連携プロジェクトはすでに存在します。maudoin/ollama-voice(本記事執筆時点で378のGitHubスター)は、文字起こしにWhisper、応答にOllama、出力にpyttsx3(ニューラルTTSモデルではなく、お使いのOSに組み込まれた音声を包むラッパー)を連結しています。このプロジェクトはパターンを示すものであり、pyttsx3の音質そのものを推奨しているわけではありません。本ガイドで比較したどのニューラルエンジンにも音質面で劣ります。
Ollamaの公式なテキスト読み上げ機能はありますか?
いいえ。Ollamaはテキストしか生成しません。ネイティブTTS対応を求めるコミュニティの要望(GitHub issue #11021)は本記事執筆時点で未解決で、より古い未解決の要望への重複としてクローズされています。音声出力にはOllamaのテキスト応答を別のTTSエンジンに渡す必要があります。
Ollamaの出力をローカルTTSエンジンに渡す方法
Ollama+TTSのパイプラインはすべて同じ4つのステップをたどります。Ollamaにテキストを要求し、そのテキストをJSON応答から抽出し、TTSエンジンに渡し、得られた音声を再生または保存します。 OllamaとどのTTSエンジンとの間にも公式な連携はなく、これは自分で書く連携コードであり、通常は20行未満です。
- Ollamaのテキスト出力がその後どう扱われるかについて、OllamaのAPIは関知しません。 OllamaをTTSエンジンに接続するコールバック、Webhook、プラグインの仕組みは存在せず、両者をつなぐのはあなたのコードだけです。
- ストリーミングモード(
"stream": true)は、トークンを生成しながら返すことで知覚レイテンシを下げます。 モデルが応答全体を完了する前に最初の文の音声合成を始められるため、対話型音声アシスタントに有用ですが、上記の非ストリーミング例より実装が複雑になります。
- 1Ollamaを起動しモデルを取得する
Why it matters: REST API経由のリクエストに応答できるようになる前に、Ollamaがすでに稼働している(`ollama serve`、またはデスクトップアプリ)必要があり、少なくとも1つのモデルが取得済み(`ollama pull llama3.1`)である必要があります。 - 2OllamaのREST APIにプロンプトを送信する
Why it matters: `"stream": false`を付けて`http://localhost:11434/api/generate`にPOSTリクエストを送ると、完全な応答を`response`フィールドに含む単一のJSONオブジェクトが返ります。TTSパイプラインで解析するには最も単純ですが、最初の音声までの時間を短縮するストリーミングモードも利用できます。 - 3テキストを抽出しTTSエンジンに渡す
Why it matters: `response`文字列はプレーンテキストです。標準入力経由でTTSエンジンのCLI(Piper)、またはそのPython API(Kokoro、XTTS v2、Chatterbox、Bark、Coqui TTSツールキット)に直接渡します。 - 4得られた音声を再生または保存する
Why it matters: ほとんどのTTSのCLIとAPIは`.wav`ファイルを直接書き出します。ライブ再生には、生の音声を`aplay`(Linux)のようなプレーヤーに渡すか、Pythonのオーディオライブラリを使用します。
# 1. Ollamaにテキスト応答を要求する(簡略化のためストリーミングなし)
RESPONSE=$(curl -s http://localhost:11434/api/generate -d '{
  "model": "llama3.1",
  "prompt": "Explain quantum entanglement in two sentences.",
  "stream": false
}' | python3 -c "import sys, json; print(json.load(sys.stdin)['response'])")

# 2. そのテキストをPiperのCLIに渡して音声を合成する(リソースコストが最も低い選択肢)
echo "$RESPONSE" | piper --model en_US-lessac-medium --output_file response.wav

# --- Pythonでの同等の例、Piperの代わりにKokoroを使用 ---
import json
import requests
import soundfile as sf
from kokoro_onnx import Kokoro

reply = requests.post(
    "http://localhost:11434/api/generate",
    json={"model": "llama3.1", "prompt": "Explain quantum entanglement in two sentences.", "stream": False},
).json()["response"]

kokoro = Kokoro("kokoro-v1.0.onnx", "voices-v1.0.bin")
samples, sample_rate = kokoro.create(reply, voice="af_heart")
sf.write("response.wav", samples, sample_rate)
Ollamaと最も相性の良いTTSエンジンは?
Piperは、すでにCPUまたはGPUメモリを使用しているLLMのそばでリソース競合が最も少ないため、ほとんどのOllama組み合わせに最適です。 下の表は、生の音質だけでなく、リソース消費量、レイテンシ、連携に必要なコード量、ライセンスという、Ollamaとマシンを共有する適性を基準に各候補を評価しています。
Piper
- ライセンス:
- GPL-3.0-or-later
- リソース消費量:
- CPUのみ、非常に軽量
- レイテンシ:
- Raspberry Piでもリアルタイム
- 連携のしやすさ:
- CLI呼び出し1回、標準入力でテキスト
Kokoro
- ライセンス:
- Apache-2.0
- リソース消費量:
- CPU対応、軽量(8,200万パラメータ)
- レイテンシ:
- 高速、GPUエンジンとの公開比較値なし
- 連携のしやすさ:
- Python API(kokoro-onnx)、数行で済む
XTTS v2
- ライセンス:
- CPML(非商用)
- リソース消費量:
- 重い、GPU推奨
- レイテンシ:
- Coqui資料によればGPUで200ms未満のストリーミング
- 連携のしやすさ:
- Python API、設定がやや多い(ライセンス承諾)
Coqui TTSツールキット
- ライセンス:
- MPL-2.0(ツールキットのみ)
- リソース消費量:
- 読み込むモデルによって変動
- レイテンシ:
- 読み込むモデルによって変動
- 連携のしやすさ:
- 複数モデルを1つのPython APIで
Bark
- ライセンス:
- MIT
- リソース消費量:
- 重い、GPU推奨、CPUでは低速
- レイテンシ:
- リアルタイムストリーミング向けではない
- 連携のしやすさ:
- Python API、シンプルだが低速
Chatterbox
- ライセンス:
- MIT
- リソース消費量:
- 中程度、リアルタイムはGPU推奨
- レイテンシ:
- リアルタイムの公開仕様は未確認
- 連携のしやすさ:
- Python API(chatterbox-tts pipパッケージ)
Ollamaと並行して最もリソース消費が少ないTTSエンジンは?
Piperです。CPUのみで動作し、Raspberry Piでもリアルタイムに動き、Ollamaのモデルと GPUメモリを共有する必要がありません—この比較の中でリソースコストが最も低い選択肢です。
誰がどのエンジンを使うべきか
単独での生の音質の高さだけでなく、ハードウェアと音声要件に合わせてエンジンを選びましょう。
- 🏆 Ollama組み合わせの総合最適解:Piper —リソースコストが最も低く、CPUでリアルタイムに動作し、シェルスクリプトやPythonのサブプロセス呼び出しに最も簡単に組み込めます。
- 同程度の規模でより高い音質が欲しい場合の最適解:Kokoro — GPUなしでも動くほど小規模でありながら、自社のリリース時ベンチマークによればPiperより明らかに知覚音質が優れています。
- 商用利用が許可された音声クローニングの最適解:Chatterbox — MITライセンスで、約5秒の参照音声から声をクローンし、リアルタイム利用にはOllamaに加えてGPUが必要です。
- 非商用または研究用途の音声クローニングの最適解:XTTS v2 — 6秒の音声から17言語にわたって声をクローンしますが、CPMLライセンスにより別途契約なしでは商用利用ができません。詳細はPromptQuorumのXTTS v2ライセンス解説を参照してください。
- 主要な声としてではなく、表現力豊かな非音声オーディオの最適解:Bark — テキストプロンプトだけで笑い声やため息、簡単な環境音を生成できますが、リポジトリは2024年4月5日以降コミットがなく、保守されたプロダクションパイプラインに依存すべきではありません。
- 🧭 Raspberry PiなどのCPUのみのハードウェアで、小型モデルのOllamaを動かしている場合 → Piper。本ガイドの他のどのエンジンも、GPUなしでのリアルタイム動作は確認されていません。
- 🧭 Ollamaに加えて空きGPUのあるデスクトップやサーバーで、クローンした声が欲しく、商用権が必要な場合 → Chatterbox。
- 🧭 空きGPUのあるデスクトップやサーバーで、研究または個人プロジェクトであり、最高のクローン品質が欲しい場合 → XTTS v2。
- 🧭 (XTTS v2を含め)複数の異なるモデルを随時読み込める単一のツールキットが欲しい場合 → モデルごとに依存関係を個別にインストールする代わりにCoqui TTSツールキット。
これらを使うべきでない場面
Ollamaと組み合わせるローカルTTSは、あらゆる音声出力ニーズに適した方法ではありません—状況によってはクラウドAPIやまったく別のツールが必要です。
- ❌ すぐに使える、洗練され感情豊かな声を何十種類も必要とする場合 — ElevenLabsのような管理型クラウドAPIは、本ガイドのどのモデルよりも幅広い厳選された音声ライブラリと表現力の高い制御を提供します。トレードオフについてはPromptQuorumのElevenLabsとローカルTTSの比較を参照してください。
- ❌ すでにOllamaが使用している分を超えてRAMやVRAMに余裕がないハードウェアの場合 — XTTS v2やBarkのようなGPUを大量に必要とするTTSエンジンを、控えめなGPU上でOllamaと同時に動かすと両方とも不足しかねません。PiperやKokoroに切り替えるか、TTSを別のマシンに移してください。
- ❌ 商用製品として出荷する必要があり、ライセンスを独自に確認していない場合 — XTTS v2のCPMLは明確に非商用であり、その背後にある企業Coqui AIは2023年12月に有料ライセンスサービスを停止しました。有料製品にこれらのエンジンのいずれかを出荷する前に、自分でライセンス条件を確認してください。
- ❌ 実在する人物の声を本人の同意なくクローンする場合 — これはどのエンジンのライセンスとも独立した同意と成りすましの問題を引き起こし、個人利用・商用利用の双方に当てはまります。
よくある質問
Ollamaにテキスト読み上げは組み込まれていますか?
いいえ。Ollamaはテキストしか生成せず、ネイティブな音声出力はありません。ネイティブTTSを求めるGitHubの機能要望(issue #11021)は本記事執筆時点で未解決です。音声出力にはOllamaのテキスト応答を別のローカルTTSエンジンに渡す必要があります。
Ollamaと組み合わせるのに最適なTTSエンジンは?
ほとんどの環境ではPiperです。CPUのみで動作し、GPL-3.0-or-laterライセンスで、Raspberry Piでもリアルタイムに動くため、OllamaとGPUメモリを奪い合いません。同程度のリソース消費でより高い知覚音質を求めるならKokoro、音声クローニングが特に必要ならXTTS v2かChatterboxを選んでください。
Ollamaの出力をTTSエンジンにどう渡しますか?
"stream": falseを付けてOllamaのREST API(http://localhost:11434/api/generate)にPOSTリクエストを送り、返されたJSONからresponseフィールドを抽出し、そのテキストを選んだTTSエンジンのCLI(Piperは標準入力でテキストを受け付けます)またはPython API(Kokoro、XTTS v2、Chatterbox、Bark、Coqui TTSツールキットはいずれも公開しています)に渡します。動作するコマンドは上のパイプライン解説を参照してください。
Ollamaと並行してTTSエンジンを実行するにはGPUが必要ですか?
必ずしも必要ではありません。PiperとKokoroはどちらもCPU対応でGPUを必要としません。XTTS v2、Bark、Chatterboxはいずれもリアルタイム性能のためにGPUの恩恵を受けるか必要とし、GPUが1枚のマシンではOllamaとGPUメモリを奪い合うことになります。
Ollamaベースの製品でXTTS v2を商用利用できますか?
別途契約なしでは不可能です。XTTS v2はCoqui Public Model License(CPML)の下でライセンスされており、非商用です。これを公開した企業Coqui AIは2023年12月に有料サービスを停止しており、PromptQuorumは現在アクティブな商用ライセンス経路が存在することを確認できませんでした。有料製品を出荷する前に、XTTS v2ライセンス解説の全文を参照してください。
Ollamaを動かすRaspberry Pi音声アシスタントにはどのTTSエンジンを使うべきですか?
Piperです。Raspberry PiのようなCPUのみのハードウェアでリアルタイムに動作することが確認されている、この比較で唯一のエンジンであり、それはPiがOllamaを同時に実行または通信する際にまさに課せられる制約です。
OllamaとTTSエンジンの間に公式な連携はありますか?
いいえ。OllamaをTTSエンジンに接続する公式なプラグイン、コールバック、組み込みブリッジは存在しません。本ガイドで説明した組み合わせはすべて自分で書く連携コードであり、通常はOllamaのREST APIを呼び出し、続けてTTSエンジン独自のCLIまたはPython APIを呼び出す20行未満のコードです。
Ollamaパイプラインにおいて、KokoroとPiperの違いは何ですか?
どちらもCPU対応で商用利用は無料です(Kokoro はApache-2.0ライセンス、PiperはGPL-3.0-or-laterライセンス)。Kokoroはより大きなモデル(8,200万パラメータ)で、自社のリリース時ベンチマークによれば明らかに高い知覚音質を実現する一方、Piperはより軽量で、Raspberry Piのような非常に控えめなハードウェア上でリアルタイムに動作してきた実績がより長いです。
Ollamaの出力を読み上げるために自分の声をクローンできますか?
はい、XTTS v2(6秒の参照音声、非商用のCPMLライセンス)またはChatterbox(約5秒の参照音声、MITライセンス、商用利用可)で可能です。PiperもKokoroも音声クローニングには対応しておらず、どちらも固定の事前学習済みの声を使用します。
総評
Ollamaにネイティブなテキスト読み上げ機能がないのは、プラグインで回避すべき欠落ではありません。Ollamaを言語モデルの推論に特化させる設計判断であり、その上に構築されるあらゆる音声パイプラインは別のエンジンを連結します。ほとんどの読者にとって、そのエンジンはPiperであるべきです。すでに稼働しているLLMのそばでほとんどリソースを消費せず、シェルスクリプトやPythonのサブプロセスに1行で組み込め、Raspberry Piほど控えめなハードウェアでもリアルタイムに動作します。Piperの音質で不十分な場合は、Kokoroが同程度のリソース消費での次のステップです。XTTS v2やChatterboxは、音声クローニングが本当に必要な場合にのみ利用し、そのためのGPU予算を確保し、特にXTTS v2については、構築を始める前に非商用のCPMLライセンスが自分の用途に合っているか確認してください。迷ったら、まずPiperを導入してください。Ollamaのモデルの発話を最も早く聞ける方法であり、後でより重いエンジンに切り替える方が、最初からそれで始めるより小さな変更で済みます。
出典
- Ollama GitHub issue #11021 — ネイティブTTS対応の機能要望。より古い未解決issueへの重複としてクローズ。
- Ollama REST APIドキュメント — 本ガイドのパイプライン例で使用している
/api/generateエンドポイント。 - GitHub上のmaudoin/ollama-voice — Whisper、Ollama、pyttsx3を連結するコミュニティプロジェクト。本記事執筆時点で378スター。
- Hugging Face上のKokoro-82Mモデルカード — パラメータ数、ライセンス、アーキテクチャ。
- Hugging Face上のXTTS v2 — クローニング要件とライセンスの参照先。
- GitHub上のChatterbox — Resemble AIのオープンソース音声クローニングモデル、ライセンス、使用例。
- GitHub上のBark — Sunoの生成オーディオモデル、ライセンス、コミット履歴。