Wichtigste Erkenntnisse
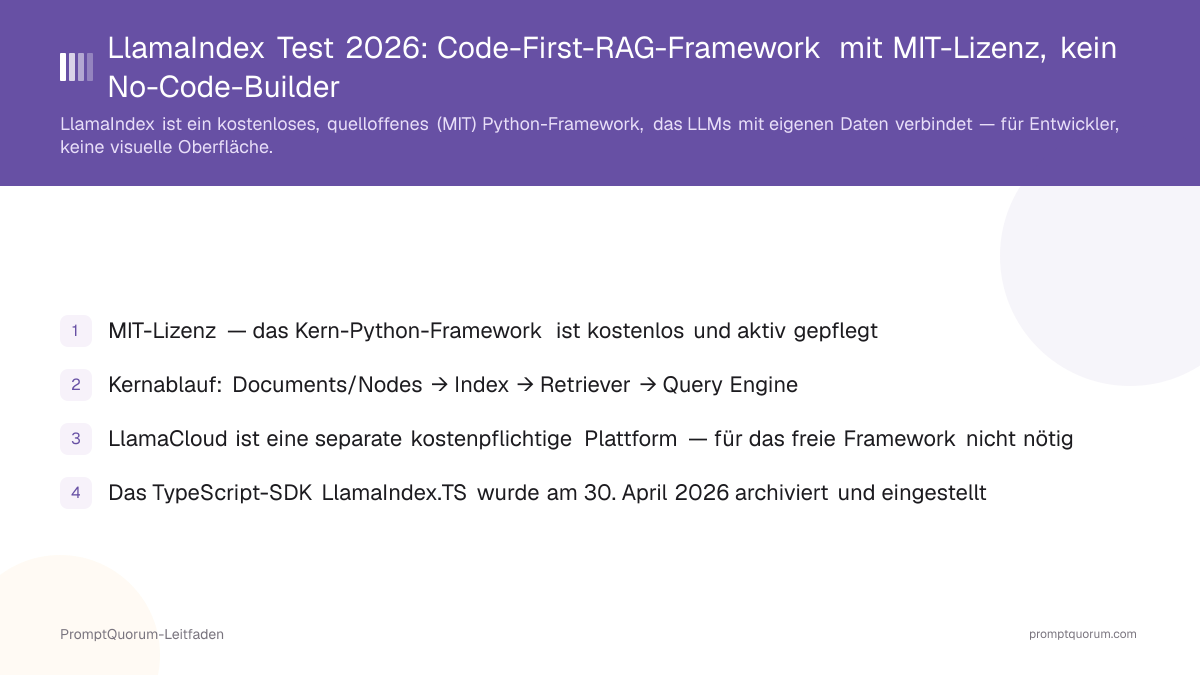
- MIT-Lizenz — das Kern-Python-Framework ist kostenlos, permissiv lizenziert und wird aktiv gepflegt
- Kernbausteine: Documents/Nodes speisen einen Index (meist ein VectorStoreIndex), ein Retriever holt relevante Nodes, eine Query Engine beantwortet die Frage
- Kostenlos zu installieren und selbst zu hosten: pip install llama-index, mit eigenem LLM-Anbieter und Vektorspeicher
- LlamaCloud ist eine separate, kostenpflichtige, nutzungsbasierte Plattform für automatisierte Dokumentenverarbeitung (LlamaParse) und -extraktion — für das quelloffene Framework nicht erforderlich
- Code-first: es gibt keine visuelle Oberfläche — dies ist eine Python-Bibliothek zum Importieren und Programmieren gegen
- Das TypeScript-SDK LlamaIndex.TS wurde am 30. April 2026 archiviert und als eingestellt markiert — Python ist die aktiv gepflegte Implementierung
- Am besten geeignet für: Entwickler, die produktive RAG-Systeme bauen und programmatische Kontrolle über Indexierung und Retrieval-Logik wollen
📍 In einem Satz
LlamaIndex ist ein kostenloses, quelloffenes (MIT) Python-Framework, das große Sprachmodelle über Indexierung, Retrieval und Query Engines mit eigenen Daten verbindet — gebaut für Entwickler, die Code schreiben, nicht für visuelle No-Code-Builder.
💬 In einfachen Worten
Statt Boxen auf einer Oberfläche zu verschieben, gibt LlamaIndex Ihnen Python-Klassen: Dokumente laden, einen Index bauen, dann abfragen — jeder Schritt ist Code, den Sie versionieren, testen und anpassen können.
📌Hinweis: Wenn Sie eine RAG-Pipeline durch Verbinden von Boxen statt durch Python-Code bauen möchten, ist LlamaIndex das falsche Werkzeug — nutzen Sie stattdessen einen visuellen Builder wie Flowise, Langflow oder Dify.
Was ist LlamaIndex?
LlamaIndex (github.com/run-llama/llama_index) ist ein quelloffenes, MIT-lizenziertes Python-Framework zum Bau von Anwendungen, die große Sprachmodelle mit eigenen Daten verbinden. Es ist in erster Linie ein Daten-Framework: Die Bibliothek ist um das Einlesen von Dokumenten, ihre Strukturierung für das Retrieval und die Beantwortung von Fragen darüber organisiert — nicht um allgemeine Agenten-Orchestrierung.
- Datenconnector: SimpleDirectoryReader für lokale Dateien, plus über 300 Community- und First-Party-Integrationen auf LlamaHub für PDFs, APIs, SQL-Datenbanken und andere Quellen
- Indizes: Strukturen, die eingelesene Daten für das LLM-Retrieval organisieren — VectorStoreIndex (embedding-basierte semantische Suche) ist die gängigste
- Retriever: holen die für eine Anfrage relevanten Nodes aus einem Index
- Query Engines: kombinieren einen Retriever mit einem LLM-Aufruf, um eine Frage über die eigenen Daten zu beantworten — der Kern-Loop von Retrieval-Augmented Generation (RAG)
- Workflows: ein ereignisgesteuertes System zur Orchestrierung mehrstufiger Agenten und Pipelines über eine einzelne Anfrage hinaus
- Das Kern-Python-Repository verzeichnet über 50.000 GitHub-Stars
Was sind die Kernbausteine von LlamaIndex?
LlamaIndex gliedert eine RAG-Pipeline in fünf Bausteine: Document/Node, Index, Retriever, Query Engine und Workflow. Jeder Baustein entspricht einem Schritt, um aus Rohdateien ein LLM zu machen, das Fragen dazu beantworten kann.
Documents und Nodes
Ein Document kapselt eine Rohquelle — ein PDF, eine Webseite, eine Datenbankzeile. LlamaIndex zerlegt jedes Document in Nodes, kleinere Abschnitte passend zum Kontextfenster eines Embedding-Modells, und hängt Metadaten an (Quelldatei, Seitenzahl), die als Zitat bis in die finale Antwort erhalten bleiben.
Indizes und Retriever
Ein Index nimmt eine Liste von Nodes und organisiert sie für schnellen Zugriff. VectorStoreIndex embeddet jeden Node und speichert die Vektoren in einer Vektordatenbank (standardmäßig im Arbeitsspeicher, oder bei einem Anbieter wie Pinecone, Qdrant oder Chroma). Ein aus diesem Index gebauter Retriever nimmt eine Anfrage, embeddet sie auf dieselbe Weise und liefert die top-k ähnlichsten Nodes zurück.
Query Engines
Eine Query Engine kapselt einen Retriever und einen LLM-Aufruf in einer Methode: Sie holt relevante Nodes, baut einen Prompt damit und gibt die Antwort des Modells zurück. Der Aufruf index.as_query_engine().query("...") ist der kürzeste Weg von einem Index zu einer Antwort.
Document / Node
- Was es leistet:
- Rohdaten, dann daraus zerlegte, strukturierte Teile
Index
- Was es leistet:
- Organisiert Nodes fürs Retrieval (z. B. VectorStoreIndex)
Retriever
- Was es leistet:
- Holt die für eine Anfrage relevanten Nodes
Query Engine
- Was es leistet:
- Kombiniert Retrieval + LLM-Aufruf zur Antwort
Workflow
- Was es leistet:
- Ereignisgesteuerte Orchestrierung mehrstufiger Agenten
Wie unterscheidet sich LlamaIndex von LangChain und visuellen Buildern?
LlamaIndex ist in erster Linie ein Daten-Framework, LangChain ein universelles Orchestrierungs-Framework, und Tools wie Flowise, Langflow und Dify sind visuelle No-Code-Builder — alle drei lösen unterschiedliche Probleme, auch wenn sie sich bei RAG überschneiden. Die Wahl zwischen ihnen ist eine Frage der Priorität, nicht, welches "besser" ist.
LlamaIndex vs. LangChain
LangChain ist um Chains, Agenten und Tool-Aufrufe für ein breites Spektrum an LLM-Anwendungstypen aufgebaut; Retrieval ist eine Fähigkeit unter vielen. LlamaIndex ist speziell um Indexierung und Retrieval aufgebaut — sein Document/Node/Index/Retriever/Query-Engine-Modell ist stärker vorgegeben und erfordert für eine datenintensive RAG-Pipeline meist weniger Boilerplate-Code, ist dafür aber weniger allgemein für nicht-Retrieval-bezogene Agenten-Logik einsetzbar. Beide sind Python-first, MIT-lizenziert und aktiv gepflegt; viele Produktivsysteme kombinieren LlamaIndex fürs Retrieval mit einer separaten Orchestrierungsschicht für den Rest der Anwendung.
LlamaIndex vs. visuelle Builder (Flowise, Langflow, Dify)
Visuelle Builder lassen Sie eine RAG-Pipeline durch Verbinden vorgefertigter Knoten auf einer Oberfläche zusammenbauen — ohne Python. Das kostet Feinkontrolle: individuelle Retrieval-Logik, unübliche Chunking-Strategien oder alles außerhalb der vorgefertigten Knoten-Bibliothek erfordert meist einen "Custom Code"-Knoten oder den Wechsel weg von der Oberfläche. LlamaIndex hat überhaupt keine Oberfläche — jede Pipeline ist von Anfang an Python-Code, den Sie schreiben, testen und versionieren. Wer stattdessen den visuellen Ansatz möchte, findet in unserem Flowise-Test eine Alternative oder kann Langflow und Dify direkt prüfen.
Ist LlamaIndex kostenlos, oder muss man für LlamaCloud bezahlen?
Das Kern-Framework von LlamaIndex ist dauerhaft kostenlos unter der MIT-Lizenz — Sie können es selbst gegen Ihr eigenes LLM und Ihre eigene Vektordatenbank hosten, ohne Kosten für LlamaIndex. LlamaCloud, eine separate gehostete Plattform für automatisierte Dokumentenverarbeitung und -extraktion (LlamaParse, LlamaExtract), berechnet zusätzlich nutzungsbasierte Credits: 1,25 $ pro 1.000 Credits, wobei Parsing 1–45 Credits pro Seite kostet und Extraktion 5–60 Credits pro Seite, je nach gewählter Stufe.
- Quelloffenes Framework (pip install llama-index): kostenlos, MIT-lizenziert, selbst gehostet — kein Konto oder Credits erforderlich
- LlamaCloud / LlamaParse: kostenpflichtige, credit-basierte Dokumentenverarbeitung für layoutintensive PDFs, gescannte Dokumente, Tabellen und Diagramme
- Für den Bau oder Betrieb einer RAG-Pipeline mit dem quelloffenen Framework ist kein LlamaCloud-Konto nötig — SimpleDirectoryReader und andere kostenlose Loader decken einfachen Text, Markdown und Standard-PDFs ab
- LlamaCloud wird relevant, wenn Dokumente so komplex sind (mehrspaltige Layouts, eingebettete Tabellen, Handschrift), dass ein kostenloser Parser schlechte Chunk-Qualität liefert
Wie baut man eine minimale RAG-Pipeline mit LlamaIndex?
Eine funktionierende RAG-Pipeline mit LlamaIndex sind fünf Zeilen Python: Dokumente laden, einen Index bauen, eine Query Engine erstellen und abfragen. Dieses Beispiel nutzt den Standard-In-Memory-Vektorspeicher und ein OpenAI-kompatibles LLM; für einen lokalen Anbieter (etwa Ollama) das passende Integrationspaket installieren und Settings.llm vor dem Bau des Index setzen.
- 1Framework installieren: pip install llama-index (für ein lokales Modell statt eines gehosteten API-Dienstes zusätzlich ein Anbieterpaket wie llama-index-llms-ollama installieren).
- 2LLM-Anbieter-Zugangsdaten setzen — zum Beispiel export OPENAI_API_KEY=... — oder Settings.llm vor dem nächsten Schritt auf einen lokalen Anbieter konfigurieren.
- 3Quelldateien in einen Ordner legen (zum Beispiel data/) und laden: documents = SimpleDirectoryReader("data").load_data().
- 4Aus den geladenen Dokumenten einen Index bauen: index = VectorStoreIndex.from_documents(documents). Dies zerlegt jedes Dokument in Nodes und embeddet sie.
- 5Aus dem Index eine Query Engine erstellen: query_engine = index.as_query_engine().
- 6Daten abfragen und Antwort ausgeben: response = query_engine.query("Ihre Frage hier"); print(response).
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

# Load documents from a folder
documents = SimpleDirectoryReader("data").load_data()

# Build an index from documents
index = VectorStoreIndex.from_documents(documents)

# Create a query engine
query_engine = index.as_query_engine()

# Query your data
response = query_engine.query("Your question here")
print(response)
Wird dieser Index bei jedem Skriptlauf neu gebaut?
Ja, standardmäßig. Für alles jenseits eines einmaligen Skripts index.storage_context.persist() nach dem Bau des Index aufrufen und ihn bei folgenden Läufen mit load_index_from_storage() zurückladen, statt jedes Mal alle Dokumente neu zu embedden.
Kann ich ein lokales LLM und einen lokalen Vektorspeicher statt OpenAI nutzen?
Ja. Das passende Integrationspaket installieren (zum Beispiel llama-index-llms-ollama für ein lokales Modell, oder ein Vektorspeicher-Paket wie llama-index-vector-stores-chroma), dann Settings.llm und Settings.embed_model setzen oder den Vektorspeicher an VectorStoreIndex.from_documents() übergeben — der restliche Query-Engine-Code bleibt derselbe.
Wird die TypeScript-Version von LlamaIndex noch gepflegt?
Nein. LlamaIndex.TS (run-llama/LlamaIndexTS auf GitHub) wurde von den Maintainern archiviert und am 30. April 2026 als eingestellt markiert. Der Hinweis im Repository selbst besagt, das Projekt "is deprecated and no longer maintained", und verweist Nutzer auf die LlamaCloud-/LlamaParse-Dokumentation statt auf das TypeScript-SDK.
- Das Python-Framework (llama_index) ist die aktiv gepflegte Implementierung — dieser Artikel behandelt diese Version
- Bestehende TypeScript-Projekte auf Basis von LlamaIndex.TS laufen weiter, erhalten aber keine weiteren Updates, Fehlerbehebungen oder Sicherheitspatches mehr
- Für ein neues TypeScript- oder JavaScript-Projekt LangChain.js (aktiv gepflegt, MIT-lizenziert) statt eines archivierten Projekts prüfen
Für wen eignet sich LlamaIndex?
LlamaIndex besetzt eine spezifische Position in der RAG-Tooling-Landschaft: Entwickler, die Kontrolle auf Code-Ebene über Indexierung und Retrieval wollen, nicht den schnellsten Weg zu einem visuellen Prototyp.
LlamaIndex nutzen, wenn
- Sie sicher in Python schreiben und pflegen und Ihre RAG-Pipeline von Anfang an unter Versionskontrolle haben möchten
- Sie ein Produktiv-Retrieval-System bauen, bei dem Chunking-Strategie, Retrieval-Logik oder Indexstruktur über eine vorgefertigte Knoten-Bibliothek hinaus angepasst werden müssen
- Sie mehrere Datenquellen (PDFs, Datenbanken, APIs) über das Connector-Ökosystem von LlamaHub in einer Retrieval-Schicht kombinieren müssen
- Sie ein Framework wollen, das Retrieval als primäres Anliegen behandelt, nicht als einen Knotentyp unter vielen allgemeinen Agenten-Tools
LlamaIndex meiden, wenn
- Sie kein Entwickler sind, oder Ihr Team eine RAG-Pipeline ohne Codeschreiben prototypisieren möchte — nutzen Sie stattdessen einen visuellen Builder wie Flowise, Langflow oder Dify
- Ihr Projekt ein universeller LLM-Agent mit Tool-Aufrufen und mehrstufigem Reasoning als primärem Bedarf ist, nicht Dokumenten-Retrieval — LangChain oder ein dediziertes Agenten-Framework passt hier eventuell besser
- Sie ein TypeScript-natives Framework für ein neues Projekt benötigen — LlamaIndex.TS ist eingestellt; prüfen Sie stattdessen LangChain.js
- Sie jeden Dokumentenverarbeitungsschritt vollständig selbst gehostet ohne nutzungsbasierte Abrechnung im gesamten Stack benötigen, auch für komplexes PDF-Parsing — die Credit-Preise von LlamaCloud passen dann eventuell nicht, das Kern-Framework selbst bleibt aber kostenlos
LlamaIndex vs. Alternativen
Die richtige Wahl hängt davon ab, ob Sie Kontrolle auf Code-Ebene (LlamaIndex, LangChain, Haystack) oder eine visuelle Oberfläche (Flowise und ähnliche Tools) wollen.
Tool | Oberfläche | Lizenz | Am besten für | Pflegestatus |
|---|---|---|---|---|
| LlamaIndex | Python-Code | MIT | Datenintensive individuelle RAG-Pipelines | Aktiv |
| LangChain | Python-/JS-Code | MIT | Universelle LLM-Orchestrierung | Aktiv |
| Haystack | Python-Code | Apache 2.0 | Enterprise-Suche + RAG-Pipelines | Aktiv |
| Flowise | Visuell, Drag-and-drop | Apache 2.0 | No-Code-Prototyping (ungepflegt) | Archiviert / keine |
Häufige Fehler bei der Bewertung von LlamaIndex
Diese Fehler entstehen dadurch, LlamaIndex als eine andere Werkzeugkategorie zu behandeln, als es tatsächlich ist.
Fehler 1: Eine visuelle No-Code-Oberfläche erwarten
LlamaIndex hat keine Oberfläche, keine Drag-and-drop-Knoten und keine GUI zum Bau einer Pipeline. Jede Pipeline ist Python-Code. Wer tatsächlich einen visuellen Builder möchte, sollte Flowise, Langflow oder Dify prüfen — LlamaIndex bei "Benutzerfreundlichkeit für Nicht-Entwickler" gegen diese anzutreten, misst das Falsche.
Fehler 2: Annehmen, LlamaCloud sei für die Nutzung von LlamaIndex nötig
LlamaCloud ist optional. Das quelloffene Framework wird per pip installiert, läuft gegen das eigene LLM und den eigenen Vektorspeicher und verarbeitet einfachen Text, Markdown und Standard-PDFs ohne kostenpflichtiges Konto. LlamaCloud wird erst relevant bei komplexem Dokumenten-Parsing (gescannte Seiten, dichte Tabellen), das kostenlose Loader schlecht verarbeiten.
Fehler 3: Ein neues TypeScript-Projekt auf LlamaIndex.TS starten
LlamaIndex.TS wurde am 30. April 2026 archiviert und als eingestellt markiert. Neue TypeScript- oder JavaScript-Projekte sollten LangChain.js prüfen oder einen Python-Retrieval-Dienst hinter einer API bauen, statt auf einer ungepflegten Bibliothek zu starten.
Häufig gestellte Fragen
Ist LlamaIndex kostenlos nutzbar?
Ja. Das Kern-Python-Framework ist quelloffen und kostenlos unter der MIT-Lizenz. LlamaCloud, eine separate gehostete Plattform für Dokumentenverarbeitung und -extraktion, berechnet nutzungsbasierte Credits (1,25 $ pro 1.000 Credits), ist aber optional und für den Bau oder Betrieb einer RAG-Pipeline nicht erforderlich.
Unter welcher Lizenz steht LlamaIndex?
MIT License, sowohl für das Python-Framework (llama_index) als auch — solange es gepflegt wurde — für das TypeScript-SDK (LlamaIndex.TS). MIT erlaubt kommerzielle Nutzung, Änderung und Weiterverbreitung.
Wie unterscheidet sich LlamaIndex von LangChain?
LlamaIndex ist ein Daten-Framework, das speziell um Indexierung und Retrieval aufgebaut ist — Documents, Nodes, Indizes, Retriever und Query Engines. LangChain ist ein universelles Orchestrierungs-Framework für Chains, Agenten und Tool-Aufrufe, bei dem Retrieval eine Fähigkeit unter vielen ist. Beide sind MIT-lizenziert, Python-first und aktiv gepflegt; viele Produktivsysteme nutzen beide zusammen.
Ist LlamaIndex ein visueller No-Code-Builder?
Nein. LlamaIndex ist eine Python- (früher auch TypeScript-) Bibliothek, die Sie importieren und gegen die Sie Code schreiben — es gibt keine Drag-and-drop-Oberfläche. Für einen visuellen No-Code-Ansatz bei RAG- oder Agenten-Pipelines Flowise, Langflow oder Dify prüfen.
Was ist LlamaCloud, und brauche ich es?
LlamaCloud ist eine separate, kostenpflichtige, nutzungsbasierte Plattform desselben Unternehmens mit LlamaParse (Dokumenten-Parsing) und LlamaExtract (strukturierte Extraktion) für komplexe Dokumente. Für die Nutzung des quelloffenen LlamaIndex-Frameworks ist es nicht nötig — nützlich wird es erst, wenn kostenlose Dokumenten-Loader bei komplexen PDFs, gescannten Seiten oder dichten Tabellen schlechte Ergebnisse liefern.
Wird die TypeScript-Version von LlamaIndex noch gepflegt?
Nein. LlamaIndex.TS wurde von den Maintainern archiviert und am 30. April 2026 als eingestellt markiert. Das Python-Framework bleibt die aktiv gepflegte Implementierung. Für ein neues TypeScript-/JavaScript-Projekt LangChain.js prüfen.
Was ist eine Query Engine in LlamaIndex?
Eine Query Engine kombiniert einen Retriever mit einem LLM-Aufruf in einem Methodenaufruf. index.as_query_engine().query("Ihre Frage") holt die relevanten Nodes aus dem Index, baut damit einen Prompt und liefert die Antwort des Modells zurück — der Kern-Loop von Retrieval-Augmented Generation (RAG).
Wie viele Integrationen unterstützt LlamaIndex?
LlamaHub hostet über 300 Community- und First-Party-Integrationspakete für Daten-Loader (PDFs, APIs, SQL-Datenbanken und mehr), LLM-Anbieter und Vektorspeicher, zusätzlich zum eingebauten SimpleDirectoryReader für lokale Dateien.
Kann ich mit LlamaIndex ein lokales LLM statt einer Cloud-API nutzen?
Ja. Das passende Anbieter-Integrationspaket installieren (zum Beispiel llama-index-llms-ollama für Ollama), dann per Settings.llm als Standard setzen, bevor der Index gebaut wird — der übrige Document/Index/Retriever/Query-Engine-Ablauf funktioniert unabhängig vom LLM-Anbieter gleich.
Kann ich eine LlamaIndex-App als lokalen API-Server selbst hosten?
Ja. Der Full-Stack Web Application Guide von LlamaIndex beschreibt, wie eine RAG-Pipeline hinter einem Flask-/FastAPI-artigen Backend verpackt und in einem Docker-Container betrieben wird — ohne LlamaCloud-Konto oder gehosteten Dienst.
Muss ich Python schreiben, um LlamaIndex zu nutzen?
Ja, für die aktuell gepflegte Version. LlamaIndex ist ein code-first-Framework ohne visuelle Oberfläche. Nicht-Entwickler oder Teams, die einen No-Code-Ansatz möchten, sollten stattdessen einen visuellen Builder wie Flowise, Langflow oder Dify prüfen.
Ist LlamaIndex DSGVO-konform einsetzbar?
Das quelloffene Framework selbst verarbeitet keine Daten auf fremden Servern — bei Self-Hosting mit einem selbst gehosteten oder EU-basierten LLM und Vektorspeicher liegt die Datenverarbeitung vollständig in Ihrer eigenen Infrastruktur, was Artikel 28 DSGVO (Auftragsverarbeitung) vereinfachen kann. LlamaCloud dagegen ist ein externer, gehosteter Dienst — bei dessen Nutzung prüfen Sie den Serverstandort und den Auftragsverarbeitungsvertrag des Anbieters gesondert. Dies ist keine Rechtsberatung; lassen Sie die konkrete datenschutzrechtliche Einordnung für Ihren Anwendungsfall von einem Datenschutzbeauftragten oder einer Kanzlei prüfen.
Eignet sich LlamaIndex für den deutschen Mittelstand?
Für Teams mit eigener Python-Entwicklungskapazität ja: Das MIT-lizenzierte, aktiv gepflegte Framework lässt sich vollständig selbst hosten und in bestehende IT-Sicherheitsprozesse (BSI-Grundschutz) einbinden. Für Teams ohne Entwicklerressourcen ist ein visueller Builder wie Flowise oder ein fertiges RAG-Produkt meist der praktischere Einstieg.