Günstigster praktikabler Weg, ein 70B-Modell lokal zu betreiben 2026
Der günstigste praktikable Weg, ein 70B-Q4-Modell lokal zu betreiben, ist eine gebrauchte Dual-RTX-3090-Konfiguration (~48 GB kombinierter VRAM) — wenn Sie bereit sind, einen PC selbst zusammenzubauen. Für die einfachste Ein-Geräte-Lösung braucht ein Apple-Silicon-Mac mit 64 GB+ Unified Memory keinen Multi-GPU-Aufbau. Eine einzelne 24-GB-GPU kann ein vollständiges 70B-Q4-Modell allein nicht aufnehmen. Apples Update vom August 2026 brachte eine neue Option: den Mac mini mit M5 Pro (64 GB Unified Memory, ab 1.699 $) — das günstigste neue Apple-Silicon-Gerät, das die 70B-Speichergrenze schafft, während der Basis-Mac-mini mit M6 (max. 32 GB) das nicht kann.
Diese Seite enthält Verweislinks zu Produkten von Drittanbietern. PromptQuorum ist an keinem Partnerprogramm beteiligt — es sind reine Referenzlinks, die keine Provision erzielen. Das Anklicken von Links und Ihre nächsten Schritte liegen in Ihrer eigenen Verantwortung. Diese Links stellen keine Billigung oder Verifizierung durch PromptQuorum dar.
Schnelle Antwort
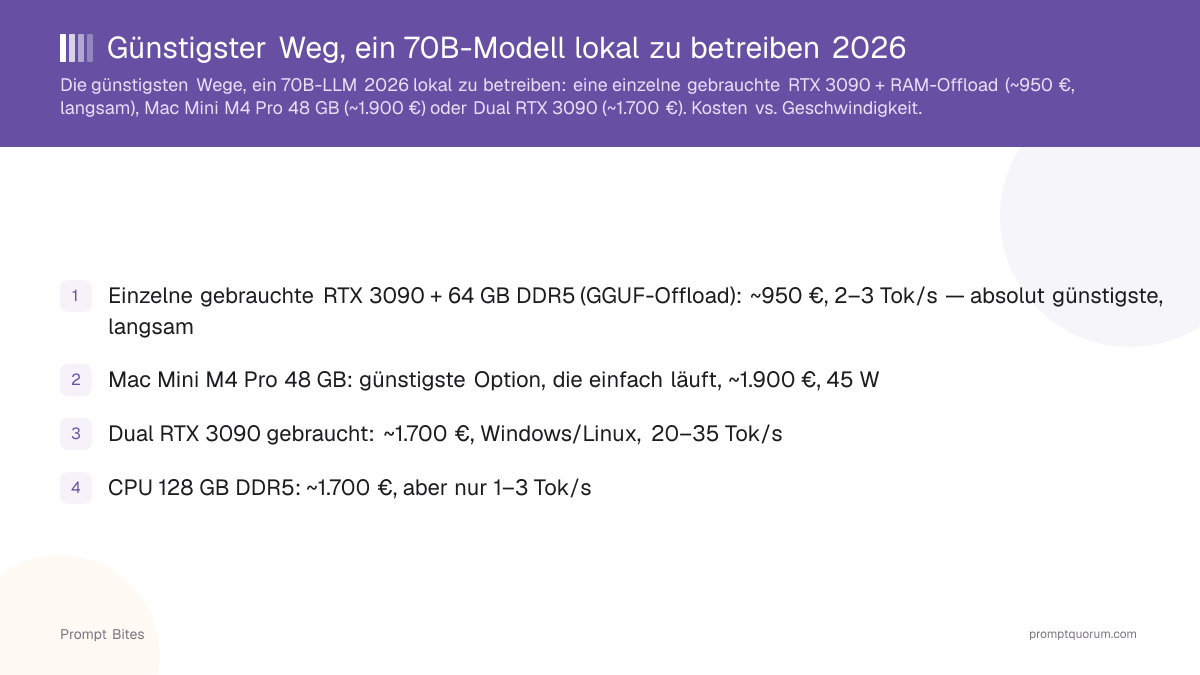
Eine gebrauchte Dual-RTX-3090-Konfiguration (~48 GB kombinierter VRAM) ist der günstigste praktikable Weg, ein 70B-Q4-Modell mit nutzbarer Geschwindigkeit zu betreiben. Ein Apple-Silicon-Mac mit 64 GB+ Unified Memory ist die einfachste Ein-Geräte-Alternative — kein Multi-GPU-Aufbau nötig. Prüfen Sie aktuelle Preise statt einer festen Zahl — gebrauchte GPU-Preise schwanken stark.
- ▸Günstigste praktikable Lösung: 2× gebrauchte RTX 3090 24 GB (~48 GB kombinierter VRAM) — vollständiges Q4-Offload, erfordert PC-Bau-Kenntnisse
- ▸Am einfachsten: Apple-Silicon-Mac mit 64 GB+ — das gesamte Modell passt in den Unified Memory, kein Multi-GPU-Aufbau
- ▸Günstigste Hardware absolut: 64–128 GB RAM, reines CPU-Setup — funktioniert, aber quälend langsam bei 1–3 Tok/s
- ▸Beste Leistung: ein hoch-VRAM-Multi-GPU-System für ernsthafte, dauerhafte 70B-Workloads
- ▸Neu seit August 2026: Der Mac mini mit M5 Pro (64 GB, ab 1.699 $) ist das günstigste neue Apple-Silicon-Gerät, das 70B betreiben kann — der Basis-Mac-mini mit M6 (max. 32 GB) kann das nicht
Wichtigste Punkte
- ✓70B Q4 benötigt etwa 40–48 GB Speicher — eine einzelne 24-GB-GPU kann das vollständige Modell nicht aufnehmen
- ✓Günstigste praktikable Lösung: 2× gebrauchte RTX 3090 24 GB, vollständiges Q4-Offload — aktuelle Gebrauchtpreise prüfen
- ✓Am einfachsten: Apple-Silicon-Mac mit 64 GB+ — kein Multi-GPU-Aufbau nötig
- ✓Günstigste Hardware absolut: 64–128 GB RAM, reines CPU-Setup — nutzbar, aber langsam (1–3 Tok/s)
- ✓Nur gelegentliche Nutzung? Eine Cloud-GPU zu mieten ist oft günstiger als überhaupt Hardware zu kaufen
- ✓Update August 2026: Der neue Mac mini mit M5 Pro (64 GB, ab 1.699 $) kann jetzt 70B betreiben — der Basis-Mac-mini mit M6 (max. 32 GB) weiterhin nicht
Günstigste praktikable Lösung: 2× gebrauchte RTX 3090
Zwei gebrauchte RTX-3090-Karten (je 24 GB VRAM) ergeben mit Tensor-Parallel-Splitting in llama.cpp zusammen etwa 48 GB nutzbaren VRAM — genug, um ein 70B-Q4_K_M-Modell vollständig ohne CPU-Fallback zu laden. Sie brauchen ein Mainboard mit zwei x16-PCIe-Slots und ein Netzteil mit 1000 W+.
Die Preise für gebrauchte RTX-3090-Karten schwanken je nach Zustand, Kühlung und Verkäufer stark — prüfen Sie aktuelle Angebote statt einer festen Zahl zu vertrauen. In Deutschland liegen Angebote auf Kleinanzeigen aktuell grob zwischen 900 € und 1.200 € pro Karte, je nach Zustand.
Kaufen Sie sie, wenn: Sie gerne PCs zusammenbauen und die beste Inferenzgeschwindigkeit pro Euro wollen. Verzichten Sie darauf, wenn: Sie ein leises, einfaches Ein-Geräte-System wollen — siehe die Mac-Option unten.
70B-Hardware-Vergleich
Alle Optionen unten passen ein 70B-Q4_K_M-Modell (~42 GB) mit nutzbarer Qualität. Prüfen Sie aktuelle Preise für jede Option, bevor Sie entscheiden — Preise für gebrauchte GPUs und RAM ändern sich häufig.
| Setup | Geschwindigkeit | Komplexität | Am besten für |
|---|---|---|---|
| CPU + 64–128 GB RAM | 🐌 1–3 Tok/s | ⭐ Niedrig | Günstigste Hardware, Tests |
| 2× gebrauchte RTX 3090 | 🏆 20–35 Tok/s | ⚠️ Hoch | Bestes Preis-Leistungs-Verhältnis |
| Apple-Silicon-Mac 64 GB+ | ⭐⭐⭐ 12–18 Tok/s | 🟢 Niedrig | Einfachheit, ein Gerät |
| Mac mini M5 Pro 64 GB (neu) | 🆕 Noch nicht getestet | 🟢 Niedrig | Günstigstes neues Komplettsystem |
| Einzelne RTX 4090 + Offload | ⭐⭐ 8–12 Tok/s | ⚠️ Mittel | Bereits eine 4090 vorhanden |
| Apple-Silicon-Mac 128 GB | 🚀 25–35 Tok/s | 🟢 Niedrig | Größere Modelle, volle Qualität |
Am einfachsten: Apple-Silicon-Mac mit 64 GB+
Wenn Sie keinen Dual-GPU-PC bauen wollen, ist Apple Silicon deutlich einfacher: Das Modell liegt direkt im Unified Memory, es muss also nichts zwischen Systemspeicher und VRAM aufgeteilt werden, und es gibt kein Multi-GPU-Treiber-Setup. 64 GB Unified Memory ist das Ziel, um 70B Q4 komfortabel ohne Layer-Offloading auf die Festplatte zu betreiben.
Apples Hardware-Update vom 25. August 2026 hat neben dem Mac Studio auch den Mac mini aktualisiert. Der Basis-Mac-mini mit M6-Chip startet bei 899 $, ist aber auf maximal 32 GB Unified Memory begrenzt — das reicht nicht für ein 70B-Q4-Modell, für diesen Einsatzzweck also ungeeignet. Der Mac mini mit M5-Pro-Chip startet bei 1.699 $ mit bis zu 64 GB Unified Memory und erreicht damit das 64-GB-Ziel — das günstigste neue Apple-Silicon-Gerät, das ein 70B-Modell betreiben kann. Beide erscheinen am 22. September 2026; prüfen Sie den aktuellen Preis, bevor Sie kaufen, da sich Preise für neue Hardware verschieben können.
Apple hat die Mac-Studio-Reihe in derselben Ankündigung im August 2026 auf M5 Max/M5 Ultra aktualisiert, ab 2.499 $, konfigurierbar bis 128 GB Unified Memory — prüfen Sie den aktuellen Preis für eine 64-GB-Konfiguration statt sich auf eine alte Zahl zu verlassen. Ein MacBook Pro mit 64 GB+ Unified Memory ist das portable Äquivalent, mit einem Preisaufschlag gegenüber dem Desktop.
Wenn Sie bei null anfangen — also keinen vorhandenen PC haben, dem Sie GPUs hinzufügen können —, ist der 1.699-$-Mac-mini mit M5 Pro oft günstiger als der komplette Eigenbau einer Dual-RTX-3090-Maschine, sobald Sie Mainboard, Netzteil und Gehäuse mitrechnen und nicht nur die zwei GPUs. Wenn Sie bereits einen leistungsfähigen PC besitzen, ist das Nachrüsten mit zwei gebrauchten RTX 3090 wahrscheinlich weiterhin der günstigere und schnellere Weg.
Kaufen Sie ihn, wenn: Ihnen Einfachheit, geringer Stromverbrauch und leiser Betrieb wichtiger sind als reine Geschwindigkeit. Verzichten Sie darauf, wenn: Sie die höchstmögliche Token-pro-Sekunde-Zahl pro Euro wollen — dort gewinnt der Dual-3090-Aufbau.
Günstigste Hardware absolut: CPU + 64–128 GB RAM
Technisch brauchen Sie überhaupt keine GPU — ein 70B-Q4_K_M-Modell kann vollständig im Systemspeicher laufen. Rechnen Sie mit etwa 1–3 Tokens pro Sekunde, was für Batch-Aufgaben oder Tests nutzbar ist, für interaktiven Chat aber frustrierend langsam.
Kaufen Sie keine reine 128-GB-CPU-Maschine speziell für interaktiven 70B-Chat, es sei denn, die reinen Kosten sind Ihnen wirklich wichtiger als Geschwindigkeit — die Dual-3090- oder Mac-Optionen oben kosten mehr, sind aber im Alltag deutlich nutzbarer.
Eine Alternative: Mieten statt kaufen
Wenn Sie ein 70B-Modell nur gelegentlich brauchen, kaufen Sie gar keine Hardware. Cloud-GPU-Miete ist für gelegentliche Nutzung oft deutlich günstiger als eine Hardware-Anschaffung für 1.500–3.000 $ — RunPods Community-Cloud-A40 mit 48 GB (die kleinste GPU, die 70B Q4 vollständig aufnimmt) kostet nach diesem Check rund 0,44 $/Stunde, und gehostete Inferenz-APIs für Llama 3.3 70B existieren ganz ohne eigene Hardware, mit Preis pro Token.
Das sollte man klar benennen statt zu übergehen, denn eine Seite, die nur je Hardware-Kauf empfiehlt, wirkt, als wolle sie allen Hardware verkaufen — bei gelegentlicher oder unregelmäßiger Nutzung ist Mieten die ehrlichere Antwort.
Quantisierung für 70B
Für ein 70B-Modell ist Q4_K_M der Standard-Kompromiss aus Größe und Qualität. Die Qualitätsprozentangaben unten sind Näherungswerte — der tatsächliche Qualitätsverlust hängt vom konkreten Modell und der Bewertungsmethode ab, nicht von einer universellen Konstante.
| Quantisierung | Größe | Qualität vs. FP16 |
|---|---|---|
| Q4_K_M | ~42 GB | ~96 % (bester Kompromiss) |
| Q3_K_M | ~32 GB | ~90 % |
| Q2_K | ~25 GB | ~82 %, merklicher Verlust |
| FP16 (voll) | ~140 GB | 100 % — auf Consumer-Hardware unrealistisch |
Kaufen Sie keine einzelne 24-GB-GPU in Erwartung voller 70B-Geschwindigkeit
- ▸Eine einzelne 24-GB-Karte (RTX 3090 oder 4090) kann kein vollständiges 70B-Q4-Modell aufnehmen — sie kann eines mit CPU-Offloading betreiben, aber die Geschwindigkeit sinkt auf etwa 8–12 Tok/s.
- ▸24-GB-GPU allein → partielles Offload, langsamer
- ▸48 GB kombinierter VRAM (2× 24 GB) → vollständiges 70B-Q4-Offload
- ▸64 GB+ Unified Memory (Mac) → komfortabel, kein Offloading nötig
- ▸Basis-Mac-mini mit M6 (max. 32 GB) → kann ebenfalls kein vollständiges 70B-Modell betreiben, gleiche Kategorie wie eine einzelne 24-GB-GPU
Verwandte Leitfäden
- ▸Wie viel VRAM braucht ein 70B-Modell? — how much VRAM for a 70B model
- ▸DeepSeek R1 Distill VRAM-Spickzettel — DeepSeek R1 distill VRAM cheatsheet
- ▸Bestes DeepSeek Distill für Ihre GPU — best DeepSeek distill for your GPU
- ▸Cloud-GPU-Kosten pro Stunde 2026 — cloud GPU cost per hour
Quick Answers
Kann ich ein 70B-Modell auf einer einzelnen Consumer-GPU betreiben?▾
Wie viel RAM brauche ich für ein 70B-Modell nur per CPU?▾
Reicht die Qualität von Q4 für ein 70B-Modell aus?▾
Was ist der günstigste Weg, ein 70B-Modell ohne Hardware-Kauf zu betreiben?▾
Kann der neue Mac mini ein 70B-Modell betreiben?▾
Den vollständigen Überblick?
Die vollständige Anleitung lesen →