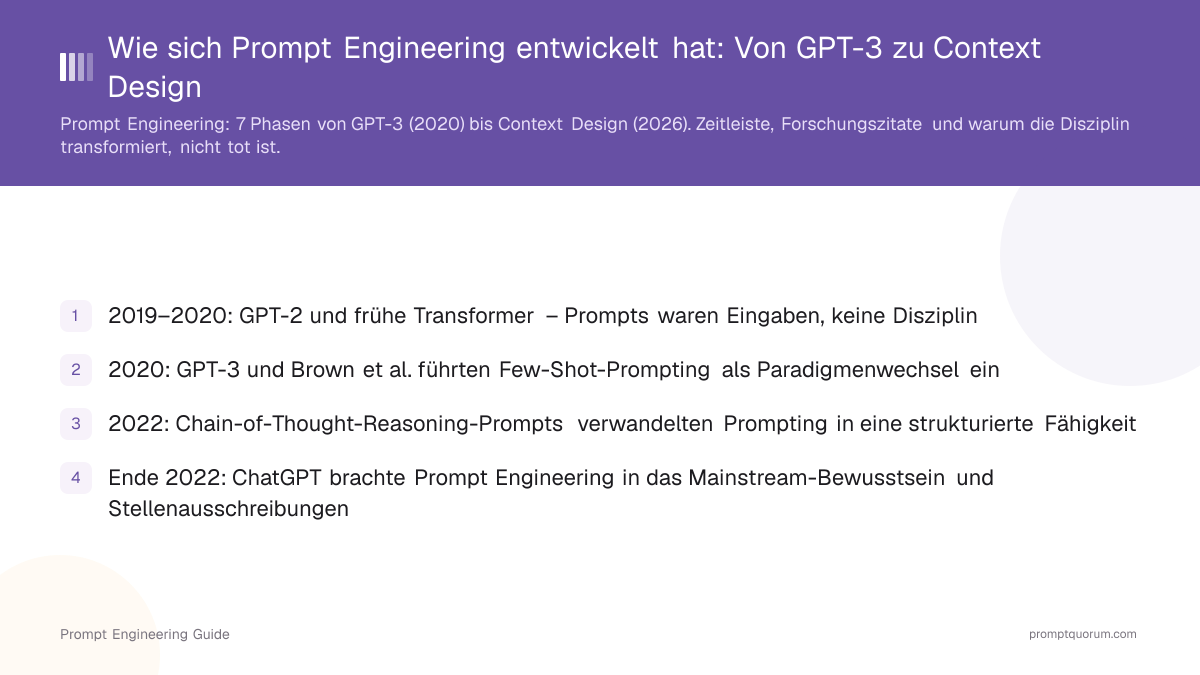
Wie sich Prompt Engineering entwickelt hat: Ein kurzer Überblick
📍 In One Sentence
Prompt Engineering entwickelte sich von Formulierungstricks nach Versuch und Irrtum zu einer dokumentierten Disziplin aus wiederverwendbaren Mustern, Evaluation und Versionierung, weil bei leistungsfähigeren Modellen die Struktur wichtiger wurde als die geschickte Wortwahl.
💬 In Plain Terms
Am Anfang war es Folklore: Man tauschte Formulierungen aus, die zu funktionieren schienen. Mit besseren Modellen verloren die Zauberworte an Bedeutung — entscheidend wurde die Struktur: wer, was, in welchem Format. Genau dieser Wandel machte aus einer Trickkiste ein lehrbares Handwerk.
Prompt Engineering entwickelte sich von informellem Trial-and-Error-Textmanipulation rund um GPT-3 im Jahr 2020 zu einer strukturierten Disziplin mit benannten Techniken, Frameworks und Werkzeugen bis 2026. Der Bogen umfasst fünf Phasen: frühe Few-Shot-Experimente, den ChatGPT-Moment, der die Fähigkeit in das Mainstream-Bewusstsein brachte, die Entwicklung strukturierter Denktechniken, den Aufstieg der automatisierten Prompt-Optimierung und die aktuelle Verschiebung hin zum Kontext-Design.
Die Disziplin entstand nicht aus einem einzigen Paper oder Unternehmen. Sie wuchs aus der Überschneidung von Forschung (Few-Shot-Learning, Chain-of-Thought-Reasoning, RAG), Praktikergemeinschaften, die Prompt-Sammlungen online teilten, und der plötzlichen öffentlichen Verfügbarkeit leistungsfähiger Modelle, die gutes Prompting sofort lohnend machte. Bis 2026 ist Prompt Engineering kein Nischentrick mehr – es ist eine Basisfähigkeit für jeden, der mit KI-Systemen arbeitet.
Bevor Prompt Engineering einen Namen hatte (vor 2020)
Bevor es den Begriff „Prompt Engineering“ gab, manipulierten Forschende bereits Modelleingaben, um bessere Ausgaben zu erzielen – sie nannten es nur nicht so. Frühe Transformer-Modelle wie GPT-2 (2019, OpenAI) und BERT (2018, Google) wurden über sorgfältig gewählte Eingabetexte genutzt, doch die Praxis galt als Teil der Datenvorverarbeitung und nicht als eigenständige Fähigkeit.
GPT-2 wurde im Februar 2019 als Modell mit 1,5 Milliarden Parametern angekündigt; OpenAI veröffentlichte zunächst kleinere Versionen und im November 2019 das vollständige Modell. Es konnte Texte erstaunlich kohärent fortsetzen. Forschende und frühe Anwender bemerkten, dass die Formulierung einer Eingabe die Qualität der Fortsetzung stark veränderte, doch es gab noch kein Framework, keine Terminologie und keine Community rund um diese Beobachtung. Prompts waren Eingaben, keine Engineering-Artefakte.
2020: GPT-3 und der Few-Shot-Durchbruch
Die moderne Geschichte des Prompt Engineerings beginnt faktisch mit GPT-3. Im Mai 2020 veröffentlichten OpenAI-Forschende „Language Models are Few-Shot Learners“ (Brown et al.), das GPT-3 beschreibt, ein Modell mit 175 Milliarden Parametern. Die Arbeit zeigte, dass einige Beispiele der gewünschten Aufgabe direkt im Prompt – ohne jede Aktualisierung der Modellgewichte – die Leistung bei vielen Folgeaufgaben verbesserten.
Das war der Keim des Prompt Engineerings als Disziplin. Forschende und Entwickler erkannten, dass dasselbe Modell allein durch die Formulierung des Prompts zum Übersetzer, Zusammenfasser, Code-Generator oder Frage-Antwort-System werden konnte. Das Modell musste nicht neu trainiert werden – es brauchte einen besseren Prompt. Diese Erkenntnis veränderte, was ein Prompt ist: nicht nur eine Eingabe, sondern ein Gestaltungsartefakt.
Brown et al. berichteten, dass die Few-Shot-Leistung im Allgemeinen mit der Modellgröße stieg und GPT-3 mit 175 Milliarden Parametern insgesamt die stärkste Variante war. Das verband Skalierung und promptbasiertes Lernen und machte die Qualität des Prompts zu einer Variable, die auch Praktiker – nicht nur Forschende – steuern konnten.
Eine praktische Anleitung zu der Technik, die GPT-3 bekannt machte, finden Sie unter Zero-Shot vs. Few-Shot Prompting.
2021 – Anfang 2022: Von Prompt-Tricks zu einer anerkannten Fähigkeit
Zwischen 2021 und Anfang 2022 wanderte das Prompt-Handwerk aus Forschungsarbeiten in Praktiker-Communities. Forschende begannen, die Praxis schriftlich zu beschreiben: Reynolds und McDonell argumentierten in „Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm“ (Februar 2021), dass das Schreiben von Prompts für GPT-3 eine Form des Programmierens sei, und der Überblick „Pre-train, Prompt, and Predict“ (Liu et al., Juli 2021) katalogisierte promptbasierte Methoden in der Sprachverarbeitung. Praktiker tauschten unterdessen funktionierende Prompts in Online-Communities aus.
OpenAIs InstructGPT-Arbeit (Ouyang et al., März 2022) stellte Modelle vor, die mit menschlichem Feedback (RLHF) feinabgestimmt wurden und natürlichsprachlichen Anweisungen weit zuverlässiger folgten als das Basis-GPT-3. Damit wurde die Prompt-Qualität noch folgenreicher. Mitte 2022 war klar, dass Prompting eine übertragbare Fähigkeit ist und nicht nur eine Marotte von Forschenden.
2022: Chain-of-Thought und Reasoning-Prompts
Die Einführung des Chain-of-Thought-Promptings (CoT) im Jahr 2022 war eine der bedeutendsten technischen Entwicklungen in der kurzen Geschichte der Disziplin. Wei et al. (Google) veröffentlichten „Chain-of-Thought Prompting Elicits Reasoning in Large Language Models“ und zeigten, dass Beispiele mit Zwischenschritten im Prompt die Leistung bei Arithmetik-, Alltagslogik- und symbolischen Aufgaben verbesserten. In einem Spitzenergebnis stieg die Genauigkeit von PaLM 540B auf dem GSM8K-Benchmark für Grundschulmathematik durch Chain-of-Thought-Prompting von 17,9 % auf 56,9 % – ein Gewinn allein durch den geänderten Prompt, ohne zusätzliches Training. Die Folgerung war weitreichend: Die Struktur des Prompts konnte anderes Denkverhalten aktivieren, nicht nur andere Fakten.
Verwandte Techniken folgten rasch. Zhou et al. führten das Least-to-Most-Prompting ein, das komplexe Probleme in eine Folge einfacherer Teilprobleme zerlegt, die nacheinander gelöst werden. Diese Ansätze machten Prompt Engineering von einer Formatierungsübung zu einem Werkzeug, mit dem sich strukturiertes Schlussfolgern aus Modellen herauskitzeln ließ, die nicht explizit darauf trainiert waren. Prompting wurde zum Gerüst für Kognition.
Den vollständigen Technikleitfaden finden Sie unter Chain-of-Thought Prompting: Lassen Sie die KI ihr Denken zeigen und Prompt Chaining: Komplexe Aufgaben in Fokussierte Schritte Zerlegen.
Ende 2022–2023: Der ChatGPT-Moment und der Berufsbezeichnung „Prompt Engineer"
Die Veröffentlichung von ChatGPT am 30. November 2022 veränderte das öffentliche Profil des Prompt Engineerings über Nacht. OpenAI-CEO Sam Altman schrieb Anfang Dezember 2022 auf Twitter, ChatGPT habe in fünf Tagen eine Million Nutzer überschritten, und eine von Reuters berichtete UBS-Analyse schätzte bis Januar 2023 rund 100 Millionen monatlich aktive Nutzer. Binnen Tagen experimentierten Millionen Menschen mit Prompts und stellten fest, dass die Ergebnisse stark von der Formulierung abhingen; Technikmedien begannen, Prompt Engineering als lohnende Fähigkeit zu behandeln.
Anfang 2023 tauchte „Prompt Engineer“ als Berufsbezeichnung auf: Eine Anthropic-Stelle als „Prompt Engineer and Librarian“ nannte eine Gehaltsspanne von 175.000–335.000 US-Dollar, wie Fortune im März 2023 berichtete. Ob Prompt Engineering ein dauerhafter Beruf oder eine Übergangsrolle war – teils Mensch-Computer-Schnittstellendesign, teils Fachexpertise, teils Qualitätssicherung –, wurde breit diskutiert.
Keine einzelne Person gilt als Urheber des Begriffs. Forschungsarbeiten beschrieben promptbasierte Methoden bereits 2021 (siehe oben), und der Ausdruck verbreitete sich nach ChatGPT stark. Der Wikipedia-Artikel zu Prompt Engineering gibt einen Überblick über die Geschichte.
🔍 Wussten Sie schon?
Eine von Reuters zitierte UBS-Analyse schätzte, dass ChatGPT im Januar 2023, etwa zwei Monate nach dem Start, rund 100 Millionen monatlich aktive Nutzer erreichte. Laut Reuters (unter Berufung auf Sensor-Tower-Daten) brauchte TikTok dafür etwa neun Monate und Instagram etwa zweieinhalb Jahre. Diese Geschwindigkeit erklärt, warum Prompt Engineering fast über Nacht vom Forschungskonzept zur Massenfähigkeit wurde.
2023: GPT-4, multimodales Prompting und Frameworks
OpenAI kündigte GPT-4 im März 2023 mit Bildeingaben zusätzlich zu Text an (zunächst als Forschungsvorschau). Das öffnete Prompt Engineering für visuelle Aufgaben wie Bilder beschreiben, Diagramme vergleichen und Grafiken kommentieren; größere Kontextfenster (128.000 Token mit GPT-4 Turbo im November 2023) folgten. Googles Gemini (Dezember 2023) und Anthropics Claude-3-Modelle mit Bildverständnis (März 2024) brachten multimodale Optionen anderer Anbieter.
In dieser Zeit wurden auch Best Practices formalisiert. OpenAI veröffentlichte seinen offiziellen Prompt-Engineering-Leitfaden. Google Cloud veröffentlichte einen eigenen Leitfaden zum Prompt Engineering. Unabhängige Autoren und Teams stellten Frameworks wie CRAFT, CO-STAR, SPECS, RISEN und TRACE vor, die wiederholbare Vorlagen für den Prompt-Aufbau lieferten und das Ausprobieren verringerten. Namen, Urheber und Veröffentlichungsdaten dieser Frameworks unterscheiden sich je nach Quelle; keines ist ein offizieller Standard.
Diese Frameworks markierten die Reifung des Prompt Engineerings von einer persönlichen Fähigkeit zu einer lehr- und teilbaren Praxis. Hilfe bei der Auswahl finden Sie unter Welches Prompt-Framework ist das richtige für Sie? (2026), die multimodale Seite unter Jenseits von Text: Wie man mit Bildern promptet.
2023–2024: Automatisiertes Prompt Engineering und RAG
Eine auffällige Entwicklung um 2023 war die Forschung, die zeigte, dass LLMs Prompts ebenso gut optimieren können wie Menschen. Zhou et al. stellten im November 2022 „Large Language Models Are Human-Level Prompt Engineers“ (APE) vor: Ein LLM erzeugte und bewertete Kandidaten-Anweisungen und erreichte oder übertraf von Menschen geschriebene Anweisungen bei 19 von 24 getesteten Aufgaben. Das DSPy-Framework von Stanford-Forschenden (Khattab et al., Oktober 2023) ging weiter: Entwickler beschreiben, was ein Prompt leisten soll, und die Formulierung wird automatisch kompiliert.
Gleichzeitig wurde Retrieval-Augmented Generation (RAG) – 2020 von Lewis et al. bei Facebook AI Research (heute Meta) vorgestellt – zu einem zentralen Muster produktiver KI-Systeme. RAG fügte abgerufene Dokumente direkt in den Prompt-Kontext ein und verankerte Antworten in echten, aktuellen Quellen, statt alle nötigen Fakten im Prompt zu verlangen. Dadurch verschob sich der Schwerpunkt von „Wie bringe ich dem Modell dieses Wissen bei?“ zu „Wie strukturiere ich den Kontext, damit das Modell ihn richtig nutzt?“
Zu den wichtigsten Techniken dieser Zeit siehe RAG erklärt: KI-Antworten in echten Daten verankern (2026) und Self-Consistency Prompting: Mehrfache Antworten generieren, Konsens auswählen.
2024–2025: Von Prompt Engineering zu Kontext-Design
In den Jahren 2024–2025 begann ein neues Leitbild, die einfache Idee „schreib einen besseren Prompt“ zu verdrängen. Context Engineering rückte in den Fokus – das gezielte Zusammenstellen des gesamten Kontextfensters: Systemprompt, abgerufene Dokumente, Tool-Ausgaben, Gesprächsverlauf und Nutzereingabe, alles bewusst komponiert, um das Modellverhalten zu steuern. Der Begriff selbst gewann im Juni 2025 an Verbreitung, als Shopify-CEO Tobi Lütke und Andrej Karpathy öffentlich „Context Engineering“ gegenüber „Prompt Engineering“ bevorzugten, wie Simon Willison am 27. Juni 2025 dokumentierte. Der Prompt war kein eigenständiges Artefakt mehr, sondern eine Schicht in einem gestalteten Kontext.
Mehrere Entwicklungen beschleunigten diesen Wandel. Metas Llama-3-Modelle (April 2024) machten leistungsfähige Open-Weights-LLMs für den privaten Betrieb verfügbar und verlagerten einen Teil des Prompt Engineerings von Cloud-APIs auf lokale Infrastruktur. Google kündigte im Februar 2024 Gemini 1.5 Pro mit einem Kontextfenster von 1 Million Token in einer begrenzten Vorschau an, sodass sich ganze Codebasen, Bücher oder Dokumentsammlungen in einen einzigen Prompt packen ließen. Multi-Agenten-Frameworks wie LangChain und AutoGen machten aus Prompting Orchestrierung: Ein Prompt löst ein weiteres Modell aus, das ein Tool aufruft, das Kontext an den nächsten Prompt zurückgibt.
2026 und darüber hinaus: Prompt Engineering als Kernkompetenz
Bis 2026 wird Prompt Engineering zunehmend nicht mehr als Nischen-Berufsbezeichnung beschrieben, sondern als Grundkompetenz für Wissensarbeiter, die KI-Werkzeuge nutzen: eine Aufgabe formulieren, den passenden Kontext liefern und das gewünschte Ausgabeformat festlegen.
Die Rolle hat sich in zwei Stränge geteilt. Der erste ist System- und Kontextdesign – die Entwicklung produktiver KI-Systeme, in denen Prompts Teil einer größeren Architektur mit Retrieval, Agenten und Evaluierungspipelines sind. Der zweite ist die alltägliche Nutzung – die Fähigkeit, klare, strukturierte Prompts zu schreiben, die ohne Kenntnis der zugrunde liegenden Architektur nützliche Ergebnisse liefern. Beide Stränge profitieren von denselben Grundprinzipien: klare Aufgabenbeschreibung, passender Kontext, Randbedingungen und Ausgabeformat.
Was sich trotz leistungsfähigerer Modelle und automatisierter Werkzeuge nicht geändert hat, ist das Grundprinzip: Je klarer und strukturierter die Eingabe, desto verlässlicher und nützlicher die Ausgabe. Techniken, Terminologie und Tooling sind gereift, aber die Kernerkenntnis aus der GPT-3-Ära gilt auch 2026.
🔍 Profi-Tipp
Der Wechsel von „Prompt Engineering“ zu „Context Design“ ist nicht nur Terminologie – er verändert, was Sie optimieren. Statt den Wortlaut Ihrer Anweisung zu verfeinern, gestalten Sie, was ins Kontextfenster gelangt: Systemprompt, abgerufene Dokumente, Gesprächsverlauf, Tool-Ausgaben und Nutzereingabe. Der Prompt ist eine Schicht, nicht das Ganze.
Zeitleiste: Wichtige Meilensteine im Prompt Engineering
Die folgende Tabelle fasst die wichtigsten Meilensteine von 2018 bis 2026 zusammen – die Ereignisse, Arbeiten und Modellveröffentlichungen, die Prompt Engineering zu seiner heutigen Form geführt haben.
2018–2019
- Meilenstein:
- BERT (Google) und GPT-2 (OpenAI) veröffentlicht
- Warum es wichtig ist:
- Zeigte, dass sich Transformer-Modelle über die Eingabeformulierung steuern lassen, aber es gab noch keine formale Disziplin
2020
- Meilenstein:
- GPT-3 und Brown et al., „Language Models are Few-Shot Learners“
- Warum es wichtig ist:
- Etablierte Few-Shot-Prompting: Ein umformulierter Prompt ändert das Modellverhalten ohne Neutraining
2022 (Jan.)
- Meilenstein:
- Chain-of-Thought-Prompting (Wei et al.)
- Warum es wichtig ist:
- Zeigte, dass die Prompt-Struktur schrittweises Schlussfolgern auslösen kann
2022 (März)
- Meilenstein:
- InstructGPT / RLHF (Ouyang et al., OpenAI)
- Warum es wichtig ist:
- Auf Befolgen von Anweisungen trainierte Modelle machten die Prompt-Qualität weit folgenreicher
2022 (Nov.)
- Meilenstein:
- Start von ChatGPT
- Warum es wichtig ist:
- Brachte Prompting zu einem Massenpublikum; Millionen begannen binnen Tagen zu experimentieren
2023 (Q1)
- Meilenstein:
- Stellen für „Prompt Engineers“ erregen Aufmerksamkeit; eine Anthropic-Stelle nennt 175.000–335.000 US-Dollar
- Warum es wichtig ist:
- Machte Prompt Engineering als möglichen Beruf sichtbar, wobei die Rolle viel diskutiert wurde
2023 (März)
- Meilenstein:
- GPT-4 mit Bildeingabe
- Warum es wichtig ist:
- Erweiterte Prompting über Text hinaus auf Bilder; 128.000 Token Kontext folgten mit GPT-4 Turbo (Nov. 2023)
2023
- Meilenstein:
- Frameworks wie CO-STAR (GovTech Singapur, 2023) und weitere veröffentlichte Vorlagen (CRAFT, SPECS, RISEN, TRACE); offizielle Leitfäden von OpenAI und Google
- Warum es wichtig ist:
- Machte aus individuellem Handwerk wiederverwendbare, lehrbare Vorlagen
2022–2023
- Meilenstein:
- APE (Zhou et al.) und DSPy (Khattab et al.): von LLMs optimierte Prompts
- Warum es wichtig ist:
- Zeigte, dass LLMs Prompts schreiben und abstimmen können; automatische Prompt-Optimierung wurde praktikabel
2024
- Meilenstein:
- Llama 3 (Apr.) und Gemini 1.5 Pro mit 1-Mio.-Token-Kontext in der Vorschau (Feb.)
- Warum es wichtig ist:
- Open-Weights-Modelle für den privaten Betrieb und sehr lange Kontexte verlagerten den Fokus auf Context Engineering
2024–2025
- Meilenstein:
- Reasoning-Modelle: OpenAI o1 (Sep. 2024), DeepSeek-R1 (Jan. 2025), Claude 3.7 Sonnet mit Extended Thinking (Feb. 2025)
- Warum es wichtig ist:
- Die Modelle denken intern Schritt für Schritt, daher ist explizites Chain-of-Thought-Prompting bei ihnen weniger wichtig
2025 (Apr.)
- Meilenstein:
- Llama 4 (Mixture-of-Experts); Llama 4 Scout unterstützt 10 Mio. Token Kontext
- Warum es wichtig ist:
- Open-Weights-Modelle übernehmen Mixture-of-Experts-Architekturen und sehr lange Kontexte
2026
- Meilenstein:
- Context Design und Agenten-Orchestrierung werden Standardpraxis
- Warum es wichtig ist:
- Prompting ist eine Schicht in einem komponierten Kontext; Denken auf Systemebene wird erwartet
Wie die Geschichte die heutigen Best Practices prägt
Jede Phase der Evolution des Prompt Engineerings hinterließ einen dauerhaften Niederschlag in der aktuellen Praxis. Die GPT-3-Ära gab uns die Kernerkenntnis, dass das Modellverhalten durch Eingabestruktur geprägt wird – nicht nur durch Inhalt. Die Chain-of-Thought-Ära gab uns explizite Denkgerüste: schrittweises Prompting, Prompt-Verkettung und Tree-of-Thought-Ansätze. Die Framework-Ära gab uns wiederverwendbare Vorlagen, die Best Practices kodifizieren, ohne dass jeder Praktiker sie von Grund auf neu entdecken muss.
Die RAG- und Kontext-Design-Ära gab uns das Verständnis, dass Prompts nicht isoliert existieren – sie werden mit abgerufenen Daten, Systemanweisungen und Werkzeugausgaben zusammengestellt, um einen vollständigen Kontext zu bilden. Und die automatisierte Prompting-Ära erinnerte uns daran, dass die Prinzipien guten Promptings messbar sind: besser strukturierte Prompts liefern bessere Ausgaben auf eine Weise, die systematisch bewertet und optimiert werden kann.
- Denktechniken aus 2022 → Chain-of-Thought Prompting: Lassen Sie die KI ihr Denken zeigen und Tree of Thought & ReAct: Fortgeschrittene Reasoning-Techniken für komplexe Probleme
- Framework-Entwicklung aus 2023 → Welches Prompt-Framework ist das richtige für Sie? (2026)
- Wachstum des Kontextfensters → Kontextfenster erklärt: Warum KI vergisst (und was Sie tun können)
- Token-Ökonomie über Modellgenerationen hinweg → Token, Kosten & Limits: Die Ökonomie des KI-Prompting
- RAG als Ergänzung zum reinen Prompting → RAG erklärt: KI-Antworten in echten Daten verankern (2026)
FAQ: Die Evolution des Prompt Engineerings
Seit wann gibt es Prompt Engineering?
Die Praxis begann mit GPT-3 im Mai 2020, als Brown et al. zeigten, dass Beispiele im Prompt ein Modell ohne Neutraining steuern können. Anfang 2021 beschrieben Forschende dies als „Prompt Programming“, im Januar 2022 folgte Chain-of-Thought-Prompting, und ChatGPT (November 2022) machte es zur Massenfähigkeit.
Wer prägte als Erster den Begriff „Prompt Engineering"?
Der genaue Ursprung ist umstritten, und keine einzelne Person gilt als Erfinder des Begriffs. Forschungsarbeiten beschrieben promptbasierte Methoden bereits 2021, und der Ausdruck wurde 2022 und nach ChatGPT breiter verwendet. Der Wikipedia-Artikel zu Prompt Engineering gibt einen Überblick über die Geschichte.
Warum explodierte Prompt Engineering in der Popularität nach ChatGPT?
ChatGPT war eines der ersten Allzweck-KI-Modelle, die Millionen von Nicht-Forschern sofort, kostenlos, ohne Code schreiben zu müssen, nutzen konnten. Die Lücke zwischen einem gut gestalteten Prompt und einem vagen war sichtbar und sofort folgenreich – bessere Prompts lieferten spürbar bessere Ausgaben. Diese Rückkopplungsschleife, die von Millionen von Menschen gleichzeitig erlebt wurde, verwandelte Prompt Engineering von einem Forschungskonzept in eine Massenfähigkeit.
Wie beeinflussten Forschungsarbeiten reale Prompting-Techniken?
Die Übertragung war für KI-Forschung ungewöhnlich schnell. Chain-of-Thought-Prompting (Wei et al., 2022) entwickelte sich innerhalb von Monaten von einem akademischen Paper zu einer weit verbreiteten Praktikertechnik, teilweise weil es kein Tooling erforderte – nur eine Änderung in der Art, wie man den Prompt schrieb. Few-Shot-Prompting aus dem GPT-3-Paper (Brown et al., 2020) war sofort von jedem mit API-Zugang adaptierbar. Die Zugänglichkeit der Techniken beschleunigte ihre Verbreitung.
Wird Prompt Engineering weniger wichtig, wenn Modelle sich verbessern?
Nein – leistungsfähigere Modelle reagieren besser auf gut strukturierte Prompts, nicht weniger. Der Gewinn aus gutem Prompting steigt, wenn das Modell präzisen Anweisungen besser folgen kann. Was sich verändert hat, ist das Niveau des Prompt Engineerings, das für einfache Aufgaben erforderlich ist: Gesprächsfragen erfordern jetzt weniger Ausarbeitung als 2021. Aber für komplexe, produktionsreife Ausgaben ist strukturiertes Prompting in der Regel einer der wirksamsten Hebel, neben Retrieval, Modellwahl und Fine-Tuning.
Was ist der Unterschied zwischen Prompt Engineering und Kontext-Engineering?
Prompt Engineering bezieht sich typischerweise auf das Gestalten der Texteingabe für ein Modell, um seine Ausgabe zu verbessern. Kontext-Engineering ist ein breiteres, neueres Konzept, das sich auf das Orchestrieren von allem im Kontextfenster des Modells bezieht: den System-Prompt, abgerufene Dokumente, Gesprächsverlauf, Werkzeugausgaben und Benutzereingaben – alle bewusst zusammengestellt. Kontext-Engineering behandelt den Prompt als eine Komponente in einem gestalteten System, nicht als eigenständiges Artefakt.
Werden automatisierte Werkzeuge die Notwendigkeit eliminieren, Prompt Engineering zu verstehen?
Automatisierte Werkzeuge wie DSPy können Prompt-Formulierungen innerhalb definierter Ziele optimieren, erfordern jedoch, dass ein Mensch festlegt, was das Ziel ist, welche Einschränkungen gelten und wie Erfolg bewertet wird. Das Verständnis von Prompt-Engineering-Prinzipien bleibt notwendig, um diese Werkzeuge effektiv einzusetzen – und um zu diagnostizieren, wenn sie das falsche Ergebnis liefern. Automatisierung beseitigt einen Teil der manuellen Iteration; sie beseitigt nicht die Notwendigkeit strukturierten Denkens.
Ist Prompt Engineering im Jahr 2026 tot?
Nein. Die Disziplin hat sich verschoben, nicht aufgelöst. Je leistungsfähiger die Modelle werden, desto mehr verlagert sich die Arbeit von Syntax-Tricks und Formatierungskniffen zum Context Design – Eingaben strukturieren, Retrieval steuern und Tool-Ausgaben zusammenführen. Die Berufsbezeichnung „Prompt Engineer“ wird enger, doch die zugrunde liegende Fähigkeit steckt in jeder Rolle, die KI nutzt: Entwickler, Analysten, Marketer, Forschende. Klare Aufgabenstellung, passender Kontext und ein festgelegtes Ausgabeformat bestimmen weiterhin, wie nützlich die Antwort eines Modells ist.
Muss ich Prompt Engineering lernen, wenn KI-Modelle immer besser werden?
Ja – aber der Fokus verschiebt sich mit jeder Generation. Bessere Modelle reduzieren den Bedarf an aufwändigen Workarounds und erhöhen den Nutzen klarer Absicht, strukturierten Kontexts und gut gewählter Beispiele. Die Grundlagen – Rolle, Kontext, Format, Einschränkungen – bleiben über jede Modellgeneration hinweg stabil. Wer sie jetzt lernt, akkumuliert eine Fähigkeit, die sich aufbaut statt zu verfallen.
Was ist der Unterschied zwischen Prompt Engineering und Fine-Tuning?
Prompt Engineering ändert, wie man mit einem Modell kommuniziert, ohne seine Gewichte zu verändern. Fine-Tuning trainiert ein Modell auf neuen Daten und ändert sein Verhalten dauerhaft. Prompt Engineering ist schneller, günstiger und reversibel – Iteration in Minuten ist möglich. Fine-Tuning ist besser, wenn das Zielverhalten konsistent, hochvolumig oder im Prompt nicht zuverlässig beschreibbar ist. Die meisten Teams beginnen mit Prompting und wechseln zum Fine-Tuning erst, wenn Prompting an seine Grenzen stößt.
Häufige Missverständnisse über Prompt Engineering
❌ Prompt Engineering bedeutet nur, bessere Sätze zu schreiben.
Why it hurts: Das übersieht die strukturellen und kontextuellen Dimensionen. Die Wirkung eines Prompts hängt nicht nur von der Wortwahl ab, sondern von Rollenzuweisung (dem Modell eine Persona geben), Randbedingungen, Ausgabeformat und Beispielauswahl – lauter strukturelle Elemente, die mit Grammatik nichts zu tun haben.
Fix: Betrachten Sie Prompt Engineering als Gestaltung eines Systems, dessen Schnittstelle der Prompt ist. Investieren Sie in Struktur: Rollen zuweisen („Du bist ein …“, „Gehe davon aus …“), Randbedingungen festlegen („Nicht …“, „Muss enthalten …“), das Ausgabeformat definieren und Beispiele liefern. Struktur zählt oft mehr als Eloquenz.
❌ Bessere Modelle machen Prompt Engineering überflüssig.
Why it hurts: Ein leistungsfähigeres Modell ist wie ein fähigerer Mitarbeiter – es reagiert *besser* auf klare Anweisungen, nicht schlechter. Der Nutzen guter Prompts kann mit der Modellfähigkeit wachsen. Es ändert sich die *Art* des nötigen Promptings, nicht ob es nötig ist.
Fix: Gehen Sie davon aus, dass Prompting für die KI-Arbeit zentral bleibt. Es ändert sich, wie viel Detail und Gerüst nötig sind. Bei schwächeren Modellen braucht es womöglich explizite Schrittstrukturen, bei stärkeren genügt eine klare Zeile – doch auch diese Direktheit ist eine Prompt-Engineering-Entscheidung.
❌ Automatische Prompt-Optimierung ersetzt menschliches Prompt Engineering.
Why it hurts: Werkzeuge wie DSPy helfen, Formulierungen innerhalb definierter Ziele zu optimieren, doch ein Mensch muss weiterhin Ziel, Randbedingungen, Erfolgskriterien und Evaluierungsmethode festlegen. Automatisierung nimmt Iterationsarbeit ab; sie ersetzt nicht das strukturierte Nachdenken darüber, was das Modell tun soll.
Fix: Nutzen Sie Automatisierung als Werkzeug, nicht als Ersatz. Beginnen Sie mit einem gut strukturierten Prompt von jemandem, der die Aufgabe versteht, und verfeinern Sie ihn mit Werkzeugen wie DSPy. Das menschliche Urteil über die Aufgabenstruktur bleibt unersetzlich.
Quellen
- Brown, T. et al. (2020). "Language Models are Few-Shot Learners." arXiv:2005.14165 — GPT-3-Arbeit von OpenAI, die Few-Shot-Prompting als Paradigma einführte.
- Wei, J. et al. (2022). "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models." arXiv:2201.11903 — Prompts mit Zwischenschritten; Quelle für das GSM8K-Ergebnis von 17,9 % auf 56,9 %.
- Ouyang, L. et al. (2022). "Training language models to follow instructions with human feedback." arXiv:2203.02155 — InstructGPT: Anweisungsbefolgung durch menschliches Feedback (RLHF).
- Zhou, Y. et al. (2022). "Large Language Models Are Human-Level Prompt Engineers." arXiv:2211.01910 — APE: LLMs erzeugen und bewerten Prompts.
- Zhou, D. et al. (2022). "Least-to-Most Prompting Enables Complex Reasoning in Large Language Models." arXiv:2205.10625 — Least-to-Most-Prompting: Probleme in Teilprobleme zerlegen.
- Lewis, P. et al. (2020). "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks." arXiv:2005.11401 — Arbeit, die Retrieval-Augmented Generation (RAG) einführte.
- Reynolds, L. and McDonell, K. (2021). "Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm." arXiv:2102.07350 — Frühe Arbeit, die das Schreiben von Prompts als Programmieren beschreibt (2021).
- Liu, P. et al. (2021). "Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing." arXiv:2107.13586 — Überblick über Prompting-Methoden in der Sprachverarbeitung (2021).
- Khattab, O. et al. (2023). "DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines." arXiv:2310.03714 — DSPy: Framework, das Prompts automatisch kompiliert.
- Meta AI (2025). Llama 4 announcement — Meta, Ankündigung von Llama 4 (5. April 2025): Mixture-of-Experts, Scout mit 10 Mio. Token Kontext.
- Anthropic (2025). Claude 3.7 Sonnet announcement — Anthropic, Ankündigung von Claude 3.7 Sonnet (24. Februar 2025): Extended-Thinking-Modus.
- Google (2024). Gemini 1.5 announcement — Google, Ankündigung von Gemini 1.5 (15. Februar 2024): 1 Mio. Token Kontext in begrenzter Vorschau.
- DeepSeek-AI (2025). "DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning." arXiv:2501.12948 — DeepSeek-R1: Reasoning durch Reinforcement Learning (Januar 2025).
- Fortune (2023). Report on new AI jobs, 9 March 2023 — Fortune (9. März 2023): Bericht über die Gehaltsspanne der Anthropic-Stelle für Prompt Engineers.
- Reuters (2023). "ChatGPT sets record for fastest-growing user base - analyst note", syndicated by The Star, 2 February 2023 — UBS-Schätzung von rund 100 Millionen monatlich aktiven Nutzern im Januar 2023; der Vergleich mit TikTok und Instagram wird Sensor Tower zugeschrieben.
- Tech Startups (2022). "ChatGPT crosses 1 million users five days after launch", 5 December 2022 — Nachrichtenbericht, der den Beitrag von Sam Altman vom 5. Dezember 2022 zitiert: „ChatGPT launched on wednesday. today it crossed 1 million users!“