Datos rápidos
- Protocolo: JSON-RPC 2.0 sobre stdio (subproceso local) o Streamable HTTP (remoto). El antiguo transporte HTTP+SSE está obsoleto. Los agentes locales usan casi exclusivamente stdio. La revisión actual de la especificación es la 2026-07-28.
- Origen: creado por Anthropic como especificación abierta (modelcontextprotocol.io). En
modelcontextprotocol/serverssolo se mantienen unos pocos servidores de referencia (filesystem, git, fetch, memory y otros); SQLite, PostgreSQL, Puppeteer y GitHub pasaron aservers-archived. Ahora cada proveedor publica sus propios servidores. - Clientes locales: Goose (código abierto, repositorio
aaif-goose/goose), Cline (extensión de VS Code), Continue.dev (VS Code/JetBrains), LM Studio (aplicación de escritorio), más varias herramientas CLI. - Modelos Ollama compatibles: cualquier modelo con entrenamiento nativo de tool calling, por ejemplo Gemma 4 31B, GLM-4.7 Flash, Qwen3.6 27B, Qwen3 32B, Qwen3-Coder 30B, Llama 3.3 70B.
- Transporte por defecto de los servidores: stdio para procesos locales; Streamable HTTP solo cuando necesitas compartir un servidor entre máquinas o agentes.
- La configuración vive en el cliente: Goose lee un bloque
extensionsen~/.config/goose/config.yaml(ogoose configure); Cline y Continue.dev tienen sus propios ajustes de MCP. Los campos son la misma idea en todos: nombre del servidor, comando, args, variables de entorno. - No se necesita Claude Desktop. El protocolo es abierto e independiente de Claude Desktop; los servidores usados aquí son de código abierto (revisa cada licencia) y funcionan con cualquier cliente compatible.
Lo que MCP realmente desbloquea para un modelo local
Un LLM local sin herramientas solo puede responder con texto. Con MCP, el mismo modelo puede actuar en tu máquina. El cambio es la diferencia entre un chatbot y un agente.
- "Encuentra todos los TODO en este repositorio, agrúpalos por archivo y escribe un resumen en Markdown en
notes/todos.md." — el servidorfilesystemlee, el modelo agrupa, el mismo servidor escribe. Un único viaje de ida y vuelta de principio a fin. - "Muéstrame los 10 mejores clientes por ingresos este trimestre y haz un gráfico." — el servidor
postgresejecuta el SQL (rol de solo lectura), el modelo resume y escribe un CSV mediantefilesystempara tu herramienta de gráficos. - "Abre la portada de Hacker News, encuentra las tres principales historias de IA, resúmelas y añádelas a mi lista de lectura." — el servidor
playwrightcontrola un navegador, el modelo extrae y resume,filesystemañade. - "Abre un PR draft con el título
chore: bump depscontra mi fork y enlaza la ejecución de CI fallida." — el servidorgithubcrea el PR, obtiene la ejecución y escribe el enlace en la descripción. - "Mira las últimas 100 filas de
events.dby dime qué IDs de usuario son responsables del nuevo pico de errores." — un servidor de base de datos consulta una copia de los datos; el modelo razona; lees la respuesta en el panel de chat. - Cada uno de estos es un flujo de trabajo de frase a acción que antes requería un modelo en la nube con herramientas alojadas o un script escrito a mano. MCP es la capa que te permite reutilizar los mismos servidores entre clientes y el mismo modelo entre servidores.
Comparativa de los cuatro servidores MCP más usados
Los servidores a continuación cubren el largo recorrido de "quiero que mi modelo local haga algo de verdad". Todos son de código abierto y se ejecutan como subprocesos locales (o un contenedor Docker) iniciados por tu cliente MCP. Comprueba el estado de mantenimiento antes de instalar uno.
📍 En una frase
Empieza con el servidor filesystem (5 minutos, bajo riesgo), añade un servidor de base de datos para trabajo con datos, agrega un servidor de navegador solo cuando lo necesites y trae GitHub una vez que confíes en el modelo en tu máquina.
💬 En términos simples
Cuatro servidores cubren la mayor parte de lo que querrás que haga un agente local. El servidor filesystem lee y escribe archivos en una carpeta que tú eliges. Un servidor de base de datos ejecuta consultas contra Postgres. El servidor de navegador controla una ventana real de navegador para que el modelo pueda leer páginas que requieren JavaScript. El servidor GitHub abre issues y PRs en tus repositorios. La mayoría se inicia con un comando (npx, uvx o Docker) y se ejecuta en tu propia máquina, y ninguno llama a internet a menos que lo necesite: el navegador y GitHub sí lo hacen, filesystem y base de datos no.
Servidor MCP | Qué habilita | Dificultad de configuración | Nivel de riesgo | Ideal para |
|---|---|---|---|---|
| Filesystem (referencia) | Leer y escribir archivos dentro de un directorio aislado | Fácil (una ruta en la allow-list) | Medio — limita el alcance con cuidado | Automatización personal, toma de notas, resumen de repositorios |
| SQLite (archivado) | Consultar un archivo de base de datos SQLite local | Fácil, pero ya sin mantenimiento | Medio — sin correcciones, usa una copia del archivo | Solo exploración de datos desechables |
| Postgres (postgres-mcp) | Consultar Postgres en modo restringido (solo lectura) | Medio (rol + URI) | Medio — modo restringido y rol de solo lectura | Exploración de datos, reportes, prototipos BI |
| Playwright (@playwright/mcp) | Controlar un navegador mediante snapshots de accesibilidad para navegación, scraping, rellenado de formularios | Medio (binarios del navegador, latencia) | Alto — puede enviar formularios, hacer clic en cualquier cosa | Investigación, scraping, pruebas de regresión |
| GitHub (oficial) | Listar repositorios, leer archivos, abrir issues y PRs | Medio (Docker + PAT en variable de entorno) | Medio — limita el token a repositorios específicos | Flujos de trabajo de desarrollo, triage, borradores de PR |
| Custom | Cualquier cosa que puedas expresar como herramientas JSON-RPC | Difícil (escribe tu propio servidor) | Variable | APIs internas, sistemas de nicho, código de integración |
⚠️Advertencia: Los servidores de referencia de SQLite, PostgreSQL, Puppeteer y GitHub se movieron al repositorio servers-archived y ya no se mantienen. Los paquetes npm de PostgreSQL, Puppeteer y GitHub figuran como "no longer supported", y el servidor de SQLite (un paquete de Python, última versión en abril de 2025) tampoco recibe correcciones. Usa los servidores mantenidos de esta tabla y lee el código de cualquier servidor que necesite credenciales.
Cómo encajan las piezas
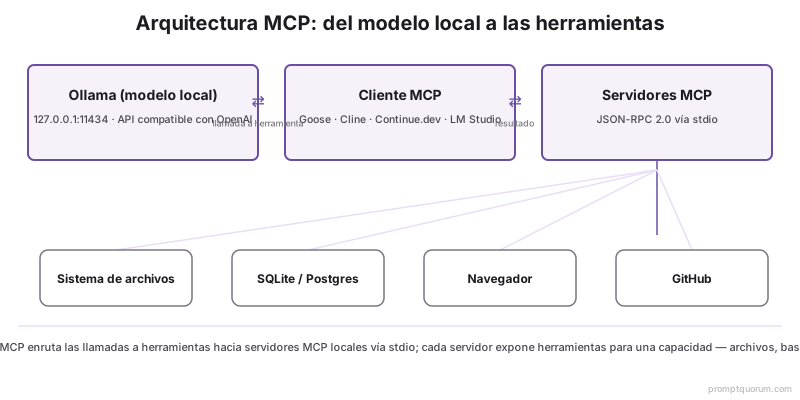
Tres procesos, un protocolo compartido. El modelo vive en Ollama, el cliente habla MCP y cada servidor expone un pequeño conjunto de herramientas. Cada tool call salta del cliente al servidor, se ejecuta localmente y devuelve JSON.
- Ollama se ejecuta como servicio en segundo plano en
127.0.0.1:11434y sirve el modelo a través de una API compatible con OpenAI. No sabe qué es MCP — simplemente responde a las completaciones de chat y emite tool calls cuando el modelo los solicita. - El cliente MCP (Goose, Cline, Continue.dev, LM Studio) es el puente. Habla con Ollama para el modelo y con los servidores MCP para las herramientas. Cuando el modelo emite un tool call, el cliente lo enruta al servidor correcto, obtiene el resultado y lo devuelve a la conversación.
- Los servidores MCP son subprocesos independientes, uno por capacidad. Hablan JSON-RPC 2.0 sobre stdio. Cada servidor anuncia una lista de Tools, Resources y Prompts; el cliente los combina en la superficie de herramientas que se presenta al modelo.
- El transporte stdio mantiene todo en local. El servidor es iniciado por el cliente, se comunica a través de su stdin/stdout y termina cuando el cliente termina. Nada va por la red a menos que el servidor mismo abra una conexión (el servidor de navegador sí lo hace; los servidores de filesystem y base de datos no).
- El modelo ve una lista plana de herramientas. Desde la perspectiva del modelo no hay servidores — solo una lista de nombres de herramientas como
filesystem.read_file,playwright.browser_navigate,github.create_pull_request. El cliente gestiona el enrutamiento.
📌Nota: La arquitectura es idéntica a la de Claude Desktop. Las diferencias son el modelo (un modelo Ollama local en lugar de Claude) y el cliente (Goose/Cline/Continue.dev/LM Studio en lugar de Claude Desktop). Los servidores MCP son los mismos servidores — puedes ejecutar el servidor filesystem bajo Claude Desktop hoy y seguirá funcionando sin cambios bajo Goose mañana.
Configuración: Ollama + Goose en 15 minutos
Goose es el camino más sencillo hacia un agente MCP local funcional. Es un agente de código abierto (originario de Block, hoy desarrollado en aaif-goose/goose) con un CLI y soporte nativo de Ollama, una interfaz de chat interactiva y un único archivo de configuración para todos tus servidores Model Context Protocol (MCP). Continue.dev, Cline y LM Studio también funcionan — Goose tiene el menor coste de configuración para una primera ejecución.
- Paso 1 — instala Ollama. Descárgalo desde ollama.com/download (macOS/Windows/Linux). Confirma que el servicio está corriendo con
curl http://127.0.0.1:11434/api/tags. - Paso 2 — descarga un modelo con tool calling. Elige entre Gemma 4 31B (
gemma4:31b), GLM-4.7 Flash (glm-4.7-flash), Qwen3.6 27B (qwen3.6:27b), Qwen3 32B (qwen3:32b) o Llama 3.3 70B (llama3.3:70b). 32 GB de memoria unificada o 24 GB de VRAM manejan cómodamente 26B–32B en Q4_K_M. - Paso 3 — instala Goose. En macOS o Linux ejecuta
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash(obrew install block-goose-cli). En Windows usa el instalador de PowerShell de la documentación de Goose, o WSL. El CLI se instala comogoose. - Paso 4 — configura Ollama como proveedor. Ejecuta
goose configure, eligeollamacomo proveedor, establece el modelo al que descargaste y el host enhttp://127.0.0.1:11434(en blanco también equivale a localhost:11434). Goose escribe esto en~/.config/goose/config.yaml. La ventana de contexto predeterminada de Ollama puede ser pequeña (la documentación de Goose menciona 4096 tokens), lo que puede hacer que Goose ignore sus extensiones — inicia Ollama conOLLAMA_CONTEXT_LENGTH=32768(o más). - Paso 5 — añade el servidor MCP de filesystem. Ejecuta
goose configure, elige Add Extension y luego Command-line Extension, o añade un bloqueextensionsa~/.config/goose/config.yaml(ejemplo a continuación). Para una prueba puntual,goose session --with-extension "npx -y @modelcontextprotocol/server-filesystem /path/to/workspace"lo activa solo para esa sesión. Iniciagoose sessiony pídele que liste los archivos en tu directorio de prueba. El primer turno confirma que el servidor está conectado. - Paso 6 — verifica con una tarea real. Prueba
goose sessiony pide "Haz una lista de cada archivo Markdown ennotes/, con título y número de palabras, y escribe el resultado ennotes/index.md." Si el agente lee, resume y escribe de vuelta, el bucle funciona.
# 1. Pull a tool-calling model
ollama pull gemma4:31b

# 2. Install Goose (macOS / Linux)
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash

# 3. Configure Ollama as the provider
goose configure
# Provider: ollama
# Model:    gemma4:31b
# Host:     http://127.0.0.1:11434

# 4. Give Ollama a context window big enough for tool use, then start a session
OLLAMA_CONTEXT_LENGTH=32768 ollama serve   # in a separate terminal
goose session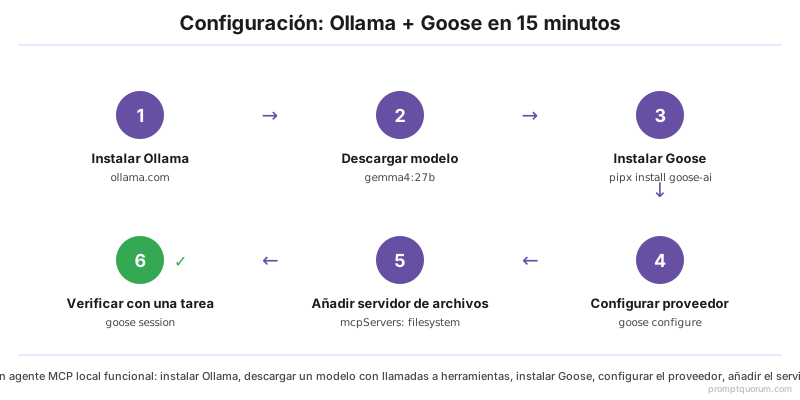
💡Consejo: Si ya usas Cline o Continue.dev, omite Goose y úsalos — ambos son clientes MCP. Cada uno tiene sus propios ajustes de MCP (consulta su documentación para el archivo exacto); el modelo y los servidores son los mismos, solo cambian la aplicación host y el formato de su configuración.
Servidor Filesystem: leer y escribir en un directorio aislado
El servidor filesystem es el primero en instalar y el más fácil de limitar de forma segura. Expone read_file, write_file, list_directory, move_file, search_files y create_directory — todo restringido a una o más rutas en la allow-list.
- Instalación: el servidor de referencia es
@modelcontextprotocol/server-filesystem, ejecutado mediantenpx -y(sin instalación global; requiere Node.js). Es uno de los servidores de referencia que siguen mantenidos. Goose, Cline y Continue.dev lo inician desde su configuración. - Rutas en la allow-list: el servidor acepta uno o más argumentos de directorio y rechaza operaciones fuera de ellos. Siempre pasa una ruta explícita y estrecha — nunca
~ni/. - Herramientas expuestas:
read_file,read_multiple_files,write_file,edit_file(reemplazos por línea),list_directory,search_files,move_file,create_directory,directory_tree. El modelo las ve comofilesystem.read_filey así sucesivamente. - Comodidad de uso:
directory_treedevuelve un árbol JSON; ideal para que el modelo se oriente antes de leer archivos específicos.search_fileshace una búsqueda recursiva similar a grep. - Superficie de riesgo: el servidor respeta la allow-list, pero dentro de ella tiene lectura/escritura completa. Trata la allow-list como la única barrera y elige un directorio workspace dedicado en lugar de tu carpeta home.
# ~/.config/goose/config.yaml
extensions:
  filesystem:
    type: stdio
    name: filesystem
    enabled: true
    cmd: npx
    args: ["-y", "@modelcontextprotocol/server-filesystem", "/Users/you/agent-workspace"]
    envs: {}
timeout: 300⚠️Advertencia: Nunca pongas / ni tu directorio home en la allow-list. Crea una carpeta agent-workspace dedicada, pon copias de los archivos que quieres que el agente toque y deja que opere solo dentro de esa carpeta. Si el agente falla, el radio de explosión se detiene en un directorio.
Servidores de base de datos: consultar Postgres (y SQLite) con seguridad
Un servidor de base de datos convierte al modelo en un analista junior que puede responder preguntas respaldadas por datos reales — siempre que lo mantengas en solo lectura. Los servidores de referencia originales de SQLite y PostgreSQL están archivados, así que usa un servidor de Postgres mantenido y trata SQLite con cuidado.
- Postgres:
postgres-mcp(Crystal DBA, licencia MIT) es la opción con modo de solo lectura (la última versión en PyPI es de mayo de 2025, así que comprueba la actividad del repositorio antes de depender de él). Ejecútalo conuvx postgres-mcp --access-mode=restricted(opipx install postgres-mcp, o su imagen Docker) y pasa la URI de conexión en la variable de entornoDATABASE_URI. El modo restringido permite transacciones de solo lectura y un límite de tiempo por consulta; el modo sin restricciones es solo para desarrollo. - Usa además un rol de solo lectura dedicado. El modo restringido es una barrera, el rol de la base de datos es otra. Crea un rol
agent_rocon permisos solo de SELECT y usa la cadena de conexión de ese rol. - SQLite: el servidor de referencia está archivado. Es el paquete de Python
mcp-server-sqlite(no un paquete npm; última versión en abril de 2025); puede que aún funcione, pero no recibe correcciones. Apúntalo solo a una copia del archivo, nunca a tu única copia, o carga los datos en Postgres. Lee el código de cualquier servidor SQLite de la comunidad antes de darle un archivo. - Conciencia del esquema: pide al agente que "liste las tablas y describa las cinco más usadas" antes de hacer preguntas analíticas — el modelo es mucho más preciso cuando ha inspeccionado el esquema que cuando adivina los nombres de columnas.
- Costo: las consultas van directamente a tu base de datos. Un
SELECT *mal formado de una tabla de 100M de filas es el mismo accidente aquí que lo sería de un humano — mantén el rol en un pool de conexiones separado con un statement timeout.
# ~/.config/goose/config.yaml
extensions:
  postgres:
    type: stdio
    name: postgres
    enabled: true
    cmd: uvx
    args: ["postgres-mcp", "--access-mode=restricted"]
    envs:
      DATABASE_URI: "postgresql://agent_ro:${PG_AGENT_PASSWORD}@127.0.0.1:5432/analytics"
timeout: 300💡Consejo: Crea el rol de Postgres una vez y no le des nada más al agente: CREATE ROLE agent_ro WITH LOGIN PASSWORD '…'; GRANT CONNECT ON DATABASE analytics TO agent_ro; GRANT USAGE ON SCHEMA public TO agent_ro; GRANT SELECT ON ALL TABLES IN SCHEMA public TO agent_ro; ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO agent_ro; Luego añade statement_timeout = 30s al rol. El agente no puede escribir, no puede eliminar y no puede ejecutarse indefinidamente.
Servidor de navegador: controlar un navegador con Playwright MCP
El servidor de navegador es el más potente y el más peligroso de los cuatro. Lanza un navegador real y expone navegación, clics, relleno de formularios y capturas de pantalla — es decir, puede hacer todo lo que tú puedes hacer en un navegador, incluyendo enviar formularios.
- Qué servidor usar: el
@playwright/mcpde Microsoft (npx @playwright/mcp@latest). El antiguo@modelcontextprotocol/server-puppeteerfigura como "no longer supported", y en npm no existe ningún paquete@modelcontextprotocol/server-playwright. - Herramientas expuestas:
browser_navigate,browser_snapshot,browser_click,browser_type,browser_fill_form,browser_evaluate(ejecutar JavaScript),browser_take_screenshot,browser_tabs,browser_wait_for. El modelo lee la página conbrowser_snapshot(un snapshot de accesibilidad, que Playwright MCP recomienda frente a las capturas para ejecutar acciones) y usa las capturas de pantalla solo para mirar. - Latencia: las sesiones de navegador reales tardan entre 1 y 5 segundos por acción. Una navegación de varios pasos puede consumir fácilmente entre 30 y 60 segundos y decenas de miles de tokens porque el contenido de las páginas es grande. Usa una ventana de contexto de 32K+.
- Referencias de elementos: el modelo hace clic en los elementos mediante las referencias del snapshot. Los modelos más pequeños se equivocan con frecuencia; un modelo de 27B+ con tool calling maneja los patrones comunes de forma fiable. Mantén las tareas acotadas — "extrae el título y el primer párrafo de esta URL" es mucho más fiable que "navega por el sitio y encuentra la página de contacto".
- Los casos de uso correctos: investigación (abrir la página, resumirla, añadir a notas), pruebas de regresión (navegar, hacer clic, captura de pantalla) y relleno de formularios en páginas que tú controlas. Los casos incorrectos: cualquier cosa donde un clic erróneo en la web en vivo tenga consecuencias.
# ~/.config/goose/config.yaml
extensions:
  playwright:
    type: stdio
    name: playwright
    enabled: true
    cmd: npx
    args: ["@playwright/mcp@latest"]
    envs: {}
    timeout: 300
# Block obviously dangerous endpoints at the OS firewall level
# rather than relying on the agent to refuse them.⚠️Advertencia: Nunca des credenciales al servidor de navegador. Si necesitas una sesión autenticada, pasa al agente un perfil de navegador pre-autenticado y nunca lo dejes navegar a sitios de alto impacto (banca, correo electrónico, consolas en la nube, formularios de pago). El modelo no tiene criterio sobre lo que hace un botón — ve texto y hace clic. Trátalo como un becario sin contexto y sin recurso.
Servidor GitHub: repositorios, issues y PRs desde un modelo local
El servidor GitHub convierte el trabajo en lenguaje natural sobre repositorios en llamadas a la API. Es el más sencillo de los cuatro de configurar y el más fácil de limitar mediante los permisos del personal access token (PAT).
- Instalación: usa el
github/github-mcp-serveroficial de GitHub, ejecutado desde su imagen Docker (ghcr.io/github/github-mcp-server) con un PAT en la variable de entornoGITHUB_PERSONAL_ACCESS_TOKEN. El antiguo paquete npm@modelcontextprotocol/server-githubfigura como "no longer supported"; no lo uses en instalaciones nuevas. - Herramientas expuestas:
search_repositories,get_file_contents,create_or_update_file,create_pull_request,list_issues,create_issue,add_issue_comment,merge_pull_request, más muchas otras. La superficie completa es grande; la mayoría de las tareas usan entre 5 y 10 herramientas. - Limita el alcance del PAT. Usa un PAT de grano fino limitado a repositorios específicos con los permisos mínimos necesarios (Read para navegar, Write para crear PRs/issues). No uses un PAT clásico con
repopara un agente experimental. - Flujos de trabajo reales: triage ("lee los últimos 20 issues abiertos, agrúpalos, propón etiquetas"), borradores ("lee el README y abre un PR corrigiendo erratas"), reportes ("qué PRs están inactivos esta semana").
- Superficie de riesgo: el agente puede crear issues y PRs, comentarlos y (con permisos de escritura) hacer push de commits. Deshabilita las herramientas de merge a menos que confíes tanto en el modelo como en el flujo de trabajo — un merge accidental en un repositorio con PAT de grano fino es recuperable, pero solo si lo notas rápido.
# ~/.config/goose/config.yaml
extensions:
  github:
    type: stdio
    name: github
    enabled: true
    cmd: docker
    args: ["run", "-i", "--rm", "-e", "GITHUB_PERSONAL_ACCESS_TOKEN", "ghcr.io/github/github-mcp-server"]
    envs:
      GITHUB_PERSONAL_ACCESS_TOKEN: "${GH_AGENT_PAT}"
    timeout: 300
# Fine-grained PAT scoped to one or two test repos,
# not your personal account-wide classic token.
Un modelo de seguridad que no confía en el modelo
El modelo mental correcto es "el LLM es un becario sin confianza con las llaves que tú le das". Las capacidades vienen de los servidores y las superficies que incluyes en la allow-list — no del criterio del modelo.
- Limita el servidor filesystem a un directorio. Nunca
~ni/. Elige una carpetaagent-workspace/y pon copias de los archivos que el agente necesita tocar. Si el agente falla, el peor caso es una carpeta. - Ejecuta los servidores de base de datos en solo lectura por defecto. Un rol
agent_rodedicado con permisos solo deSELECTy un statement timeout de 30 segundos elimina toda una clase de incidentes. - Coloca cada herramienta de escritura o shell detrás de una aprobación explícita. Goose, Cline y Continue.dev admiten reglas de aprobación por herramienta. Permite las herramientas de lectura por defecto; requiere aprobación para
write_file,edit_file,execute_command,create_pull_requesty cualquier acción del navegador que envíe formularios. - Usa el registro de auditoría. Cada cliente MCP registra las tool calls y los resultados. Después de una sesión larga, revisa el registro: detectarás al modelo intentando cosas que no esperabas (a veces inofensivas, a veces justificando ajustar los permisos).
- Limita el acceso de terceros con tokens de alcance estrecho. PATs de GitHub limitados a dos repositorios de prueba. Roles de Postgres de solo lectura. Sesiones de navegador sin credenciales. El modelo eventualmente intentará cosas que no anticipaste; los límites de lo que puede hacer no deben depender de que el modelo lo haga bien.
- Aísla al agente para trabajo con datos sensibles. Deshabilita el acceso a la red en el host mientras se ejecuta el agente (o usa un namespace de red) cuando trabajes con datos privados. El stack local ya no envía nada fuera de la máquina, pero la defensa en profundidad detecta errores en servidores de terceros.
- Trata la selección de servidores MCP como cualquier elección de dependencia. Los servidores de referencia están bien mantenidos; muchos servidores de terceros no lo están. Lee el código del servidor antes de instalar uno que necesite credenciales.
📌Nota: Un hábito útil de recuperación ante fallos: antes de una tarea de agente no trivial, haz git stash (o git checkout -b agent/<task>). Después de la tarea, revisa el diff, conserva las partes que quieres y descarta el resto. Esta es la misma práctica que hace seguras las sesiones largas de Cline o Aider — consulta la comparativa de Continue.dev vs Cline vs Aider para el patrón más amplio.
MCP local vs Claude Desktop: qué cambia, qué permanece
El protocolo y los servidores son idénticos. Solo cambian el modelo y el cliente. Esta es exactamente la razón por la que MCP importa — tu inversión en herramientas se porta limpiamente entre configuraciones locales y en la nube.
Capa | Claude Desktop | Ollama local + Goose |
|---|---|---|
| Modelo | Claude (Anthropic, en la nube) | Gemma 4, GLM-4.7, Qwen3 o Llama 3.3 (local) |
| Cliente | Aplicación Claude Desktop | Goose, Cline, Continue.dev o LM Studio |
| Servidores | Los mismos servidores MCP | Los mismos servidores MCP |
| Protocolo | MCP (JSON-RPC 2.0) | MCP (JSON-RPC 2.0) |
| Costo por solicitud | Gasto de API por token | $0 — inferencia local |
| Privacidad | La conversación va a Anthropic | Se queda en la máquina |
| Límites de velocidad | Se aplican los límites de la API | Limitado solo por el rendimiento del hardware |
| Calidad del tool calling | La mejor en su clase | Buena con modelos de 27B+; se degrada rápido por debajo de 7B |
| Requiere internet | Sí | Solo si un servidor hace peticiones (p.ej. el navegador) |
| Tiempo de configuración | 5 minutos | 15 minutos (una sola vez) |
Elegir un modelo con tool calling para MCP local
La fiabilidad del tool calling escala con el tamaño y el entrenamiento del modelo, no con el harness. Un modelo que emite tool calls malformados en Cline los emitirá en Goose por la misma razón.
- Gemma 4 31B (
gemma4:31b) — el entrenamiento de tool calling de Google es el mejor en su clase para este tamaño. Cabe en 16 GB de memoria unificada o 24 GB de VRAM en Q4_K_M. Buen razonamiento general; algo conservador en tool calls encadenados. - GLM-4.7 Flash (
glm-4.7-flash) — el modelo de Zhipu tiene una fiabilidad de tool calling muy alta y una ventana de contexto de 128K de serie. Ligeramente más pesado que Gemma 4; cabe cómodamente en una GPU de 24 GB. - Qwen3.6 27B (
qwen3.6:27b) — la opción Qwen más reciente en Ollama (unos 18–19 GB, contexto de 256K, con soporte de tool calling). Qwen3 32B (qwen3:32b) — equilibrado; el 32B denso maneja MCP sin problemas y se desenvuelve bien en un bucle de agente largo. Qwen3-Coder 30B (qwen3-coder:30b) es la mejor opción si tu trabajo de agente está orientado al código. - Llama 3.3 70B (
llama3.3:70b) — el techo más alto pero el más pesado. 48 GB+ de memoria unificada o 2× 24 GB de GPUs en Q4_K_M. Úsalo solo si tu hardware lo admite; los modelos más pequeños suelen ser suficientes. - Evita para trabajo con MCP: cualquier cosa por debajo de 7B y cualquier modelo de uso general sin entrenamiento explícito de tool calling. Emitirán llamadas malformadas, el bucle se bloqueará y culparás al harness — pero el harness está bien.
- Para técnicas de prompting estructurado que mejoran la calidad del tool calling en cualquier modelo, consulta Chain-of-thought prompting.
- Para los datos comparativos, consulta Mejores modelos locales para tool calling en 2026.
MCP vs Function Calling simple: cuál es la diferencia
El function calling es lo que emite el modelo. MCP es el protocolo que permite que los clientes y las herramientas se encuentren. Viven en capas diferentes y cooperan; uno no reemplaza al otro.
- El function calling es la capacidad del lado del LLM: el modelo emite un objeto JSON estructurado que describe el nombre de la herramienta y los argumentos. Las herramientas de OpenAI, las de Anthropic y la API de tool call de Ollama usan la misma idea con formatos de wire ligeramente diferentes.
- MCP se sitúa por encima: estandariza cómo se describen, descubren, invocan y devuelven las herramientas entre procesos. Un modelo con function calling por sí solo no sabe nada de tu filesystem; un servidor MCP hace disponibles las operaciones de filesystem, el cliente las mapea a la API de function calling del modelo y el modelo puede llamarlas.
- El beneficio es la interoperabilidad. Escribe el servidor filesystem una vez; Claude Desktop, Goose, Cline, Continue.dev y LM Studio lo usan todos sin cambios. Cambia el modelo de Claude a Gemma 4; el servidor no cambia.
- Puedes hacer agentes con function calling puro. Reimplementarás manejadores de filesystem, base de datos y navegador por proyecto. Con MCP, esas son dependencias listas para usar.
- Para scripts puntuales, el function calling puro es más sencillo. Para cualquier cosa que quieras reutilizar entre proyectos o modelos, MCP es el camino de menor esfuerzo en pocos días.
Errores comunes al configurar MCP local
- Error 1: usar un modelo pequeño de propósito general. Los modelos de menos de 7B (y la mayoría de los modelos generales de 7B–13B sin fine-tuning de tool calling) emiten tool calls malformados. Usa un modelo de 27B+ afinado para tool calling y deja de pelear con el harness.
- Error 2: poner tu directorio home en la allow-list. Las allow-lists de
~"solo para pruebas" sobreviven hasta el uso rutinario. Crea unagent-workspacededicado desde el principio. - Error 3: dejar el servidor de base de datos en modo lectura/escritura. Una consulta
DELETEredactada por un agente seguro de sí mismo sobre una tabla real es exactamente el incidente que esto evita. Haz deagent_rotu rol por defecto; configura un rol escribible separado solo para las tareas que explícitamente lo necesiten y solo durante esas tareas. - Error 4: aprobar automáticamente cada herramienta. El botón "aprobar todo" es cómodo y peligroso. Aprueba automáticamente las herramientas de lectura (
read_file,list_directory,query); siempre requiere aprobación para las herramientas de escritura/shell/PR. - Error 5: usar un modelo con contexto de 32K para trabajo de navegador de varios pasos. El contenido de la página es grande; un agente que navega tres páginas puede agotar los 32K tokens antes de razonar. Usa un modelo con contexto de 128K para tareas intensivas en el navegador.
- Error 6: asumir que el agente tiene criterio. No lo tiene. El modelo no tiene concepto de "esta es la base de datos de producción" o "este PR va a desplegarse". Los permisos son tu única barrera.
- Error 7: instalar todos los servidores de referencia desde el principio. Más herramientas = prompt de sistema más grande = selección de herramientas más lenta y menos fiable. Empieza con
filesystem. Añade los demás solo cuando tengas un flujo de trabajo que los necesite. - Error 8: instalar servidores de referencia archivados de tutoriales antiguos. Los paquetes npm
@modelcontextprotocol/server-postgres,-puppeteery-githubfiguran como "no longer supported" y el servidor de SQLite está archivado. Algunas guías antiguas también nombran paquetes npm que no existen (server-sqlite,server-playwright). Usa los servidores mantenidos indicados arriba. - Error 9: poner la configuración de MCP en Ollama. Ollama no tiene ajustes de MCP. Los servidores se configuran en el cliente (
extensionsen Goose, los ajustes de MCP de Cline o Continue.dev).
Fuentes
- Especificación de Model Context Protocol — Especificación oficial, esquema JSON-RPC, definiciones de transporte y ciclo de vida, incluido el changelog de 2026-07-28.
- Repositorio GitHub modelcontextprotocol/servers — Los servidores de referencia mantenidos (filesystem, git, fetch, memory y otros) y la lista de servidores archivados.
- github/github-mcp-server — Servidor MCP oficial de GitHub, configuración con Docker y binario.
- microsoft/playwright-mcp — Servidor MCP de Playwright y sus herramientas de navegador.
- crystaldba/postgres-mcp — Servidor MCP de Postgres con modo de acceso restringido (solo lectura).
- Documentación de Goose — Instalación del CLI, configuración del proveedor Ollama, sintaxis de configuración de extensiones (servidores MCP).
- Biblioteca de modelos Ollama — Modelos locales disponibles, indicadores de soporte de tool calling y niveles de cuantización referenciados en esta guía.
- Repositorio GitHub de Cline — Implementación del cliente MCP para VS Code, panel de servidores MCP.
- Documentación de Continue.dev — Referencia del bloque de configuración
mcpServerspara el cliente Continue.dev.
Preguntas frecuentes
¿Qué es MCP y por qué importa para la IA local?
Model Context Protocol (MCP) es un protocolo abierto JSON-RPC 2.0 que permite que un cliente (Goose, Cline, Continue.dev, LM Studio, Claude Desktop) conecte un modelo de lenguaje a servidores de herramientas de manera uniforme. Importa para la IA local porque estandariza la capa que convierte un modelo de chat en un agente — escribe un servidor de herramientas una vez y úsalo bajo cualquier cliente y cualquier modelo, incluido un modelo Ollama local. Sin MCP, cada proyecto reinventa las herramientas de archivo/base de datos/navegador contra su propio cliente.
¿MCP funciona sin Claude Desktop?
Sí. El protocolo es abierto y completamente independiente de Claude Desktop. Goose, Cline, Continue.dev y LM Studio ofrecen implementaciones de cliente MCP que funcionan con modelos Ollama locales. Los servidores mantenidos (filesystem, Postgres, Playwright, GitHub) funcionan sin cambios bajo cualquier cliente compatible.
¿Qué modelos locales soportan MCP mejor?
Las opciones más fiables son Gemma 4 31B, GLM-4.7 Flash, Qwen3.6 27B o Qwen3 32B (o Qwen3-Coder 30B para trabajo orientado al código) y Llama 3.3 70B. Todos tienen entrenamiento explícito de tool calling y emiten JSON de function calling limpio que los clientes MCP pueden enrutar. Los modelos de menos de 7B (y la mayoría de los modelos generales sin fine-tuning de tool calling) producen regularmente tool calls malformados.
¿Es seguro MCP? ¿Puede el agente borrar mis archivos?
Puede si se lo permites. La seguridad proviene de cómo configuras los servidores, no del protocolo. El servidor filesystem solo opera dentro de las rutas que pones en la allow-list — limítalo a un directorio agent-workspace dedicado. El servidor de base de datos funciona en solo lectura cuando usas el modo restringido y un rol solo de SELECT. Siempre requiere aprobación explícita para las herramientas de escritura, shell y PR; aprueba automáticamente solo las operaciones de lectura. El registro de auditoría te muestra exactamente lo que hizo el agente después del hecho.
¿Puedo escribir mi propio servidor MCP?
Sí — y los SDKs lo hacen sencillo. Los SDKs oficiales de TypeScript y Python (@modelcontextprotocol/sdk y mcp) manejan la plomería JSON-RPC. Defines herramientas con sus JSON Schemas y una función handler, y el SDK las expone mediante stdio. Un servidor de propósito único (una o dos herramientas que envuelven una API interna) es un archivo de 50–100 líneas.
¿Funciona MCP en Windows?
Sí. Ollama, Goose, Cline, Continue.dev y LM Studio todos funcionan en Windows. Los servidores MCP se ejecutan como subprocesos de Node.js o Python; ambos entornos de ejecución son completamente compatibles con Windows. El único detalle específico de la plataforma es el manejo de rutas — usa barras inclinadas hacia adelante en la configuración o escapa correctamente las barras invertidas. Por lo demás, la experiencia es idéntica a macOS y Linux.
¿Cómo pongo en sandbox las tool calls de MCP?
Tres capas cubren la mayor parte del riesgo. Primero, limita cada servidor estrechamente a nivel de configuración: filesystem a un directorio, base de datos a un rol de solo lectura, GitHub a un PAT de grano fino para repositorios de prueba. Segundo, usa las reglas de aprobación por herramienta del cliente: aprobación automática para lecturas, aprobación requerida para escrituras. Tercero, mantén al agente dentro de un workspace compatible con git stash para que cualquier acción destructiva sea deshacible mediante git. Para tareas sensibles, ejecuta en un host sin acceso a la red excepto para los endpoints que los servidores necesitan explícitamente.
¿Pueden los agentes MCP hacer peticiones HTTP?
Sí, a través de servidores específicos. El servidor de navegador (Playwright MCP) controla un navegador real que hace las peticiones que el modelo navega. Varios servidores de terceros exponen herramientas http_get/http_post de forma más directa. Los servidores de filesystem y base de datos no hacen peticiones de red; operan solo en recursos locales.
¿MCP funciona con Ollama de forma nativa o necesito un wrapper?
Ollama en sí mismo no habla MCP — sirve una API de chat compatible con OpenAI. Necesitas un cliente (Goose, Cline, Continue.dev, LM Studio) para hacer de puente entre la API de chat de Ollama y los servidores MCP. El cliente enruta los tool calls del modelo al servidor MCP correcto y devuelve los resultados a la conversación. Desde la perspectiva del usuario no hay configuración adicional más allá de instalar el cliente y apuntarlo a Ollama.
¿Cuál es la diferencia entre MCP y function calling?
El function calling es que el LLM emite JSON estructurado con el nombre de una herramienta y sus argumentos — es una capacidad del modelo. MCP es el protocolo que permite que los servidores de herramientas y los clientes describan, descubran, invoquen y devuelvan esas herramientas entre procesos — es una capa de interoperabilidad. Cooperan: el cliente convierte las definiciones de herramientas de MCP al formato de function calling del modelo, el modelo emite un function call, el cliente mapea la llamada de vuelta a un servidor MCP y el servidor la ejecuta. Sin MCP puedes hacer function calling; reimplementas los manejadores de filesystem/base de datos/navegador por proyecto. Con MCP, los mismos servidores funcionan bajo cualquier cliente.
¿Cómo añado un servidor MCP a Ollama?
No se añade a Ollama: Ollama no tiene ajustes de MCP. El servidor se añade en el cliente que se sitúa delante de Ollama. En Goose, ejecuta goose configure, elige Add Extension y luego Command-line Extension, e introduce el comando del servidor (por ejemplo npx -y @modelcontextprotocol/server-filesystem /path/to/workspace); para una prueba rápida usa goose session --with-extension "<command>". Cline y Continue.dev tienen sus propios ajustes de MCP. Asegúrate de que Ollama ejecute un modelo con tool calling y una ventana de contexto de al menos 32K.
¿Puedo usar Claude Desktop con modelos de Ollama?
No como configuración directa. Claude Desktop se comunica con los modelos de Anthropic en la nube, así que no ejecuta un modelo de Ollama. Lo que se traslada de Claude Desktop es el ecosistema de servidores MCP: los mismos servidores funcionan con un cliente MCP que sí admite Ollama, como Goose, Cline, Continue.dev o LM Studio. Ese es el equivalente local que describe esta guía.
¿Qué servidores MCP oficiales están archivados y qué los sustituye?
Los servidores de referencia de SQLite, PostgreSQL, Puppeteer y GitHub (entre otros) se movieron al repositorio servers-archived y ya no se mantienen; sus paquetes npm (donde existen) figuran como "no longer supported" y no reciben correcciones de seguridad. Sustitutos mantenidos: el github/github-mcp-server oficial de GitHub para GitHub, el @playwright/mcp de Microsoft para automatización del navegador y postgres-mcp (Crystal DBA) en modo restringido para Postgres. Para SQLite no hay un servidor oficial mantenido, así que usa una copia del archivo con el servidor archivado o carga los datos en Postgres. El servidor filesystem sigue siendo un servidor de referencia mantenido activamente.