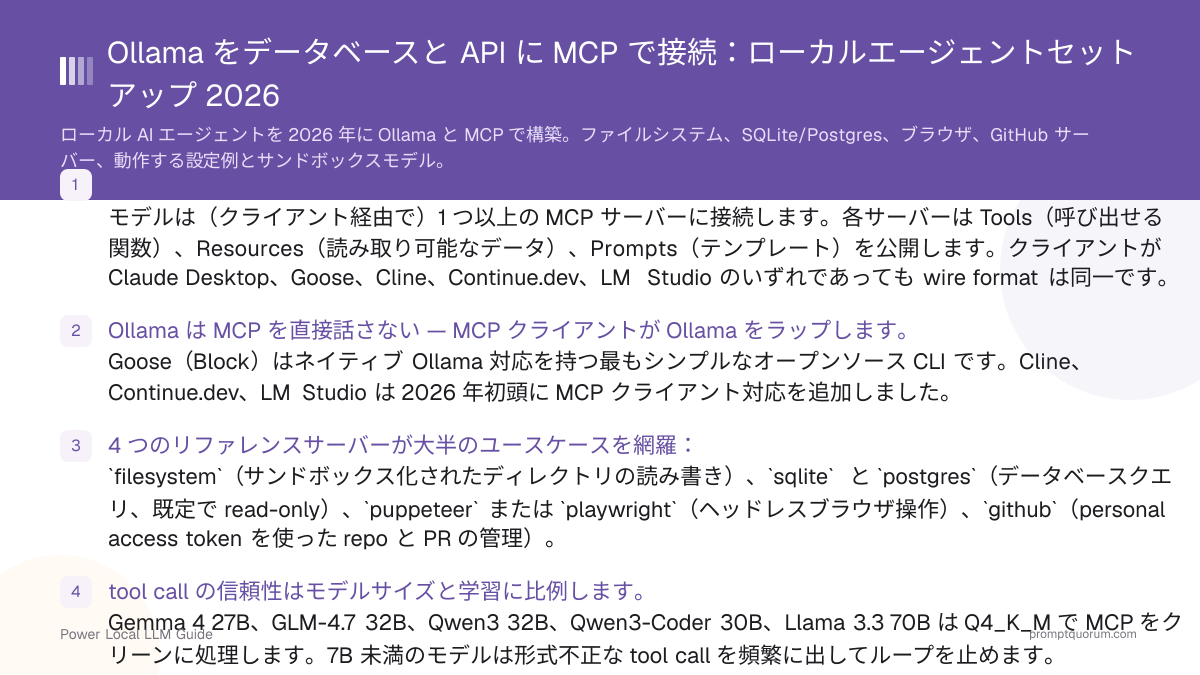
クイックファクト
- プロトコル: JSON-RPC 2.0 を stdio(ローカルサブプロセス)または Streamable HTTP(リモート)で通信。従来の HTTP+SSE transport は非推奨です。ローカルエージェントはほぼ stdio のみ使用します。現行の仕様リビジョンは 2026-07-28 です。
- 起源: Anthropic がオープン仕様として作成(modelcontextprotocol.io)。
modelcontextprotocol/serversで今もメンテナンスされているリファレンスサーバーはごく一部(filesystem、git、fetch、memory など)で、SQLite、PostgreSQL、Puppeteer、GitHub はservers-archivedに移されました。現在は各ベンダーが自社のサーバーを提供しています。 - ローカルクライアント: Goose(オープンソース、リポジトリは
aaif-goose/goose)、Cline(VS Code 拡張)、Continue.dev(VS Code/JetBrains)、LM Studio(デスクトップアプリ)、加えて複数の CLI ツール。 - 互換 Ollama モデル: ネイティブ tool call 学習を持つすべてのモデル。例:Gemma 4 31B、GLM-4.7 Flash、Qwen3.6 27B、Qwen3 32B、Qwen3-Coder 30B、Llama 3.3 70B。
- サーバー transport の既定: ローカルプロセスは stdio;複数マシンや複数エージェント間でサーバーを共有する場合のみ Streamable HTTP。
- 設定はクライアント側にあります: Goose は
~/.config/goose/config.yamlのextensionsブロック(またはgoose configure)を読み、Cline と Continue.dev はそれぞれ独自の MCP 設定を持ちます。考え方はどれも同じ:サーバー名、command、args、env vars。 - Claude Desktop 不要。 プロトコルはオープンで Claude Desktop から独立しており、ここで使うサーバーはオープンソース(ライセンスは各自確認してください)で、準拠する任意のクライアントで動作します。
MCP がローカルモデルに対して実際に解放するもの
ツールのないローカル LLM はテキストでしか応答できません。MCP があれば、同じモデルがマシン上でアクションできます。 これが chatbot とエージェントの違いです。
- 「このリポジトリのすべての TODO を見つけ、ファイルごとにグルーピングして、Markdown 要約を
notes/todos.mdに書き出してください」 —filesystemサーバーが読み、モデルがグルーピングし、同じサーバーが書き込みます。エンドツーエンドで往復 1 回。 - 「今四半期の売上トップ 10 顧客を出して、グラフ化してください」 —
postgresサーバーが SQL を実行(read-only ロール)、モデルが要約、filesystem経由で CSV を書き出してチャートツールに渡します。 - 「Hacker News のフロントページを開いて、AI 関連トップ 3 記事を見つけて要約し、私の reading list に追記してください」 —
playwrightサーバーがブラウザを操作し、モデルが抽出と要約、filesystemが追記します。 - 「私の fork に対して
chore: bump depsというタイトルのドラフト PR を開き、失敗中の CI run を本文にリンクしてください」 —githubサーバーが PR を作成、run を取得、本文にリンクを書き込みます。 - 「
events.dbの最新 100 行を見て、新しいエラースパイクの原因になっているユーザー ID を教えてください」 — データベースサーバーがデータのコピーを照会、モデルが推論、回答をチャットパネルで読みます。 - いずれも以前はクラウドモデルとホストツール、または手書きスクリプトを必要とした「文 → アクション」ワークフローです。MCP は同じサーバーを複数クライアント間で、同じモデルを複数サーバー間で再利用できる層です。
最もよく使われる 4 つの MCPサーバーの比較
下記のサーバーは「ローカルモデルに何か実際の作業をしてほしい」というロングテールをカバーします。すべてオープンソースで、MCP クライアントが起動するローカルサブプロセス(または Docker コンテナ)として動作します。インストール前にメンテナンス状況を確認してください。
📍 一文で説明
まず filesystem サーバーから(5 分、低リスク)、データ作業にデータベースサーバーを追加、必要が生じたらブラウザサーバー、マシン上のモデルを信頼できるようになったら GitHub を追加してください。
💬 簡潔に説明
ローカルエージェントにさせたい作業の大半をこの 4 つで処理できます。filesystem サーバーは選んだフォルダ内でファイルを読み書きします。データベースサーバーは Postgres に対してクエリを実行します。ブラウザサーバーは実際のブラウザウィンドウを操作するため、JavaScript を必要とするページもモデルが読めます。GitHub サーバーは自分のリポジトリで issue や PR を開きます。ほとんどは 1 コマンド(npx、uvx、Docker)で起動し、自分のマシン上で動作します。必要な場合を除いてインターネットには出ません(ブラウザと GitHub サーバーは出ますが、filesystem とデータベースサーバーは出ません)。
MCPサーバー | 可能になること | セットアップ難度 | リスクレベル | 適した用途 |
|---|---|---|---|---|
| Filesystem(リファレンス) | サンドボックス化されたディレクトリでのファイル読み書き | 簡単(パス 1 つを allow-list) | 中 — 範囲を厳しく絞ること | 個人の自動化、ノート、リポジトリ要約 |
| SQLite(アーカイブ済み) | ローカル SQLite データベースファイルへのクエリ | 簡単、ただしメンテナンス終了 | 中 — 修正なし、ファイルのコピーを使う | 使い捨てのデータ探索のみ |
| Postgres(postgres-mcp) | 制限(read-only)モードでの Postgres クエリ | 中(ロール + URI) | 中 — 制限モードと read-only ロール | データ探索、レポーティング、BI プロトタイプ |
| Playwright(@playwright/mcp) | アクセシビリティスナップショットによるブラウジング、スクレイピング、フォーム入力 | 中(ブラウザバイナリ、レイテンシ) | 高 — フォーム送信や任意のクリックが可能 | リサーチ、スクレイピング、回帰テスト |
| GitHub(公式) | リポジトリ一覧、ファイル読み取り、issue と PR の作成 | 中(Docker + 環境変数の PAT) | 中 — トークンを特定 repo に絞る | 開発ワークフロー、トリアージ、PR ドラフト |
| Custom | JSON-RPC ツールとして表現できる任意のもの | 難(自分でサーバーを書く) | 可変 | 社内 API、ニッチなシステム、glue code |
⚠️注意: SQLite、PostgreSQL、Puppeteer、GitHub のリファレンスサーバーは servers-archived リポジトリに移され、メンテナンスされていません。PostgreSQL、Puppeteer、GitHub の npm パッケージは「no longer supported」と表示されており、SQLite サーバー(Python パッケージ、最終リリースは 2025 年 4 月)にも修正は提供されません。この表のメンテナンスされているサーバーを使い、認証情報が必要なサーバーはコードを読んでから導入してください。
構成要素のつながり
3 つのプロセス、共有プロトコル 1 つ。 モデルは Ollama 内、クライアントが MCP を話し、各サーバーが小さなツールセットを公開します。tool call はクライアント → サーバーに飛び、ローカル実行され、JSON が返ります。
- Ollama はバックグラウンドサービスとして
127.0.0.1:11434で動作し、OpenAI 互換 API でモデルを提供します。MCP のことは知りません — chat completion に応答し、モデルが要求すれば tool call を出すだけです。 - MCP クライアント(Goose、Cline、Continue.dev、LM Studio)が橋渡し役です。モデルについては Ollama と、ツールについては MCPサーバーと話します。モデルが tool call を出すと、クライアントが正しいサーバーへルーティングし、結果を取得し、会話に戻します。
- MCPサーバー は機能ごとに独立したサブプロセスです。stdio で JSON-RPC 2.0 を話します。各サーバーが Tools、Resources、Prompts を公開し、クライアントがそれらを統合してモデルに見せます。
- stdio transport ですべてがローカルに留まります。 サーバーはクライアントによって起動され、stdin/stdout で通信し、クライアント終了時に終了します。サーバー自身が接続を開かない限り(ブラウザサーバーは開きます、filesystem とデータベースサーバーは開きません)、ネットワーク経由になりません。
- モデルはフラットなツールリストを見ます。 モデル視点ではサーバーは存在せず、
filesystem.read_file、playwright.browser_navigate、github.create_pull_requestのようなツール名のリストがあるだけです。クライアントがルーティングを処理します。

📌補足: アーキテクチャは Claude Desktop と同一です。違いはモデル(Claude の代わりにローカル Ollama モデル)とクライアント(Claude Desktop の代わりに Goose/Cline/Continue.dev/LM Studio)です。MCPサーバーは同じサーバー — 今日 Claude Desktop で動かしている filesystem サーバーは、明日 Goose 配下で変更なく動作します。
MCP 設定:Ollama + Goose を 15 分で
Goose は動作するローカル MCP エージェントへの最短ルートです。 オープンソースのエージェント(元は Block 発、現在は aaif-goose/goose で開発)で、CLI、ネイティブな Ollama 対応、対話型チャットインターフェース、すべての Model Context Protocol (MCP) サーバー設定を 1 ファイルに集約する仕組みを備えています。Continue.dev、Cline、LM Studio でも動作しますが、初回セットアップのコストは Goose が最も低いです。
- Step 1 — Ollama をインストール。 ollama.com/download(macOS/Windows/Linux)からダウンロード。
curl http://127.0.0.1:11434/api/tagsでサービスが動作していることを確認してください。 - Step 2 — tool calling モデルを pull。 Gemma 4 31B(
gemma4:31b)、GLM-4.7 Flash(glm-4.7-flash)、Qwen3.6 27B(qwen3.6:27b)、Qwen3 32B(qwen3:32b)または Llama 3.3 70B(llama3.3:70b)から選択。32 GB unified memory または 24 GB VRAM で 26B–32B を Q4_K_M で快適に動かせます。 - Step 3 — Goose をインストール。 macOS または Linux では
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash(またはbrew install block-goose-cli)を実行します。Windows では Goose ドキュメントの PowerShell インストーラか WSL を使ってください。CLI はgooseとしてインストールされます。 - Step 4 — Ollama をプロバイダーとして設定。
goose configureを実行、ollamaをプロバイダーに選択、モデルを pull したものに、host をhttp://127.0.0.1:11434に設定(空欄でも localhost:11434 になります)。Goose は~/.config/goose/config.yamlに書き込みます。Ollama の既定コンテキストウィンドウは小さいことがあり(Goose のドキュメントでは 4096 トークンとされています)、その場合 Goose が extension を無視することがあります —OLLAMA_CONTEXT_LENGTH=32768(またはそれ以上)を付けて Ollama を起動してください。 - Step 5 — filesystem の MCPサーバーを追加。
goose configureを実行して Add Extension、続いて Command-line Extension を選ぶか、~/.config/goose/config.yamlにextensionsブロックを追加します(下に設定例)。一度だけ試すならgoose session --with-extension "npx -y @modelcontextprotocol/server-filesystem /path/to/workspace"でそのセッションに限って有効にできます。goose sessionを開始し、テストディレクトリのファイル一覧を尋ねてください。最初のターンでサーバー接続が確認できます。 - Step 6 — 実際のタスクで検証。
goose sessionを試し、「notes/内の各 Markdown ファイルについて、タイトルと単語数の一覧を作って結果をnotes/index.mdに書いてください」と尋ねます。エージェントが読み、要約し、書き戻せばループは動作しています。
# 1. Pull a tool-calling model
ollama pull gemma4:31b

# 2. Install Goose (macOS / Linux)
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash

# 3. Configure Ollama as the provider
goose configure
# Provider: ollama
# Model:    gemma4:31b
# Host:     http://127.0.0.1:11434

# 4. Give Ollama a context window big enough for tool use, then start a session
OLLAMA_CONTEXT_LENGTH=32768 ollama serve   # in a separate terminal
goose session
💡ヒント: すでに Cline や Continue.dev を使っているなら Goose をスキップしてそちらを使ってください — どちらも MCP クライアントです。それぞれ独自の MCP 設定を持つので(正確なファイルは各ドキュメントで確認してください)、モデルとサーバーは同じで、変わるのはホストアプリとその設定形式だけです。
Filesystem サーバー:サンドボックス化されたディレクトリの読み書き
filesystem サーバーは最初に入れるべきサーバーで、安全に範囲を絞るのも最も簡単です。 read_file、write_file、list_directory、move_file、search_files、create_directory を公開し、すべて allow-list された 1 つ以上のパスに制限されます。
- インストール: リファレンスサーバーは
@modelcontextprotocol/server-filesystem、npx -y経由で実行(グローバルインストール不要、Node.js が必要)。今もメンテナンスされているリファレンスサーバーの 1 つです。Goose、Cline、Continue.dev はすべて設定ブロックから自動起動します。 - パスを allow-list: サーバーは 1 つ以上のディレクトリ引数を受け取り、それ以外の場所での操作を拒否します。常に明示的で範囲の狭いパスを渡してください —
~や/は絶対に避けてください。 - 公開ツール:
read_file、read_multiple_files、write_file、edit_file(行ベースの置換)、list_directory、search_files、move_file、create_directory、directory_tree。モデルからはfilesystem.read_fileのように見えます。 - 便利機能:
directory_treeは JSON ツリーを返し、特定ファイルを読む前にモデルが構造を把握するのに最適です。search_filesは grep のような再帰検索を行います。 - リスク面: サーバーは allow-list を尊重しますが、リスト内では完全な読み書き権限を持ちます。allow-list を唯一のバリアと捉え、ホームフォルダではなく専用 workspace ディレクトリを選んでください。
# ~/.config/goose/config.yaml
extensions:
  filesystem:
    type: stdio
    name: filesystem
    enabled: true
    cmd: npx
    args: ["-y", "@modelcontextprotocol/server-filesystem", "/Users/you/agent-workspace"]
    envs: {}
timeout: 300⚠️注意: / やホームディレクトリは絶対に allow-list しないでください。専用の agent-workspace フォルダを作成し、エージェントに触らせたいファイルのコピーをそこに置き、そのフォルダ内でのみ動作させてください。エージェントが暴走しても、被害は 1 ディレクトリで止まります。
データベースサーバー:Postgres(と SQLite)を安全に照会する
データベースサーバーはモデルを実データで質問に答えられるジュニアアナリストに変えます — read-only に保つことが前提です。 SQLite と PostgreSQL の旧リファレンスサーバーはアーカイブ済みなので、メンテナンスされている Postgres サーバーを使い、SQLite は慎重に扱ってください。
- Postgres:
postgres-mcp(Crystal DBA、MIT ライセンス) は read-only モードを備えた選択肢です(PyPI の最新リリースは 2025 年 5 月なので、頼る前にリポジトリの活動状況を確認してください)。uvx postgres-mcp --access-mode=restricted(またはpipx install postgres-mcp、Docker イメージ)で起動し、接続 URI はDATABASE_URI環境変数で渡します。制限モードでは read-only トランザクションとクエリの時間制限が適用され、非制限モードは開発専用です。 - 専用の read-only ロールも併用してください。 制限モードが 1 つ目のバリア、データベースロールが 2 つ目です。SELECT のみの権限を持つ
agent_roロールを作成し、そのロールの接続文字列を使います。 - SQLite:リファレンスサーバーはアーカイブ済みです。 Python パッケージ
mcp-server-sqlite(npm パッケージではありません。最終リリースは 2025 年 4 月)で、まだ動く可能性はありますが修正は提供されません。ファイルのコピーにだけ向け、唯一のコピーには絶対に向けないでください。あるいはデータを Postgres に読み込んでください。コミュニティ製の SQLite サーバーは、ファイルを渡す前にコードを読んでください。 - スキーマ認識: 分析的な質問の前に「テーブル一覧を出して、よく使われる 5 つを describe してください」とエージェントに頼んでください — スキーマを確認したモデルは、カラム名を推測したモデルよりはるかに精度が高くなります。
- コスト: クエリは直接データベースに飛びます。1 億行テーブルへの不適切な
SELECT *は人間がやった場合と同じ事故です — ロールは独立した接続プールに置き、statement timeout を設定してください。
# ~/.config/goose/config.yaml
extensions:
  postgres:
    type: stdio
    name: postgres
    enabled: true
    cmd: uvx
    args: ["postgres-mcp", "--access-mode=restricted"]
    envs:
      DATABASE_URI: "postgresql://agent_ro:${PG_AGENT_PASSWORD}@127.0.0.1:5432/analytics"
timeout: 300💡ヒント: Postgres ロールは一度作成し、エージェントにそれ以上の権限を与えないでください:CREATE ROLE agent_ro WITH LOGIN PASSWORD '…'; GRANT CONNECT ON DATABASE analytics TO agent_ro; GRANT USAGE ON SCHEMA public TO agent_ro; GRANT SELECT ON ALL TABLES IN SCHEMA public TO agent_ro; ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO agent_ro; 続いてロールに statement_timeout = 30s を設定してください。エージェントは書き込み不可、drop 不可、無限実行不可になります。
ブラウザサーバー:Playwright MCP でブラウザを操作
ブラウザサーバーは 4 つのうち最も強力で最も危険です。 実際のブラウザを起動し、ナビゲーション、クリック、フォーム入力、スクリーンショットを公開します — つまりブラウザでできるすべてが可能で、フォーム送信も含まれます。
- 使うサーバー: Microsoft の
@playwright/mcp(npx @playwright/mcp@latest)を使います。旧@modelcontextprotocol/server-puppeteerは「no longer supported」と表示されており、@modelcontextprotocol/server-playwrightという npm パッケージは存在しません。 - 公開ツール:
browser_navigate、browser_snapshot、browser_click、browser_type、browser_fill_form、browser_evaluate(JavaScript 実行)、browser_take_screenshot、browser_tabs、browser_wait_for。モデルはページをbrowser_snapshot(アクセシビリティスナップショット。Playwright MCP は操作にはスクリーンショットよりこちらを推奨)で読み、スクリーンショットは見るためだけに使います。 - レイテンシ: 実ブラウザセッションはアクションあたり 1–5 秒。多段ブラウジングは簡単に 30–60 秒、数万トークンを消費します(ページ内容が大きいため)。32K+ コンテキストウィンドウを使ってください。
- 要素参照: モデルはスナップショット内の参照を使って要素をクリックします。小さいモデルはよく外しますが、27B+ tool calling モデルなら一般的なパターンを安定して扱います。タスクは絞ってください — 「この URL のタイトルと最初の段落を抽出してください」のほうが「サイトを巡回して contact ページを探してください」よりはるかに信頼できます。
- 良いユースケース: リサーチ(ページを開く、要約する、ノートに追記)、回帰テスト(ナビゲート、クリック、screenshot)、自分が管理するページのフォーム入力。悪いユースケース:本番 Web 上の誤クリックが結果を伴うあらゆる作業。
# ~/.config/goose/config.yaml
extensions:
  playwright:
    type: stdio
    name: playwright
    enabled: true
    cmd: npx
    args: ["@playwright/mcp@latest"]
    envs: {}
    timeout: 300
# Block obviously dangerous endpoints at the OS firewall level
# rather than relying on the agent to refuse them.⚠️注意: ブラウザサーバーに認証情報を絶対に渡さないでください。認証済みセッションが必要なら、事前認証されたブラウザプロファイルを渡し、高インパクトサイト(バンキング、メール、クラウドコンソール、決済フォーム)には絶対に navigate させないでください。モデルはボタンの意味を判断できません — テキストを見てクリックするだけです。コンテキストも復旧手段もないインターンと同じ扱いをしてください。
GitHub サーバー:ローカルモデルから repo、issue、PR を扱う
GitHub サーバーは自然言語のリポジトリ作業を API call に変換します。 4 つの中で最も設定が簡単で、personal access token (PAT) の権限を使って範囲を厳しく絞るのも最も容易です。
- インストール: GitHub 公式の
github/github-mcp-serverを使い、Docker イメージ(ghcr.io/github/github-mcp-server)からGITHUB_PERSONAL_ACCESS_TOKEN環境変数に PAT を入れて実行します。旧@modelcontextprotocol/server-githubnpm パッケージは「no longer supported」と表示されているので、新規構成では使わないでください。 - 公開ツール:
search_repositories、get_file_contents、create_or_update_file、create_pull_request、list_issues、create_issue、add_issue_comment、merge_pull_request、ほか多数。フルセットは大きいですが、ほとんどのタスクは 5–10 ツールで足ります。 - PAT を絞る。 特定 repo に絞った fine-grained PAT を、必要最小限の権限(閲覧は Read、PR/issue 作成は Write)で使ってください。実験的エージェントに対して
repo権限のクラシック PAT は使わないでください。 - 実例ワークフロー: トリアージ(「直近の open issue 20 件を読んで、グルーピングしてラベル案を出してください」)、ドラフト作成(「README を読んで誤字を直す PR を開いてください」)、レポーティング(「今週 stale な PR を教えてください」)。
- リスク面: エージェントは issue や PR を作成、コメント、(書き込み権限があれば)コミットを push できます。merge 系ツールはモデルとワークフローの両方を信頼できる場合以外は無効化してください — fine-grained PAT の repo での誤マージは復旧可能ですが、すぐに気付いた場合のみです。
# ~/.config/goose/config.yaml
extensions:
  github:
    type: stdio
    name: github
    enabled: true
    cmd: docker
    args: ["run", "-i", "--rm", "-e", "GITHUB_PERSONAL_ACCESS_TOKEN", "ghcr.io/github/github-mcp-server"]
    envs:
      GITHUB_PERSONAL_ACCESS_TOKEN: "${GH_AGENT_PAT}"
    timeout: 300
# Fine-grained PAT scoped to one or two test repos,
# not your personal account-wide classic token.
モデルを信頼しないセキュリティモデル
正しいメンタルモデルは「LLM はあなたが渡した鍵を持つ信頼できないインターン」です。 能力はサーバーと allow-list したインターフェースから来ます — モデルの判断力からは来ません。
- filesystem サーバーを 1 ディレクトリに限定。
~や/は絶対に使わないでください。agent-workspace/フォルダを選び、エージェントに触らせたいファイルのコピーを置きます。エージェントが暴走しても、最悪のケースは 1 フォルダです。 - データベースサーバーは既定で read-only 運用。 専用の
agent_roロールをSELECTのみの権限と 30 秒の statement timeout で作成すれば、ある種のインシデントカテゴリ全体が消えます。 - 書き込みやシェル系ツールはすべて明示的承認の後ろに。 Goose、Cline、Continue.dev はそれぞれツール単位の承認ルールをサポートしています。読み取りツールは既定で許可、
write_file、edit_file、execute_command、create_pull_request、フォーム送信を行うブラウザアクションには承認を要求してください。 - 監査ログを使ってください。 すべての MCP クライアントは tool call と結果を記録します。長時間セッション後にログをスキャンしてください:モデルがあなたが想定しなかった操作を試みていることに気付けます(無害な場合も、権限を絞り直すべき場合もあります)。
- サードパーティーアクセスはトークンスコープを狭く。 GitHub PAT は 2 つのテスト repo に絞る。Postgres ロールは read-only。ブラウザセッションは認証情報なし。モデルはいずれあなたが想定しなかった操作を試みます;できることの限界は、モデルが正しく振る舞うことに依存させてはいけません。
- 機密データ作業時はエージェントを air-gap してください。 プライベートデータを扱うとき、エージェント実行中はホストのネットワークアクセスを無効化(または network namespace を使用)してください。ローカルスタックはマシンから何も出しませんが、defense-in-depth はサードパーティーサーバーの不具合をキャッチします。
- MCPサーバーの選定は依存関係選びと同様に扱ってください。 リファレンスサーバーはよくメンテされていますが、サードパーティーサーバーの多くはそうではありません。認証情報が必要なサーバーは、入れる前にコードを読んでください。
📌補足: 便利な失敗回復習慣:些細でないエージェントタスクの前に git stash(または git checkout -b agent/<task>)。タスク後に diff を確認し、欲しい部分だけ残し、それ以外は破棄します。これは長時間の Cline や Aider セッションを安全に保つ慣習と同じです — 広いパターンは Continue.dev vs Cline vs Aider 比較 を参照してください。
ローカル MCP vs Claude Desktop:何が変わり、何が残るか
プロトコルとサーバーは同一です。モデルとクライアントだけが変わります。 これが MCP の重要性そのものです — ツーリング投資はローカルとクラウド構成間でクリーンに移植できます。
レイヤー | Claude Desktop | ローカル Ollama + Goose |
|---|---|---|
| モデル | Claude(Anthropic、クラウド) | Gemma 4、GLM-4.7、Qwen3、または Llama 3.3(ローカル) |
| クライアント | Claude Desktop アプリ | Goose、Cline、Continue.dev、または LM Studio |
| サーバー | 同じ MCPサーバー | 同じ MCPサーバー |
| プロトコル | MCP(JSON-RPC 2.0) | MCP(JSON-RPC 2.0) |
| リクエストコスト | トークン課金 API | 0 円 — ローカル推論 |
| プライバシー | 会話は Anthropic に送信 | マシン上に留まる |
| レート制限 | API レート制限が適用 | ハードウェアスループットのみが制約 |
| tool call 品質 | best-in-class | 27B+ なら良好、7B 未満で急激に劣化 |
| インターネット必要 | 必要 | サーバー自身が fetch する場合のみ(例:ブラウザ) |
| セットアップ時間 | 5 分 | 15 分(初回のみ) |
ローカル MCP 用 tool calling モデルの選定
tool call の信頼性はモデルサイズと学習に依存し、ハーネスではありません。 Cline で形式不正な tool call を出すモデルは、Goose でも同じ理由で形式不正な tool call を出します。
- Gemma 4 31B(
gemma4:31b) — Google の tool call 学習はサイズに対して best-in-class。16 GB unified memory または 24 GB VRAM で Q4_K_M に収まります。一般推論は良好;連鎖した tool call にはやや保守的です。 - GLM-4.7 Flash(
glm-4.7-flash) — Zhipu のモデルは tool call 信頼性が非常に高く、out of the box で 128K コンテキストウィンドウ。Gemma 4 よりやや重め;24 GB GPU に余裕で収まります。 - Qwen3.6 27B(
qwen3.6:27b) — Ollama で使える新しい Qwen の選択肢(約 18–19 GB、256K コンテキスト、tool calling 対応)。Qwen3 32B(qwen3:32b) — バランスが良く、dense な 32B が MCP をクリーンに処理し、長時間エージェントループでも安定します。Qwen3-Coder 30B(qwen3-coder:30b) はエージェント作業がコード形態の場合の最良の選択です。 - Llama 3.3 70B(
llama3.3:70b) — 最高の天井ですが最も重い。Q4_K_M で 48 GB+ unified memory または 2× 24 GB GPU。ハードウェアが対応している場合のみ;通常は小さいモデルで十分です。 - MCP 作業で避けるべきもの: 7B 未満すべて、明示的な tool call 学習のない汎用モデルすべて。形式不正な call を出してループが止まり、ハーネスを責めることになりますが — ハーネスは問題ありません。
- 任意のモデルで tool call 品質を改善する構造化プロンプティング手法は、Chain-of-Thought Prompting を参照してください。
- 頭ごなしの比較データは、2026 年のローカル tool calling 最強モデル を参照してください。
MCP vs プレーン Function Calling:違いは何か
Function calling はモデルが出力するもの。MCP はクライアントとツールが互いを見つけるためのプロトコル。 異なる層に存在し協調します;どちらかがもう一方を置き換えるわけではありません。
- Function calling は LLM 側の能力です:モデルがツール名と引数を記述する構造化 JSON を出力します。OpenAI Tools、Anthropic Tools、Ollama の tool call API はすべて同じ考え方を、わずかに異なる wire format で使います。
- MCP はその上に乗ります:ツールがどう記述、発見、呼び出し、返却されるかを、プロセス間で標準化します。Function calling モデル単体ではあなたの filesystem を知りませんが、MCPサーバーが filesystem 操作を提供し、クライアントがモデルの function calling API にマッピングし、モデルがそれを呼び出せるようになります。
- メリットは interop です。 filesystem サーバーを一度書けば、Claude Desktop、Goose、Cline、Continue.dev、LM Studio が変更なしで使います。モデルを Claude から Gemma 4 に変えても、サーバーは変わりません。
- Function calling だけでエージェントは作れます。 プロジェクトごとに filesystem、データベース、ブラウザのハンドラを再実装することになります。MCP ならそれらは out-of-the-box の依存関係です。
- 1 回限りのスクリプトには素の function calling のほうが簡単です。 プロジェクトやモデルをまたいで再利用したいものなら、数日以内に MCP のほうが手間が少なくなります。
日本ユーザーのための活用ポイント
日本企業にとってローカル MCP は、クラウドエージェントが直面する個人情報保護法(APPI)と METI AI ガバナンスのハードルを直接下げます。 モデル、クライアント、すべてのツールサーバーが自社マシン上で動く構成なら、データは一切エンドポイントを離れません。
- METI AI ガバナンス 2024: 経済産業省の AI ガバナンスガイドラインは、特に金融、医療、法務など規制業界での AI 利用において、データ保護とトレーサビリティを求めています。ローカル MCP スタックは外部データ送信を排除し、監査ログでトレーサビリティを担保するため、これらの要件にクリーンに整合します。
- 個人情報保護法(APPI): 顧客データや従業員データをクラウド AI プロバイダーに送るには、第三者提供の同意とリスク評価が必要です。ローカル推論ではこの第三者提供自体が発生せず、契約上の負担と説明責任が大幅に軽減されます。
- 日本企業のユースケース: 法律事務所、税理士法人、医療機関、製造業の設計部門、人事 — クライアント・患者・従業員データを OpenAI、Anthropic、Google に送れない領域すべて。十分なユニファイドメモリを搭載した Apple シリコンの Mac や RTX 4090 搭載ワークステーションで 27B–32B モデルが動き、書類要約、契約レビュー、社内データベースに対するコード片の検証ができます。
- 東アジアのデータ越境: 日本、シンガポール、マレーシア、韓国はそれぞれ独自のデータ residency 枠組みを持ち、APAC 全域へのクロスボーダー転送には個別の評価が必要です。ローカル推論はこの転送を完全に回避し、東アジアでの multi-region 展開時のコンプライアンス負担を取り除きます。
- 日本の中堅企業(中小企業): 大企業向けに作られたクラウド AI 契約は、中小企業にとってはコスト・契約レビュー両面でハードルが高いケースが多く、PoC が頓挫しがちです。ローカル MCP スタックは設備投資 1 回(マシン代)のみで月額課金なし、契約も社内のみで完結します。
- 監査と説明責任: MCP クライアントの監査ログ(Goose、Cline、Continue.dev)は「エージェントが想定外の操作をしていないこと」を示す主たる証拠になります。WORM ストレージや、エージェント自身からは上書き不可能な Git リポジトリに保存してください。日本の監査文化との親和性は高いです。
ローカル MCP 設定でよくある間違い
- 間違い 1:小さい汎用モデルを使う。 7B 未満(および tool call ファインチューニングなしの 7B–13B 汎用モデルの大半)は形式不正な tool call を出します。27B+ tool call チューン済みモデルを使い、ハーネスと戦うのをやめてください。
- 間違い 2:ホームディレクトリを allow-list する。 「テストだけ」のはずの
~の allow-list は本番運用に残ります。最初から専用のagent-workspaceを作ってください。 - 間違い 3:データベースサーバーを read/write モードで放置。 自信を持ったエージェントが本番テーブルに書く
DELETEクエリこそ、これで防げるインシデントです。agent_roを既定にし、書き込みが明示的に必要なタスクのためだけに、その期間だけ別の writable ロールを立ててください。 - 間違い 4:すべてのツールを自動承認。 「すべて承認」トグルは便利で危険です。読み取りツール(
read_file、list_directory、query)は自動承認、書き込み・シェル・PR 系は常に承認を要求してください。 - 間違い 5:多段ブラウザ作業に 32K コンテキストモデル。 ページ内容は大きく、3 ページ巡回で推論前に 32K トークンを使い切ることがあります。ブラウザ重めのタスクには 128K コンテキストモデルを使ってください。
- 間違い 6:エージェントに判断力があると仮定。 ありません。モデルは「これは本番データベース」「この PR はデプロイされる」という概念を持ちません。権限が唯一のバリアです。
- 間違い 7:リファレンスサーバーを最初に全部入れる。 ツールが多い = system prompt が大きい = ツール選択が遅く不正確になります。
filesystemから始めて、必要になったら他を追加してください。 - 間違い 8:古いチュートリアルのアーカイブ済みリファレンスサーバーを入れる。 npm パッケージ
@modelcontextprotocol/server-postgres、-puppeteer、-githubは「no longer supported」と表示されており、SQLite サーバーもアーカイブ済みです。古いガイドには、存在しない npm パッケージ(server-sqlite、server-playwright)を挙げているものもあります。上で挙げたメンテナンスされているサーバーを使ってください。 - 間違い 9:MCP の設定を Ollama に書こうとする。 Ollama に MCP の設定項目はありません。サーバーはクライアント側で設定します(Goose の
extensions、Cline や Continue.dev の MCP 設定)。
出典
- Model Context Protocol 仕様 — 公式仕様、JSON-RPC スキーマ、transport およびライフサイクル定義(2026-07-28 の変更履歴を含む)。
- modelcontextprotocol/servers GitHub リポジトリ — メンテナンスされているリファレンスサーバー(filesystem、git、fetch、memory など)とアーカイブ済みサーバーの一覧。
- github/github-mcp-server — GitHub 公式の MCPサーバー、Docker とバイナリのセットアップ。
- microsoft/playwright-mcp — Playwright MCPサーバーとそのブラウザツール。
- crystaldba/postgres-mcp — 制限(read-only)アクセスモードを持つ Postgres MCPサーバー。
- Goose ドキュメント — CLI インストール、Ollama プロバイダー設定、extension(MCPサーバー)の設定構文。
- Ollama モデルライブラリ — 利用可能なローカルモデル、tool call サポートフラグ、本ガイドで参照する量子化レベル。
- Cline GitHub リポジトリ — VS Code MCP クライアント実装、MCP サーバーパネル。
- Continue.dev ドキュメント — Continue.dev クライアント用
mcpServers設定ブロックリファレンス。
よくある質問
MCP とは何で、ローカル AI にとってなぜ重要ですか?
Model Context Protocol(MCP)はオープンな JSON-RPC 2.0 プロトコルで、クライアント(Goose、Cline、Continue.dev、LM Studio、Claude Desktop)が言語モデルとツールサーバーを統一的に接続できるようにします。ローカル AI にとって重要な理由は、chat モデルをエージェントに変える層を標準化することです — ツールサーバーを 1 度書けば、ローカル Ollama モデルを含む任意のクライアントとモデルで使えます。MCP がなければ、各プロジェクトが自前のクライアントに対してファイル/データベース/ブラウザのツールを再発明することになります。
MCP は Claude Desktop なしで動きますか?
はい。プロトコルはオープンで Claude Desktop からは完全に独立しています。Goose、Cline、Continue.dev、LM Studio はすべてローカル Ollama モデルで動作する MCP クライアント実装を提供しています。メンテナンスされているサーバー(filesystem、Postgres、Playwright、GitHub)は準拠する任意のクライアント配下で変更なしに動きます。
MCP に最も適したローカルモデルは何ですか?
最も信頼できる選択肢は、Gemma 4 31B、GLM-4.7 Flash、Qwen3.6 27B または Qwen3 32B(コード形態の作業なら Qwen3-Coder 30B)、Llama 3.3 70B です。いずれも明示的な tool call 学習を持ち、MCP クライアントがルーティング可能なクリーンな function calling JSON を出力します。7B 未満(および tool call ファインチューニングのない汎用モデルの大半)は形式不正な tool call を頻繁に出します。
MCP は安全ですか — エージェントがファイルを削除できますか?
許可すれば可能です。安全性はサーバーの設定から来ており、プロトコルからではありません。filesystem サーバーは allow-list したパス内でのみ動作します — 専用の agent-workspace ディレクトリに絞ってください。データベースサーバーは制限モードと SELECT のみのロールを使えば read-only で動きます。書き込み、シェル、PR 系ツールには常に明示的承認を要求し、読み取り操作のみ自動承認にしてください。監査ログで事後にエージェントが何をしたか正確に確認できます。
自分で MCP サーバーを書けますか?
はい — そして SDK が手間を減らします。公式の TypeScript と Python SDK(@modelcontextprotocol/sdk と mcp)が JSON-RPC のプラミングを処理します。JSON Schema でツールを定義しハンドラ関数を書けば、SDK が stdio で公開します。社内 API をラップする 1–2 ツールの単機能サーバーなら 50–100 行のファイル 1 つで済みます。
MCP は Windows で動きますか?
はい。Ollama、Goose、Cline、Continue.dev、LM Studio はすべて Windows で動きます。MCPサーバーは Node.js または Python のサブプロセスとして動作し、両ランタイムは Windows で完全にサポートされています。プラットフォーム固有の唯一の落とし穴はパス処理 — 設定でフォワードスラッシュを使うか、バックスラッシュを正しくエスケープしてください。それ以外は macOS や Linux と同じ体験です。
MCP の tool call をサンドボックスする方法は?
3 層でリスクの大半をカバーします。第一に、各サーバーを設定レベルで狭く絞る:filesystem は 1 ディレクトリ、データベースは read-only ロール、GitHub はテスト repo に絞った fine-grained PAT。第二に、クライアントのツール単位の承認ルールを使う:read は自動承認、write は承認要求。第三に、エージェントを git stash 可能な workspace 内に置き、破壊的なものは git で取り消せるようにする。機密タスクではサーバーが明示的に必要とするエンドポイント以外ネットワークアクセスのないホストで実行してください。
MCP エージェントは HTTP リクエストを行えますか?
はい、特定のサーバー経由で。ブラウザサーバー(Playwright MCP)は実ブラウザを操作し、モデルが navigate するすべてのリクエストを行います。複数のサードパーティーサーバーが http_get/http_post ツールをより直接的に公開しています。filesystem およびデータベースサーバーはネットワークリクエストを行わず、ローカルリソースのみを操作します。
Ollama 単体で MCP は使えますか、それともラッパーが必要ですか?
Ollama 自体は MCP を話しません — OpenAI 互換 chat API を提供します。Ollama の chat API と MCPサーバーを橋渡しするクライアント(Goose、Cline、Continue.dev、LM Studio)が必要です。クライアントがモデルの tool call を正しい MCPサーバーへルーティングし、結果を会話に戻します。ユーザー視点ではクライアントをインストールして Ollama に向けるだけで、追加の設定は不要です。
MCP と function calling の違いは何ですか?
Function calling はツール名と引数を記述する構造化 JSON を LLM が出力すること — モデルの能力です。MCP はそれらのツールがプロセス間で記述、発見、呼び出し、返却される方法を定めるプロトコル — interop 層です。両者は協調します:クライアントが MCP のツール定義をモデルの function calling 形式に変換し、モデルが function call を出し、クライアントがそれを MCPサーバーへ戻し、サーバーが実行します。MCP がなくても function calling はできますが、プロジェクトごとに filesystem/database/browser のハンドラを再実装することになります。MCP があれば同じサーバーが任意のクライアントで動作します。
Ollama に MCPサーバーを追加(設定)するにはどうすればよいですか?
Ollama には追加しません — Ollama に MCP の設定項目はないからです。Ollama の前段にあるクライアント側でサーバーを追加します。Goose では goose configure を実行して Add Extension、続いて Command-line Extension を選び、サーバーのコマンド(例:npx -y @modelcontextprotocol/server-filesystem /path/to/workspace)を入力します。手早く試すなら goose session --with-extension "<command>" が使えます。Cline と Continue.dev には独自の MCP 設定があります。Ollama では、コンテキストウィンドウが 32K 以上の tool calling モデルを動かしてください。
Claude Desktop で Ollama のモデルは使えますか?
直接の構成としては使えません。Claude Desktop は Anthropic のクラウドモデルと通信するため、Ollama のモデルは動かせません。Claude Desktop から引き継げるのは MCPサーバーのエコシステムです:同じサーバーが、Ollama に対応した MCP クライアント(Goose、Cline、Continue.dev、LM Studio など)でも動きます。それが本ガイドで説明しているローカルでの代替構成です。
アーカイブされた公式 MCPサーバーはどれで、代わりに何を使えばよいですか?
SQLite、PostgreSQL、Puppeteer、GitHub(ほか)のリファレンスサーバーは servers-archived リポジトリに移され、メンテナンスされていません。npm パッケージ(存在するもの)は「no longer supported」と表示され、セキュリティ修正も提供されません。メンテナンスされている代替:GitHub には GitHub 公式の github/github-mcp-server、ブラウザ自動化には Microsoft の @playwright/mcp、Postgres には制限モードの postgres-mcp(Crystal DBA)。SQLite にはメンテナンスされている公式サーバーがないため、ファイルのコピーにアーカイブ済みサーバーを使うか、データを Postgres に読み込んでください。filesystem サーバーは引き続きメンテナンスされているリファレンスサーバーです。
ローカル MCP エージェントで METI AI ガバナンスをどう適用しますか?
経済産業省の AI ガバナンスガイドライン 2024 は、特に金融・医療・法務などの規制業界における AI 活用に対し、データ保護、トレーサビリティ、説明責任を求めています。ローカル MCP スタックはこれら 3 つの軸すべてに直接整合します:第一に、外部データ送信が発生しないため第三者提供のリスクがなく、APPI(個人情報保護法)の負担も軽減されます。第二に、MCP クライアントの監査ログ(Goose、Cline、Continue.dev)が tool call と結果を時系列で記録し、トレーサビリティの主たる証拠になります。第三に、サーバーごとの権限設定(filesystem は 1 ディレクトリ、データベースは read-only ロール、GitHub は fine-grained PAT)が、説明責任に必要な「何が起きうるか」の境界を明確に定義します。日本の大企業の社内監査文化と整合性が高く、内部監査での説明が容易です。
ローカル MCP エージェントで日本企業のセキュリティ要件を満たせますか?
はい、特にデータ residency と第三者監査の観点で適合性が高いです。日本企業のセキュリティ標準(金融機関の FISC、医療機関の 3 省 2 ガイドライン、製造業の社内 ISMS)はいずれも、機密データを扱うシステムについて「外部送信の有無」「アクセス制御」「監査ログ」を中心評価項目に置いています。ローカル MCP スタックでは、十分なユニファイドメモリを搭載した Apple シリコンの Mac や RTX 4090 搭載ワークステーションでモデル、MCP クライアント、すべてのサーバーが同一マシン上で動作するため、外部送信は発生しません。アクセス制御は filesystem サーバーの allow-list、Postgres ロール、GitHub PAT の fine-grained scope で多層化できます。監査ログは MCP クライアント側で自動収集され、WORM ストレージや内部 Git リポジトリに保管できます。中堅企業(中小企業)にとっては、月額課金なしで PoC を社内完結できる点も大きな利点です。