빠른 사실
- 프로토콜: stdio(로컬 하위 프로세스) 또는 Streamable HTTP(원격)를 통한 JSON-RPC 2.0. 기존 HTTP+SSE 전송은 더 이상 권장되지 않습니다(deprecated). 로컬 에이전트는 거의 stdio만 사용합니다. 현재 사양 개정판은 2026-07-28입니다.
- 기원: Anthropic이 오픈 사양(modelcontextprotocol.io)으로 만들었습니다.
modelcontextprotocol/servers에서는 일부 참조 서버(filesystem, git, fetch, memory 등)만 계속 유지 관리되며, SQLite, PostgreSQL, Puppeteer, GitHub는servers-archived로 옮겨졌습니다. 이제는 각 벤더가 자체 서버를 제공합니다. - 로컬 클라이언트: Goose(오픈 소스, 저장소
aaif-goose/goose), Cline(VS Code 확장), Continue.dev(VS Code/JetBrains), LM Studio(데스크톱 앱), 그리고 여러 CLI 도구. - 호환되는 Ollama 모델: 네이티브 tool calling 훈련을 받은 모든 모델. 예: Gemma 4 31B, GLM-4.7 Flash, Qwen3.6 27B, Qwen3 32B, Qwen3-Coder 30B, Llama 3.3 70B.
- 서버 전송 기본값: 로컬 프로세스에는 stdio. 서버를 여러 기기나 에이전트가 공유해야 할 때만 Streamable HTTP를 사용합니다.
- 설정은 클라이언트에 있습니다: Goose는
~/.config/goose/config.yaml의extensions블록(또는goose configure)을 읽고, Cline과 Continue.dev에는 각자의 MCP 설정이 있습니다. 필드의 개념은 어디서나 같습니다: 서버 이름, 명령, args, 환경 변수. - Claude Desktop이 필요하지 않습니다. 프로토콜은 오픈되어 있고 Claude Desktop과 독립적입니다. 여기서 사용하는 서버는 오픈 소스(라이선스는 각각 확인하십시오)이며 모든 호환 클라이언트에서 작동합니다.
MCP 연동으로 로컬 모델에 실제로 가능해지는 것
도구가 없는 로컬 LLM은 텍스트로만 응답할 수 있습니다. MCP를 연동하면 같은 모델이 기기에서 직접 행동할 수 있습니다. 이 변화는 챗봇과 에이전트의 차이입니다.
- "이 저장소에서 모든 TODO를 찾아 파일별로 그룹화하고
notes/todos.md에 Markdown 요약을 작성하십시오." —filesystem서버가 읽고, 모델이 그룹화하고, 같은 서버가 씁니다. 처음부터 끝까지 한 번의 왕복입니다. - "이번 분기 수익 기준 상위 10개 고객을 보여주고 차트를 만드십시오." —
postgres서버가 SQL을 실행하고(읽기 전용 역할), 모델이 요약하고, 차트 도구를 위해filesystem으로 CSV를 씁니다. - "Hacker News 첫 페이지를 열어 상위 3개 AI 기사를 찾아 요약하고 내 읽기 목록에 추가하십시오." —
playwright서버가 브라우저를 제어하고, 모델이 추출 및 요약하고,filesystem이 추가합니다. - "내 포크에
chore: bump deps제목으로 draft PR을 열고 실패한 CI 실행을 링크하십시오." —github서버가 PR을 만들고, 실행 정보를 가져오고, 설명에 링크를 씁니다. - "
events.db의 최근 100개 행을 보고 새 오류 급증의 원인이 된 사용자 ID를 알려주십시오." — 데이터베이스 서버가 데이터 사본을 쿼리하고, 모델이 추론하고, 답은 채팅 패널에서 확인합니다. - 이 각각은 예전에는 호스팅된 도구가 있는 클라우드 모델이나 직접 작성한 스크립트가 필요했던, 문장 하나로 행동을 일으키는 워크플로입니다. MCP는 같은 서버를 여러 클라이언트에서, 같은 모델을 여러 서버에서 재사용할 수 있게 하는 계층입니다.
가장 많이 사용되는 4개의 MCP 서버 비교
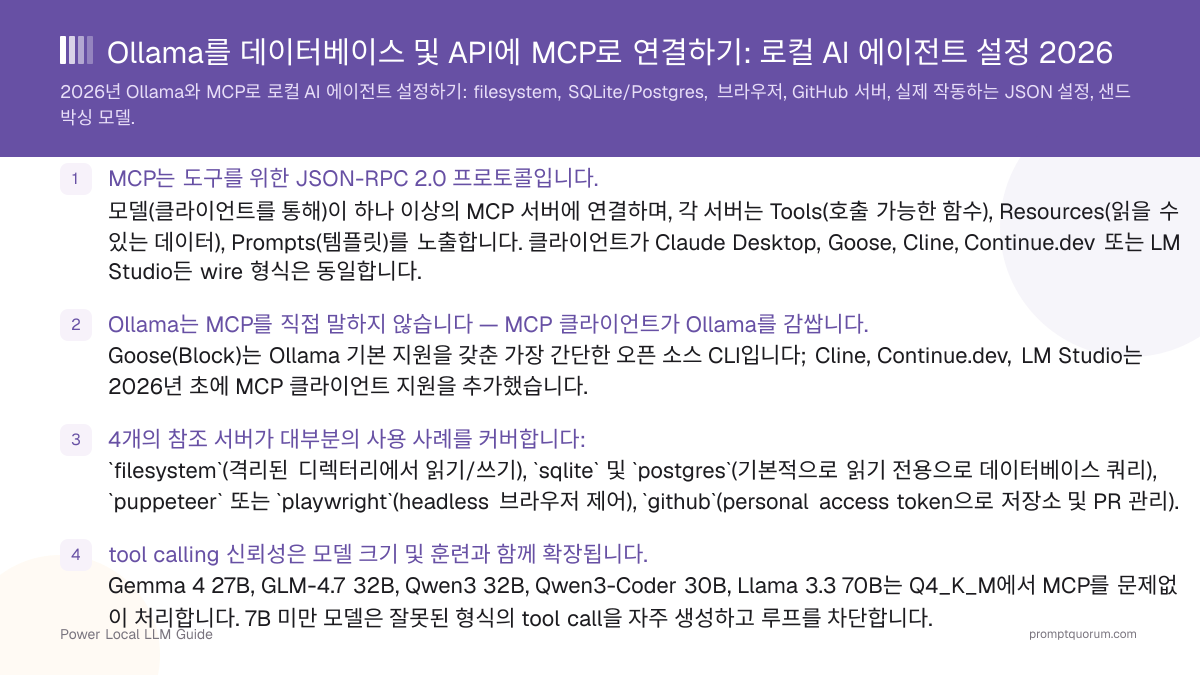
아래 서버들은 "내 로컬 모델이 실제로 무언가를 하게 하고 싶다"는 요구의 대부분을 커버합니다. 모두 오픈 소스이며 MCP 클라이언트가 시작하는 로컬 하위 프로세스(또는 Docker 컨테이너)로 실행됩니다. 설치하기 전에 유지 관리 상태를 확인하십시오.
📍 한 문장으로
filesystem 서버(5분, 낮은 위험)로 시작하고, 데이터 작업을 위해 데이터베이스 서버를 추가하고, 필요할 때만 브라우저 서버를 추가하고, 기기에서 모델을 신뢰할 수 있게 되면 GitHub를 도입하십시오.
💬 쉽게 말하면
네 가지 서버가 로컬 에이전트에게 맡기고 싶은 작업의 대부분을 커버합니다. filesystem 서버는 선택한 폴더에서 파일을 읽고 씁니다. 데이터베이스 서버는 Postgres에 쿼리를 실행합니다. 브라우저 서버는 실제 브라우저 창을 제어하여 모델이 JavaScript가 필요한 페이지를 읽을 수 있게 합니다. GitHub 서버는 저장소에 이슈와 PR을 엽니다. 대부분 명령 하나(npx, uvx 또는 Docker)로 시작하고 자신의 기기에서 실행되며, 필요한 경우가 아니면 인터넷을 호출하지 않습니다. 브라우저와 GitHub 서버는 호출하지만, filesystem과 데이터베이스 서버는 호출하지 않습니다.
MCP 서버 | 활성화하는 기능 | 설정 난이도 | 위험 수준 | 이상적인 용도 |
|---|---|---|---|---|
| Filesystem (참조) | 격리된 디렉터리 내에서 파일 읽기 및 쓰기 | 쉬움(허용 목록에 경로 하나) | 중간 — 범위를 좁게 제한하십시오 | 개인 자동화, 노트 작성, 저장소 요약 |
| SQLite (보관됨) | 로컬 SQLite 데이터베이스 파일 쿼리 | 쉬움, 단 더 이상 유지 관리되지 않음 | 중간 — 수정 없음, 파일 사본을 사용하십시오 | 일회성 데이터 탐색에만 |
| Postgres (postgres-mcp) | 제한(읽기 전용) 모드로 Postgres 쿼리 | 중간(역할 + URI) | 중간 — 제한 모드와 읽기 전용 역할 | 데이터 탐색, 보고, BI 프로토타입 |
| Playwright (@playwright/mcp) | 접근성 스냅샷으로 브라우저를 제어해 탐색, 스크래핑, 양식 작성 | 중간(브라우저 바이너리, 지연) | 높음 — 양식을 제출하고 무엇이든 클릭할 수 있습니다 | 연구, 스크래핑, 회귀 테스트 |
| GitHub (공식) | 저장소 나열, 파일 읽기, 이슈 및 PR 열기 | 중간(Docker + 환경 변수의 PAT) | 중간 — 토큰을 특정 저장소로 제한하십시오 | 개발 워크플로, 트리아지, PR 초안 |
| Custom | JSON-RPC 도구로 표현할 수 있는 모든 것 | 어려움(자체 서버 작성) | 가변적 | 내부 API, 틈새 시스템, 통합 코드 |
⚠️경고: SQLite, PostgreSQL, Puppeteer, GitHub용 참조 서버는 servers-archived 저장소로 옮겨졌으며 더 이상 유지 관리되지 않습니다. PostgreSQL, Puppeteer, GitHub용 npm 패키지에는 "no longer supported"(더 이상 지원되지 않음) 표시가 있고, SQLite 서버(Python 패키지, 마지막 릴리스 2025년 4월)도 수정이 제공되지 않습니다. 이 표의 유지 관리되는 서버를 사용하고, 자격 증명이 필요한 서버는 설치 전에 코드를 읽으십시오.
구성 요소가 맞물리는 방식
세 가지 프로세스, 하나의 공유 프로토콜. 모델은 Ollama에 있고, 클라이언트는 MCP를 말하며, 각 서버는 소규모 도구 집합을 노출합니다. 모든 tool call은 클라이언트에서 서버로 이동하고, 로컬에서 실행되고, JSON을 반환합니다.
- Ollama는
127.0.0.1:11434에서 백그라운드 서비스로 실행되며 OpenAI 호환 API로 모델을 제공합니다. MCP가 무엇인지 알지 못합니다. 채팅 완성에 응답하고, 모델이 요청할 때 tool call을 생성할 뿐입니다. - MCP 클라이언트(Goose, Cline, Continue.dev, LM Studio)가 다리 역할을 합니다. 모델을 위해 Ollama와, 도구를 위해 MCP 서버와 통신합니다. 모델이 tool call을 생성하면 클라이언트가 올바른 서버로 라우팅하고, 결과를 받아 대화에 되돌려 줍니다.
- MCP 서버는 기능마다 하나씩 있는 독립적인 하위 프로세스입니다. stdio를 통해 JSON-RPC 2.0을 사용합니다. 각 서버는 Tools, Resources, Prompts 목록을 공개하며, 클라이언트는 이를 합쳐 모델에 제시되는 도구 표면을 만듭니다.
- stdio 전송은 모든 것을 로컬에 유지합니다. 서버는 클라이언트가 시작하고, stdin/stdout으로 통신하며, 클라이언트가 종료되면 함께 종료됩니다. 서버 자체가 연결을 여는 경우를 제외하면 네트워크로 나가는 것이 없습니다(브라우저 서버는 연결을 열지만 filesystem과 데이터베이스 서버는 열지 않습니다).
- 모델은 평평한 도구 목록 하나를 봅니다. 모델의 관점에서 서버는 없습니다.
filesystem.read_file,playwright.browser_navigate,github.create_pull_request같은 도구 이름의 목록만 있습니다. 라우팅은 클라이언트가 처리합니다.

📌참고: 아키텍처는 Claude Desktop과 동일합니다. 차이는 모델(Claude 대신 로컬 Ollama 모델)과 클라이언트(Claude Desktop 대신 Goose/Cline/Continue.dev/LM Studio)입니다. MCP 서버는 같은 서버입니다. 오늘 Claude Desktop에서 filesystem 서버를 실행하고 있다면, 내일 Goose에서도 변경 없이 그대로 실행됩니다.
설정: 15분 안에 Ollama + Goose 연결하기
Goose는 작동하는 로컬 MCP 에이전트로 가는 가장 간단한 경로입니다. 오픈 소스 에이전트(원래 Block에서 시작, 현재는 aaif-goose/goose에서 개발)로, CLI와 Ollama 기본 지원, 대화형 채팅 인터페이스, 모든 Model Context Protocol(MCP) 서버를 위한 단일 설정 파일을 갖추고 있습니다. Continue.dev, Cline, LM Studio도 작동합니다. Goose는 첫 실행의 설정 부담이 가장 낮습니다.
- 1단계 — Ollama 설치. ollama.com/download(macOS/Windows/Linux)에서 다운로드하십시오.
curl http://127.0.0.1:11434/api/tags로 서비스가 실행 중인지 확인하십시오. - 2단계 — tool calling 모델 다운로드. Gemma 4 31B(
gemma4:31b), GLM-4.7 Flash(glm-4.7-flash), Qwen3.6 27B(qwen3.6:27b), Qwen3 32B(qwen3:32b), Llama 3.3 70B(llama3.3:70b) 중에서 선택하십시오. 32GB 통합 메모리 또는 24GB VRAM이면 Q4_K_M에서 26B~32B를 여유 있게 처리할 수 있습니다. - 3단계 — Goose 설치. macOS 또는 Linux에서는
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash를 실행하십시오(또는brew install block-goose-cli). Windows에서는 Goose 문서의 PowerShell 설치 프로그램이나 WSL을 사용하십시오. CLI는goose로 설치됩니다. - 4단계 — Ollama를 제공자로 구성.
goose configure를 실행하고,ollama를 제공자로 선택하고, 모델을 다운로드한 것으로 설정하고, 호스트를http://127.0.0.1:11434로 설정하십시오(비워 두어도 localhost:11434를 의미합니다). Goose가 이 내용을~/.config/goose/config.yaml에 기록합니다. Ollama의 기본 컨텍스트 창은 작을 수 있으며(Goose 문서는 4096 토큰을 언급합니다), Goose가 extension을 무시할 수 있으므로, Ollama를OLLAMA_CONTEXT_LENGTH=32768(또는 더 높게)로 시작하십시오. - 5단계 — filesystem MCP 서버 추가.
goose configure를 실행해 Add Extension을 선택한 다음 Command-line Extension을 고르거나,~/.config/goose/config.yaml에extensions블록을 추가하십시오(아래 예시). 일회성 테스트라면goose session --with-extension "npx -y @modelcontextprotocol/server-filesystem /path/to/workspace"로 해당 세션에서만 활성화할 수 있습니다.goose session을 시작하고 테스트 디렉터리의 파일 목록을 요청하십시오. 첫 번째 턴이 서버가 연결되었음을 확인해 줍니다. - 6단계 — 실제 작업으로 확인.
goose session을 실행하고 "notes/의 모든 Markdown 파일을 제목과 단어 수와 함께 나열하고 결과를notes/index.md에 쓰십시오."라고 요청하십시오. 에이전트가 읽고, 요약하고, 다시 쓰면 루프가 작동하는 것입니다.
# 1. Pull a tool-calling model
ollama pull gemma4:31b

# 2. Install Goose (macOS / Linux)
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash

# 3. Configure Ollama as the provider
goose configure
# Provider: ollama
# Model:    gemma4:31b
# Host:     http://127.0.0.1:11434

# 4. Give Ollama a context window big enough for tool use, then start a session
OLLAMA_CONTEXT_LENGTH=32768 ollama serve   # in a separate terminal
goose session
💡팁: 이미 Cline이나 Continue.dev를 사용하고 있다면 Goose를 건너뛰고 그것들을 사용하십시오. 둘 다 MCP 클라이언트입니다. 각각 자체 MCP 설정이 있으므로(정확한 파일은 해당 문서를 확인하십시오), 모델과 서버는 같고 호스트 애플리케이션과 설정 형식만 바뀝니다.
Filesystem 서버: 격리된 디렉터리에서 읽기 및 쓰기
filesystem 서버는 가장 먼저 설치하기 좋고, 안전하게 제한하기도 가장 쉽습니다. read_file, write_file, list_directory, move_file, search_files, create_directory를 노출하며, 모두 하나 이상의 허용 목록 경로로 제한됩니다.
- 설치: 참조 서버는
@modelcontextprotocol/server-filesystem이며npx -y로 실행합니다(전역 설치 불필요, Node.js 필요). 지금도 유지 관리되는 참조 서버 중 하나입니다. Goose, Cline, Continue.dev가 설정에서 이 서버를 시작합니다. - 허용 목록 경로: 서버는 하나 이상의 디렉터리 인수를 받아 그 밖의 작업을 거부합니다. 항상 명시적이고 좁은 경로를 전달하십시오.
~나/는 절대 사용하지 마십시오. - 노출되는 도구:
read_file,read_multiple_files,write_file,edit_file(행 단위 대체),list_directory,search_files,move_file,create_directory,directory_tree. 모델은 이것들을filesystem.read_file등으로 봅니다. - 사용 편의성:
directory_tree는 JSON 트리를 반환하므로 모델이 특정 파일을 읽기 전에 방향을 잡기에 좋습니다.search_files는 grep과 비슷한 재귀 검색을 수행합니다. - 위험 표면: 서버는 허용 목록을 지키지만, 그 안에서는 읽기/쓰기 권한이 완전합니다. 허용 목록을 유일한 장벽으로 취급하고 홈 폴더 대신 전용 workspace 디렉터리를 고르십시오.
# ~/.config/goose/config.yaml
extensions:
  filesystem:
    type: stdio
    name: filesystem
    enabled: true
    cmd: npx
    args: ["-y", "@modelcontextprotocol/server-filesystem", "/Users/you/agent-workspace"]
    envs: {}
timeout: 300⚠️경고: 허용 목록에 /나 홈 디렉터리를 절대 넣지 마십시오. 전용 agent-workspace 폴더를 만들고, 에이전트가 다룰 파일의 사본을 그 안에 넣고, 에이전트가 그 폴더 안에서만 작동하게 하십시오. 에이전트가 잘못되더라도 피해 범위는 하나의 디렉터리에서 멈춥니다.
데이터베이스 서버: Postgres(와 SQLite)를 안전하게 쿼리하기
데이터베이스 서버는 읽기 전용으로 유지하는 한, 모델을 실제 데이터에 기반해 질문에 답하는 주니어 분석가로 만들어 줍니다. 기존 SQLite와 PostgreSQL 참조 서버는 보관되었으므로, 유지 관리되는 Postgres 서버를 사용하고 SQLite는 주의해서 다루십시오.
- Postgres:
postgres-mcp(Crystal DBA, MIT 라이선스)는 읽기 전용 모드가 있는 선택지입니다(최신 PyPI 릴리스는 2025년 5월이므로 의존하기 전에 저장소의 활동을 확인하십시오).uvx postgres-mcp --access-mode=restricted로 실행하고(또는pipx install postgres-mcp, 혹은 Docker 이미지), 연결 URI는DATABASE_URI환경 변수로 전달하십시오. 제한(restricted) 모드는 읽기 전용 트랜잭션과 쿼리 시간 제한을 허용하며, 제한 없는(unrestricted) 모드는 개발 전용입니다. - 전용 읽기 전용 역할도 함께 사용하십시오. 제한 모드가 하나의 장벽이고, 데이터베이스 역할이 또 하나의 장벽입니다. SELECT 권한만 있는
agent_ro역할을 만들고 그 역할의 연결 문자열을 사용하십시오. - SQLite: 참조 서버는 보관되었습니다. Python 패키지
mcp-server-sqlite(npm 패키지가 아니며, 마지막 릴리스는 2025년 4월)로, 아직 실행될 수는 있지만 수정은 제공되지 않습니다. 하나뿐인 원본이 아니라 반드시 파일 사본에만 연결하거나, 데이터를 Postgres에 불러와 사용하십시오. 커뮤니티 SQLite 서버는 파일을 넘기기 전에 코드를 읽으십시오. - 스키마 인식: 분석적인 질문을 하기 전에 에이전트에게 "테이블을 나열하고 가장 많이 사용되는 5개를 설명하십시오"라고 요청하십시오. 모델은 열 이름을 추측할 때보다 스키마를 확인한 뒤에 훨씬 정확합니다.
- 비용: 쿼리는 데이터베이스로 직접 갑니다. 1억 행 테이블에 대한 잘못된
SELECT *는 사람이 실행했을 때와 똑같은 사고입니다. 역할을 statement timeout이 있는 별도의 연결 풀에 두십시오.
# ~/.config/goose/config.yaml
extensions:
  postgres:
    type: stdio
    name: postgres
    enabled: true
    cmd: uvx
    args: ["postgres-mcp", "--access-mode=restricted"]
    envs:
      DATABASE_URI: "postgresql://agent_ro:${PG_AGENT_PASSWORD}@127.0.0.1:5432/analytics"
timeout: 300💡팁: Postgres 역할을 한 번만 만들고 에이전트에게 그 이상은 주지 마십시오: CREATE ROLE agent_ro WITH LOGIN PASSWORD '…'; GRANT CONNECT ON DATABASE analytics TO agent_ro; GRANT USAGE ON SCHEMA public TO agent_ro; GRANT SELECT ON ALL TABLES IN SCHEMA public TO agent_ro; ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO agent_ro; 그런 다음 역할에 statement_timeout = 30s를 추가하십시오. 에이전트는 쓸 수 없고, 삭제할 수 없고, 무한히 실행할 수도 없습니다.
브라우저 MCP 사용법: 로컬 LLM에 Playwright MCP 연결하기
로컬 LLM으로 브라우저 MCP를 사용하려면 세 가지가 필요합니다. tool calling 모델이 실행 중인 Ollama, MCP 클라이언트(여기서는 Goose), 그리고 Microsoft의 @playwright/mcp 서버입니다. 아래 설정 블록을 클라이언트에 추가하면 모델이 실제 브라우저를 열고 탐색, 클릭, 양식 작성, 스크린샷을 수행할 수 있습니다. 브라우저 서버는 네 가지 중 가장 강력하고 가장 위험합니다. 브라우저에서 할 수 있는 모든 일을 할 수 있으며 양식 제출도 포함됩니다.
- 어떤 서버를 쓸까: Microsoft의
@playwright/mcp(npx @playwright/mcp@latest)를 사용하십시오. 기존@modelcontextprotocol/server-puppeteer에는 "no longer supported" 표시가 있고, npm에는@modelcontextprotocol/server-playwright패키지가 존재하지 않습니다. - 노출되는 도구:
browser_navigate,browser_snapshot,browser_click,browser_type,browser_fill_form,browser_evaluate(JavaScript 실행),browser_take_screenshot,browser_tabs,browser_wait_for. 모델은browser_snapshot(접근성 스냅샷으로, Playwright MCP가 동작 수행에는 스크린샷보다 이쪽을 권장합니다)으로 페이지를 읽고, 스크린샷은 눈으로 확인할 때만 사용합니다. - 지연: 실제 브라우저 세션은 동작당 1~5초가 걸립니다. 페이지 내용이 크기 때문에 다단계 탐색은 쉽게 30~60초와 수만 토큰을 소비합니다. 32K 이상 컨텍스트 창을 사용하십시오.
- 요소 참조: 모델은 스냅샷에 있는 참조로 요소를 클릭합니다. 작은 모델은 잘못된 요소를 자주 고르며, 27B 이상의 tool calling 모델은 일반적인 패턴을 안정적으로 처리합니다. 작업 범위를 제한하십시오. "이 URL에서 제목과 첫 단락을 추출하십시오"는 "사이트를 탐색하여 연락처 페이지를 찾으십시오"보다 훨씬 신뢰할 수 있습니다.
- 올바른 사용 사례: 연구(페이지 열기, 요약하기, 노트에 추가), 회귀 테스트(탐색, 클릭, 스크린샷), 직접 제어하는 페이지의 양식 작성. 잘못된 사용 사례: 라이브 웹에서 잘못된 클릭이 결과를 일으키는 모든 작업.
# ~/.config/goose/config.yaml
extensions:
  playwright:
    type: stdio
    name: playwright
    enabled: true
    cmd: npx
    args: ["@playwright/mcp@latest"]
    envs: {}
    timeout: 300
# Block obviously dangerous endpoints at the OS firewall level
# rather than relying on the agent to refuse them.⚠️경고: 브라우저 서버에 자격 증명을 절대 제공하지 마십시오. 인증된 세션이 필요하다면 에이전트에게 사전 인증된 브라우저 프로파일을 전달하고, 영향이 큰 사이트(뱅킹, 이메일, 클라우드 콘솔, 결제 양식)로는 절대 이동하지 못하게 하십시오. 모델은 버튼이 무슨 일을 하는지 판단하지 못합니다. 텍스트를 보고 클릭할 뿐입니다. 맥락도 없고 책임도 지지 않는 인턴처럼 취급하십시오.
GitHub 서버: 로컬 모델로 저장소, 이슈, PR 다루기
GitHub 서버는 저장소에 대한 자연어 작업을 API 호출로 바꿔 줍니다. 네 가지 중 설정이 가장 간단하며, personal access token(PAT) 권한으로 범위를 좁게 제한하기도 가장 쉽습니다.
- 설치: GitHub 공식
github/github-mcp-server를 사용하십시오. Docker 이미지(ghcr.io/github/github-mcp-server)로 실행하며, PAT는GITHUB_PERSONAL_ACCESS_TOKEN환경 변수에 넣습니다. 기존@modelcontextprotocol/server-githubnpm 패키지에는 "no longer supported" 표시가 있으므로 새 설정에는 사용하지 마십시오. - 노출되는 도구:
search_repositories,get_file_contents,create_or_update_file,create_pull_request,list_issues,create_issue,add_issue_comment,merge_pull_request, 그 외 다수. 전체 표면은 크지만 대부분의 작업은 5~10개의 도구를 사용합니다. - PAT의 범위를 제한하십시오. 필요한 최소 권한(탐색에는 Read, PR/이슈 생성에는 Write)으로 특정 저장소에 한정된 fine-grained PAT를 사용하십시오. 실험적인 에이전트에
repo권한이 있는 classic PAT를 사용하지 마십시오. - 실제 워크플로: 트리아지("최근 열린 이슈 20개를 읽어 그룹화하고 레이블을 제안하십시오"), 초안 작성("README를 읽고 오타를 수정하는 PR을 여십시오"), 보고("이번 주에 정체된 PR은 무엇입니까").
- 위험 표면: 에이전트는 이슈와 PR을 만들고 댓글을 달 수 있으며, 쓰기 권한이 있으면 커밋을 push할 수도 있습니다. 모델과 워크플로를 모두 신뢰하지 않는 한 merge 도구는 비활성화하십시오. fine-grained PAT를 쓰는 저장소에서 잘못 merge한 것은 복구할 수 있지만, 빨리 알아차렸을 때만 가능합니다.
# ~/.config/goose/config.yaml
extensions:
  github:
    type: stdio
    name: github
    enabled: true
    cmd: docker
    args: ["run", "-i", "--rm", "-e", "GITHUB_PERSONAL_ACCESS_TOKEN", "ghcr.io/github/github-mcp-server"]
    envs:
      GITHUB_PERSONAL_ACCESS_TOKEN: "${GH_AGENT_PAT}"
    timeout: 300
# Fine-grained PAT scoped to one or two test repos,
# not your personal account-wide classic token.
모델을 신뢰하지 않는 보안 모델
올바른 멘탈 모델은 "LLM은 사용자가 건넨 열쇠만 가진, 신뢰할 수 없는 인턴"입니다. 기능은 허용 목록에 넣은 서버와 표면에서 나오며, 모델의 판단에서 나오지 않습니다.
- filesystem 서버를 하나의 디렉터리로 제한하십시오.
~나/는 절대 안 됩니다.agent-workspace/폴더를 정하고 에이전트가 다룰 파일의 사본을 그 안에 넣으십시오. 에이전트가 잘못되더라도 최악의 경우는 폴더 하나입니다. - 데이터베이스 서버를 기본적으로 읽기 전용으로 실행하십시오.
SELECT권한만 있고 30초 statement timeout이 설정된 전용agent_ro역할이 한 부류의 사고를 완전히 없애 줍니다. - 모든 쓰기 또는 셸 도구를 명시적 승인 뒤에 두십시오. Goose, Cline, Continue.dev는 모두 도구별 승인 규칙을 지원합니다. 읽기 도구는 기본적으로 허용하고,
write_file,edit_file,execute_command,create_pull_request, 양식을 제출하는 모든 브라우저 동작에는 승인을 요구하십시오. - 감사 로그를 사용하십시오. 모든 MCP 클라이언트는 tool call과 결과를 기록합니다. 긴 세션이 끝나면 로그를 훑어보십시오. 모델이 예상하지 못한 것을 시도하는 모습이 발견됩니다(때로는 무해하고, 때로는 권한을 더 조일 이유가 됩니다).
- 타사 접근은 토큰 범위를 좁게 제한하십시오. GitHub PAT는 테스트 저장소 두 개로, Postgres 역할은 읽기 전용으로, 브라우저 세션은 자격 증명 없이. 모델은 결국 예상하지 못한 것을 시도합니다. 할 수 있는 일의 한계가 모델이 올바르게 행동하는지에 달려 있으면 안 됩니다.
- 민감한 데이터 작업에는 에이전트를 격리하십시오. 개인 데이터를 다룰 때는 에이전트를 실행하는 동안 호스트의 네트워크 접근을 끄십시오(또는 네트워크 네임스페이스를 사용). 로컬 스택은 이미 기기 밖으로 아무것도 보내지 않지만, 심층 방어는 타사 서버의 실수를 잡아 줍니다.
- MCP 서버 선택도 다른 의존성 선택과 똑같이 다루십시오. 참조 서버는 잘 유지 관리되지만 많은 타사 서버는 그렇지 않습니다. 자격 증명이 필요한 서버는 설치하기 전에 코드를 읽으십시오.
📌참고: 유용한 장애 복구 습관: 사소하지 않은 에이전트 작업 전에 git stash(또는 git checkout -b agent/<task>)를 실행하십시오. 작업이 끝나면 diff를 검토하고, 원하는 부분은 남기고 나머지는 버리십시오. 긴 Cline이나 Aider 세션을 안전하게 만드는 것과 같은 관행입니다. 더 넓은 패턴은 Continue.dev vs Cline vs Aider 비교를 참조하십시오.
로컬 MCP vs Claude Desktop: 무엇이 바뀌고 무엇이 그대로인가
프로토콜과 서버는 동일합니다. 모델과 클라이언트만 바뀝니다. 이것이 MCP가 중요한 이유 전부입니다. 도구에 대한 투자가 로컬과 클라우드 설정 사이에서 깔끔하게 이식됩니다.
레이어 | Claude Desktop | Ollama 로컬 + Goose |
|---|---|---|
| 모델 | Claude(Anthropic, 클라우드) | Gemma 4, GLM-4.7, Qwen3 또는 Llama 3.3(로컬) |
| 클라이언트 | Claude Desktop 앱 | Goose, Cline, Continue.dev 또는 LM Studio |
| 서버 | 동일한 MCP 서버 | 동일한 MCP 서버 |
| 프로토콜 | MCP(JSON-RPC 2.0) | MCP(JSON-RPC 2.0) |
| 요청당 비용 | 토큰당 API 지출 | $0 — 로컬 추론 |
| 프라이버시 | 대화가 Anthropic으로 전송됨 | 기기에 그대로 유지됨 |
| 속도 제한 | API 속도 제한 적용 | 하드웨어 처리량에 의해서만 제한됨 |
| tool calling 품질 | 최고 수준 | 27B 이상 모델에서 좋음; 7B 미만에서 급격히 저하됨 |
| 인터넷 필요 | 예 | 서버가 직접 가져오는 경우에만(예: 브라우저) |
| 설정 시간 | 5분 | 15분(일회성) |
로컬 MCP를 위한 tool calling 모델 선택
tool calling 신뢰성은 harness가 아니라 모델 크기와 훈련에 따라 달라집니다. Cline에서 잘못된 형식의 tool call을 생성하는 모델은 같은 이유로 Goose에서도 생성합니다.
- Gemma 4 31B(
gemma4:31b) — Google의 tool calling 훈련은 이 크기에서 최고 수준입니다. Q4_K_M에서 16GB 통합 메모리 또는 24GB VRAM에 들어갑니다. 일반 추론이 좋고, 연쇄 tool call에서는 다소 보수적입니다. - GLM-4.7 Flash(
glm-4.7-flash) — Zhipu의 모델은 tool calling 신뢰성이 매우 높고 기본으로 128K 컨텍스트 창을 제공합니다. Gemma 4보다 약간 무겁지만 24GB GPU에 여유 있게 들어갑니다. - Qwen3.6 27B(
qwen3.6:27b) — Ollama에서 쓸 수 있는 더 새로운 Qwen 선택지입니다(약 18~19GB, 256K 컨텍스트, tool calling 지원). Qwen3 32B(qwen3:32b) — 균형이 잘 잡혀 있고, 조밀한 32B는 MCP를 문제없이 처리하며 긴 에이전트 루프에서도 잘 작동합니다. Qwen3-Coder 30B(qwen3-coder:30b)는 에이전트 작업이 코드 중심이라면 최선의 선택입니다. - Llama 3.3 70B(
llama3.3:70b) — 성능 한계는 가장 높지만 가장 무겁습니다. Q4_K_M에서 48GB 이상 통합 메모리 또는 2× 24GB GPU가 필요합니다. 하드웨어가 허용하는 경우에만 사용하십시오. 더 작은 모델로 충분한 경우가 많습니다. - MCP 작업에서 피해야 할 것: 7B 미만의 모든 모델, 그리고 명시적인 tool calling 훈련이 없는 범용 모델. 잘못된 형식의 호출을 생성하고, 루프가 멈추고, harness를 탓하게 됩니다. 하지만 harness는 문제가 없습니다.
- 어떤 모델에서든 tool calling 품질을 높이는 구조적 프롬프팅 기법은 Chain-of-thought 프롬프팅을 참조하십시오.
- 비교 데이터는 2026년 tool calling을 위한 최고의 로컬 모델을 참조하십시오.
MCP vs 일반 Function Calling: 차이점은 무엇인가
Function calling은 모델이 생성하는 것이고, MCP는 클라이언트와 도구가 서로를 찾을 수 있게 하는 프로토콜입니다. 둘은 서로 다른 계층에 있으며 함께 작동합니다. 하나가 다른 하나를 대체하지 않습니다.
- Function calling은 LLM 측의 기능입니다. 모델이 도구 이름과 인수를 설명하는 구조화된 JSON 객체를 생성합니다. OpenAI의 도구, Anthropic의 도구, Ollama의 tool call API는 wire 형식만 조금씩 다를 뿐 같은 아이디어를 사용합니다.
- MCP는 그 위에 위치합니다. 도구가 프로세스 간에 설명, 발견, 호출, 반환되는 방식을 표준화합니다. function calling만 있는 모델은 filesystem에 대해 아무것도 모릅니다. MCP 서버가 filesystem 작업을 사용할 수 있게 만들고, 클라이언트가 이를 모델의 function calling API에 매핑하면, 모델이 그것을 호출할 수 있게 됩니다.
- 이점은 상호 운용성입니다. filesystem 서버를 한 번 작성하면 Claude Desktop, Goose, Cline, Continue.dev, LM Studio 모두 변경 없이 사용합니다. 모델을 Claude에서 Gemma 4로 바꿔도 서버는 바뀌지 않습니다.
- 순수한 function calling으로도 에이전트를 만들 수 있습니다. 다만 프로젝트마다 filesystem, 데이터베이스, 브라우저 핸들러를 다시 구현하게 됩니다. MCP를 쓰면 이것들이 바로 가져다 쓰는 의존성이 됩니다.
- 일회성 스크립트라면 순수한 function calling이 더 간단합니다. 프로젝트나 모델을 넘나들며 재사용하고 싶은 것이라면, 며칠 안에 MCP 쪽이 더 적은 노력으로 끝납니다.
로컬 MCP 설정 시 일반적인 실수
- 실수 1: 범용 소형 모델 사용. 7B 미만 모델(그리고 tool calling 파인튜닝이 없는 대부분의 7B~13B 범용 모델)은 잘못된 형식의 tool call을 생성합니다. tool calling에 맞게 튜닝된 27B 이상 모델을 사용하고 harness와 싸우는 일을 그만두십시오.
- 실수 2: 허용 목록에 홈 디렉터리 넣기. "테스트만 하려고" 넣은
~허용 목록은 일상적인 사용까지 살아남습니다. 처음부터 전용agent-workspace를 만드십시오. - 실수 3: 데이터베이스 서버를 읽기/쓰기 모드로 두기. 자신만만한 에이전트가 실제 테이블에
DELETE쿼리를 작성하는 것이 바로 이 설정이 막는 사고입니다.agent_ro를 기본 역할로 만들고, 명시적으로 필요한 작업에만, 그 작업이 진행되는 동안에만 별도의 쓰기 가능 역할을 만드십시오. - 실수 4: 모든 도구 자동 승인. "모두 승인" 토글은 편리하지만 위험합니다. 읽기 도구(
read_file,list_directory,query)는 자동 승인하고, 쓰기/셸/PR 도구는 항상 승인을 요구하십시오. - 실수 5: 다단계 브라우저 작업에 32K 컨텍스트 모델 사용. 페이지 내용이 크기 때문에, 세 페이지를 탐색하는 에이전트는 추론에 들어가기 전에 32K 토큰을 소진할 수 있습니다. 브라우저 중심 작업에는 128K 컨텍스트 모델을 사용하십시오.
- 실수 6: 에이전트에게 판단력이 있다고 가정하기. 판단력은 없습니다. 모델에게는 "이것은 프로덕션 데이터베이스다"나 "이 PR은 배포된다"라는 개념이 없습니다. 권한이 유일한 장벽입니다.
- 실수 7: 처음부터 모든 참조 서버 설치. 도구가 많아지면 시스템 프롬프트가 커지고 도구 선택이 느려지고 덜 안정적이 됩니다.
filesystem으로 시작하고, 필요한 워크플로가 생겼을 때만 다른 서버를 추가하십시오. - 실수 8: 오래된 튜토리얼의 보관된 참조 서버 설치. npm 패키지
@modelcontextprotocol/server-postgres,-puppeteer,-github에는 "no longer supported" 표시가 있고 SQLite 서버는 보관되었습니다. 일부 오래된 가이드는 존재하지 않는 npm 패키지(server-sqlite,server-playwright)를 언급하기도 합니다. 위에서 소개한 유지 관리되는 서버를 사용하십시오. - 실수 9: Ollama에 MCP 설정 넣기. Ollama에는 MCP 설정이 없습니다. 서버는 클라이언트에서 구성합니다(Goose
extensions, Cline 또는 Continue.dev의 MCP 설정).
출처
- Model Context Protocol 사양 — 공식 사양, JSON-RPC 스키마, 전송 및 수명 주기 정의, 2026-07-28 변경 내역 포함.
- modelcontextprotocol/servers GitHub 저장소 — 유지 관리되는 참조 서버(filesystem, git, fetch, memory 등)와 보관된 서버 목록.
- github/github-mcp-server — GitHub 공식 MCP 서버, Docker 및 바이너리 설정.
- microsoft/playwright-mcp — Playwright MCP 서버와 브라우저 도구.
- crystaldba/postgres-mcp — 제한(읽기 전용) 접근 모드를 갖춘 Postgres MCP 서버.
- Goose 문서 — CLI 설치, Ollama 제공자 설정, extension(MCP 서버) 설정 구문.
- Ollama 모델 라이브러리 — 이 가이드에서 참조하는 사용 가능한 로컬 모델, tool calling 지원 표시, 양자화 수준.
- Cline GitHub 저장소 — VS Code용 MCP 클라이언트 구현, MCP 서버 패널.
- Continue.dev 문서 — Continue.dev 클라이언트의
mcpServers설정 블록 참조.
자주 묻는 질문
MCP란 무엇이며 로컬 AI에 왜 중요합니까?
Model Context Protocol(MCP)은 클라이언트(Goose, Cline, Continue.dev, LM Studio, Claude Desktop)가 언어 모델을 도구 서버에 일관된 방식으로 연결할 수 있게 하는 오픈 JSON-RPC 2.0 프로토콜입니다. 로컬 AI에 중요한 이유는 채팅 모델을 에이전트로 바꾸는 계층을 표준화하기 때문입니다. 도구 서버를 한 번 작성하면 로컬 Ollama 모델을 포함한 모든 클라이언트와 모든 모델에서 사용할 수 있습니다. MCP가 없으면 프로젝트마다 자체 클라이언트에 맞춰 파일/데이터베이스/브라우저 도구를 새로 만들어야 합니다.
MCP는 Claude Desktop 없이 작동합니까?
네. 프로토콜은 오픈되어 있으며 Claude Desktop과 완전히 독립적입니다. Goose, Cline, Continue.dev, LM Studio는 모두 로컬 Ollama 모델과 작동하는 MCP 클라이언트 구현을 제공합니다. 유지 관리되는 서버(filesystem, Postgres, Playwright, GitHub)는 모든 호환 클라이언트에서 변경 없이 실행됩니다.
어떤 로컬 모델이 MCP를 가장 잘 지원합니까?
가장 신뢰할 수 있는 선택지는 Gemma 4 31B, GLM-4.7 Flash, Qwen3.6 27B 또는 Qwen3 32B(코드 중심 작업에는 Qwen3-Coder 30B), Llama 3.3 70B입니다. 모두 명시적인 tool calling 훈련을 받았으며 MCP 클라이언트가 라우팅할 수 있는 깔끔한 function calling JSON을 생성합니다. 7B 미만 모델(그리고 tool calling 파인튜닝이 없는 대부분의 범용 모델)은 잘못된 형식의 tool call을 자주 생성합니다.
MCP는 안전합니까? 에이전트가 내 파일을 삭제할 수 있습니까?
허용하면 가능합니다. 안전은 프로토콜이 아니라 서버를 구성하는 방식에서 나옵니다. filesystem 서버는 허용 목록에 넣은 경로 안에서만 작동하므로 전용 agent-workspace 디렉터리로 제한하십시오. 데이터베이스 서버는 제한 모드와 SELECT 전용 역할을 사용하면 읽기 전용으로 작동합니다. 쓰기, 셸, PR 도구에는 항상 명시적 승인을 요구하고, 읽기 작업만 자동 승인하십시오. 감사 로그를 보면 에이전트가 한 일을 사후에 정확히 확인할 수 있습니다.
나만의 MCP 서버를 작성할 수 있습니까?
네. SDK가 이를 간단하게 만들어 줍니다. 공식 TypeScript 및 Python SDK(@modelcontextprotocol/sdk 및 mcp)가 JSON-RPC 처리를 맡습니다. JSON 스키마와 핸들러 함수로 도구를 정의하면 SDK가 stdio를 통해 노출합니다. 단일 목적 서버(내부 API를 감싸는 도구 한두 개)는 50~100줄 파일이면 됩니다.
MCP는 Windows에서 작동합니까?
네. Ollama, Goose, Cline, Continue.dev, LM Studio 모두 Windows에서 실행됩니다. MCP 서버는 Node.js 또는 Python 하위 프로세스로 실행되며, 두 런타임 모두 Windows를 완전히 지원합니다. 플랫폼에 따라 다른 부분은 경로 처리뿐입니다. 설정에서 슬래시를 사용하거나 백슬래시를 올바르게 이스케이프하십시오. 그 외에는 macOS 및 Linux와 경험이 같습니다.
MCP tool call을 어떻게 샌드박싱합니까?
세 가지 계층이 대부분의 위험을 커버합니다. 첫째, 설정 수준에서 각 서버의 범위를 좁게 제한하십시오: filesystem은 하나의 디렉터리로, 데이터베이스는 읽기 전용 역할로, GitHub는 테스트 저장소에 한정된 fine-grained PAT로. 둘째, 클라이언트의 도구별 승인 규칙을 사용하십시오: 읽기는 자동 승인, 쓰기는 승인 필수. 셋째, 에이전트를 git stash를 쓰기 쉬운 workspace 안에 두어 파괴적인 작업을 git으로 되돌릴 수 있게 하십시오. 민감한 작업은 서버가 명시적으로 필요로 하는 엔드포인트를 제외하고 네트워크 접근이 없는 호스트에서 실행하십시오.
로컬 LLM으로 브라우저 MCP를 사용하려면 어떻게 하며, 에이전트가 HTTP 요청을 할 수 있습니까?
브라우저 MCP를 쓰려면 tool calling 모델이 실행 중인 Ollama, MCP 클라이언트(Goose 등), 그리고 Microsoft의 @playwright/mcp 서버(npx @playwright/mcp@latest)를 연결하십시오. 클라이언트의 MCP 설정에 이 서버를 추가하면 모델이 실제 브라우저를 제어합니다. 이 브라우저가 모델이 이동하는 곳으로 요청을 보내므로, 그 범위에서 에이전트는 HTTP 요청을 할 수 있습니다. 일부 타사 서버는 http_get/http_post 도구를 더 직접적으로 노출합니다. 반면 filesystem과 데이터베이스 서버는 네트워크 요청을 하지 않으며 로컬 리소스에서만 작동합니다.
MCP가 Ollama와 기본적으로 작동합니까, 아니면 래퍼가 필요합니까?
Ollama 자체는 MCP를 말하지 않습니다. OpenAI 호환 채팅 API를 제공할 뿐입니다. Ollama의 채팅 API를 MCP 서버에 연결하려면 클라이언트(Goose, Cline, Continue.dev, LM Studio)가 필요합니다. 클라이언트가 모델의 tool call을 올바른 MCP 서버로 라우팅하고 결과를 대화에 되돌려 줍니다. 사용자 입장에서는 클라이언트를 설치하고 Ollama를 가리키는 것 외에 추가 설정이 없습니다.
MCP와 function calling의 차이점은 무엇입니까?
Function calling은 LLM이 도구 이름과 인수를 지정하는 구조화된 JSON을 생성하는 것으로, 모델의 기능입니다. MCP는 도구 서버와 클라이언트가 프로세스 간에 도구를 설명, 발견, 호출, 반환하게 하는 프로토콜로, 상호 운용성 계층입니다. 둘은 함께 작동합니다. 클라이언트가 MCP 도구 정의를 모델의 function calling 형식으로 변환하고, 모델이 function call을 생성하면, 클라이언트가 그 호출을 MCP 서버로 되돌려 매핑하고, 서버가 실행합니다. MCP 없이도 function calling은 할 수 있지만, 프로젝트마다 filesystem/데이터베이스/브라우저 핸들러를 다시 구현하게 됩니다. MCP를 쓰면 같은 서버가 모든 클라이언트에서 작동합니다.
Ollama에 MCP 서버를 연결(연동)하려면 어떻게 합니까?
Ollama에 추가하는 것이 아닙니다. Ollama에는 MCP 설정이 없습니다. Ollama 앞에 있는 클라이언트에서 서버를 추가합니다. Goose에서는 goose configure를 실행하고 Add Extension, Command-line Extension을 차례로 선택한 다음 서버 명령을 입력하십시오(예: npx -y @modelcontextprotocol/server-filesystem /path/to/workspace). 빠른 테스트에는 goose session --with-extension "<command>"를 사용합니다. Cline과 Continue.dev에는 각자의 MCP 설정이 있습니다. Ollama가 컨텍스트 창 32K 이상의 tool calling 모델을 실행 중인지 확인하십시오.
Claude Desktop을 Ollama 모델과 함께 사용할 수 있습니까?
직접적인 구성으로는 불가능합니다. Claude Desktop은 Anthropic의 클라우드 모델과 통신하므로 Ollama 모델을 실행하지 않습니다. Claude Desktop에서 이어지는 것은 MCP 서버 생태계입니다. 같은 서버를 Ollama를 지원하는 MCP 클라이언트(Goose, Cline, Continue.dev, LM Studio 등)에서 사용할 수 있습니다. 이 가이드가 설명하는 것이 바로 그 로컬 대응 구성입니다.
어떤 공식 MCP 서버가 보관(archived)되었으며, 무엇으로 대체합니까?
SQLite, PostgreSQL, Puppeteer, GitHub(및 기타)용 참조 서버는 servers-archived 저장소로 옮겨져 더 이상 유지 관리되지 않습니다. 해당 npm 패키지(존재하는 경우)에는 "no longer supported" 표시가 있고 보안 수정이 제공되지 않습니다. 유지 관리되는 대체재는 다음과 같습니다: GitHub는 공식 github/github-mcp-server, 브라우저 자동화는 Microsoft의 @playwright/mcp, Postgres는 제한 모드의 postgres-mcp(Crystal DBA). SQLite에는 유지 관리되는 공식 서버가 없으므로 파일 사본에 보관된 서버를 사용하거나 데이터를 Postgres에 불러오십시오. filesystem 서버는 계속 적극적으로 유지 관리되는 참조 서버입니다.