Fatos rápidos
- Protocolo: JSON-RPC 2.0 sobre stdio (subprocesso local) ou Streamable HTTP (remoto). O antigo transporte HTTP+SSE está obsoleto. Os agentes locais usam quase exclusivamente stdio. A revisão atual da especificação é 2026-07-28.
- Origem: criado pela Anthropic como especificação aberta (modelcontextprotocol.io). Apenas alguns servidores de referência ainda são mantidos em
modelcontextprotocol/servers(filesystem, git, fetch, memory e outros); SQLite, PostgreSQL, Puppeteer e GitHub foram movidos paraservers-archived. Hoje os fornecedores publicam seus próprios servidores. - Clientes locais: Goose (open source, repositório
aaif-goose/goose), Cline (extensão do VS Code), Continue.dev (VS Code/JetBrains), LM Studio (aplicativo de desktop), mais várias ferramentas CLI. - Modelos Ollama compatíveis: qualquer modelo com treinamento nativo de tool calling, por exemplo Gemma 4 31B, GLM-4.7 Flash, Qwen3.6 27B, Qwen3 32B, Qwen3-Coder 30B, Llama 3.3 70B.
- Transporte padrão dos servidores: stdio para processos locais; Streamable HTTP apenas quando você precisa compartilhar um servidor entre máquinas ou agentes.
- A configuração vive no cliente: o Goose lê um bloco
extensionsem~/.config/goose/config.yaml(ougoose configure); Cline e Continue.dev têm suas próprias configurações de MCP. Os campos têm a mesma ideia em todos: nome do servidor, comando, args, variáveis de ambiente. - Claude Desktop não é necessário. O protocolo é aberto e independente do Claude Desktop; os servidores usados aqui são open source (confira a licença de cada um) e funcionam com qualquer cliente compatível.
O que o MCP realmente desbloqueia para um modelo local
Um LLM local sem ferramentas só pode responder com texto. Com MCP, o mesmo modelo pode agir na sua máquina. A mudança é a diferença entre um chatbot e um agente.
- "Encontre todos os TODOs neste repositório, agrupe-os por arquivo e escreva um resumo em Markdown em
notes/todos.md." — o servidorfilesystemlê, o modelo agrupa, o mesmo servidor escreve. Uma única ida e volta de ponta a ponta. - "Mostre-me os 10 melhores clientes por receita neste trimestre e faça um gráfico." — o servidor
postgresexecuta o SQL (role de somente leitura), o modelo resume e escreve um CSV viafilesystempara sua ferramenta de gráficos. - "Abra a capa do Hacker News, encontre as três principais histórias de IA, resuma-as e adicione-as à minha lista de leitura." — o servidor
playwrightcontrola um navegador, o modelo extrai e resume,filesystemadiciona. - "Abra um PR draft com o título
chore: bump depscontra meu fork e ligue a execução de CI com falha." — o servidorgithubcria o PR, obtém a execução e escreve o link na descrição. - "Olhe as últimas 100 linhas de
events.dbe diga-me quais IDs de usuário são responsáveis pelo novo pico de erros." — um servidor de banco de dados consulta uma cópia dos dados; o modelo raciocina; você lê a resposta no painel de chat. - Cada um desses é um fluxo de trabalho de frase para ação que antes exigia um modelo na nuvem com ferramentas hospedadas ou um script escrito à mão. O MCP é a camada que permite reutilizar os mesmos servidores entre clientes e o mesmo modelo entre servidores.
Comparativo dos quatro servidores MCP mais usados
Os servidores a seguir cobrem o longo alcance de "quero que meu modelo local faça algo real". Todos são open source e rodam como subprocessos locais (ou um contêiner Docker) iniciados pelo seu cliente MCP. Confira o status de manutenção antes de instalar um deles.
📍 Em uma frase
Comece com o servidor filesystem (5 minutos, baixo risco), adicione um servidor de banco de dados para trabalho com dados, adicione um servidor de navegador apenas quando precisar e traga o GitHub quando você confiar no modelo na sua máquina.
💬 Em termos simples
Quatro servidores cobrem a maior parte do que você vai querer que um agente local faça. O servidor filesystem lê e escreve arquivos em uma pasta que você escolhe. Um servidor de banco de dados executa consultas no Postgres. O servidor de navegador controla uma janela real de navegador para que o modelo possa ler páginas que exigem JavaScript. O servidor GitHub abre issues e PRs nos seus repositórios. A maioria começa com um único comando (npx, uvx ou Docker) e roda na sua própria máquina, e nenhum deles acessa a internet sem necessidade: os servidores de navegador e de GitHub acessam, os de filesystem e de banco de dados não.
Servidor MCP | O que habilita | Dificuldade de configuração | Nível de risco | Ideal para |
|---|---|---|---|---|
| Filesystem (referência) | Ler e escrever arquivos dentro de um diretório isolado | Fácil (um caminho na allowlist) | Médio — limite o escopo com cuidado | Automação pessoal, anotações, resumo de repositórios |
| SQLite (arquivado) | Consultar um arquivo de banco de dados SQLite local | Fácil, mas sem manutenção | Médio — sem correções, use uma cópia do arquivo | Apenas exploração descartável de dados |
| Postgres (postgres-mcp) | Consultar o Postgres em modo restrito (somente leitura) | Médio (role + URI) | Médio — modo restrito e role de somente leitura | Exploração de dados, relatórios, protótipos BI |
| Playwright (@playwright/mcp) | Controlar um navegador por snapshots de acessibilidade para navegação, scraping, preenchimento de formulários | Médio (binários do navegador, latência) | Alto — pode enviar formulários, clicar em qualquer coisa | Pesquisa, scraping, testes de regressão |
| GitHub (oficial) | Listar repositórios, ler arquivos, abrir issues e PRs | Médio (Docker + PAT em variável de ambiente) | Médio — limite o token a repositórios específicos | Fluxos de trabalho de desenvolvimento, triagem, rascunhos de PR |
| Custom | Qualquer coisa que você possa expressar como ferramentas JSON-RPC | Difícil (escreva seu próprio servidor) | Variável | APIs internas, sistemas de nicho, código de integração |
⚠️Aviso: Os servidores de referência de SQLite, PostgreSQL, Puppeteer e GitHub foram movidos para o repositório servers-archived e não são mais mantidos. Os pacotes npm de PostgreSQL, Puppeteer e GitHub estão marcados como "no longer supported", e o servidor SQLite (um pacote Python, lançado pela última vez em abril de 2025) também não recebe correções. Use os servidores mantidos desta tabela e leia o código de qualquer servidor que precise de credenciais.
Como as peças se encaixam
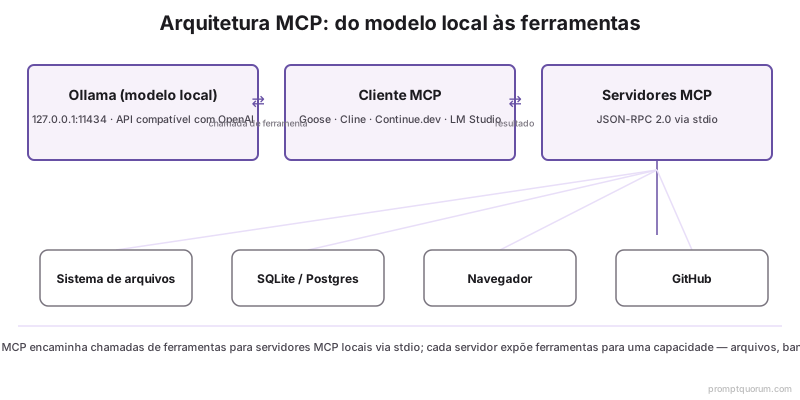
Três processos, um protocolo compartilhado. O modelo vive no Ollama, o cliente fala MCP e cada servidor expõe um pequeno conjunto de ferramentas. Cada tool call salta do cliente para o servidor, é executado localmente e retorna JSON.
- Ollama roda como serviço em segundo plano em
127.0.0.1:11434e serve o modelo via uma API compatível com OpenAI. Não sabe o que é MCP — simplesmente responde às completações de chat e emite tool calls quando o modelo os solicita. - O cliente MCP (Goose, Cline, Continue.dev, LM Studio) é a ponte. Fala com o Ollama para o modelo e com os servidores MCP para as ferramentas. Quando o modelo emite um tool call, o cliente o roteia para o servidor correto, obtém o resultado e o retorna à conversa.
- Os servidores MCP são subprocessos independentes, um por capacidade. Falam JSON-RPC 2.0 sobre stdio. Cada servidor anuncia uma lista de Tools, Resources e Prompts; o cliente os combina na superfície de ferramentas que é apresentada ao modelo.
- O transporte stdio mantém tudo local. O servidor é iniciado pelo cliente, se comunica via seu stdin/stdout e termina quando o cliente termina. Nada vai pela rede a menos que o servidor em si abra uma conexão (o servidor de navegador o faz; os servidores de filesystem e banco de dados não).
- O modelo vê uma lista plana de ferramentas. Da perspectiva do modelo não há servidores — apenas uma lista de nomes de ferramentas como
filesystem.read_file,playwright.browser_navigate,github.create_pull_request. O cliente gerencia o roteamento.
📌Nota: A arquitetura é idêntica à do Claude Desktop. As diferenças são o modelo (um modelo Ollama local em vez do Claude) e o cliente (Goose/Cline/Continue.dev/LM Studio em vez do Claude Desktop). Os servidores MCP são os mesmos — você pode rodar o servidor filesystem sob o Claude Desktop hoje e ele continuará rodando sem mudanças sob o Goose amanhã.
Configuração: Ollama + Goose em 15 minutos
O Goose é o caminho mais simples para um agente MCP local funcional. É um agente open source (originalmente do Block, hoje desenvolvido em aaif-goose/goose) com um CLI e suporte nativo ao Ollama, uma interface de chat interativa e um único arquivo de configuração para todos os seus servidores do Model Context Protocol (MCP). Continue.dev, Cline e LM Studio também funcionam — o Goose é o que dá menos trabalho na primeira execução.
- Passo 1 — instale o Ollama. Baixe em ollama.com/download (macOS/Windows/Linux). Confirme que o serviço está rodando com
curl http://127.0.0.1:11434/api/tags. - Passo 2 — baixe um modelo com tool calling. Escolha entre Gemma 4 31B (
gemma4:31b), GLM-4.7 Flash (glm-4.7-flash), Qwen3.6 27B (qwen3.6:27b), Qwen3 32B (qwen3:32b) ou Llama 3.3 70B (llama3.3:70b). 32 GB de memória unificada ou 24 GB de VRAM lidam confortavelmente com 26B–32B em Q4_K_M. - Passo 3 — instale o Goose. No macOS ou Linux, execute
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash(oubrew install block-goose-cli). No Windows, use o instalador PowerShell da documentação do Goose, ou o WSL. O CLI se instala comogoose. - Passo 4 — configure o Ollama como provedor. Execute
goose configure, escolhaollamacomo provedor, defina o modelo que você baixou e o host comohttp://127.0.0.1:11434(em branco também significa localhost:11434). O Goose escreve isso em~/.config/goose/config.yaml. A janela de contexto padrão do Ollama pode ser pequena (a documentação do Goose menciona 4096 tokens), o que pode fazer o Goose ignorar suas extensões — inicie o Ollama comOLLAMA_CONTEXT_LENGTH=32768(ou mais). - Passo 5 — adicione o servidor MCP de filesystem. Execute
goose configure, escolha Add Extension e depois Command-line Extension, ou adicione um blocoextensionsa~/.config/goose/config.yaml(exemplo abaixo). Para um teste pontual,goose session --with-extension "npx -y @modelcontextprotocol/server-filesystem /path/to/workspace"o ativa apenas naquela sessão. Iniciegoose sessione peça que liste os arquivos no seu diretório de teste. O primeiro turno confirma que o servidor está conectado. - Passo 6 — verifique com uma tarefa real. Teste
goose sessione peça "Faça uma lista de cada arquivo Markdown emnotes/, com título e número de palavras, e escreva o resultado emnotes/index.md." Se o agente ler, resumir e escrever de volta, o loop funciona.
# 1. Pull a tool-calling model
ollama pull gemma4:31b

# 2. Install Goose (macOS / Linux)
curl -fsSL https://github.com/aaif-goose/goose/releases/download/stable/download_cli.sh | bash

# 3. Configure Ollama as the provider
goose configure
# Provider: ollama
# Model:    gemma4:31b
# Host:     http://127.0.0.1:11434

# 4. Give Ollama a context window big enough for tool use, then start a session
OLLAMA_CONTEXT_LENGTH=32768 ollama serve   # in a separate terminal
goose session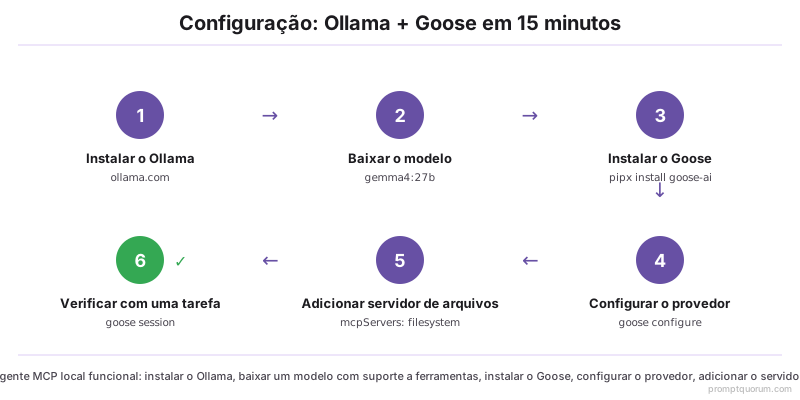
💡Dica: Se você já usa Cline ou Continue.dev, pule o Goose e use-os — ambos são clientes MCP. Cada um tem suas próprias configurações de MCP (consulte a documentação para saber o arquivo exato); o modelo e os servidores são os mesmos, só mudam o aplicativo host e o formato de configuração.
Servidor Filesystem: ler e escrever em um diretório isolado
O servidor filesystem é o primeiro a instalar e o mais fácil de limitar com segurança. Expõe read_file, write_file, list_directory, move_file, search_files e create_directory — tudo restrito a um ou mais caminhos na allowlist.
- Instalação: o servidor de referência é
@modelcontextprotocol/server-filesystem, executado vianpx -y(sem instalação global; requer Node.js). É um dos servidores de referência que ainda são mantidos. Goose, Cline e Continue.dev o iniciam a partir da configuração. - Caminhos na allowlist: o servidor aceita um ou mais argumentos de diretório e rejeita operações fora deles. Sempre passe um caminho explícito e estreito — nunca
~nem/. - Ferramentas expostas:
read_file,read_multiple_files,write_file,edit_file(substituições por linha),list_directory,search_files,move_file,create_directory,directory_tree. O modelo as vê comofilesystem.read_filee assim por diante. - Conveniência de uso:
directory_treeretorna uma árvore JSON; ideal para o modelo se orientar antes de ler arquivos específicos.search_filesfaz uma busca recursiva similar ao grep. - Superfície de risco: o servidor respeita a allowlist, mas dentro dela tem leitura/escrita completa. Trate a allowlist como a única barreira e escolha um diretório workspace dedicado em vez da sua pasta home.
# ~/.config/goose/config.yaml
extensions:
  filesystem:
    type: stdio
    name: filesystem
    enabled: true
    cmd: npx
    args: ["-y", "@modelcontextprotocol/server-filesystem", "/Users/you/agent-workspace"]
    envs: {}
timeout: 300⚠️Aviso: Nunca coloque / nem seu diretório home na allowlist. Crie uma pasta agent-workspace dedicada, coloque cópias dos arquivos que quer que o agente toque e deixe-o operar apenas dentro dessa pasta. Se o agente falhar, o raio de explosão para em um diretório.
Servidores de banco de dados: consultar o Postgres (e o SQLite) com segurança
Um servidor de banco de dados converte o modelo em um analista júnior que pode responder perguntas respaldadas por dados reais — desde que você o mantenha em somente leitura. Os servidores de referência originais de SQLite e PostgreSQL estão arquivados; por isso, use um servidor Postgres mantido e trate o SQLite com cuidado.
- Postgres:
postgres-mcp(Crystal DBA, licença MIT) é a opção com modo somente leitura (a versão mais recente no PyPI é de maio de 2025, então confira a atividade do repositório antes de depender dele). Execute-o comuvx postgres-mcp --access-mode=restricted(oupipx install postgres-mcp, ou sua imagem Docker) e passe a URI de conexão na variável de ambienteDATABASE_URI. O modo restrito permite transações somente leitura e um limite de tempo por consulta; o modo irrestrito é só para desenvolvimento. - Use também um role de somente leitura dedicado. O modo restrito é uma barreira, o role do banco de dados é outra. Crie um role
agent_rocom permissões apenas de SELECT e use a string de conexão desse role. - SQLite: o servidor de referência está arquivado. É o pacote Python
mcp-server-sqlite(não é um pacote npm; última versão em abril de 2025), pode até continuar funcionando, mas não recebe correções. Aponte-o apenas para uma cópia do arquivo, nunca para a sua única cópia, ou carregue os dados no Postgres. Leia o código de qualquer servidor SQLite da comunidade antes de entregar um arquivo a ele. - Consciência do esquema: peça ao agente que "liste as tabelas e descreva as cinco mais usadas" antes de fazer perguntas analíticas — o modelo é muito mais preciso quando inspecionou o esquema do que quando adivinha os nomes das colunas.
- Custo: as consultas vão diretamente ao seu banco de dados. Um
SELECT *malformado de uma tabela com 100M de linhas é o mesmo acidente aqui que seria de um humano — mantenha o role em um pool de conexões separado com um statement timeout.
# ~/.config/goose/config.yaml
extensions:
  postgres:
    type: stdio
    name: postgres
    enabled: true
    cmd: uvx
    args: ["postgres-mcp", "--access-mode=restricted"]
    envs:
      DATABASE_URI: "postgresql://agent_ro:${PG_AGENT_PASSWORD}@127.0.0.1:5432/analytics"
timeout: 300💡Dica: Crie o role do Postgres uma vez e não dê nada mais ao agente: CREATE ROLE agent_ro WITH LOGIN PASSWORD '…'; GRANT CONNECT ON DATABASE analytics TO agent_ro; GRANT USAGE ON SCHEMA public TO agent_ro; GRANT SELECT ON ALL TABLES IN SCHEMA public TO agent_ro; ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO agent_ro; Em seguida adicione statement_timeout = 30s ao role. O agente não pode escrever, não pode excluir e não pode rodar indefinidamente.
Servidor de navegador: controlar um navegador com o Playwright MCP
O servidor de navegador é o mais poderoso e o mais perigoso dos quatro. Lança um navegador real e expõe navegação, cliques, preenchimento de formulários e capturas de tela — ou seja, pode fazer tudo que você faz em um navegador, incluindo enviar formulários.
- Qual servidor: use o
@playwright/mcpda Microsoft (npx @playwright/mcp@latest). O antigo@modelcontextprotocol/server-puppeteerestá marcado como "no longer supported", e não existe nenhum pacote@modelcontextprotocol/server-playwrightno npm. - Ferramentas expostas:
browser_navigate,browser_snapshot,browser_click,browser_type,browser_fill_form,browser_evaluate(executar JavaScript),browser_take_screenshot,browser_tabs,browser_wait_for. O modelo lê a página por meio debrowser_snapshot(um snapshot de acessibilidade, que o Playwright MCP recomenda em vez de capturas de tela para executar ações) e usa capturas de tela apenas para olhar. - Latência: sessões de navegador reais levam entre 1 e 5 segundos por ação. Uma navegação de múltiplos passos pode facilmente consumir 30–60 segundos e dezenas de milhares de tokens porque o conteúdo das páginas é grande. Use uma janela de contexto de 32K+.
- Referências de elementos: o modelo clica nos elementos pelas referências do snapshot. Modelos menores escolhem o elemento errado com frequência; um modelo de 27B+ com tool calling lida com os padrões comuns de forma confiável. Mantenha as tarefas delimitadas — "extraia o título e o primeiro parágrafo desta URL" é muito mais confiável do que "navegue pelo site e encontre a página de contato".
- Os casos de uso corretos: pesquisa (abrir a página, resumir, adicionar a notas), testes de regressão (navegar, clicar, captura de tela) e preenchimento de formulários em páginas que você controla. Os casos incorretos: qualquer coisa onde um clique errado na web ao vivo tenha consequências.
# ~/.config/goose/config.yaml
extensions:
  playwright:
    type: stdio
    name: playwright
    enabled: true
    cmd: npx
    args: ["@playwright/mcp@latest"]
    envs: {}
    timeout: 300
# Block obviously dangerous endpoints at the OS firewall level
# rather than relying on the agent to refuse them.⚠️Aviso: Nunca passe credenciais ao servidor de navegador. Se precisar de uma sessão autenticada, passe ao agente um perfil de navegador pré-autenticado e nunca o deixe navegar para sites de alto impacto (banco, e-mail, consoles de nuvem, formulários de pagamento). O modelo não tem julgamento sobre o que um botão faz — ele vê texto e clica. Trate-o como um estagiário sem contexto e sem recurso.
Servidor GitHub: repositórios, issues e PRs a partir de um modelo local
O servidor GitHub converte o trabalho em linguagem natural sobre repositórios em chamadas de API. É o mais simples dos quatro de configurar e o mais fácil de limitar pelas permissões do personal access token (PAT).
- Instalação: use o
github/github-mcp-serveroficial do GitHub, executado a partir da sua imagem Docker (ghcr.io/github/github-mcp-server) com um PAT na variável de ambienteGITHUB_PERSONAL_ACCESS_TOKEN. O antigo pacote npm@modelcontextprotocol/server-githubestá marcado como "no longer supported"; não o use em novas configurações. - Ferramentas expostas:
search_repositories,get_file_contents,create_or_update_file,create_pull_request,list_issues,create_issue,add_issue_comment,merge_pull_request, mais muitas outras. A superfície completa é grande; a maioria das tarefas usa de 5 a 10 ferramentas. - Limite o escopo do PAT. Use um PAT de granularidade fina limitado a repositórios específicos com as permissões mínimas necessárias (Read para navegar, Write para criar PRs/issues). Não use um PAT clássico com
repopara um agente experimental. - Fluxos de trabalho reais: triagem ("leia os últimos 20 issues abertos, agrupe-os, proponha labels"), rascunhos ("leia o README e abra um PR corrigindo erros de digitação"), relatórios ("quais PRs estão inativos esta semana").
- Superfície de risco: o agente pode criar issues e PRs, comentá-los e (com permissões de escrita) fazer push de commits. Desative as ferramentas de merge a menos que você confie tanto no modelo quanto no fluxo de trabalho — um merge feito por engano em um repositório com PAT de granularidade fina é recuperável, mas só se você notar rápido.
# ~/.config/goose/config.yaml
extensions:
  github:
    type: stdio
    name: github
    enabled: true
    cmd: docker
    args: ["run", "-i", "--rm", "-e", "GITHUB_PERSONAL_ACCESS_TOKEN", "ghcr.io/github/github-mcp-server"]
    envs:
      GITHUB_PERSONAL_ACCESS_TOKEN: "${GH_AGENT_PAT}"
    timeout: 300
# Fine-grained PAT scoped to one or two test repos,
# not your personal account-wide classic token.
Um modelo de segurança que não confia no modelo
O modelo mental correto é "o LLM é um estagiário sem confiança com as chaves que você lhe dá". As capacidades vêm dos servidores e das superfícies que você inclui na allowlist — não do julgamento do modelo.
- Limite o servidor filesystem a um diretório. Nunca
~nem/. Escolha uma pastaagent-workspace/e coloque cópias dos arquivos que o agente precisa tocar. Se o agente falhar, o pior caso é uma pasta. - Execute os servidores de banco de dados em somente leitura por padrão. Um role
agent_rodedicado com permissões apenas deSELECTe um statement timeout de 30 segundos elimina toda uma classe de incidentes. - Coloque cada ferramenta de escrita ou shell atrás de uma aprovação explícita. Goose, Cline e Continue.dev admitem regras de aprovação por ferramenta. Permita as ferramentas de leitura por padrão; exija aprovação para
write_file,edit_file,execute_command,create_pull_requeste qualquer ação do navegador que envie formulários. - Use o log de auditoria. Cada cliente MCP registra os tool calls e os resultados. Após uma sessão longa, revise o log: você vai detectar o modelo tentando coisas que não esperava (às vezes inofensivas, às vezes um motivo para apertar as permissões).
- Limite o acesso de terceiros com tokens de escopo estreito. PATs do GitHub limitados a dois repositórios de teste. Roles de Postgres de somente leitura. Sessões de navegador sem credenciais. O modelo acabará tentando coisas que você não previu; os limites do que ele pode fazer não devem depender de ele acertar.
- Isole o agente para trabalho com dados sensíveis. Desative o acesso à rede no host enquanto o agente está rodando (ou use um network namespace) quando trabalhar com dados privados. O stack local já não envia nada para fora da máquina, mas a defesa em profundidade pega erros em servidores de terceiros.
- Trate a seleção de servidores MCP como qualquer escolha de dependência. Os servidores de referência são bem mantidos; muitos servidores de terceiros não são. Leia o código do servidor antes de instalar um que precise de credenciais.
📌Nota: Um hábito útil de recuperação pós-falha: antes de uma tarefa de agente não trivial, faça git stash (ou git checkout -b agent/<task>). Após a tarefa, revise o diff, mantenha as partes que quer e descarte o resto. É a mesma prática que torna seguras as sessões longas com Cline ou Aider — veja a comparação Continue.dev vs Cline vs Aider para o padrão mais amplo.
MCP local vs Claude Desktop: o que muda, o que permanece
O protocolo e os servidores são idênticos. Apenas o modelo e o cliente mudam. Esta é exatamente a razão pela qual o MCP importa — seu investimento em ferramentas se porta limpa entre configurações locais e na nuvem.
Camada | Claude Desktop | Ollama local + Goose |
|---|---|---|
| Modelo | Claude (Anthropic, na nuvem) | Gemma 4, GLM-4.7, Qwen3 ou Llama 3.3 (local) |
| Cliente | Aplicativo Claude Desktop | Goose, Cline, Continue.dev ou LM Studio |
| Servidores | Os mesmos servidores MCP | Os mesmos servidores MCP |
| Protocolo | MCP (JSON-RPC 2.0) | MCP (JSON-RPC 2.0) |
| Custo por solicitação | Gasto de API por token | $0 — inferência local |
| Privacidade | A conversa vai para a Anthropic | Fica na máquina |
| Limites de velocidade | Aplicam-se os limites da API | Limitado apenas pelo desempenho do hardware |
| Qualidade do tool calling | A melhor da categoria | Boa com modelos de 27B+; degrada rapidamente abaixo de 7B |
| Requer internet | Sim | Apenas se um servidor fizer requisições (ex.: o navegador) |
| Tempo de configuração | 5 minutos | 15 minutos (uma única vez) |
Escolher um modelo com tool calling para MCP local
A confiabilidade do tool calling escala com o tamanho e o treinamento do modelo, não com o harness. Um modelo que emite tool calls malformados no Cline os emitirá no Goose pela mesma razão.
- Gemma 4 31B (
gemma4:31b) — o treinamento de tool calling do Google é o melhor da categoria para esse tamanho. Cabe em 16 GB de memória unificada ou 24 GB de VRAM em Q4_K_M. Bom raciocínio geral; um pouco conservador em tool calls encadeados. - GLM-4.7 Flash (
glm-4.7-flash) — o modelo da Zhipu tem confiabilidade de tool calling muito alta e uma janela de contexto de 128K nativa. Um pouco mais pesado que o Gemma 4; cabe confortavelmente em uma GPU de 24 GB. - Qwen3.6 27B (
qwen3.6:27b) — a opção mais nova da família Qwen no Ollama (cerca de 18–19 GB, contexto de 256K, com suporte a tool calling). Qwen3 32B (qwen3:32b) — equilibrado; o 32B denso lida com MCP sem problemas e se sente bem em um loop de agente longo. Qwen3-Coder 30B (qwen3-coder:30b) é a melhor opção se seu trabalho de agente é orientado a código. - Llama 3.3 70B (
llama3.3:70b) — o maior teto, mas o mais pesado. 48 GB+ de memória unificada ou 2× 24 GB de GPUs em Q4_K_M. Use apenas se seu hardware comportar; os modelos menores geralmente bastam. - Evite para trabalho com MCP: qualquer coisa abaixo de 7B e qualquer modelo de uso geral sem treinamento explícito de tool calling. Eles emitirão chamadas malformadas, o loop vai travar e você vai culpar o harness — mas o harness está bem.
- Para técnicas de prompting estruturado que melhoram a qualidade do tool calling em qualquer modelo, veja chain-of-thought prompting.
- Para os dados comparativos, veja Melhores modelos locais para tool calling em 2026.
MCP vs Function Calling simples: qual é a diferença
O function calling é o que o modelo emite. O MCP é o protocolo que permite que clientes e ferramentas se encontrem. Vivem em camadas diferentes e cooperam; um não substitui o outro.
- O function calling é a capacidade do lado do LLM: o modelo emite um objeto JSON estruturado descrevendo o nome da ferramenta e os argumentos. As tools da OpenAI, as tools da Anthropic e a API de tool calls do Ollama usam a mesma ideia, com formatos de wire ligeiramente diferentes.
- O MCP fica acima: padroniza como as ferramentas são descritas, descobertas, invocadas e retornadas entre processos. Um modelo com function calling, por si só, não sabe nada sobre o seu filesystem; um servidor MCP disponibiliza as operações de arquivo, o cliente as mapeia para a API de function calling do modelo, e o modelo passa a poder chamá-las.
- O benefício é a interoperabilidade. Escreva o servidor filesystem uma vez; Claude Desktop, Goose, Cline, Continue.dev e LM Studio todos o usam sem mudanças. Troque o modelo de Claude para Gemma 4; o servidor não muda.
- Você pode fazer agentes com function calling puro. Você reimplementará handlers de filesystem, banco de dados e navegador por projeto. Com MCP, essas são dependências prontas para uso.
- Para scripts pontuais, o function calling puro é mais simples. Para qualquer coisa que queira reutilizar entre projetos ou modelos, o MCP é o caminho de menor esforço em poucos dias.
Erros comuns ao configurar MCP local
- Erro 1: usar um modelo pequeno de propósito geral. Modelos abaixo de 7B (e a maioria dos modelos gerais de 7B–13B sem fine-tuning de tool calling) emitem tool calls malformados. Use um modelo de 27B+ ajustado para tool calling e pare de lutar com o harness.
- Erro 2: colocar seu diretório home na allowlist. As allowlists de
~"apenas para testes" sobrevivem até o uso rotineiro. Crie umagent-workspacededicado desde o início. - Erro 3: deixar o servidor de banco de dados em modo leitura/escrita. Uma consulta
DELETEredigida por um agente autoconfiante em uma tabela real é exatamente o incidente que isso evita. Faça deagent_roseu role padrão; crie um role com escrita separado apenas para tarefas que realmente precisem dele, e somente durante essas tarefas. - Erro 4: aprovar automaticamente cada ferramenta. O botão "aprovar tudo" é conveniente e perigoso. Aprove automaticamente as ferramentas de leitura (
read_file,list_directory,query); sempre exija aprovação para as ferramentas de escrita/shell/PR. - Erro 5: usar um modelo com contexto de 32K para trabalho de navegador de múltiplos passos. O conteúdo da página é grande; um agente que navega três páginas pode esgotar os 32K tokens antes de raciocinar. Use um modelo com contexto de 128K para tarefas intensivas no navegador.
- Erro 6: assumir que o agente tem julgamento. Não tem. O modelo não tem conceito de "este é o banco de dados de produção" ou "este PR vai ser implantado". As permissões são sua única barreira.
- Erro 7: instalar todos os servidores de referência desde o início. Mais ferramentas = prompt de sistema maior = seleção de ferramentas mais lenta e menos confiável. Comece com
filesystem. Adicione os demais apenas quando tiver um fluxo de trabalho que os precise. - Erro 8: instalar servidores de referência arquivados a partir de tutoriais antigos. Os pacotes npm
@modelcontextprotocol/server-postgres,-puppeteere-githubestão marcados como "no longer supported" e o servidor SQLite está arquivado. Alguns guias antigos também citam pacotes npm que não existem (server-sqlite,server-playwright). Use os servidores mantidos citados acima. - Erro 9: colocar a configuração de MCP no Ollama. O Ollama não tem configurações de MCP. Os servidores são configurados no cliente (
extensionsdo Goose, configurações de MCP do Cline ou do Continue.dev).
Fontes
- Especificação do Model Context Protocol — Especificação oficial, esquema JSON-RPC, definições de transporte e ciclo de vida, incluindo o changelog de 2026-07-28.
- Repositório GitHub modelcontextprotocol/servers — Os servidores de referência mantidos (filesystem, git, fetch, memory e outros) e a lista de servidores arquivados.
- github/github-mcp-server — Servidor MCP oficial do GitHub, configuração com Docker e binário.
- microsoft/playwright-mcp — Servidor Playwright MCP e suas ferramentas de navegador.
- crystaldba/postgres-mcp — Servidor MCP para Postgres com modo de acesso restrito (somente leitura).
- Documentação do Goose — Instalação do CLI, configuração do provedor Ollama, sintaxe de configuração de extensões (servidores MCP).
- Biblioteca de modelos Ollama — Modelos locais disponíveis, indicadores de suporte de tool calling e níveis de quantização referenciados neste guia.
- Repositório GitHub do Cline — Implementação do cliente MCP para VS Code, painel de servidores MCP.
- Documentação do Continue.dev — Referência do bloco de configuração
mcpServerspara o cliente Continue.dev.
Perguntas frequentes
O que é MCP e por que importa para a IA local?
O Model Context Protocol (MCP) é um protocolo aberto JSON-RPC 2.0 que permite que um cliente (Goose, Cline, Continue.dev, LM Studio, Claude Desktop) conecte um modelo de linguagem a servidores de ferramentas de forma uniforme. Importa para a IA local porque padroniza a camada que converte um modelo de chat em um agente — escreva um servidor de ferramentas uma vez e use-o sob qualquer cliente e qualquer modelo, incluindo um modelo Ollama local. Sem o MCP, cada projeto reinventa as ferramentas de arquivo/banco de dados/navegador para o seu próprio cliente.
O MCP funciona sem Claude Desktop?
Sim. O protocolo é aberto e completamente independente do Claude Desktop. Goose, Cline, Continue.dev e LM Studio oferecem implementações de cliente MCP que funcionam com modelos Ollama locais. Os servidores mantidos (filesystem, Postgres, Playwright, GitHub) funcionam sem mudanças sob qualquer cliente compatível.
Quais modelos locais suportam MCP melhor?
As opções mais confiáveis são Gemma 4 31B, GLM-4.7 Flash, Qwen3.6 27B ou Qwen3 32B (ou Qwen3-Coder 30B para trabalho orientado a código) e Llama 3.3 70B. Todos têm treinamento explícito de tool calling e emitem JSON de function calling limpo que os clientes MCP podem rotear. Modelos abaixo de 7B (e a maioria dos modelos gerais sem fine-tuning de tool calling) produzem regularmente tool calls malformados.
O MCP é seguro? O agente pode excluir meus arquivos?
Pode se você permitir. A segurança vem de como você configura os servidores, não do protocolo. O servidor filesystem só opera dentro dos caminhos que você coloca na allowlist — limite-o a um diretório agent-workspace dedicado. O servidor de banco de dados funciona em somente leitura quando você usa o modo restrito e um role apenas de SELECT. Sempre exija aprovação explícita para as ferramentas de escrita, shell e PR; aprove automaticamente apenas as operações de leitura. O log de auditoria mostra exatamente o que o agente fez depois do fato.
Posso escrever meu próprio servidor MCP?
Sim — e os SDKs tornam isso simples. Os SDKs oficiais de TypeScript e Python (@modelcontextprotocol/sdk e mcp) lidam com o encanamento JSON-RPC. Você define ferramentas com seus JSON Schemas e uma função handler, e o SDK as expõe via stdio. Um servidor de propósito único (uma ou duas ferramentas que envolvem uma API interna) é um arquivo de 50–100 linhas.
O MCP funciona no Windows?
Sim. Ollama, Goose, Cline, Continue.dev e LM Studio todos funcionam no Windows. Os servidores MCP rodam como subprocessos de Node.js ou Python; ambos os ambientes de execução são totalmente compatíveis com Windows. O único detalhe específico da plataforma é o tratamento de caminhos — use barras para frente na configuração ou escape corretamente as barras invertidas. No mais, a experiência é idêntica à do macOS e do Linux.
Como faço sandbox das tool calls do MCP?
Três camadas cobrem a maior parte do risco. Primeiro, limite cada servidor estreitamente no nível de configuração: filesystem a um diretório, banco de dados a um role de somente leitura, GitHub a um PAT de granularidade fina para repositórios de teste. Segundo, use as regras de aprovação por ferramenta do cliente: aprovação automática para leituras, aprovação exigida para escritas. Terceiro, mantenha o agente dentro de um workspace compatível com git stash para que qualquer ação destrutiva seja desfazível via git. Para tarefas sensíveis, rode em um host sem acesso à rede, exceto para os endpoints de que os servidores realmente precisam.
Os agentes MCP podem fazer requisições HTTP?
Sim, através de servidores específicos. O servidor de navegador (Playwright MCP) controla um navegador real que faz as requisições que o modelo navega. Vários servidores de terceiros expõem ferramentas http_get/http_post de forma mais direta. Os servidores de filesystem e banco de dados não fazem requisições de rede; operam apenas em recursos locais.
O MCP funciona com o Ollama nativamente ou precisa de um wrapper?
O Ollama em si não fala MCP — serve uma API de chat compatível com OpenAI. Você precisa de um cliente (Goose, Cline, Continue.dev, LM Studio) para fazer a ponte entre a API de chat do Ollama e os servidores MCP. O cliente roteia os tool calls do modelo para o servidor MCP correto e retorna os resultados à conversa. Do ponto de vista do usuário, não há configuração extra além de instalar o cliente e apontá-lo para o Ollama.
Qual é a diferença entre MCP e function calling?
O function calling é o LLM emitindo JSON estruturado com o nome de uma ferramenta e seus argumentos — é uma capacidade do modelo. O MCP é o protocolo que permite que os servidores de ferramentas e os clientes descrevam, descubram, invoquem e retornem essas ferramentas entre processos — é uma camada de interoperabilidade. Cooperam: o cliente converte as definições de ferramentas do MCP para o formato de function calling do modelo, o modelo emite um function call, o cliente mapeia a chamada de volta para um servidor MCP e o servidor a executa. Sem o MCP você ainda pode usar function calling; só precisa reimplementar os handlers de filesystem/banco de dados/navegador por projeto. Com o MCP, os mesmos servidores funcionam sob qualquer cliente.
Como adicionar um servidor MCP ao Ollama?
Você não o adiciona ao Ollama — o Ollama não tem configurações de MCP. Você adiciona o servidor no cliente que fica na frente do Ollama. No Goose, execute goose configure, escolha Add Extension e depois Command-line Extension, e informe o comando do servidor (por exemplo npx -y @modelcontextprotocol/server-filesystem /path/to/workspace); para um teste rápido, use goose session --with-extension "<command>". Cline e Continue.dev têm suas próprias configurações de MCP. Garanta que o Ollama execute um modelo com tool calling e uma janela de contexto de pelo menos 32K.
Posso usar o Claude Desktop com modelos do Ollama?
Não como configuração direta. O Claude Desktop conversa com os modelos na nuvem da Anthropic, então não executa um modelo do Ollama. O que se aproveita do Claude Desktop é o ecossistema de servidores MCP: os mesmos servidores funcionam com um cliente MCP que suporta o Ollama, como Goose, Cline, Continue.dev ou LM Studio. Esse é o equivalente local descrito neste guia.
Quais servidores MCP oficiais foram arquivados e o que os substitui?
Os servidores de referência de SQLite, PostgreSQL, Puppeteer e GitHub (entre outros) foram movidos para o repositório servers-archived e não são mais mantidos; seus pacotes npm (quando existem) estão marcados como "no longer supported" e não recebem correções de segurança. Substitutos mantidos: o github/github-mcp-server oficial do GitHub para o GitHub, o @playwright/mcp da Microsoft para automação de navegador e o postgres-mcp (Crystal DBA) em modo restrito para o Postgres. Para o SQLite não há servidor oficial mantido, então use uma cópia do arquivo com o servidor arquivado ou carregue os dados no Postgres. O servidor filesystem continua sendo um servidor de referência ativamente mantido.